百鍊 API 按請求數和 Token 用量限流。本文提供從平台配置到用戶端流控再到架構兜底的應對方案。
百鍊 API 對請求數、Token 用量和增長速率設有限制,即限流。大模型請求延遲高,且同時受請求數和 Token 量兩個維度約束,單純"遇錯重試"效果有限,需要針對性的流控措施。
本文按改動成本從低到高,介紹三類方案:
- 平台配置方案(低改動成本):服務端排隊等待、提升限流額度、PTU、Batch API。
- 用戶端流控策略(改用戶端代碼):從基礎重試到自適應擁塞控制,按工程複雜度遞進的四種策略。
- 架構兜底方案(改系統架構):模型降級(Fallback)、基於訊息佇列(MQ)的削峰填穀。
如果當前正在解決 429 報錯,可查看錯誤診斷與策略推薦定位原因。若為突發流量(Traffic Burst)觸發,推薦先試服務端排隊等待——只需加一個要求標頭。
平台限流機制
限流按主帳號維度、模型獨立計算,觸發後通常 1 分鐘內恢複。各模型的限流條件和當前用量參見模型限流條件和模型用量監控。百鍊 API 有以下三種限流規則:
- 分鐘級配額限制(RPM / TPM):每分鐘允許的最大請求數(Requests Per Minute,RPM)和最大 Token 用量(Tokens Per Minute,TPM)。
- 瞬時頻率限制(RPS / TPS):每秒允許的最大請求數(RPS)和最大 Token 用量(TPS)。單秒內請求或 Token 消耗過於密集時觸發。
- 增速限制(Traffic Burst):短時間內請求量或 Token 用量激增時觸發。閾值隨服務狀態動態調整,逐步提升請求量可避免觸發。
以下從平台配置、用戶端流控、架構兜底三個層面介紹應對方案。
錯誤診斷與策略推薦
同一錯誤碼可能由不同限流維度觸發。高並發下服務端飽和也可能導致響應變慢或逾時,可通過自適應擁塞控制策略緩解。
錯誤碼 (DashScope / OpenAI) | 觸發維度 | 特徵診斷 | 推薦策略 |
|---|---|---|---|
Throttling.RateQuota / limit_requests | 請求頻率超限 | 間歇性報錯,成功率隨時間下降 | 令牌桶:控制單位時間內的請求配額 |
請求頻率超限 | 啟動瞬間或並發激增時集中報錯 | ||
Throttling.AllocationQuota / insufficient_quota | Token 用量超限 | 長文本處理時間歇性報錯 | 雙重令牌桶:同時限制 RPM 和 TPM 配額 |
Token 用量超限 | 長文本並發時瞬間 Token 消耗過大 | ||
Throttling.BurstRate / limit_burst_rate | 流量增速超限 | 啟動或空閑恢複後突然發起大量請求 | 推薦首選服務端排隊等待;或令牌桶設定低初始值(如 |
平台配置方案
以下方案依賴平台能力,用戶端改動極少或無需改動。
服務端排隊等待(推薦首選)
針對增速/突發限流(Traffic Burst),百鍊支援在要求標頭中聲明最大等待時間。服務端收到後,在指定時間內排隊重試,直到請求開始處理或逾時。相比直接返回 429,該機制可顯著提升突發流量下的成功率。
說明該功能僅適用於增速/突發限流(Throttling.BurstRate),不適用於 RPM/TPM 絕對值限流。
在要求標頭中添加 X-DashScope-Wait-Timeout 欄位:
Header 欄位 | 樣本 | 說明 |
|---|---|---|
X-DashScope-Wait-Timeout | 30 | 突發請求的最大排隊等待時間,單位為秒。
|
配置排隊等待後,需相應調整用戶端逾時時間,避免因疊加排隊時間導致串連提前關閉:
- 非流式請求(stream: false):逾時時間 = 原基礎逾時時間 + Wait-Timeout 值。
- 流式請求(stream: true):逾時時間 > Wait-Timeout 值。流式請求在收到首個 chunk 後開始計時,只需確保首次響應逾時大於排隊時間。
例如:原基礎逾時時間為 120 秒,Wait-Timeout 設為 30 秒,則非流式請求的逾時時間應設為 150 秒。
程式碼範例
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    timeout=150.0,  # 原逾時 120s + 排隊等待 30s
)

response = client.chat.completions.create(
    model="qwen-plus",
    messages=[{"role": "user", "content": "Hello"}],
    extra_headers={
        "X-DashScope-Wait-Timeout": "30"  # 最大排隊等待 30 秒
    }
)
print(response.choices[0].message.content)
curl -X POST "https://dashscope.aliyuncs.com/compatible-mode/v1/chat/completions" \
  -H "Authorization: Bearer $DASHSCOPE_API_KEY" \
  -H "Content-Type: application/json" \
  -H "X-DashScope-Wait-Timeout: 30" \
  -d '{
    "model": "qwen-plus",
    "messages": [{"role": "user", "content": "Hello"}]
  }'
提升限流額度
預設額度不足時,可在百鍊控制台直接提升臨時限流額度,提交後立即生效。目前支援華北2(北京)和新加坡地區。
適用情境:業務增長導致 RPM/TPM 配額不足,或短期活動需臨時提升輸送量。操作詳情參見限流。
操作簡單,建議在嘗試用戶端流控前優先評估。
預置吞吐單元(PTU)
PTU 服務提供獨立預留的專享算力,可避免公用資源集區的競爭,是保障即時高吞吐的首選。
適用情境:業務對輸送量有確定性要求(如 SLA 承諾),或希望免去用戶端流控開發,直接獲得穩定高吞吐。
PTU 為預留資源,未滿負荷使用也持續計費。建議根據實際峰值評估規格,避免閑置浪費。
非同步批處理(Batch API)
資料清洗、離線分析等無即時性要求的任務,可使用 Batch API 批量提交。任務在低峰期非同步執行,不受線上限流約束。
適用情境:資料標註、日誌分析、批量摘要等允許數小時至數天返回結果的任務。費用通常低於即時 API。
結果返回時間不確定,不適用於需即時響應的線上業務。提交後需通過輪詢或回調擷取結果。
用戶端流控策略
當平台方案(如服務端排隊等待、提升額度等)無法滿足需求時,需在用戶端引入流控。核心原則:將請求均勻分布在時間視窗內,避免突發觸發限流。系統啟動或長時間空閑後,應逐步提升並發而非瞬間拉滿。
以下四種策略按工程複雜度遞增,每種包含上一級能力並增強:
- 基礎重試僅做被動防禦;
- 請求速率限制加入主動排隊;
- 流量整形進一步引入 Token 維度管控和平滑發送;
- 自適應擁塞控制則基於即時反饋動態調整發送速率。
在滿足業務需求的前提下,優先選擇實現成本更低的策略。
各策略的輸送量表現對比
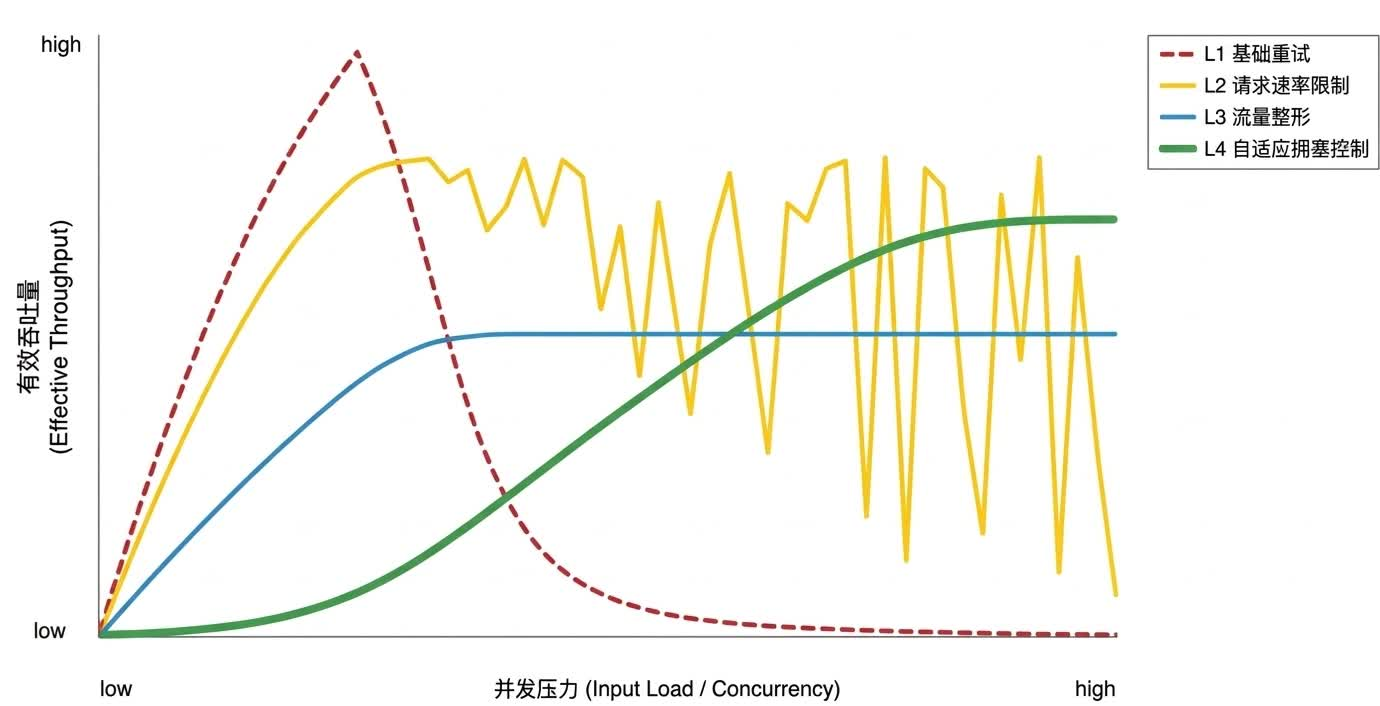
四種策略在不同負載下的輸送量表現:
- 基礎重試策略:低負載下有效,高並發下易觸發擁塞崩潰,輸送量斷崖式下降。
- 請求速率限制策略:防崩潰能力強,但長文本混合負載下因缺乏 Token 管控,輸送量呈鋸齒狀波動。
- 流量整形策略:穩定性高,以犧牲部分峰值吞吐換取平穩輸出。
- 自適應擁塞控制策略:高負載下可動態收斂至穩定高吞吐點,但存在冷啟動探測開銷。
基礎重試策略
適用於個人測試、本地指令碼等低並發情境。不限制發送速率,僅在收到 429 或 5xx 時觸發帶隨機抖動的指數退避重試。
沒有前置流量控制,多線程並發下易觸發限流並導致請求積壓。
程式碼範例
import openai
from openai import OpenAI
from tenacity import (
    retry,
    stop_after_attempt,
    wait_random_exponential,
    retry_if_exception_type
)

RETRYABLE_ERRORS = (
    openai.RateLimitError,
    openai.InternalServerError,
    openai.APIConnectionError,
)

@retry(
    wait=wait_random_exponential(min=1, max=60),
    stop=stop_after_attempt(6),
    retry=retry_if_exception_type(RETRYABLE_ERRORS)
)
def chat_with_retry(client, model, messages, max_tokens):
    return client.chat.completions.create(
        model=model,
        max_tokens=max_tokens,
        messages=messages
    )

client = OpenAI(
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
    api_key="YOUR_DASHSCOPE_API_KEY"
)

try:
    response = chat_with_retry(
        client=client,
        model="qwen-plus",
        messages=[{"role": "user", "content": "什麼是指數退避重試?"}],
        max_tokens=1024
    )
    print(response.choices[0].message.content)
except Exception as e:
    print(f"請求失敗: {e}")
import time
import random
import openai
from openai import OpenAI

RETRYABLE_ERRORS = (
    openai.RateLimitError,
    openai.InternalServerError,
    openai.APIConnectionError,
)

def chat_with_retry(client, model, messages, max_tokens):
    attempt = 0
    max_retries = 5
    base_delay = 1
    max_delay = 60

    while attempt <= max_retries:
        try:
            return client.chat.completions.create(
                model=model,
                max_tokens=max_tokens,
                messages=messages
            )
        except RETRYABLE_ERRORS as e:
            attempt += 1
            if attempt > max_retries:
                raise e
            backoff = min(max_delay, base_delay * (2 ** (attempt - 1)))
            sleep_time = backoff + random.uniform(0, 1)
            print(f"觸發 {type(e).__name__},等待 {sleep_time:.2f}s 後重試...")
            time.sleep(sleep_time)

client = OpenAI(
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
    api_key="YOUR_DASHSCOPE_API_KEY"
)

try:
    response = chat_with_retry(
        client=client,
        model="qwen-plus",
        messages=[{"role": "user", "content": "什麼是指數退避重試?"}],
        max_tokens=1024
    )
    print(response.choices[0].message.content)
except Exception as e:
    print(f"請求失敗: {e}")
上述代碼使用指數退避而非固定間隔重試。固定間隔重試會讓所有失敗請求同時重發,再次觸發限流。指數退避 + 隨機抖動將重試打散:
- 等待時間逐步翻倍:如
1s:2s:4s...,避免短時間內反覆請求。 - 加入隨機抖動:引入隨機值(如
2s +/- 0.5s)打散重試流量,防止"紮堆"重試形成二次洪峰(驚群效應)。
系統以分散方式恢複,避免"失敗—集體重試—再次失敗"的惡性迴圈。
請求速率限制策略
被動重試難以應對真實業務流量,頻繁重試增加延遲。該策略引入主動流控:請求發出前先自檢,將無序湧入的請求梳理成符合 RPM 限額的隊列。主動平滑帶來少量可控的排隊延遲,但遠低於”報錯—等待—重試”迴圈的代價——用確定的小代價,避免不確定的大延遲。
適用於 Chatbot 等輕量互動、對首字延遲敏感的線上服務。
用戶端主動排隊分兩級控制:
- RPM 令牌桶:限制每分鐘請求總數。桶容量即 RPM 配額,令牌恒定速率填充。支援預支:令牌不足時可透支未來額度,嚴格 FIFO。
- 並發訊號量:限制並發請求數,防止瞬時高並發觸發 RPS 限制。
兩級控制必須先擷取 RPM 令牌,再擷取並發訊號量。並發槽位是稀缺資源,只應分配給已滿足執行條件的請求。若順序顛倒,高負載下會引發隊頭阻塞——請求佔住槽位卻無令牌可用,所有槽位被佔滿但無請求發出。原則:持有稀缺資源時,不做長耗時等待。
下方代碼將令牌桶初始化為滿桶(initial_tokens=rpm_limit),適合線上服務啟動時立即處理請求。若滿桶啟動觸發限流,可降低初始值(如 initial_tokens=0,空桶啟動),使系統以更平緩的速率進入工作狀態。
該策略不追蹤 Token 用量,長文本任務中仍可能耗盡 TPM 配額。
程式碼範例
import time

class TokenBucket:
    """
    令牌桶實現,用於控制每分鐘請求數 (RPM)。
    支援預支 (Debt) 機制,以保證高並發下的先進先出 (FIFO) 順序。
    """
    def __init__(self, quota_per_minute: float, initial_tokens: float = 0.0):
        self.capacity = quota_per_minute
        self.tokens = initial_tokens
        self.refill_rate = quota_per_minute / 60.0
        self.last_refill = time.monotonic()

    def reserve(self, cost: float = 1.0) -> float:
        """
        申請令牌。
        如果令牌不足,返回需要等待的秒數(支援預支)。
        """
        self._refill()

        # 1. 令牌充足:直接扣除
        if self.tokens >= cost:
            self.tokens -= cost
            return 0.0

        # 2. 令牌不足:計算等待時間並預支
        # 為當前請求"預定"了未來的令牌,確保 FIFO 順序
        deficit = cost - self.tokens
        wait_seconds = deficit / self.refill_rate
        self.tokens -= cost
        return wait_seconds

    def _refill(self):
        """根據流逝時間補充令牌"""
        now = time.monotonic()
        elapsed = now - self.last_refill
        if elapsed > 0:
            self.tokens = min(self.capacity, self.tokens + elapsed * self.refill_rate)
            self.last_refill = now
import asyncio
import openai
from openai import AsyncOpenAI
from tenacity import retry, wait_random_exponential, stop_after_attempt, retry_if_exception_type

class RateLimitedClient:
    def __init__(
        self,
        api_key: str,
        base_url: str = "https://dashscope.aliyuncs.com/compatible-mode/v1",
        rpm_limit: float = 600.0,
        max_concurrency: int = 20
    ):
        self.client = AsyncOpenAI(api_key=api_key, base_url=base_url)
        # 組件 1: RPM 令牌桶 (控制總量)
        self.rpm_bucket = TokenBucket(
            quota_per_minute=rpm_limit,
            initial_tokens=rpm_limit  # 滿桶啟動,適合輕量線上服務
        )
        # 組件 2: 並發訊號量 (控制瞬間並發)
        self.semaphore = asyncio.Semaphore(max_concurrency)

    async def _execute_request(self, model, messages, max_tokens):
        """執行單個請求:依次通過 RPM 檢查和並發限制。"""
        # 1. RPM 檢查 (先拿令牌)
        wait_seconds = self.rpm_bucket.reserve(1.0)
        if wait_seconds > 0:
            await asyncio.sleep(wait_seconds)
        # 2. 並發檢查 (再拿訊號量)
        async with self.semaphore:
            # 3. 發起 API 呼叫
            return await self.client.chat.completions.create(
                model=model,
                messages=messages,
                max_tokens=max_tokens
            )

    @retry(
        wait=wait_random_exponential(min=1, max=60),
        stop=stop_after_attempt(5),
        retry=retry_if_exception_type((
            openai.RateLimitError,
            openai.InternalServerError,
            openai.APIConnectionError
        ))
    )
    async def chat_with_limit(self, model, messages, max_tokens=1024):
        # 設計考量:為什麼重試也要重新拿 Token?
        # 答:為了安全。如果不重新拿,重試帶來的流量脈衝
        # 可能會瞬間突破 RPM 限制
        return await self._execute_request(model, messages, max_tokens)
流量整形策略
RAG 即時入庫、長文檔批量分析等高穩吞吐情境中,請求速率限制存在 TPM 盲區。流量整形策略升級為雙重資源感知(RPM & TPM),並在發送端引入整形機制,將突發脈衝削峰填穀為平滑流速。
在請求速率限制基礎上,增強了以下能力:
- 雙重資源管控(RPM & TPM):同時維護 RPM 和 TPM 令牌桶,所有請求在發出前必須通過兩個維度配額檢查。
- 輸入事前預扣,輸出事後結算:模型輸出長度請求前未知。TPM 令牌桶發送時僅預扣輸入 Token,完成後結算實際輸出。即使結算後令牌為負,後續請求也會等待回正,自然平滑流速。
- 勻速預熱:冷啟動期間,令牌發放速率隨時間軸性增長,消除初始突發風險。
- 平滑限速:通過強制請求間保持最小間隔(Pacing),平滑發送速率,降低觸發速率限制的風險。
備選方案:若業務對啟動時的微小排隊延遲不敏感,可複用標準令牌桶(設 initial_tokens=0)實現安全啟動,降低用戶端複雜度。Python 令牌桶僅用於示範思路,生產環境建議使用成熟限流組件(如 Java Guava 的 SmoothRateLimiter)。
程式碼範例中平滑等待置於並發鎖內部。多個請求可能在等待結束後同時競爭訊號量,導致流量在出口再次擁堵。鎖內平滑雖輕微降低並發效率,但能確保發送間隔可控。
完整的流量整形鏈路為:預估輸入 Token → 雙重准入(RPM & TPM)→ 並發鎖 → 平滑整形 → 發送 → 輸出 Token 結算。
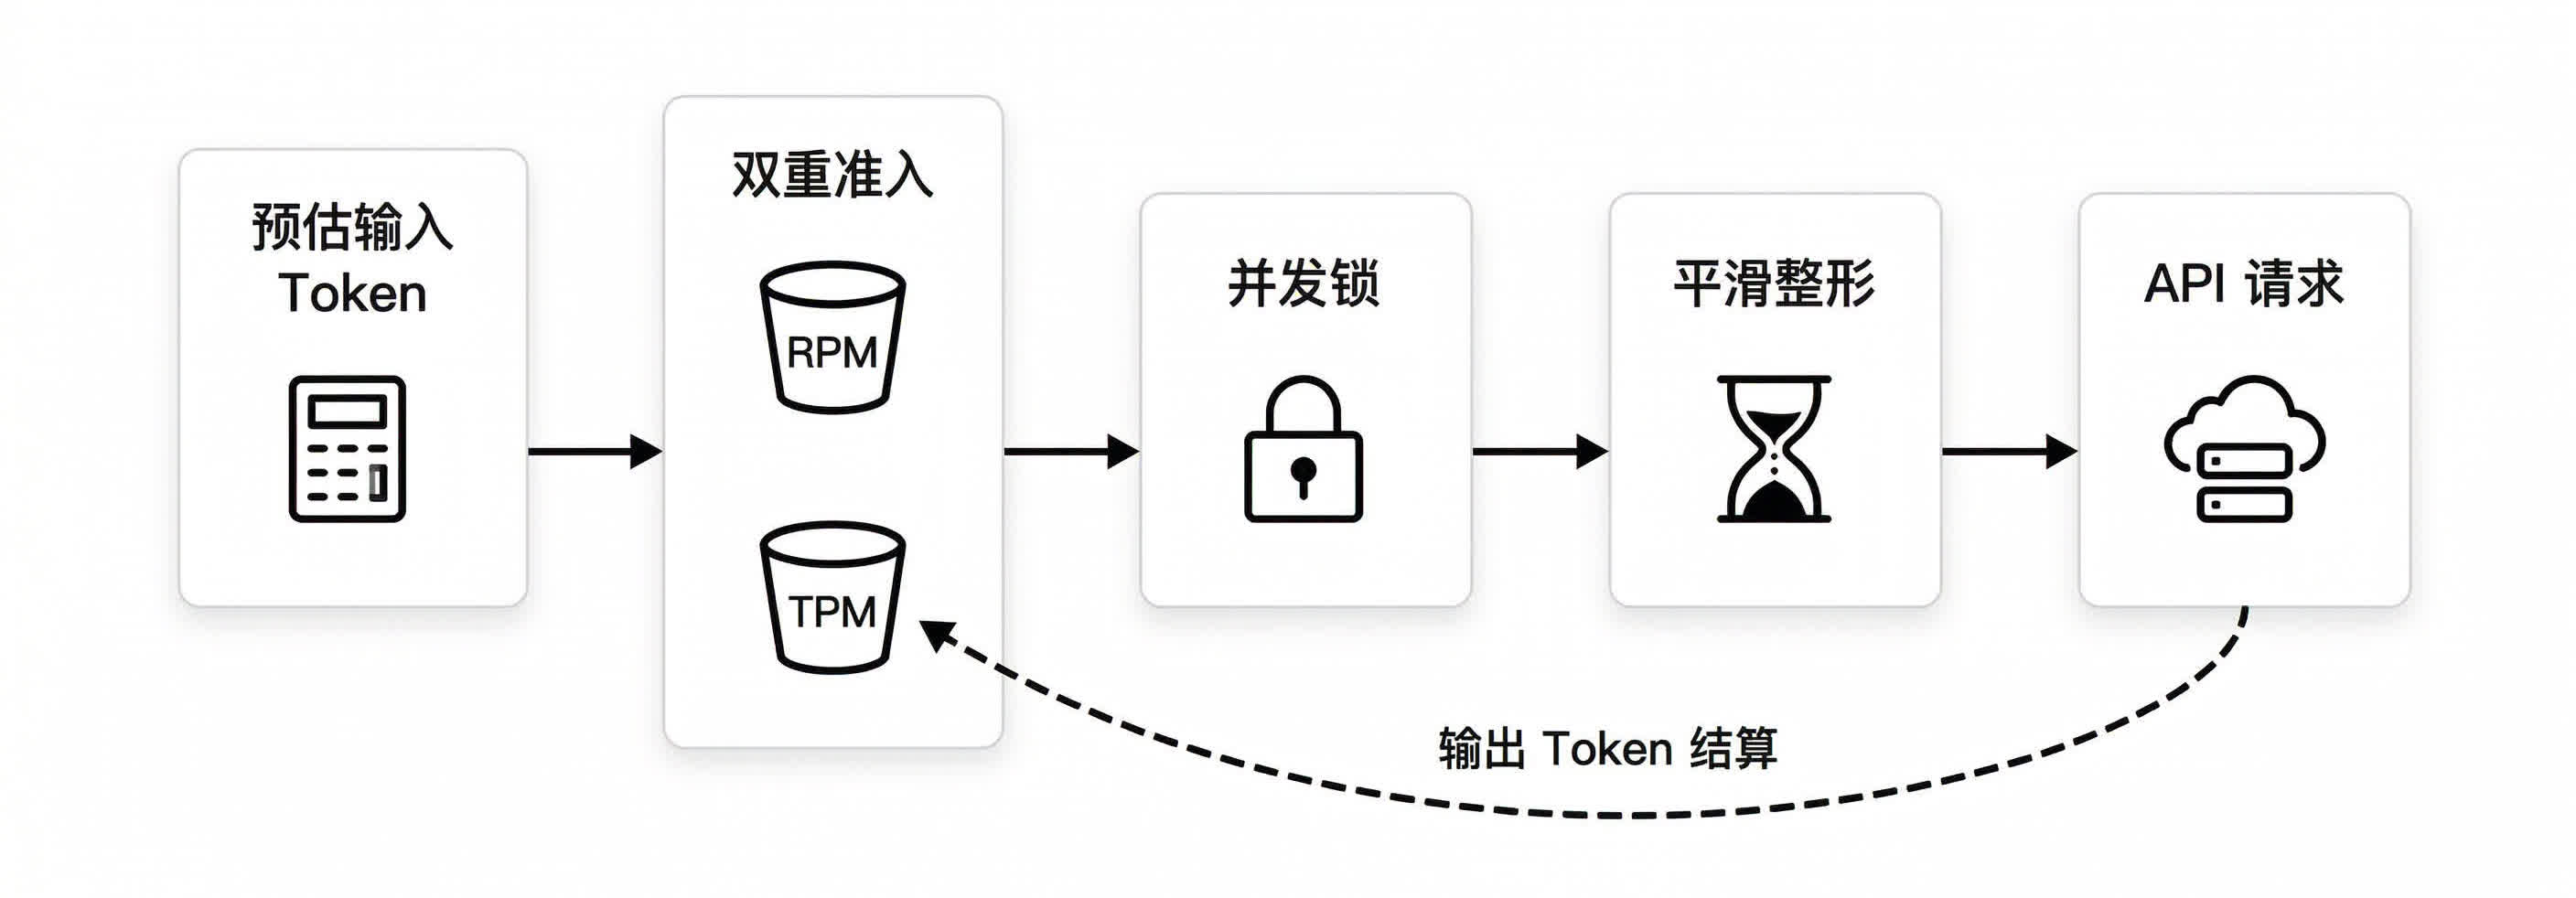
該策略採用保守平滑機制,會犧牲部分峰值並發,不適用於極致低延遲的線上服務。
程式碼範例
import time

class TokenBucket:
    """進階令牌桶,支援勻速預熱 (Continuous Warm-up) 機制。"""
    def __init__(self, quota_per_minute: float, warmup_seconds: float = 0.0):
        self.capacity = quota_per_minute
        self.tokens = 0.0
        self.target_refill_rate = quota_per_minute / 60.0
        self.warmup_seconds = warmup_seconds
        self.start_time = time.monotonic()
        self.last_update_time = self.start_time
        self.cumulative_generated = 0.0

    def _get_cumulative_tokens(self, t: float) -> float:
        if t <= 0:
            return 0.0
        R = self.target_refill_rate
        T = self.warmup_seconds
        if T <= 0:
            return R * t
        if t <= T:
            return (R / (2 * T)) * (t ** 2)
        else:
            warmup_total = (R * T) / 2.0
            return warmup_total + R * (t - T)

    def _get_time_for_cumulative_tokens(self, target_cumulative: float) -> float:
        if target_cumulative <= 0:
            return 0.0
        R = self.target_refill_rate
        T = self.warmup_seconds
        if T <= 0:
            return target_cumulative / R
        warmup_total = (R * T) / 2.0
        if target_cumulative <= warmup_total:
            return ((2 * T * target_cumulative) / R) ** 0.5
        else:
            return (target_cumulative - warmup_total) / R + T

    def reserve(self, cost: float = 1.0) -> float:
        now = time.monotonic()
        relative_now = now - self.start_time
        current_cumulative = self._get_cumulative_tokens(relative_now)
        new_tokens = current_cumulative - self.cumulative_generated
        self.tokens = min(self.capacity, self.tokens + new_tokens)
        self.cumulative_generated = current_cumulative
        self.last_update_time = now
        if self.tokens >= cost:
            self.tokens -= cost
            return 0.0
        deficit = cost - self.tokens
        self.tokens -= cost
        target_cumulative = self.cumulative_generated + deficit
        target_time = self._get_time_for_cumulative_tokens(target_cumulative)
        wait_seconds = target_time - relative_now
        return max(0.0, wait_seconds)

    def adjust(self, amount: float):
        self.tokens = min(self.capacity, self.tokens + amount)
import time

class SmoothRateLimiter:
    def __init__(self, rate_per_minute: float):
        self._min_interval = 60.0 / rate_per_minute
        self._last_operation = time.monotonic()

    def reserve(self) -> float:
        now = time.monotonic()
        elapsed = now - self._last_operation
        wait_time = max(0.0, self._min_interval - elapsed)
        self._last_operation = now + wait_time
        return wait_time
import asyncio

class TrafficShapingClient:
    def __init__(self):
        self._rpm_bucket = TokenBucket(quota_per_minute=600)
        self._tpm_bucket = TokenBucket(quota_per_minute=1_000_000)
        self._smooth_limiter = SmoothRateLimiter(rate_per_minute=600)
        self._concurrency_semaphore = asyncio.Semaphore(20)

    async def _execute_throttled_request(self, model, prompt, max_tokens, input_tokens):
        # [步驟 1] 雙重准入控制 (Parallel Admission)
        # 同時檢查 RPM 和 TPM,取兩者中較長的等待時間
        wait_rpm = self._rpm_bucket.reserve(1.0)
        # TPM 檢查僅針對輸入 Token 申請額度
        wait_tpm = self._tpm_bucket.reserve(input_tokens)
        admission_wait = max(wait_rpm, wait_tpm)
        if admission_wait > 0:
            await asyncio.sleep(admission_wait)

        # [步驟 2] 擷取並發鎖 (Concurrency Lock)
        async with self._concurrency_semaphore:
            # [步驟 3] 流量整形 (Traffic Shaping)
            # 關鍵:在鎖內進行平滑等待
            # 犧牲部分並發效率,換取發送間隔的精準可控
            smooth_wait = self._smooth_limiter.reserve()
            if smooth_wait > 0:
                await asyncio.sleep(smooth_wait)

            # [步驟 4] 發送請求
            content, actual_usage = await self._send_chat_request(model, prompt, max_tokens)

            # [步驟 5] 輸出 Token 結算
            output_tokens = actual_usage.completion_tokens
            if output_tokens > 0:
                self._tpm_bucket.adjust(-output_tokens)
            return content
自適應擁塞控制策略
適用於 API Gateway、複雜代理、多租戶等大規模動態負載情境。
說明
選型提示:該策略並非通用方案該策略的價值在於應對高度不確定與劇烈波動的環境,並非普適選擇:
- 效能悖論:若負載可預測(如定量批處理),直接設定最優靜態參數通常優於需要"試探與收斂"的動態探測。
- 探測損耗:動態演算法必然伴隨冷啟動爬坡與試探波動,在可知情境下是不必要的效能損耗。
- 維護成本:閉環反饋機制增加系統複雜度與排查難度。
除非業務規模極大、負載複雜且波動顯著,否則優先選擇更簡單的前三種策略。
請求速率限制和流量整形基於靜態配額,負載穩定時完全適用。但在網關級情境下,下遊負載複雜多變(短請求與深度推理交織),平台閾值也動態波動,靜態策略難以兼顧效率與穩定。
該策略借鑒 BBR,建立基於 EBP(Elastic Bandwidth Probing) 的閉環控制系統。以 RPM/TPM 配額為指導上限,根據即時反饋(延遲、限流訊號)動態計算最佳發送速率。
- 彈性探測(EBP):記憶歷史最高成功水位,根據當前並發與最高水位的距離類比彈簧張力計算探測增益(距離遠加速,近減速)。疊加微小線性推力確保高飽和區仍能探索邊界。
- TPT 擁塞感知:大模型產生耗時與長度成正比,長文本延遲高不代表擁塞。使用 TPT(Time Per Token)作為指標,濾除內容長度雜訊,僅在 TPT 顯著惡化時判定為計算飽和。
- 防突發調速器:無論 EBP 算出的目標多高,調速器強制限制並發增長加速度,確保流量平滑上升,避免階梯跳變觸發增速限制。
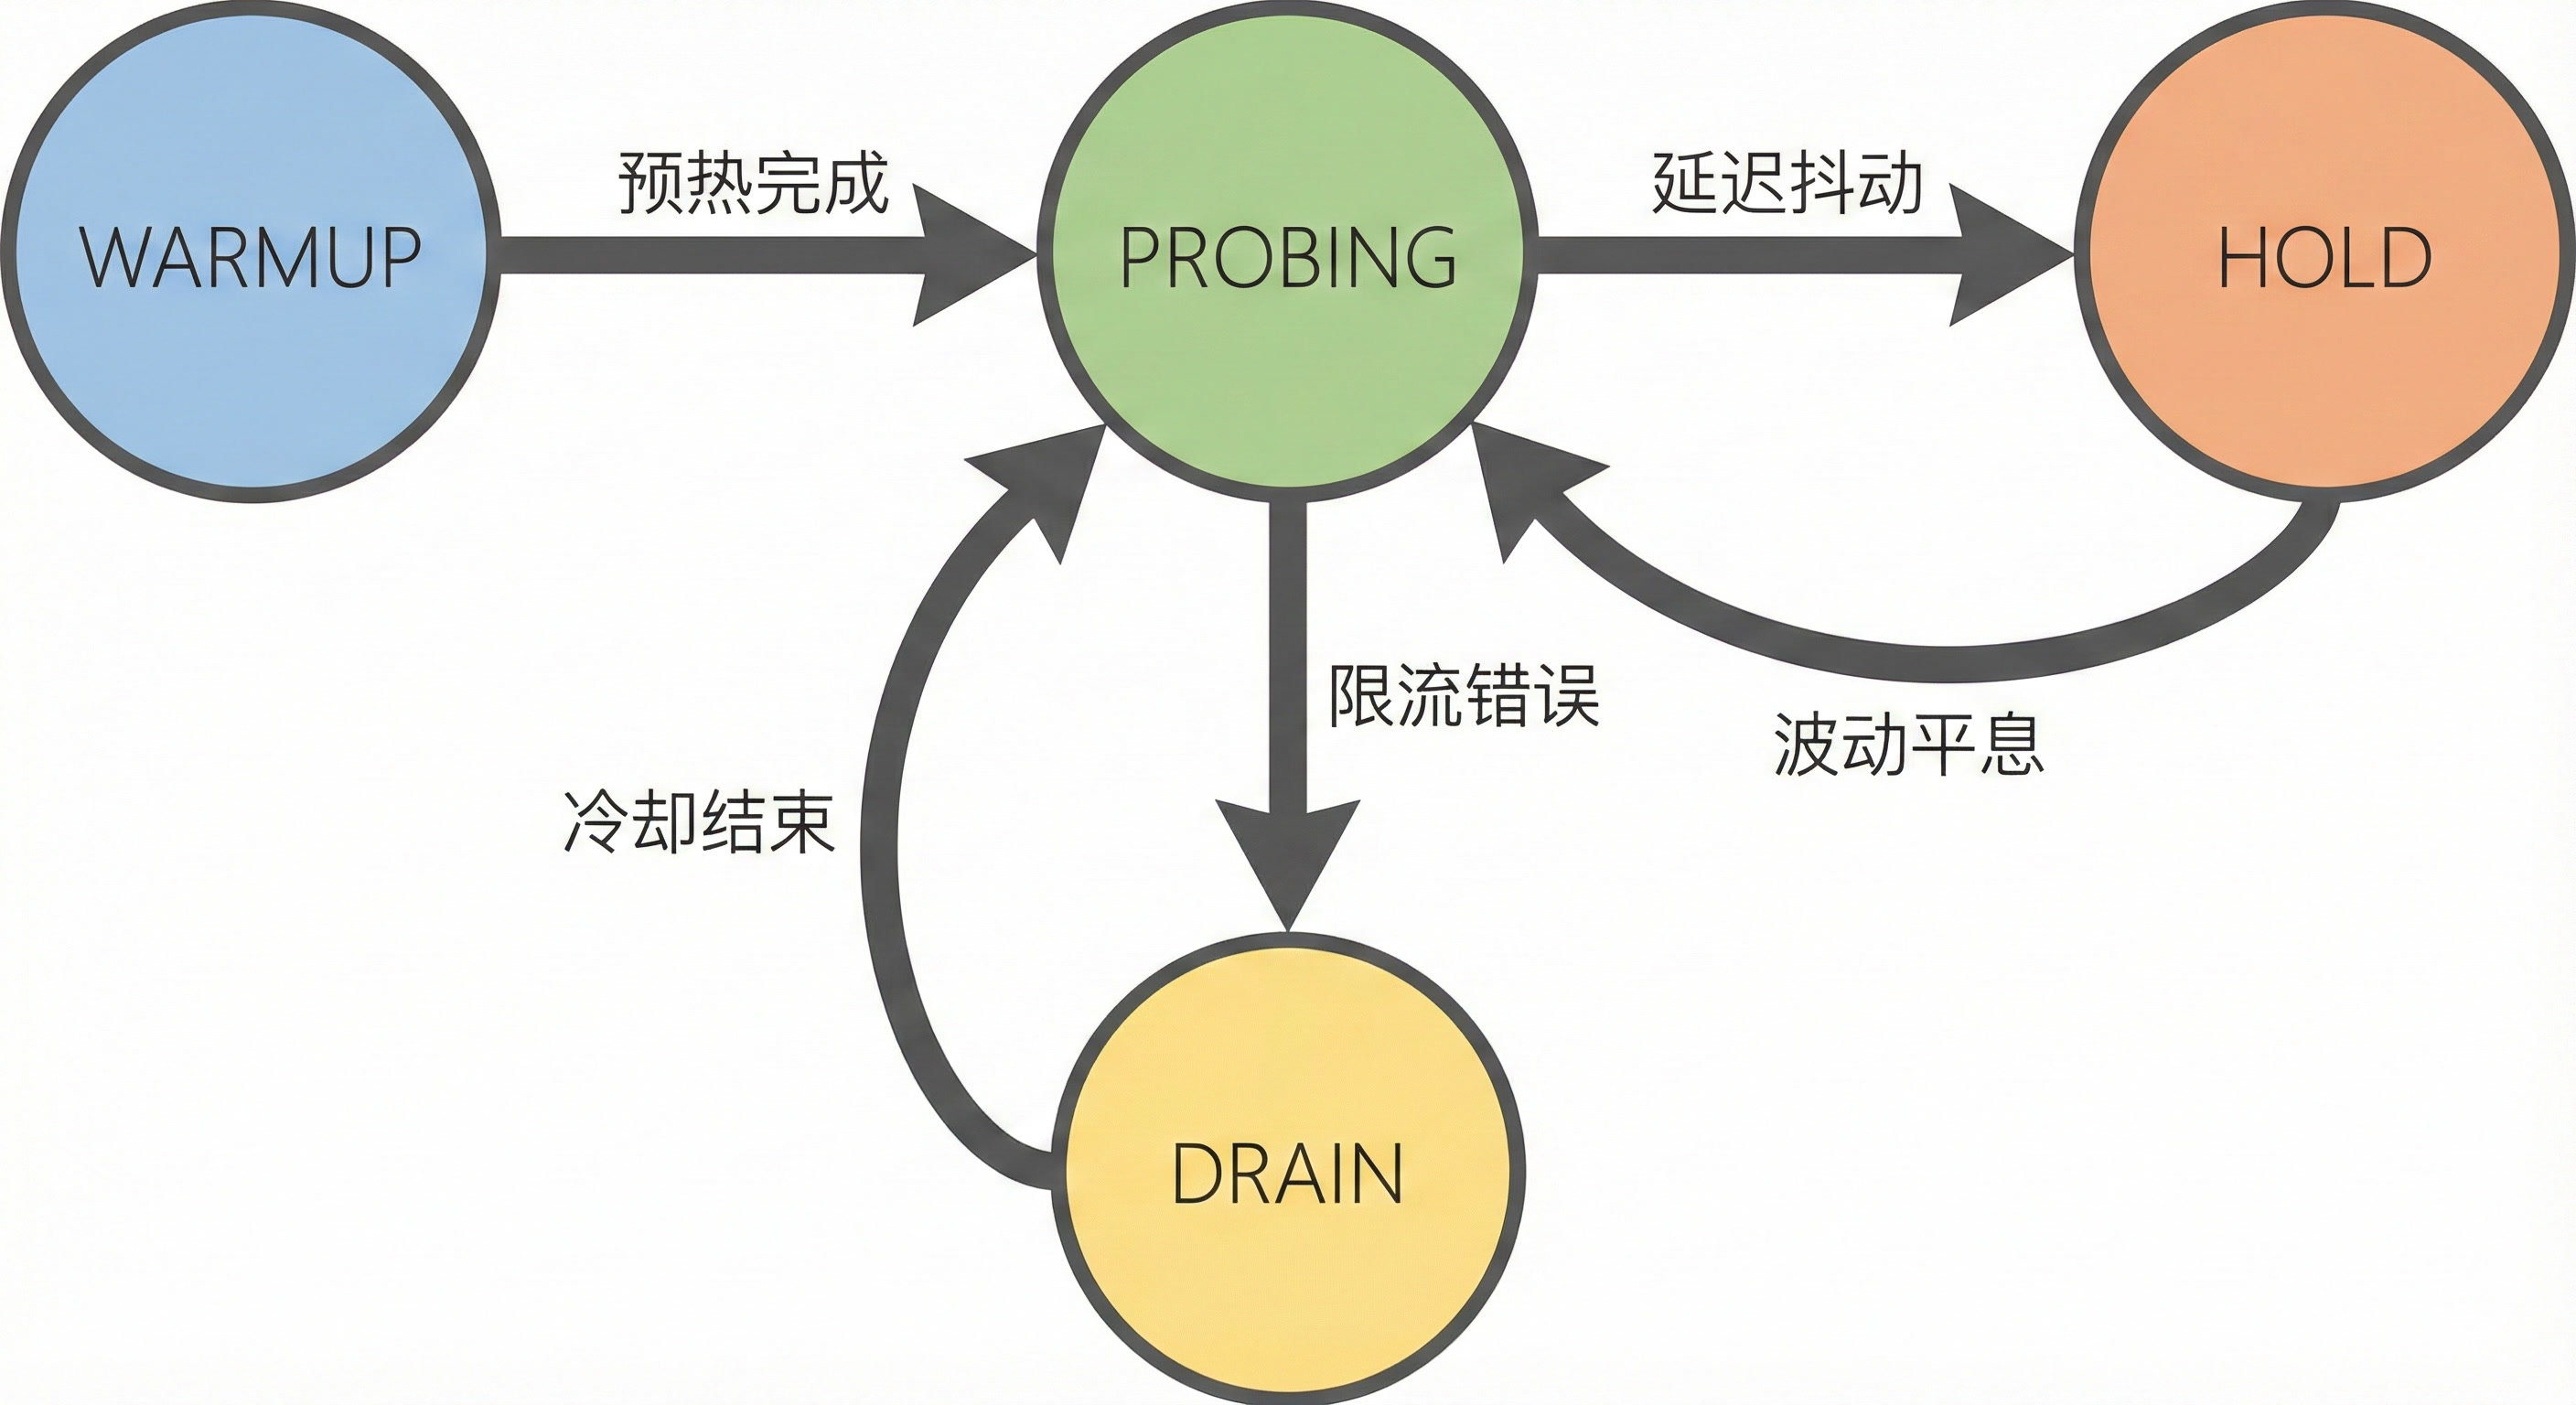
相較於原生 BBR,針對大模型特性做了以下改造:
- 指導性探測:引入已知的 RPM/TPM 配額作為"指導上限",避免盲目試探導致的頻繁撞牆。
- 訊號源改造(RTT → TPT):原生 BBR 依賴 RTT,但大模型中內容長度帶來的延遲差異遠大於網路抖動,改用 TPT 剔除幹擾。
- 響應機制強化(ProbeRTT → Hold):面對延遲波動,選擇保持當前並發水平,而非主動退避降低吞吐。
- 硬限流響應(Packet Loss → 429 Drain):一旦觸發
429錯誤,進入激進的 Drain 狀態,冷卻期結束後執行快速恢複。
局限:
- TPT 噪點:當前 TPT 按"總延遲 / 總 Token 數"粗估,混入了網路往返、排隊與首字產生耗時,易受抖動或長輸入幹擾而虛高,可能誤觸發 Hold 狀態。
- 大請求饑餓:為追求調度效能採用了非嚴格 FIFO 喚醒機制,配額緊缺時短 Token 請求可能搶佔資源,導致長 Token 請求等待過長。
- 冷啟動:需要預熱時間建立統計模型,低負載或短時任務中輸送量可能低於前三種策略。
程式碼範例
class ElasticCongestionController:
    async def acquire(self):
        """[准入階段] 請求發起前的檢查"""
        # 1. SSR 慢啟動重啟:若空閑太久,主動衰減上限
        #    防止過時水位導致的突發流量
        if self.is_idle_too_long():
            self.perform_slow_start_restart()

        # 2. 熔斷檢查:若處於 DRAIN (冷卻) 狀態,強制等待
        if self.state == CongestionState.DRAIN:
            await self.wait_for_cooldown()

        # 3. 雙重預算檢查:同時檢查並發槽位和 Token 預算
        await self.wait_for_budget(request_tokens)

    async def release(self, latency, actual_tokens, error):
        """[反饋階段] 請求結束後的決策"""
        if error:
            # [故障響應] 遇限流錯誤 (429/503):立即排水 + 乘性回退
            self.state = CongestionState.DRAIN
            self.concurrency_limit *= self.backoff_factor  # e.g. 0.7
            return

        # [正常響應] 計算 TPT (Time-Per-Token)
        current_tpt = latency / actual_tokens

        # [擁塞感知] TPT 突增 (產生變慢):進入 HOLD 觀察
        # 維持並發水平,不退避也不增長
        if current_tpt > self.metrics.ema_tpt * 2.0:
            self.state = CongestionState.HOLD
        else:
            # [穩態探測] 網路健康:執行 EBP 彈性探測
            self.state = CongestionState.PROBING
            self.update_limit_via_ebp()
def probe_next_limit(self, current_limit, max_known_capacity):
    """
    計算下一個並發上限
    核心公式:Next = Max(彈簧張力, 線性推力) + 調速器平滑
    """
    # 1. 計算物理上限 (Little's Law)
    # 理論上限 = 輸送量 * 延遲 * 緩衝因子
    dynamic_ceiling = self.metrics.tps * self.metrics.avg_latency * 1.2

    # 2. 彈簧邏輯 (Spring Tension)
    # 距離歷史最高水位越遠,張力越大(加速);越近則越小(減速)
    tension = 1.0 - (current_limit / max_known_capacity)
    spring_target = current_limit * (1.0 + tension * gain)

    # 3. 線性推力 (Additive Thrust)
    # 解決"芝諾悖論":張力趨近於 0 時,強制疊加微小線性增量
    # 確保系統能突破局部極值,持續探索邊界
    linear_target = current_limit + self.min_additive_step

    raw_target = max(spring_target, linear_target)

    # 4. 防突發調速器 (Rate Governor)
    # 限制並發增長的加速度,防止階梯跳變
    final_limit = self.governor.smooth(raw_target)

    return min(final_limit, dynamic_ceiling)
class CongestionMetrics:
    def update_stats(self, latency, token_count):
        """
        [感應器] 即時更新統計指標
        使用 EMA (指數移動平均) 濾除長尾請求的雜訊
        """
        alpha = 0.2  # 平滑因子

        # 1. 估算單請求大小 (Token Size)
        self.ema_tokens = (1 - alpha) * self.ema_tokens + alpha * token_count

        # 2. 估算 TPT (Time Per Token)
        # 用 TPT 代替 Latency,消除 LLM 產生長度不同帶來的誤差
        instant_tpt = latency / token_count
        self.ema_tpt = (1 - alpha) * self.ema_tpt + alpha * instant_tpt

    def track_inflight(self, estimated_tokens):
        """
        [盲區填充] 修正"響應後才計數"的滯後性
        請求發起瞬間,立即預扣額度
        """
        self.inflight_tokens += estimated_tokens
架構兜底方案
當平台配置和用戶端流控仍無法滿足可用性或峰值吞吐要求時,可在架構層面引入兜底。
模型降級(Fallback)
主模型因限流或異常無法響應時,自動回退至配額寬裕的備選模型,保障主流程持續可用。
降級鏈路設計原則- 選擇不同系列的模型:百鍊限流按模型獨立計算,可選不同模型作為備選,例如
qwen3.6-plus降級至qwen3.6-flash。 - 僅限流錯誤時降級:降級針對
429限流錯誤,網路逾時或參數錯誤切換模型無法解決。 - 備選模型需提前驗證:確保備選模型支援業務所需功能(如 Function Calling、結構化輸出),避免降級後功能異常。
程式碼範例
以下樣本示範了基於 429 錯誤碼的模型降級邏輯:主模型請求觸發限流時,自動切換至備選模型重試。
import os
import asyncio
from openai import AsyncOpenAI, APIStatusError

# 主模型與備選模型(不同系列,獨立配額)
PRIMARY_MODEL = "qwen3.6-plus"
FALLBACK_MODEL = "qwen3.6-flash"

client = AsyncOpenAI(
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1"
)

async def chat_with_fallback(messages: list) -> str:
    """帶降級的請求:主模型限流時自動切換備選模型。"""
    for model in [PRIMARY_MODEL, FALLBACK_MODEL]:
        try:
            response = await client.chat.completions.create(
                model=model,
                messages=messages
            )
            return response.choices[0].message.content
        except APIStatusError as e:
            if e.status_code == 429 and model == PRIMARY_MODEL:
                print(f"[限流觸發] {model},降級至 {FALLBACK_MODEL}")
                continue
            raise
    raise RuntimeError("所有模型均不可用")

async def main():
    result = await chat_with_fallback(
        messages=[{"role": "user", "content": "你好"}]
    )
    print(result)

if __name__ == "__main__":
    asyncio.run(main())
模型降級可與用戶端流控策略組合使用。例如,在請求速率限制策略的重試邏輯中整合降級判斷:當重試次數耗盡仍觸發限流時,切換至備選模型。
基於訊息佇列(MQ)的削峰填穀
不要求即時響應的後端業務,可引入訊息中介軟體(如 RabbitMQ、Kafka)削峰。突發流量先寫入 MQ,消費端按限流配額勻速拉取處理,從根本上解耦前端峰值與後端調用。
適用情境:使用者提交任務後可非同步通知結果的業務,如工單處理、內容審核、批量標註等。
設計要點:
- 消費速率控制:消費端應配合請求速率限制或流量整形策略,按 RPM/TPM 配額勻速消費,而非無限制地拉取訊息。
- 死信處理:多次重試仍失敗的訊息轉入無效信件佇列並警示,避免無限重試阻塞消費。
- 背壓傳遞:MQ 積壓超閾值時向上遊反饋壓力(如返回排隊狀態),避免隊列無限增長。
生產環境注意事項
上述樣本基於 Python asyncio 單線程迴圈,用於示範核心演算法。大規模生產前需關注以下問題。
-
非文本模型的適配
上述策略以文本模型為例,核心思想同樣適用於多模態模型(映像產生、語音合成等)。計量單位不同,但本質均為限制提交速率和處理容量:
- 語音辨識等模型:通常受單位時間內請求數(如 RPM)和用量(如音頻時間長度)雙重約束,策略與文本模型基本一致。
- 圖片/視頻等模型:通常受任務提交速率和並發任務數約束。可沿用請求速率限制策略的思路,限制任務提交速率並配合訊號量控制並發數。
無論限流指標如何變化,用戶端主動流控的原則不變。只需將計數器或探測指標替換為對應模態的指標。具體規則參見模型限流條件。
-
並行存取模型的原子性
樣本:
asyncio單線程協作式調度,狀態修改天然原子,單進程內無需額外並發保護。生產建議:多線程或多進程環境需確保令牌桶及統計視窗的並發安全,否則競態條件會導致流控失效。
-
分布式限流
樣本:流控組件均為本地記憶體實現。
生產建議:多執行個體部署中各執行個體獨立流控,實際總用量可能超標。建議使用中心化計數器(如 Redis)統一管控。
-
優先順序隊列與饑餓預防
樣本:均未實現優先順序區分。自適應擁塞控制策略為追求調度效能採用了非嚴格 FIFO 喚醒。
生產建議:業務存在高低優先順序請求時,建議實現加權優先順序隊列保障高優頻寬,同時為低優隊列保留最小配額防止饑餓。