本文介紹當您遇到磁碟使用率超過85%,甚至達到100%,導致Elasticsearch叢集或Kibana無法正常提供服務時,採用的排查方式。
免責聲明:本文檔可能包含第三方產品資訊,該資訊僅供參考。阿里雲對第三方產品的效能、可靠性以及操作可能帶來的潛在影響,不進行任何暗示或其他形式的承諾。
問題一:叢集磁碟使用率過高,並且報錯index read_only
問題描述
-
在進行索引請求時,返回類似
index read_only的報錯。例如FORBIDDEN/12/index read-only / allow delete (api)];]。 -
叢集處於Red狀態,嚴重情況下存在節點未加入叢集的情況(可通過
GET _cat/nodes?查看),並且存在未分配的分區(可通過GET _cat/allocation?v查看)。說明Red狀態代表部分主分區不可用,可能已經遺失資料。
-
通過Kibana控制台建立管道、註冊Beats時報錯:
internal server error。 -
通過Elasticsearch控制台的叢集監控頁面,或者登入Kibana控制台進入監控頁面,動態查看近一段時間的叢集負載,磁碟使用率曾達到100%。
問題原因
上述問題是由於磁碟使用率過高導致的。資料節點的磁碟使用率存在以下三個水位線,超過水位線可能會影響Elasticsearch或Kibana服務:
-
超過85%,會導致新的分區無法分配。
-
超過90%,Elasticsearch會嘗試將對應節點中的分區遷移到其他磁碟使用率比較低的資料節點中。
-
超過95%,系統會對Elasticsearch叢集中的每個索引強制設定
read_only_allow_delete屬性,此時索引將無法寫入資料,只能讀取和刪除對應索引。
解決方案
凍結索引(_freeze,Elasticsearch 7.x及以下版本支援,8.x已廢棄)或關閉索引(_close)不會釋放磁碟空間。這兩種操作只是將索引設為唯讀並降低記憶體等資源佔用,資料仍保留在磁碟上。要釋放磁碟空間,需要刪除索引資料。
-
刪除資料以釋放磁碟空間。
根據實際需求,選擇以下任一方式刪除資料:
-
方式一:刪除整個索引
執行以下命令刪除整個索引,物理刪除索引資料並立即釋放磁碟空間。
警告資料刪除後將無法恢複,請謹慎操作。您也可以選擇保留資料,但需進行磁碟擴容,詳情請參見升配叢集。
curl -u <username>:<password> -XDELETE http://<host>:<port>/<index-name>-
<host>表示Elasticsearch執行個體的公網或私網地址,建議使用前先確認相關白名單是否開啟。 -
執行命令後,如果叢集無法響應,建議觸發強制重啟,在重啟階段嘗試執行刪除命令。
-
-
方式二:刪除部分文檔後強制合并
如果只需刪除索引中的部分或全部文檔而保留索引結構,先通過
_delete_by_queryAPI刪除文檔,再執行_forcemerge強制合并segment以回收已刪除文檔佔用的磁碟空間。在Kibana的Dev Tools中執行以下命令刪除文檔(以刪除全部文檔為例):
POST /<index-name>/_delete_by_query
{
  "query": {
    "match_all": {}
  }
}
文檔刪除完成後,執行以下命令強制合并segment以釋放磁碟空間:
POST /<index-name>/_forcemerge?max_num_segments=1
-
-
檢測叢集索引是否依然為read_only狀態,如果是,執行以下命令,將叢集中所有索引的
index.blocks.read_only_allow_delete屬性設定為null,使叢集中不再存在read_only狀態的索引。PUT _settings { "index.blocks.read_only_allow_delete": null } -
檢測叢集是否依然為Red狀態,如果是,可使用
_cat/allocation?v命令查看叢集中是否存在未分配的分區。 -
如果存在未分配的分區,可執行
GET _cluster/allocation/explain命令查看未分配分區的原因。如果原因如下圖,請手動執行POST /_cluster/reroute?retry_failed=true命令。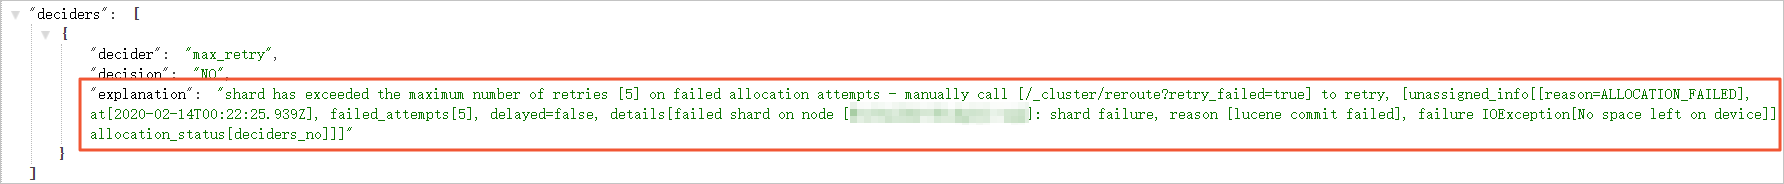 說明
擴容或清理資料後仍報錯:磁碟使用率曾達到100%會導致分區分配失敗,並累計失敗重試次數。即使隨後完成磁碟擴容或清理了資料,部分分區仍可能停留在未分配(unassigned)狀態,叢集對外表現為查詢報503
search_phase_execution_exception等錯誤。此時需手動執行POST /_cluster/reroute?retry_failed=true重試失敗的分區分配,命令返回後需等待分區資料恢複完成,叢集才能恢複正常服務。 -
等待分區下發完成後,查看叢集狀態。如果叢集狀態依然為Red,請聯絡阿里雲支援人員工程師解決。
問題二:磁碟
常見問題
如何臨時調整磁碟水位限制以恢複叢集健康狀態?
當叢集因磁碟水位限制導致狀態不健康、存在未分配分區,且無法立即擴容時,可在Kibana的Dev Tools中執行以下命令,臨時調高磁碟水位閾值(以將low閾值調整為88%為例),使受水位限制而未分配的分區重新分配。
PUT _cluster/settings
{
  "transient": {
    "cluster.routing.allocation.disk.watermark.low": "88%"
  },
  "persistent": {
    "cluster.routing.allocation.disk.watermark.low": "88%"
  }
}該操作僅為臨時應急方案。叢集恢複Green後,請儘快通過控制台進行原地滾動變更升級配置,或清理無用資料,避免長期依賴調高後的水位線。
刪除索引後磁碟空間多久開始釋放?
刪除索引後,磁碟空間通常在幾分鐘到半小時內開始釋放,並在短時間內反映到監控指標中。
如果長時間仍未釋放,建議檢查是否存在其他佔用(例如未刪除的索引、快照或日誌),或確認監控指標是否存在重新整理延遲。
更多資訊
為避免磁碟使用率過高影響Elasticsearch服務,建議開啟磁碟使用率監控警示,及時查收警示簡訊,提前做好防禦措施,詳情請參見配置叢集警示。