As tarefas de transformação de dados oferecem métricas operacionais, um painel integrado e alertas de monitoramento configuráveis para acompanhar a integridade e o desempenho das tarefas.
Dados de métricas
Para coletar métricas de execução das tarefas de Data Transformation (New Version), ative os Job Operational Logs do SLS. Para mais informações, consulte Gerencie service logs.
Painel
O Simple Log Service cria automaticamente um painel na página de detalhes de cada tarefa de transformação de dados e exibe as métricas operacionais correspondentes.
Procedimento
Faça login no console do Simple Log Service.
-
Na seção Projects, clique em no projeto desejado.

No painel de navegação à esquerda, escolha .
Clique em na tarefa de transformação de dados desejada e visualize o painel na seção Execution Status.
Métricas gerais
O painel inclui as seguintes métricas principais:
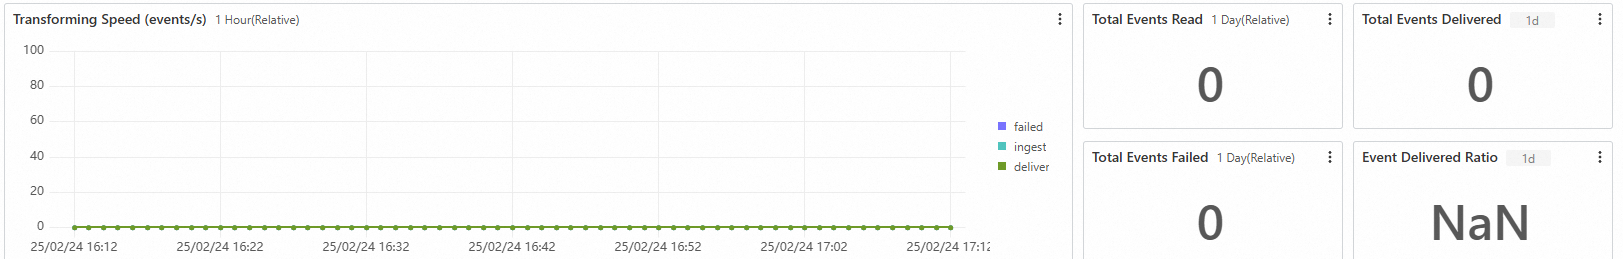
-
Taxa de processamento: eventos processados por segundo, calculados em uma janela de 1 minuto dentro de um período de 1 hora por padrão.
ingest: quantidade de eventos lidos de todos os shards no logstore de origem.
deliver: quantidade de eventos gravados com sucesso no logstore de destino.
failed: quantidade de eventos lidos do logstore de origem que falharam durante a transformação.
Total de eventos lidos: soma total de eventos lidos de todos os shards no logstore de origem. O período estatístico padrão é de um dia.
Total de eventos entregues: soma total de eventos gravados com sucesso em todos os logstores de destino. O período estatístico padrão é de um dia.
Total de eventos com falha: soma total de eventos lidos do logstore de origem que falharam durante a transformação. O período estatístico padrão é de um dia.
Taxa de entrega de eventos: proporção entre eventos entregues com sucesso ao logstore de destino e o total de eventos lidos do logstore de origem. O período estatístico padrão é de um dia.
Detalhes dos shards
As métricas no nível de shard são coletadas em intervalos de um minuto conforme a tarefa lê dados do Logstore de origem.
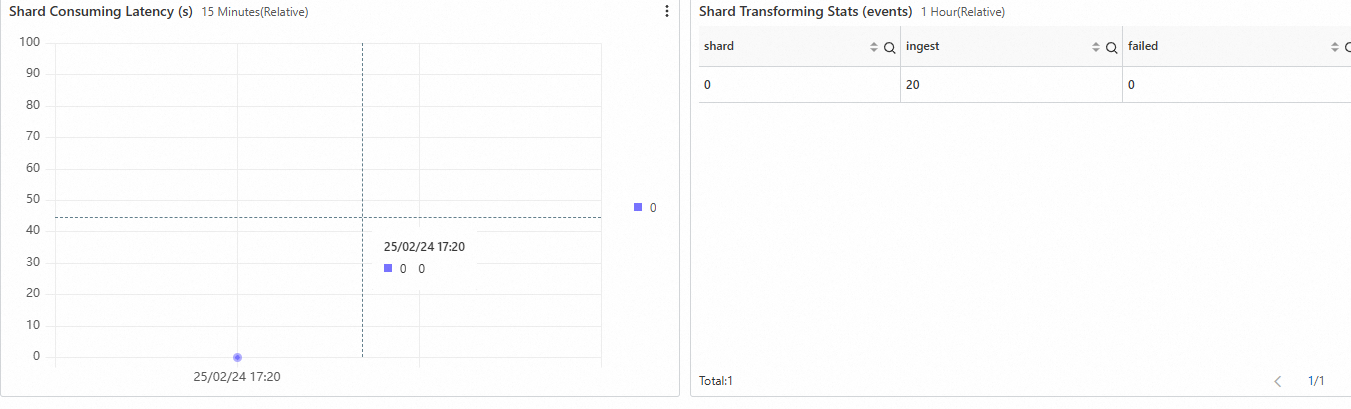
Latência de consumo de shard (s): diferença de tempo (em segundos) entre o horário de ingestão do evento mais recente e o horário de ingestão do evento atualmente processado, indicando o atraso de processamento por shard.
-
Estatísticas de shards ativos: o período estatístico padrão é de uma hora.
shard: ID do shard.
ingest: quantidade de eventos brutos lidos do shard.
failed: quantidade de eventos brutos lidos do shard que falharam durante a transformação.
Exceções de execução
Os detalhes de erro estão disponíveis no campo message.
Por exemplo, a tabela de logs na página de detalhes de erro contém quatro colunas: time, level, action e message. Quando o level é ERROR e a action é deliver, o campo message pode exibir um erro como {"Code":"InvalidArgs","Message":"failed to get sts token: ...The role not exists: acs:ram::*:role/test-role."}. Essa mensagem indica que o sistema não conseguiu obter um token STS porque a função RAM especificada não existe.
Regras de alerta
Crie regras de alerta com base em Metric data para monitorar latência de processamento, exceções e alterações de tráfego. Para conceitos gerais sobre alertas, consulte Alerts. Para instruções passo a passo, consulte Crie a log-based alert rule.
Ao criar uma regra de alerta para uma tarefa de transformação de dados, garanta que a consulta tenha como alvo o mesmo projeto e logstore onde os logs operacionais da tarefa estão armazenados. Para mais informações, consulte Gerencie service logs.
Na caixa de diálogo Query and Analyze, clique em na aba Advanced Settings. Defina Type como Logstore e Authorization Method como Default. Selecione a Region desejada e insira os nomes do project e do logstore. Conforme necessário, configure o dedicated SQL (selecione Auto, Enable ou Disable) e o time range. Em seguida, clique em em Confirm.
Monitoramento de latência de processamento
|
Item |
Descrição |
|
Finalidade |
Monitora a latência de consumo de shard em uma tarefa de transformação de dados. Um alerta é acionado se a latência de processamento ultrapassar o limiar especificado. |
|
Métrica associada no painel |
Consulte Shard Consumption Latency (s). |
|
Consulta de análise de exemplo |
Substitua |
|
Configurações da regra de alerta |
Nota
Para evitar falsos alarmes causados por atualizações periódicas de métricas (a cada 1 minuto) ou latência decorrente de picos repentinos de dados, recomendamos o uso dessas configurações. |
|
Como resolver alertas |
Para resolver esses alertas:
|
Monitoramento de exceções de processamento
|
Item |
Descrição |
|
Finalidade |
Aciona um alerta quando ocorre uma exceção durante uma tarefa de transformação de dados. |
|
Métrica associada no painel |
Consulte Runtime exceptions. |
|
Consulta de análise de exemplo |
Substitua |
|
Configurações da regra de alerta |
|
|
Como resolver alertas |
Solucione o problema com base na mensagem de erro:
|
Monitoramento da proporção de volume de dados gravados (comparação entre períodos)
|
Item |
Descrição |
|
Finalidade |
Aciona um alerta com base nas alterações entre períodos na taxa de entrega de dados (volume gravado versus volume lido). A regra compara a taxa atual com o mesmo período do dia e da semana anteriores e aciona um alerta se a alteração ultrapassar os limiares de crescimento ou declínio configurados. |
|
Métrica associada no painel |
Taxa de entrega de eventos: proporção entre eventos entregues com sucesso ao logstore de destino e o total de eventos lidos do logstore de origem. O período estatístico padrão é de um dia. |
|
Consulta de análise de exemplo |
Insira a seguinte consulta na caixa de diálogo Query and Analyze ao criar a regra de alerta. Substitua |
|
Configurações da regra de alerta |
Nota
Para evitar falsos alarmes devido a flutuações periódicas no tráfego de dados brutos, recomendamos definir os limiares de crescimento e declínio diário/semanal em pelo menos 20%, ou ajustar o período de comparação para corresponder ao ciclo do seu tráfego de dados brutos. |
|
Como resolver alertas |
Para resolver esses alertas:
|
Monitoramento da contagem de eventos de origem (comparação entre períodos)
|
Item |
Descrição |
|
Finalidade |
Aciona um alerta se o número de eventos lidos pela tarefa de transformação de dados mudar significativamente em relação ao dia e à semana anteriores. A regra dispara se a contagem de eventos ultrapassar um limiar de crescimento ou ficar abaixo de um limiar de declínio. |
|
Métrica associada no painel |
Total de eventos lidos: soma total de eventos lidos de todos os shards no logstore de origem. O período estatístico padrão é de um dia. |
|
Consulta de análise de exemplo |
Insira a seguinte consulta na caixa de diálogo Query and Analyze ao criar a regra de alerta. Substitua |
|
Configurações da regra de alerta |
Nota
Para evitar falsos alarmes devido a flutuações periódicas no tráfego de dados brutos, recomendamos definir os limiares de crescimento e declínio diário/semanal em pelo menos 20%, ou ajustar o período de comparação para corresponder ao ciclo do seu tráfego de dados brutos. |
|
Como resolver alertas |
Para resolver esses alertas:
|
Monitoramento da contagem de eventos entregues (comparação entre períodos)
|
Item |
Descrição |
|
Finalidade |
Aciona um alerta se o número de eventos gravados pela tarefa de transformação de dados mudar significativamente em relação ao dia e à semana anteriores. A regra dispara se a contagem de eventos ultrapassar um limiar de crescimento ou ficar abaixo de um limiar de declínio. |
|
Métrica associada no painel |
Total de eventos entregues |
|
Consulta de análise de exemplo |
Insira a seguinte consulta na caixa de diálogo Query and Analyze ao criar a regra de alerta. Substitua |
|
Configurações da regra de alerta |
Nota
Para evitar falsos alarmes devido a flutuações periódicas no tráfego de dados brutos, recomendamos definir os limiares de crescimento e declínio diário/semanal em pelo menos 20%, ou ajustar o período de comparação para corresponder ao ciclo do seu tráfego de dados brutos. |
|
Como resolver alertas |
Para resolver esses alertas:
|