O ApsaraDB RDS for SQL Server permite a migração incremental de dados para a nuvem. Primeiro, faça upload dos arquivos de backup completo para o Object Storage Service (OSS) da Alibaba Cloud e use o console do ApsaraDB RDS para restaurar os dados em uma instância específica do ApsaraDB RDS for SQL Server. Por fim, importe arquivos de backup diferencial ou de log para a instância para concluir a migração. Esse processo reduz o tempo de inatividade para alguns minutos.
Casos de uso
Utilize a migração incremental de dados para o RDS SQL Server nos seguintes cenários:
-
Quando você precisa realizar uma migração física para o RDS SQL Server usando arquivos de backup, em vez de uma migração lógica.
NotaA migração física é baseada em arquivos, enquanto a migração lógica gera instruções DML a partir dos dados e as executa na instância de destino do RDS SQL Server.
Uma migração física garante que o banco de dados de destino seja 100% idêntico ao banco de dados de origem. Já a migração lógica não consegue garantir essa consistência. Por exemplo, atributos como fragmentação de índice e informações estatísticas podem divergir após a migração.
-
Quando é necessário um tempo de inatividade mínimo, limitado a poucos minutos.
NotaSe um período de inatividade maior for aceitável (por exemplo, uma interrupção de 2 horas) e seu banco de dados tiver menos de 100 GB, migre seu banco de dados usando um arquivo de backup completo.
Pré-requisitos
-
Sua instância do RDS for SQL Server deve atender aos seguintes requisitos:
A instância deve executar o SQL Server 2012 ou posterior, ou ser uma instância do SQL Server 2008 R2 que utilize discos na nuvem.
A instância não deve conter um banco de dados com o mesmo nome daquele que você está migrando.
O espaço de armazenamento disponível da instância deve ser maior que o tamanho do arquivo de dados que você está migrando. Se o espaço de armazenamento for insuficiente, faça upgrade do armazenamento da instância.
-
O modelo de recuperação do seu banco de dados SQL Server local deve ser
FULL.NotaA migração incremental de dados requer backups de log de transações. O modelo de recuperação Simples não oferece suporte a backups de log de transações.
Um arquivo de backup diferencial grande pode prolongar a migração incremental de dados.
-
Caso faça logon como usuário RAM, você deve atender aos seguintes requisitos:
O usuário RAM deve ter as permissões AliyunOSSFullAccess e AliyunRDSFullAccess. Para mais informações, consulte Controlar acesso ao OSS usando RAM e Controlar acesso ao RDS usando RAM.
-
Certifique-se de que sua conta Alibaba Cloud concedeu à conta de serviço oficial do RDS acesso aos seus recursos do OSS.
Acesse a página Restoration da instância RDS for SQL Server e clique em Restore Backup Data from OSS.
-
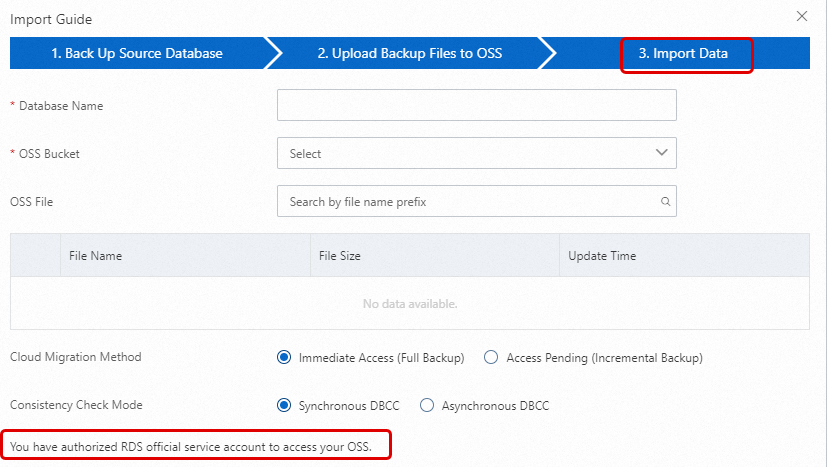
No Import Guide, clique em Next duas vezes para chegar à etapa 3. Import Data.
Se a mensagem You have authorized RDS official service account to access your OSS aparecer no canto inferior esquerdo da página, a autorização já foi concedida. Caso contrário, clique na Authorization URL na página para concedê-la.
-
Você deve criar manualmente uma política de acesso em sua conta Alibaba Cloud e anexá-la ao usuário RAM.
Preparativos
Execute o comando DBCC CHECKDB no banco de dados autogerenciado para verificar se há allocation errors e consistency errors. A saída esperada é a seguinte:
...
CHECKDB found 0 allocation errors and 0 consistency errors in database 'xxx'.
DBCC execution completed. If DBCC printed error messages, contact your system administrator.
Observações
Nível de migração: Esta solução migra apenas um único banco de dados. Para migrar vários bancos de dados ou todos eles, consulte Migração para a nuvem no nível de instância do SQL Server.
Compatibilidade de versão: Não é possível restaurar um backup de uma instância SQL Server autogerenciada para uma instância ApsaraDB RDS for SQL Server que execute uma versão anterior do SQL Server.
Gerenciamento de permissões: Após autorizar a conta de serviço do ApsaraDB RDS a acessar o OSS, uma função chamada
AliyunRDSImportRoleé criada no Resource Access Management (RAM). Não modifique nem exclua essa função, pois isso causará falha na tarefa de migração para a nuvem. Se você modificar ou excluir essa função acidentalmente, será necessário conceder as permissões novamente por meio do assistente de migração.Gerenciamento de contas: Após a conclusão da migração, não é possível usar as contas de banco de dados existentes. Crie novas contas no console do ApsaraDB RDS.
Retenção de arquivos no OSS: Não exclua o arquivo de backup do OSS antes que a tarefa de migração para a nuvem seja concluída. Caso contrário, a tarefa falhará.
-
Requisitos do arquivo de backup:
Restrições de nome de arquivo: O nome do arquivo de backup não pode conter caracteres especiais (como
!@#$%^&*()_+-=). Caso contrário, a migração para a nuvem falhará.-
Extensões de arquivo: O ApsaraDB RDS aceita arquivos de backup com as seguintes extensões:
.bak(backup completo),.diff(backup diferencial) e.trnou.log(backup de log). O ApsaraDB RDS não reconhece outros tipos de arquivo.NotaNa prática, a extensão de um arquivo não indica necessariamente seu tipo de backup. Por exemplo, um arquivo
.bakpode conter um backup completo, diferencial ou de log de transações.-
Um arquivo de backup de log do SQL Server baixado do console do ApsaraDB RDS tem, por padrão, o formato
.zip.log. Isso difere do arquivo de backup.bakgerado pelo script oficial na Etapa 1. Após converter o formato do arquivo, você poderá usá-lo para migração incremental para a nuvem.Método de processamento: Altere a extensão do arquivo para
.zipe descompacte-o. Em seguida, renomeie o arquivo descompactadodatabase_name.lbakpara ter a extensão.bak. Por fim, faça upload desse arquivo.bakpara o OSS como um backup de log incremental para migração para a nuvem.
Exemplo de fluxo de trabalho
|
Fase de migração |
Etapa |
Descrição |
|
Fase de migração completa de dados |
Etapa 1. Antes das 00:00 |
Conclua os preparativos:
|
|
Etapa 2. 00:01 |
Realize um backup completo do banco de dados de source. Duração: ~1 hora. |
|
|
Etapa 3. 02:00 |
Faça upload do arquivo de backup para um bucket do OSS. Duração: ~1 hora. |
|
|
Etapa 4. 03:00 |
No console do ApsaraDB RDS, restaure o arquivo de backup completo. Duração: ~19 horas. |
|
|
Fase de migração incremental |
Etapa 5. 22:00 |
Execute um backup de log incremental do banco de dados de source e faça upload para o OSS. Duração: ~20 minutos. |
|
Etapa 6. 22:20 |
Restaure o arquivo de backup de log. Duração: ~10 minutos. |
|
|
Etapa 7. 22:30 |
|
|
|
Transição (Cutover) |
Etapa 8. 22:34 |
O backup final de log é restaurado em cerca de 4 minutos. Depois disso, coloque o banco de dados online. |
|
Etapa 9. 22:35 |
O banco de dados está online. Se você optar por executar a verificação DBCC de forma assíncrona, esta etapa final levará cerca de 1 minuto. |
Este fluxo de trabalho demonstra que o tempo de inatividade necessário da aplicação é muito curto. Basta interromper as gravações da aplicação imediatamente antes do backup final de log. Neste exemplo, o tempo total de inatividade é inferior a 5 minutos.
Etapa 1: Fazer backup do banco de dados local
Baixe o script de backup e abra-o no SSMS.
-
Modifique os seguintes parâmetros.
Parâmetro
Descrição
@backup_databases_list
Uma lista de bancos de dados para backup, separada por ponto e vírgula ou vírgula.
@backup_type
O tipo de backup a ser realizado. Valores válidos:
-
FULL: backup completo
-
DIFF: backup diferencial
-
LOG: backup de log
@backup_folder
O diretório local para o arquivo de backup. O script cria esse diretório automaticamente caso ele não exista.
@is_run
Determina se o backup deve ser executado. Valores válidos:
-
1: Executa o backup.
-
0: Executa apenas uma verificação e não realiza o backup.
-
-
Execute o script de backup.
Por padrão, o script gera um arquivo
.bak, independentemente do tipo de backup selecionado.
2. Fazer upload do arquivo de backup para o OSS
-
Para enviar um arquivo de backup ao OSS, é necessário criar um bucket primeiro.
-
Se você já possui um bucket no OSS, certifique-se de que ele atenda aos seguintes requisitos:
A classe de armazenamento do bucket é Standard. A classe de armazenamento não pode ser Infrequent Access (IA), Archive, Cold Archive ou Deep Cold Archive.
A criptografia de dados não está ativada para o bucket.
-
Se você não possui um bucket no OSS, crie um. (Certifique-se de ter ativado o OSS.)
Faça logon no console do OSS, clique em Buckets e, em seguida, clique em Create bucket.
-
Configure os seguintes parâmetros principais. Mantenha os valores padrão para os demais parâmetros.
ImportanteO bucket será usado apenas para esta migração de dados basta configurar os parâmetros principais. Após a conclusão da migração, exclua o bucket prontamente para evitar vazamentos de dados e cobranças relacionadas.
Não ative a criptografia de dados ao criar o bucket.
Parâmetro
Descrição
Exemplo
Bucket Name
O nome do bucket. O nome deve ser globalmente exclusivo e não pode ser alterado após a criação do bucket.
Convenções de nomenclatura:
-
Pode conter apenas letras minúsculas, dígitos e hifens (-).
-
Deve começar e terminar com uma letra minúscula ou um dígito.
-
Deve ter entre 3 e 63 caracteres.
migratetest
Region
A região onde o bucket reside. Para usar uma rede interna para upload a partir de uma instância ECS e restauração em uma instância RDS, a instância ECS, o bucket e a instância RDS devem estar na mesma região.
China (Hangzhou)
Storage Type
Selecione Standard. O método de migração descrito neste tópico não oferece suporte a buckets de outras classes de armazenamento.
Standard
-
-
Faça upload do arquivo de backup para o OSS.
Após fazer backup do banco de dados local, envie o arquivo de backup para um bucket do OSS que esteja na mesma região da sua instância RDS. Isso permite a comunicação pela rede interna, evitando cobranças de tráfego de internet e melhorando a velocidade de upload. Você pode usar um dos seguintes métodos:
Baixe o ossbrowser.
Por exemplo, em um sistema Windows x64, descompacte o pacote
oss-browser-win32-x64.zipbaixado e clique duas vezes no aplicativooss-browser.exe.-
Use o método de logon via AK, insira seu Access Key ID e Access Key Secret, mantenha os valores padrão para os outros parâmetros e clique em Log On.
NotaUm AccessKey é usado para verificação de identidade e garantia da segurança dos dados. Mantenha seu par de AccessKey seguro.
Após o logon, clique no bucket de destino, por exemplo, migratetest, na lista de Buckets para abrir sua página de gerenciamento de arquivos.
Clique em
 , selecione o arquivo de backup para upload e clique em Abrir.
3. Criar uma tarefa de migração para a nuvem
Acesse a página Instances. Na barra de navegação superior, selecione a região onde a instância RDS reside. Em seguida, localize a instância RDS e clique no ID da instância.
No painel de navegação à esquerda, clique em Restoration.
Na parte superior da página, clique em Restore Backup Data from OSS.
-
Na página Import Guide, clique em Next duas vezes para ir até a etapa Import Data.
NotaSe esta for a primeira vez que você usa o recurso de migração de dados de backup do OSS para o RDS, será necessário autorizar a conta do RDS a acessar o OSS. Clique em Authorize para conceder as permissões necessárias. Caso contrário, a lista suspensa OSS Bucket ficará vazia.
-
Defina os seguintes parâmetros e clique em Yes.
Aguarde a conclusão da tarefa de migração para a nuvem. Clique em Refresh para visualizar o status mais recente da tarefa. Se a tarefa falhar, solucione o problema com base na mensagem de erro na descrição da tarefa. Para mais informações, consulte Erros comuns.
Parâmetro
Descrição
Database Name
O nome do banco de dados de destino na instância RDS. O nome deve estar em conformidade com as convenções de nomenclatura do SQL Server.
Importante-
Antes de iniciar a migração, certifique-se de que a instância de destino não possua nenhum banco de dados existente ou arquivo de banco de dados desanexado com o mesmo nome do banco de dados no arquivo de backup.
-
Se já existir um banco de dados com o mesmo nome do banco especificado no arquivo de backup na instância de destino, ou se existir um arquivo de banco de dados desanexado com o mesmo nome, a migração para a nuvem falhará.
OSS Bucket
Selecione o bucket do OSS onde o arquivo de backup está armazenado.
OSS File
Clique no ícone de lupa para realizar uma busca aproximada por arquivos de backup usando prefixo. Os resultados exibem o nome do arquivo, o tamanho e a última modificação. Selecione o arquivo de backup a ser migrado.
Cloud Migration Method
Selecione Do Not Open Database.
-
Immediate Access (Full Backup): Use este método para uma migração completa de dados para a nuvem se você tiver um único arquivo de backup completo para migrar. Para esta opção, a operação
CreateMigrateTaskusa os seguintes parâmetros:BackupMode = FULLeIsOnlineDB = True. -
Access Pending (Incremental Backup): Use este método para uma migração incremental de dados para a nuvem se estiver migrando um arquivo de backup completo seguido de backups diferenciais ou arquivos de log. Para esta opção, a operação
CreateMigrateTaskusa os seguintes parâmetros:BackupMode = UPDFeIsOnlineDB = False.
-
4. Importar backups diferenciais ou de log
Após migrar o backup completo do seu banco de dados SQL Server autogerenciado, importe os arquivos de backup diferencial ou de log.
Acesse a página Instances. Na barra de navegação superior, selecione a região onde a instância RDS reside. Em seguida, localize a instância RDS e clique no ID da instância.
No painel de navegação à esquerda, clique em Restoration e, em seguida, na aba Backup Data Upload History.
-
Na lista de tarefas, localize a tarefa correspondente e clique em Upload Incremental Files na coluna Actions. Selecione o arquivo incremental e clique em OK.
NotaSe você tiver vários arquivos de backup de log, crie uma tarefa de migração separada para cada um.
Certifique-se de que o arquivo de backup final não exceda 500 MB. Isso minimizará o tempo necessário para a migração incremental para a nuvem.
Antes de gerar o arquivo de backup de log final, interrompa todas as operações de gravação no banco de dados autogerenciado. Isso garante a consistência dos dados entre o banco de dados autogerenciado e a instância do RDS for SQL Server.
5. Abrir o banco de dados
Após importar um arquivo de backup, o banco de dados na sua instância ApsaraDB RDS for SQL Server entra no estado In Recovery ou Restoring. Para instâncias High-availability Edition, o estado é In Recovery, e para instâncias Basic Edition, o estado é Restoring. Em qualquer um desses estados, o banco de dados fica indisponível para operações de leitura e gravação. É necessário abrir o banco de dados para torná-lo acessível.
Acesse a página Instances. Na barra de navegação superior, selecione a região onde a instância RDS reside. Em seguida, localize a instância RDS e clique no ID da instância.
No painel de navegação à esquerda, escolha Restoration e clique na aba Cloud Migration Records of Backup Data.
Na lista de tarefas, localize o registro da importação do arquivo de backup e clique em Open Database na coluna Actions.
-
Selecione uma opção de verificação de consistência do banco de dados e clique em OK.
NotaAs seguintes opções estão disponíveis para a verificação de consistência do banco de dados:
Asynchronous DBCC: Esta opção executa a operação
DBCC CHECKDBde forma assíncrona após a abertura do banco de dados. Este método minimiza o tempo de inatividade ao colocar o banco de dados online mais rapidamente. É ideal se o seu banco de dados for grande e a operaçãoDBCC CHECKDBconsumir muito tempo. Use esta opção se o seu serviço for sensível a tempo de inatividade e você não precisar dos resultados imediatos da verificação. Para a chamada de API CreateMigrateTask, esta opção define o parâmetroCheckDBModecomoAsyncExecuteDBCheck.Synchronous DBCC: Esta opção executa a operação
DBCC CHECKDBdurante a abertura do banco de dados. Este método permite verificar imediatamente a consistência dos dados e identificar quaisquer erros. Use esta opção se priorizar a verificação de dados, mas observe que isso aumenta o tempo necessário para abrir o banco de dados. Para a chamada de API CreateMigrateTask, esta opção define o parâmetroCheckDBModecomoSyncExecuteDBCheck.
6. Visualizar detalhes do backup de migração para a nuvem
Para visualizar os detalhes do arquivo de backup de uma tarefa de migração para a nuvem, acesse a página Restoration no painel de navegação à esquerda da instância RDS. Na aba Cloud Migration Records of Backup Data, localize a tarefa e clique em View File Details na coluna mais à direita.
Após a migração para a nuvem, o sistema cria automaticamente um backup com base na política de backup automático da instância RDS. Esse backup é executado em um horário especificado, que você pode ajustar. O conjunto de backup resultante contém os dados migrados e está disponível na página Restoration.
Se precisar de um backup antes do próximo horário agendado, realize um backup manual.
Erros comuns
Para erros comuns durante a migração de dados de backup completo, consulte Erros comuns na migração de dados de backup completo.
Você pode encontrar os seguintes erros durante um upload incremental:
-
Falha ao abrir o banco de dados
Mensagem de erro: Failed to open database xxx.
Causa: O banco de dados SQL Server de source usa recursos avançados que não são suportados pela edição da instância ApsaraDB RDS for SQL Server selecionada. Por exemplo, esse erro ocorre se sua instância SQL Server de source executar a Enterprise Edition com compactação de dados ou particionamento ativado, e você migrar dados para uma instância ApsaraDB RDS for SQL Server que executa a Web Edition.
-
Solução:
Desative os recursos avançados na sua instância SQL Server de source, crie um novo backup e tente a migração novamente.
-
Adquira uma instância ApsaraDB RDS for SQL Server com a mesma edição do SQL Server da sua instância de source. Para mais informações, consulte Criar uma instância ApsaraDB RDS for SQL Server.
NotaPara mais informações, consulte Comparação de recursos entre diferentes versões do SQL Server e edições do RDS.
-
Incompatibilidade de LSN na cadeia de backups
Mensagem de erro: The log in this backup set begins at LSN XXX, which is too recent to apply to the database. RESTORE LOG is terminating abnormally.
Causa: No SQL Server, um backup diferencial ou de log só pode ser restaurado se seu Log Sequence Number (LSN) inicial estiver alinhado com o LSN do arquivo de backup restaurado anteriormente. Esse erro ocorre quando os LSNs não coincidem.
Solução: Selecione os arquivos de backup com LSNs correspondentes para o upload incremental. Certifique-se de enviar os arquivos de backup em ordem cronológica.
-
Falha no DBCC CHECKDB assíncrono
Mensagem de erro: asynchronously DBCC checkdb failed: CHECKDB found 0 allocation errors and 2 consistency errors in table 'XXX' (object ID XXX).
Causa: Após a restauração do arquivo de backup na instância ApsaraDB RDS for SQL Server, o sistema executa um DBCC CHECKDB assíncrono. Se essa verificação falhar, indica que o banco de dados de source já continha erros de consistência.
-
Solução:
-
Na instância ApsaraDB RDS for SQL Server de destino, execute o seguinte comando:
DBCC CHECKDB (DBName,REPAIR_ALLOW_DATA_LOSS)ImportanteEste comando de reparo pode causar perda de dados.
-
Na instância de source, execute o seguinte comando para reparar os erros e tente novamente o upload incremental.
DBCC CHECKDB (DBName,REPAIR_ALLOW_DATA_LOSS)
-
-
Tipo incorreto de arquivo de backup para upload incremental
Mensagem de erro: Backup set (xxx) is a Database FULL backup, we only accept transaction log or differential backup.
Causa: Durante um upload incremental para uma instância ApsaraDB RDS for SQL Server, o sistema aceita apenas arquivos de backup de log ou backup diferencial após a restauração de um backup completo. Esse erro ocorre se você selecionar um arquivo de backup completo novamente.
Solução: Selecione um arquivo de backup de log ou um arquivo de backup diferencial.
-
Quantidade de bancos de dados excede o limite
Mensagem de erro: The database (xxx) migration failed due to databases count limitation.
Causa: Esse erro ocorre quando você tenta migrar um banco de dados para uma instância que atingiu seu limite máximo de bancos de dados.
Solução: Migre o banco de dados para outra instância ApsaraDB RDS for SQL Server ou exclua bancos de dados desnecessários da instância atual.
-
Permissões insuficientes para usuário RAM
P1: Na Etapa 5 de Criar uma tarefa de migração de dados, por que o botão OK aparece esmaecido e inacessível mesmo com todos os parâmetros configurados?
R1: Isso pode ocorrer se o seu usuário RAM não tiver as permissões necessárias. Consulte a seção Pré-requisitos neste tópico e conceda as permissões adequadas.
-
P2: Como resolvo o erro
no permissionque ocorre quando um usuário RAM tenta conceder a funçãoAliyunRDSImportRole? R2: Use sua conta Alibaba Cloud para conceder temporariamente a permissão
AliyunRAMFullAccessao usuário RAM. Para instruções sobre como conceder permissões a um usuário RAM, consulte Usar RAM para gerenciar permissões do ApsaraDB RDS.
-
Backup incremental restaurado em um backup completo incorreto
Mensagem de erro: This differential backup cannot be restored because the database is not in the correct state. RESTORE DATABASE is terminating abnormally.
Causa: Esse erro ocorre se um backup incremental mais recente for restaurado sobre um backup completo mais antigo. Isso quebra a cadeia de backups porque o LSN do arquivo de backup diferencial não se alinha com o LSN do arquivo de backup completo que foi restaurado com a opção
NORECOVERY.Solução: Certifique-se de ter selecionado os arquivos de backup corretos e de estar fazendo upload deles na ordem correta. Você pode consultar a tabela
msdb.dbo.backupsetna instância de source para verificar a ordem e a relação de LSN entre seus arquivos de backup completo e diferencial.
-
Erro com Striped Backups de múltiplos arquivos
Mensagem de erro: Failed to verify (xxx.bak), error message:The media set has xxx media families but only 1 are provided. All members must be provided. VERIFY DATABASE is terminating abnormally.
Causa: O banco de dados de source teve backup realizado usando o recurso Striped Backup, que grava um único backup completo em vários arquivos .bak. No entanto, você forneceu apenas um desses arquivos para a tarefa de migração. O ApsaraDB RDS for SQL Server não suporta a migração de dados a partir de múltiplos arquivos de backup em uma única tarefa.
Solução: Faça backup do banco de dados de source em um único arquivo .bak e tente o upload novamente.
Referência de API
|
API |
Descrição |
|
Cria uma tarefa de migração de dados restaurando um arquivo de backup do OSS para uma instância ApsaraDB RDS for SQL Server. |
|
|
Coloca um banco de dados online após sua restauração como parte de uma tarefa de migração de dados. |
|
|
Lista as tarefas de migração de dados para uma instância ApsaraDB RDS for SQL Server. |
|
|
Retorna os detalhes do arquivo de backup para uma tarefa de migração de dados. |