Este tópico descreve como realizar buscas vetoriais de forma eficiente no RDS for PostgreSQL usando a extensão PASE, que é baseada no algoritmo IVFFlat ou HNSW.
A extensão PASE não é mais mantida. Recomendamos o uso da extensão pgvector.
Pré-requisitos
Sua instância deve estar executando o RDS for PostgreSQL nas versões 11 a 16.
Informações gerais
Nos últimos anos, o aprendizado de representação, uma tecnologia-chave na área de deep learning, avançou significativamente. Ele agora é amplamente utilizado em aplicações industriais, como veiculação de anúncios, pagamentos por reconhecimento facial e reconhecimento de imagem e voz. Nesses cenários, os dados são incorporados em vetores de alta dimensão, e a busca vetorial é usada para encontrar itens semelhantes.
PASE (PostgreSQL ANN search extension) é uma extensão de índice de busca vetorial de alto desempenho desenvolvida para o PostgreSQL. Ela utiliza algoritmos de busca de vizinhos mais próximos aproximados (ANN) maduros, estáveis e eficientes, incluindo os algoritmos IVFFlat e HNSW, para permitir consultas vetoriais extremamente rápidas. O PASE não suporta a extração ou geração de vetores de características. Você é responsável por gerar os vetores de características para suas entidades. O PASE então realiza buscas de similaridade no grande volume de vetores que você gerou.
Público-alvo
Este tópico requer conhecimento básico de machine learning, busca e sistemas de recomendação.
Notas de uso
Um índice pode ficar inchado. Você pode verificar o tamanho de um índice executando o comando
select pg_relation_size('index_name');. Reconstrua o índice se seu tamanho se tornar significativamente maior que o tamanho dos dados e o desempenho da consulta degradar visivelmente.O índice pode perder precisão após atualizações frequentes de dados. Para garantir precisão absoluta, reconstrua o índice periodicamente.
Para usar um índice IVFFlat com centroides internos (
clustering_type=1), você deve inserir alguns dados na tabela antes de criar o índice.Use uma conta privilegiada para executar os exemplos de SQL neste tópico.
Algoritmos PASE
-
Algoritmo IVFFlat
O IVFFlat é uma versão simplificada do IVFADC, adequada para cenários que exigem alta revocação (recall) e podem tolerar latência moderada de consulta (na faixa de 100 ms). Em comparação com outros algoritmos, o algoritmo IVFFlat oferece as seguintes vantagens:
Se o vetor de consulta fizer parte do conjunto de dados candidato, o IVFFlat pode atingir 100% de revocação.
O algoritmo é simples, o que resulta em criação de índice mais rápida e menor consumo de armazenamento.
Você pode especificar os centroides e controlar a revocação ajustando parâmetros simples.
Os parâmetros do algoritmo são altamente interpretáveis, dando a você controle total sobre a precisão.
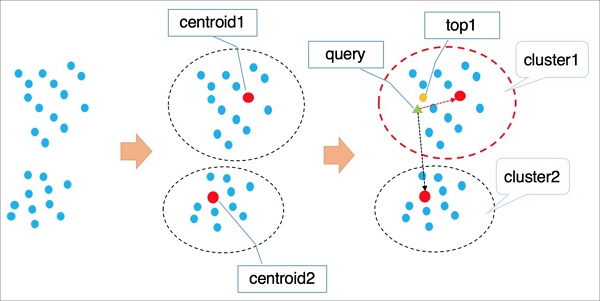
A figura a seguir ilustra como o algoritmo IVFFlat funciona.
O processo é o seguinte:
Vetores em um espaço de alta dimensão são agrupados em clusters usando um algoritmo de clustering, como k-means. Cada cluster possui um centroide.
Durante uma busca, o algoritmo primeiro itera pelos centroides de todos os clusters para encontrar os
nclusters cujos centroides estão mais próximos do vetor alvo.O algoritmo então itera por todos os elementos dentro desses
nclusters e realiza uma ordenação global para encontrar oskvetores mais próximos finais.
NotaDurante a busca por centroides, clusters distantes são automaticamente excluídos para acelerar a consulta. No entanto, isso significa que não há garantia de que os vetores top-
kideais estejam todos dentro dosnclusters selecionados, o que pode reduzir a precisão. Você pode controlar a precisão do algoritmo IVFFlat ajustando o número de clusters a serem varridos,n. Um valor maior denaumenta a precisão, mas também aumenta a carga computacional.A primeira etapa do IVFFlat e do IVFADC é idêntica. A principal diferença reside na segunda etapa de computação. O IVFADC usa quantização de produto para evitar computação exaustiva, o que leva a alguma perda de precisão. Em contraste, o IVFFlat usa cálculo de força bruta para evitar essa perda, mantendo a computação gerenciável.
-
Algoritmo HNSW
O algoritmo Hierarchical Navigable Small World (HNSW) é adequado para conjuntos de dados vetoriais de escala muito grande (dezenas de milhões ou mais) e cenários com requisitos rigorosos de latência de consulta (na faixa de 10 ms).
O HNSW é um algoritmo baseado em grafos que itera rapidamente através de um grafo de proximidade para encontrar potenciais vizinhos próximos. A melhoria de desempenho do algoritmo HNSW é mais significativa com grandes conjuntos de dados em comparação com outros algoritmos. No entanto, armazenar pontos vizinhos consome espaço de armazenamento adicional, e ajustar apenas os parâmetros oferece retornos decrescentes para melhorar a revocação.
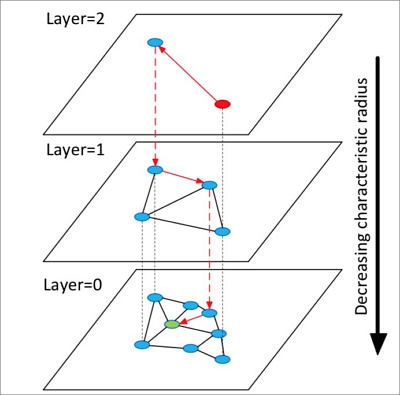
A figura a seguir ilustra como o algoritmo HNSW funciona.
O processo é o seguinte:
O algoritmo constrói um grafo multicamadas, onde cada camada é uma versão mais esparsa da camada abaixo e atua como uma skip list, semelhante a um sistema de vias expressas, para a camada inferior.
A busca começa a partir de um ponto selecionado aleatoriamente na camada superior.
O algoritmo encontra os vizinhos do ponto inicial e os armazena em uma lista dinâmica de tamanho fixo, ordenada pela distância até o alvo. Nas etapas subsequentes, ele pega pontos da lista dinâmica, encontra seus vizinhos e insere esses novos vizinhos descobertos de volta na lista. A lista é reordenada após cada inserção, mantendo apenas os
kprincipais pontos. Esse processo continua iterativamente até que a lista estabilize. O primeiro ponto na lista estabilizada é então usado como ponto de entrada para a próxima camada inferior.Esse processo é repetido para cada camada até que a busca atinja a camada inferior.
NotaO algoritmo HNSW baseia-se no grafo de camada única do algoritmo NSW construindo um grafo multicamadas. A busca por vizinhos mais próximos neste grafo pode atingir uma taxa de aceleração maior do que algoritmos baseados em clustering.
Cada algoritmo tem casos de uso específicos. Por exemplo, o algoritmo IVFFlat é adequado para comparação de imagens de alta precisão, enquanto o algoritmo HNSW é ideal para recuperação em cenários de busca e recomendação.
Usar o PASE
Procedimento
-
Crie a extensão PASE. Execute o seguinte comando:
CREATE EXTENSION pase; -
Calcule a similaridade vetorial. Você pode usar um dos dois métodos de construtor para calcular a similaridade vetorial:
-
Usar o construtor de tipo de dados PASE
Exemplos
SELECT ARRAY[2, 1, 1]::float4[] <?> pase(ARRAY[3, 1, 1]::float4[]) AS distance; SELECT ARRAY[2, 1, 1]::float4[] <?> pase(ARRAY[3, 1, 1]::float4[], 0) AS distance; SELECT ARRAY[2, 1, 1]::float4[] <?> pase(ARRAY[3, 1, 1]::float4[], 0, 1) AS distance;NotaO operador
<?>calcula a similaridade entre um vetor à esquerda (float4[]) e um vetor à direita (pase).O tipo
paseé um tipo de dados definido dentro da extensão. Ele possui três métodos de construtor, conforme mostrado nos exemplos. Tomepase(ARRAY[3, 1, 1]::float4[], 0, 1)como exemplo: O primeiro parâmetro éfloat4[]e representa o vetor à direita. O segundo parâmetro não é usado neste contexto e pode ser definido como 0. O terceiro parâmetro especifica o método de cálculo de similaridade:0para distância euclidiana e1para produto escalar (produto interno).As dimensões dos vetores à esquerda e à direita devem ser iguais. Caso contrário, o cálculo falhará.
-
Usar o construtor de string
Exemplos
SELECT ARRAY[2, 1, 1]::float4[] <?> '3,1,1'::pase AS distance; SELECT ARRAY[2, 1, 1]::float4[] <?> '3,1,1:0'::pase AS distance; SELECT ARRAY[2, 1, 1]::float4[] <?> '3,1,1:0:1'::pase AS distance;NotaTanto o construtor de string quanto o construtor de tipo de dados PASE calculam a similaridade entre dois vetores. A diferença é que o construtor de string usa dois pontos (
:) como delimitadores. Tome'3,1,1:0:1'como exemplo: A primeira parte representa o vetor à direita. A segunda parte não é usada neste contexto e pode ser definida como 0. A terceira parte especifica o método de cálculo de similaridade:0para distância euclidiana e1para produto escalar (produto interno).
-
-
Crie um índice. Você pode criar um índice usando um dos dois algoritmos:
NotaAo usar um índice vetorial PASE com distância euclidiana como métrica de similaridade, você não precisa processar os vetores originais. No entanto, para usar produto interno ou similaridade de cosseno como métrica, você deve realizar normalização nos vetores. Se o vetor original for
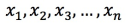 , ele deve satisfazer
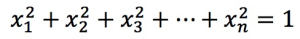 . Após a normalização, os valores de produto interno e similaridade de cosseno são equivalentes na classificação.
-
Criar um índice usando o algoritmo IVFFlat
CREATE INDEX ivfflat_idx ON table_name
USING
  pase_ivfflat(column_name)
WITH
  (clustering_type = 1, distance_type = 0, dimension = 256, base64_encoded = 0, clustering_params = "10,100");
A tabela a seguir descreve os parâmetros.
Parâmetro
Descrição
clustering_type
O método de clustering para o algoritmo IVFFlat. Este parâmetro é obrigatório. Valores válidos:
-
0: Clustering externo. Carrega um arquivo de centroides externo especificado pelo parâmetro clustering_params. -
1: Clustering interno. Realiza uma operação de clustering internamente durante a criação do índice usando o algoritmo k-means. Isso é controlado pelo parâmetro clustering_params.
Para novos usuários, recomendamos o uso de clustering interno.
distance_type
O método de cálculo de similaridade. Padrão:
0. Valores válidos:-
0: Distância euclidiana. -
1: Produto escalar (produto interno). Para usar este método, você deve realizar normalização nos vetores. Neste caso, a classificação dos valores de produto escalar (produto interno) é o inverso da classificação dos valores de distância euclidiana.
Atualmente, apenas a distância euclidiana é suportada diretamente para indexação. Para usar produto escalar (produto interno), você deve normalizar os vetores e usar o método fornecido em Appendix.
dimension
A dimensão do vetor. Este parâmetro é obrigatório. A dimensão máxima suportada é 512.
base64_encoded
Especifica se os dados estão codificados em Base64. Padrão:
0. Valores válidos:-
0: O tipo de vetor éfloat4[]. -
1: O tipo de vetor é uma string codificada em Base64 de um array float.
clustering_params
Para clustering externo, este parâmetro especifica o caminho para o arquivo de centroides. Para clustering interno, especifica os parâmetros de clustering no formato
"clustering_sample_ratio,k". Este parâmetro é obrigatório.-
clustering_sample_ratio: A taxa de amostragem de clustering, com 1000 como denominador. O intervalo válido é um inteiro de(0, 1000]. Por exemplo, um valor de1significa que 1/1000 dos dados na tabela é amostrado para clustering k-means. Um valor maior melhora a precisão da consulta, mas aumenta o tempo de criação do índice. Recomendamos que o número total de pontos de dados amostrados não exceda 100.000. -
k: O número de centroides. Um valor maior melhora a precisão da consulta, mas aumenta o tempo de criação do índice. Recomendamos um valor no intervalo de[100, 1000].
-
-
Criar um índice usando o algoritmo HNSW
CREATE INDEX hnsw_idx ON table_name
USING
  pase_hnsw(column_name)
WITH
  (dim = 256, base_nb_num = 16, ef_build = 40, ef_search = 200, base64_encoded = 0);
A tabela a seguir descreve os parâmetros.
Parâmetro
Descrição
dim
Dimensão do vetor. Obrigatório. O intervalo de valores é
[8,512].base_nb_num
O número de vizinhos para cada nó no grafo. Este parâmetro é obrigatório. Um valor maior melhora a precisão da consulta, mas aumenta o tempo de criação do índice e o tamanho do índice. O intervalo de valores recomendado é
[16-128].ef_build
O tamanho do heap para o processo de criação do índice. Este parâmetro é obrigatório. Um valor maior fornece melhores resultados, mas desacelera o processo de criação. O intervalo de valores recomendado é
[40,400].ef_search
O tamanho do heap para a consulta. Este é um parâmetro obrigatório. Um valor maior melhora a qualidade do resultado, mas degrada o desempenho da consulta. O valor deve estar no intervalo de
[10,400].base64_encoded
Especifica se os dados estão codificados em Base64. Padrão:
0. Valores válidos:-
0: O tipo de vetor éfloat4[]. -
1: O tipo de vetor é uma string codificada em Base64 de um array float.
-
-
-
Execute uma consulta. Você pode consultar os dados usando qualquer um dos tipos de índice:
-
Consultar usando um índice IVFFlat
SELECT id, vector <#> '1,1,1'::pase as distance FROM table_name ORDER BY vector <#> '1,1,1:10:0'::pase ASC LIMIT 10;NotaO operador
<#>é usado para consultar um índice IVFFlat.O índice vetorial é ativado pela cláusula
ORDER BY. Ele suporta ordem de classificação ascendente (ASC).O tipo de dados pase consiste em três partes separadas por dois pontos (:). Por exemplo, em
1,1,1:10:0, a primeira parte é o vetor de consulta. A segunda parte é um parâmetro de consulta para IVFFlat com um intervalo de valores de(0,1000]. Um valor maior resulta em maior precisão da consulta, mas menor desempenho. Recomenda-se determinar o valor ideal depurando com base em seus dados reais. A terceira parte especifica o método de cálculo de similaridade para a consulta, onde 0 indica distância euclidiana e 1 indica produto escalar (produto interno). Se você usar o método de produto escalar (produto interno), deve realizar a normalização do vetor. Neste caso, a ordem dos valores de produto escalar (produto interno) é o inverso da ordem dos valores de distância euclidiana.
-
Consultar usando um índice HNSW
SELECT id, vector <?> '1,1,1'::pase as distance FROM table_name ORDER BY vector <?> '1,1,1:100:0'::pase ASC LIMIT 10;NotaO operador
<?>é usado para consultar um índice HNSW.O índice vetorial é ativado pela cláusula
ORDER BY. Ele suporta ordem de classificação ascendente (ASC).O tipo de dados
pasetem um formato de três partes, com partes separadas por dois pontos (:). No exemplo1,1,1:100:0, a primeira parte é o vetor de consulta. A segunda parte é o parâmetro de efeito de consulta HNSW, que tem um intervalo de valores de(0,∞). Um valor maior resulta em maior precisão da consulta, mas menor desempenho. Recomendamos que você determine esse valor depurando com seus dados reais e comece com um valor inicial de 40. A terceira parte especifica o método de cálculo de similaridade para a consulta, onde 0 indica distância euclidiana e 1 indica produto escalar (produto interno). Ao usar o método de produto escalar (produto interno), a normalização do vetor é necessária. Neste caso, a ordem dos valores de produto escalar (produto interno) é o inverso da ordem dos valores de distância euclidiana.
-
Exemplo
Este exemplo demonstra como consultar dados usando um índice IVFFlat.
-
Crie a extensão PASE. Execute o seguinte comando:
CREATE EXTENSION pase; -
Crie uma tabela de teste e insira dados de teste.
Crie uma tabela de teste.
CREATE TABLE vectors_table ( id SERIAL PRIMARY KEY, vector float4[] NOT NULL );Insira dados de teste.
INSERT INTO vectors_table (vector) VALUES ('{1.0, 0.0, 0.0}'), ('{0.0, 1.0, 0.0}'), ('{0.0, 0.0, 1.0}'), ('{0.0, 0.5, 0.0}'), ('{0.0, 0.5, 0.0}'), ('{0.0, 0.6, 0.0}'), ('{0.0, 0.7, 0.0}'), ('{0.0, 0.8, 0.0}'), ('{0.0, 0.0, 0.0}'); -
Crie um índice usando o algoritmo IVFFlat.
CREATE INDEX ivfflat_idx ON vectors_table USING pase_ivfflat(vector) WITH (clustering_type = 1, distance_type = 0, dimension = 3, base64_encoded = 0, clustering_params = "10,100"); -
Consulte os dados usando o índice IVFFlat.
SELECT id, vector <#> '1,1,1'::pase as distance
FROM vectors_table
ORDER BY
vector <#> '1,1,1:10:0'::pase
ASC LIMIT 10;
Apêndice
-
Exemplo de cálculo de produto escalar (produto interno)
Este exemplo usa um índice de algoritmo HNSW. O código a seguir mostra como criar uma função:
CREATE OR REPLACE FUNCTION inner_product_search(query_vector text, ef integer, k integer, table_name text) RETURNS TABLE (id integer, uid text, distance float4) AS $$ BEGIN RETURN QUERY EXECUTE format(' select a.id, a.vector <?> pase(ARRAY[%s], %s, 1) AS distance from (SELECT id, vector FROM %s ORDER BY vector <?> pase(ARRAY[%s], %s, 0) ASC LIMIT %s) a ORDER BY distance DESC;', query_vector, ef, table_name, query_vector, ef, k); END $$ LANGUAGE plpgsql;NotaPara vetores normalizados, o produto interno é igual à similaridade de cosseno. Portanto, você pode usar o mesmo método para calcular a similaridade de cosseno.
-
Arquivo de centroides personalizado para um índice IVFFlat
Este é um recurso avançado. Para usar este recurso, carregue um arquivo de centroides em um caminho especificado no servidor e use-o como parâmetro de índice para construir o índice. Para obter mais informações sobre os parâmetros, consulte IVFFlat index parameters. O formato do arquivo é o seguinte:
vector_dimension|number_of_centroids|set_of_centroid_vectorsExemplo
3|2|1,1,1,2,2,2
Documentos relacionados
-
Product Quantization for Nearest Neighbor Search
Hervé Jégou, Matthijs Douze e Cordelia Schmid.
-
Yu. A. Malkov e D. A. Yashunin.