Quando o crescimento dos negócios aumenta o tráfego do banco de dados e os recursos de computação se tornam insuficientes, aumentar as especificações de computação, como CPU e memória, é uma solução eficaz. O Database Autonomy Service (DAS) é um service que permite dimensionar automaticamente as especificações de computação das suas instâncias de banco de dados para lidar rapidamente com picos de tráfego. Quando o tráfego diminui, o DAS também pode reduzir automaticamente as especificações para evitar desperdício de recursos.
Recursos
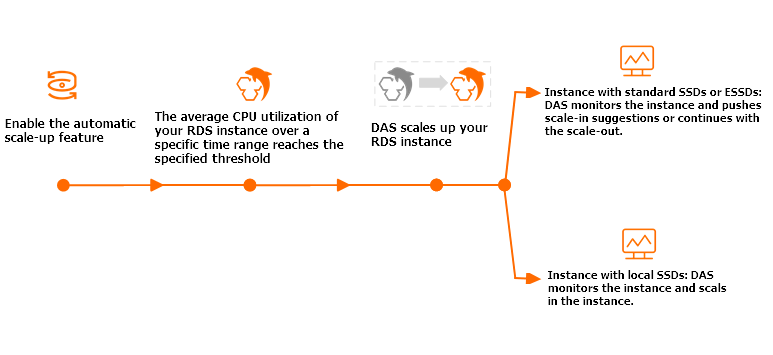
Item | Instância com disco cloud | Instância com disco local premium |
Itens de aumento de escala |
|
Importante Se os recursos do host forem insuficientes, o que ocorre em menos de 1% dos casos, o aumento de escala não acontece. |
Redução automática de escala | O sistema reduz automaticamente as especificações da instância em etapas para as especificações anteriores ao aumento quando as duas condições a seguir são atendidas:
| Durante a scale-down observation window, se a utilização de CPU for inferior a 30% por mais de 99% do tempo, o sistema reduz automaticamente a CPU e o IOPS em etapas para o nível anterior ao aumento. |
Impacto na disponibilidade | Quando a alteração de configuração entra em vigor, pode ocorrer uma desconexão transitória de até 15 segundos. Recomendamos que execute esta operação fora dos horários de pico e garanta que sua aplicação possua um mecanismo de tentativa de reconexão. | Nenhum failover primário/secundário ocorre. Nota As operações de dimensionamento automático são concluídas em até 30 segundos e são imperceptíveis para os usuários. |
Pré-requisitos
-
A instância do ApsaraDB RDS for MySQL atende aos seguintes requisitos:
Billing method: assinatura ou pagamento conforme o uso. Uma Serverless instance é dimensionada automaticamente e não requer configuração.
Storage type: discos cloud (uso geral ou dedicado) ou discos locais premium (uso geral).
Edition: High-Availability Edition
Category: Standard Edition
Região: O recurso de dimensionamento automático de desempenho depende da detecção de anomalias. Portanto, a instância deve estar em uma região que ofereça suporte ao DAS anomaly detection feature.
O saldo da sua conta deve ser suficiente para cobrir os custos do aumento de escala.
O recurso de dimensionamento automático de desempenho não oferece suporte a instâncias do ApsaraDB RDS for MySQL executadas em tipos de instância descontinuados que utilizam discos cloud. Para usar este recurso, primeiro change the instance type to a current one.
Observações
-
Relação entre instâncias primárias e instâncias somente leitura
O DAS não aplica automaticamente as configurações de dimensionamento automático de uma instância primária às suas instâncias somente leitura, portanto, configure manualmente o dimensionamento automático para as instâncias somente leitura.
-
O sistema executa as operações de aumento de escala apenas na instância primária. Se um failover primário/secundário for acionado após o aumento de escala da instância primária:
Se a nova instância primária (a instância secundária original) atender às condições para aumento ou redução de escala, o sistema fará o ajuste correspondente automaticamente.
Se a nova instância secundária (a instância primária original) atender às condições para redução de escala, o sistema a reduzirá automaticamente para suas especificações originais.
-
Impacto das alterações de configuração
Ao alterar as configurações, o sistema atualiza a versão secundária do mecanismo da instância para a mais recente, a menos que ela já esteja nessa versão. Isso garante desempenho e estabilidade ideais.
Para garantir que o DAS possa acessar os recursos de banco de dados cloud necessários, o sistema atribui a função vinculada a service AliyunServiceRoleForDAS ao DAS após você ativar o recurso de dimensionamento automático.
Faturamento
-
Discos locais premium (uso geral): faturados por hora na modalidade de pagamento conforme o uso.
Fórmula de faturamento: (Preço por núcleo × Número de núcleos de CPU adicionados) × Duração do aumento de escala (em horas)
Por exemplo, considere uma instância na região China (Hangzhou) com 4 núcleos de CPU. Após o acionamento de um aumento automático de desempenho, o número de núcleos aumenta para 8. A duração do aumento é de 30 minutos (0,5 horas). O preço unitário na região China (Hangzhou) é USD 0,083 por núcleo-hora. A taxa é calculada da seguinte forma:
0.083 (unit price) x 4 (added cores) x 0.5 (hours) = USD 0.166. Discos cloud (uso geral e dedicado): Há cobrança pelas novas especificações da instância após um aumento de escala. As taxas para a atualização de especificações variam com base em fatores como a região e as novas especificações. Para mais informações, acesse a página de compra.
Procedimento
Discos cloud
Para começar, acesse a página RDS Instances. Na barra de navegação superior, selecione a região onde sua instância RDS está localizada. Em seguida, encontre a instância e clique em seu ID.
Na seção Configuration Information, clique em Settings ao lado de Automatic Performance Scaling.
-
Na caixa de diálogo exibida, configure os parâmetros e clique em OK.
Parâmetro
Descrição
Automatic Performance Scaling
ative a opção para habilitar o dimensionamento automático de desempenho.
Observation Window
O período durante o qual o sistema verifica periodicamente a utilização de CPU da instância para determinar se deve acionar um aumento de escala.
ImportanteA duração da scale-down observation window é
observation window + 10 minutes. Por exemplo, caso defina a Observation Window como 30 minutos, a scale-down observation window será de 40 minutos.O recurso de redução automática de escala tem execução estável garantida apenas em instâncias que usam a nova arquitetura (kindcode=18). Você pode chamar a operação DescribeDBInstanceAttribute para consultar a versão da arquitetura da sua instância.
CPU Trigger Threshold
O limiar de utilização de CPU para acionar um aumento automático de escala. Um aumento automático é acionado quando a utilização média de CPU é maior ou igual a este limiar.
Maximum Specifications
O limite superior para o aumento automático de escala. As especificações configuradas, incluindo CPU e memória, devem ser superiores às especificações atuais da instância. Caso contrário, a configuração não terá efeito. As configurações exibem as especificações atuais da instância.
Cool-down Period
O intervalo mínimo entre dois eventos de dimensionamento consecutivos (seja aumento ou redução de escala).
NotaDurante o período de cool-down, o DAS continua monitorando a instância, mas não aciona nenhum evento de dimensionamento.
Se o período de cool-down e a janela de observação terminarem ao mesmo tempo, e a utilização de CPU atingir o limiar de acionamento dentro dessa janela, o DAS acionará um evento de dimensionamento.
Redução automática de escala
O sistema reduz automaticamente as especificações da instância em etapas para as especificações anteriores ao aumento quando as duas condições a seguir são atendidas:
A instância não está em um Cool-down Period.
Durante a scale-down observation window (a
observation window + 10 minutes), a utilização de CPU da instância fica abaixo de 30% por mais de 99% do tempo.
Discos locais premium
Para começar, acesse a página RDS Instances. Na barra de navegação superior, selecione a região onde sua instância RDS está localizada. Em seguida, encontre a instância e clique em seu ID.
Na seção Configuration Information, clique em Settings ao lado de Automatic Performance Scaling.
-
Na caixa de diálogo exibida, configure os parâmetros e clique em OK.
Parâmetro
Descrição
Automatic Performance Scaling
ative a opção para habilitar o dimensionamento automático de desempenho.
Scale-up Observation Window
O período durante o qual o sistema verifica periodicamente a utilização de CPU da instância para determinar se deve acionar um aumento de escala.
CPU Trigger Threshold
O limiar de utilização de CPU para acionar um aumento automático de escala. Um aumento automático é acionado quando a utilização média de CPU é maior ou igual a este limiar.
Scale-down Observation Window
O período durante o qual o sistema monitora a utilização de CPU da instância para determinar se deve acionar uma redução de escala. Uma redução é acionada se a utilização de CPU permanecer abaixo de 30% por mais de 99% desta janela.