Crie um modelo de scorecard para avaliação de crédito usando componentes financeiros do PAI Designer e dados de transações de cartão de crédito.
Contexto
O scorecard é uma estrutura de modelagem para avaliação de risco de crédito e finanças digitais. Em vez de usar um único algoritmo, essa abordagem aplica engenharia de features a dados discretizados em intervalos (bins) e ajusta um modelo linear.
As aplicações incluem avaliação de risco de cartão de crédito, concessão de empréstimos, pontuação de atendimento ao cliente e sistemas de crédito como o Sesame Credit.
Pré-requisitos
Você criou um workspace. Para mais informações, consulte Create and manage workspaces.
Você associou recursos do MaxCompute ao seu workspace. Para mais informações, consulte Create and manage workspaces.
Conjunto de dados
Este pipeline usa um conjunto de dados público (Baixe conjunto de dados) com 30.000 registros contendo dados demográficos dos usuários (gênero, escolaridade, estado civil, idade), histórico de transações e extratos de faturamento.
O alvo da previsão é a coluna payment_next_month, que indica se o usuário quitou a fatura do cartão de crédito:
1 indica fatura quitada.
0 indica fatura pendente.
Crie e execute o pipeline de scorecard
-
Acesse a página do Machine Learning Designer.
Faça login no PAI console.
No painel de navegação à esquerda, clique em Workspaces. Na página Workspaces, clique no nome do workspace que deseja gerenciar.
No painel de navegação à esquerda, escolha .
-
Construa o pipeline.
Na página do Designer, clique na aba Preset Templates.
Na página Preset Templates, clique em Create abaixo de Credit Consumption Analysis Based on Scorecard.
-
Na caixa de diálogo Create Pipeline, configure os parâmetros. Use as configurações padrão para todos os parâmetros.
O parâmetro Data Storage define um caminho de Bucket OSS para armazenar dados temporários e modelos gerados durante a execução do pipeline.
-
Clique em Confirm.
A criação do pipeline leva cerca de 10 segundos.
Na aba Pipelines, clique duas vezes em Credit Consumption Analysis Based on Scorecard para abrir o pipeline.
-
O sistema constrói o pipeline a partir do modelo predefinido.
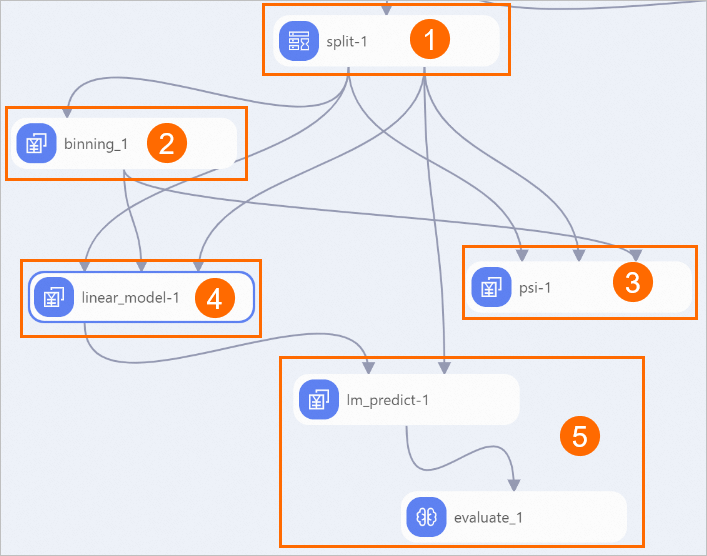
Área
Descrição
①
Divide o conjunto de dados em conjuntos de treinamento e previsão.
②
O componente Binning mapeia dados para features de alta dimensão por intervalo de distribuição, de forma semelhante à codificação one-hot. Após a conclusão do pipeline, clique com o botão direito em Binning-1 e selecione Binning. No painel de configuração, clique no nome de uma feature (por exemplo, age) para visualizar os detalhes dos bins.
A tabela de detalhes de binning exibe 10 bins para uma feature (de (-inf,25] a (49,+inf)), com as seguintes informações para cada bin:
Label: Faixa de intervalo do bin
Constrain: Condições de restrição (Operator e Value), não definidas por padrão
WOE: Valores WOE para cada bin (ex.: 0.250, -0.091, -0.114)
Number: Contagens de amostras Total, Positive e Negative (ex.: linha 0: Total=3138, Positive=845, Negative=2293)
Para visualizar os intervalos de binning por campo, clique com o botão direito em Binning-1 e escolha .
A tabela de resumo de binning de features mostra os resultados para todas as 21 features (sex, education, marriage, limit_bal, age, pay_0–pay_6, bill_amt1–bill_amt6, pay_amt1–pay_amt6). Cada feature é representada por um segmento JSON contendo os seguintes campos-chave:
iv: Valor de Informação (ex.: sex = 0.003556, limit_bal = 0.075548, pay_0 = 0.046904)
n: Contagem de amostras
p: Contagem de amostras positivas
prate: Taxa de amostras positivas
total: Contagem total de amostras
③
Compara a estabilidade das amostras antes e depois da divisão ou binning e retorna o Índice de Estabilidade Populacional (PSI) por feature. Após a execução do pipeline, clique com o botão direito em PSI-1 e escolha para visualizar os detalhes.
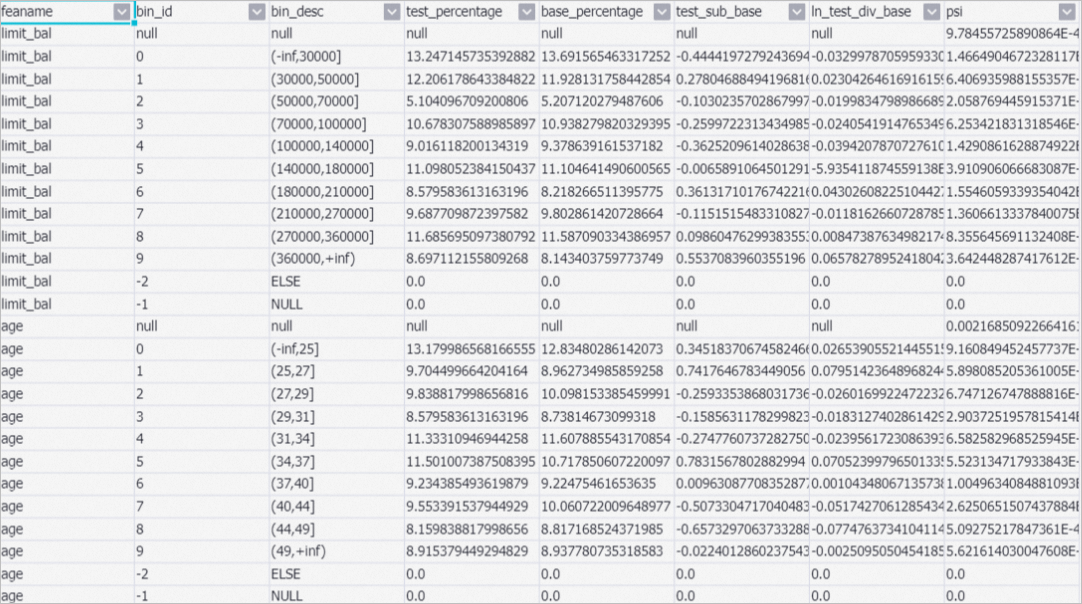
O PSI quantifica o desvio de distribuição. O PSI por feature corresponde à soma em todos os bins: abaixo de 0,1 = mudança insignificante; 0,1–0,25 = mudança moderada; acima de 0,25 = mudança significativa que exige revisão.
④
Treinamento do scorecard. Após a execução do pipeline, clique com o botão direito em Scorecard Training-1 e escolha para visualizar os resultados.
A tabela de resultados do modelo de scorecard apresenta estatísticas de binning para três features: intercepto, pay_0 (bins incluem (-inf,-1], (-1,0], (0,1], (1,2], (2,+inf), totalizando 8 linhas) e limit_bal (bins de (-inf,30000] a (360000,+inf), totalizando 11 linhas). As colunas incluem weight, scaled_weight e contribution, além de feaname, binid, bin, constraint, woe, total, positi, negativ, percentage_pos, percentage_neg, in_mode, test_woe e test_contribution.
Um scorecard converte pesos do modelo em pontuações compreensíveis para o negócio. Parâmetros principais:
-
weight: Valor original do peso.
-
Scaled_weight: Variação da pontuação por bin. Por exemplo, para pay_0: valores em (-1,0] reduzem a pontuação em 29; valores em (0,1] aumentam-na em 27.
-
contribution: Impacto da feature no resultado. Valores maiores indicam maior impacto.
⑤
Prevê scores de crédito e avalia o desempenho do modelo.
-
Execute o pipeline e visualize os resultados.
Clique no ícone de execução
 na parte superior da tela.
-
Após a conclusão do pipeline, clique com o botão direito em Scorecard Prediction-1 e escolha para visualizar os scores de crédito.
Os resultados de saída contêm os seguintes campos:
payment_next_month: Rótulo de comportamento de pagamento no mês seguinte (0 ou 1)
prediction_score: Score de crédito (ex.: 685, 525)
prediction_prob: Probabilidade da previsão
prediction_detail: Probabilidade detalhada para cada classe (formato JSON, contendo probabilidades para a classe 0 e classe 1)
Tópicos relacionados
Referências de componentes: