O Treinamento de Scorecard é um método de machine learning para avaliação de risco de crédito. Ele discretiza as variáveis originais por meio de binning e treina um modelo linear, como regressão logística ou linear. Este método inclui recursos de seleção de features e transformação de pontuação, permitindo aplicar restrições às variáveis durante o treinamento para melhorar a interpretabilidade e o desempenho do modelo. Sem binning, o Treinamento de Scorecard equivale à regressão logística ou linear padrão.
Limitações
O componente Scorecard Training armazena modelos temporários apenas como tabelas temporárias do MaxCompute. O ciclo de vida padrão dessas tabelas é de 369 dias no Machine Learning Studio. No Machine Learning Designer, o ciclo de vida depende do período de retenção de tabela temporária configurado para o workspace atual. Para obter mais informações sobre essa configuração, consulte Gerenciar workspaces. Para usar um modelo temporário a longo prazo, persista-o com o componente Write Table. Para instruções, consulte FAQ do Componente de Algoritmo.
Conceitos principais
O Treinamento de Scorecard envolve os seguintes conceitos:
-
Engenharia de features
A principal diferença entre um modelo de scorecard e um modelo linear padrão reside na engenharia de features aplicada aos dados antes do treinamento. O componente Scorecard Training oferece dois métodos:
-
Use o componente Binning para discretizar as features. Em seguida, aplique codificação one-hot em cada variável com base nos resultados do binning para gerar N variáveis dummy, onde N corresponde ao número de bins da variável.
NotaAo usar a transformação de variável dummy, defina restrições entre as variáveis dummy de cada variável original. Para mais detalhes, consulte Binning.
Use o componente Binning para discretizar as features e realize uma conversão de Weight of Evidence (WOE). Esse processo substitui o valor original de uma variável pelo valor WOE do bin no qual a variável se enquadra.
-
-
Transformação de pontuação
Na pontuação de crédito, uma transformação linear converte as odds previstas da amostra em uma pontuação. Essa transformação geralmente utiliza a seguinte fórmula.
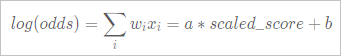 Especifique a transformação linear com os três parâmetros abaixo:
scaledValue: Pontuação de linha de base.
odds: Valor de odds na pontuação de linha de base especificada.
pdo (Points to Double Odds): Número de pontos que a pontuação deve aumentar para que o valor de odds dobre.
Por exemplo, se scaledValue=800, odds=50 e pdo=25, dois pontos na linha são definidos da seguinte forma:
log(50)=a×800+b
log(100)=a×825+b
Ao resolver para a e b, aplique a transformação linear às pontuações do modelo para obter as pontuações finais das variáveis.
Especifique as informações de escala no formato JSON usando o parâmetro
-Dscale, conforme o exemplo a seguir.{"scaledValue":800,"odds":50,"pdo":25}Se o parâmetro
-Dscalenão estiver vazio, especifique valores para scaledValue, odds e pdo. -
Restrições de treinamento
O Treinamento de Scorecard permite adicionar restrições às variáveis. Por exemplo, defina a pontuação de um bin específico como um valor fixo, imponha uma relação proporcional entre as pontuações de dois bins, limite o intervalo de pontuações entre bins ou ordene as pontuações dos bins de acordo com seus valores WOE. O algoritmo de otimização restrita subjacente implementa essas restrições. Configure-as visualmente no componente Binning, que gera uma condição formatada em JSON e a passa automaticamente para o componente de treinamento subsequente. No painel de configurações de parâmetros do nó Binning do seu experimento de scorecard, defina Feature Columns (suporta tipos STRING, BIGINT e DOUBLE), Label Column (o valor é class) e Positive Label como 1. Em seguida, selecione a opção Custom JSON File for Binning e carregue seu arquivo de restrição (por exemplo, binning.txt). O JSON de restrição é armazenado como uma string em uma tabela de linha e coluna únicas. O sistema suporta os seis tipos de restrições JSON a seguir:
"<": Impõe ordem crescente aos pesos das variáveis.
">": Impõe ordem decrescente aos pesos das variáveis.
"=": Define um peso de variável como um valor fixo.
"%": Estabelece uma relação proporcional entre os pesos das variáveis.
"UP": Estabelece um limite superior para o peso de uma variável. Por exemplo, um valor de 0,5 significa que o peso treinado não pode exceder 0,5.
"LO": Estabelece um limite inferior para o peso de uma variável. Por exemplo, um valor de 0,5 significa que o peso treinado deve ser de pelo menos 0,5.
Essa tabela deve conter uma única coluna do tipo STRING. O código a seguir mostra um exemplo de string JSON.
{ "name": "feature0", "<": [ [0,1,2,3] ], ">": [ [4,5,6] ], "=": [ "3:0","4:0.25" ], "%": [ ["6:1.0","7:1.0"] ] } -
Restrições integradas
Cada variável original possui uma restrição implícita que não precisa ser especificada: a pontuação média de uma única variável em toda a população é zero. Devido a essa restrição, o scaled_weight do intercepto do modelo representa a pontuação média de toda a população.
-
Algoritmos de otimização
Configure o algoritmo de otimização nas opções avançadas. O sistema suporta os quatro algoritmos a seguir:
L-BFGS: Algoritmo de otimização de primeira ordem adequado para grandes conjuntos de dados de features. Trata-se de um algoritmo de otimização irrestrita que ignora automaticamente quaisquer restrições especificadas.
Método de Newton: Algoritmo clássico de segunda ordem conhecido pela convergência rápida e alta precisão. No entanto, não é adequado para features em grande escala, pois exige o cálculo de uma matriz Hessiana de segunda ordem. Também é um algoritmo de otimização irrestrita e ignora quaisquer restrições especificadas.
Método de barreira: Algoritmo de otimização de segunda ordem. Sem restrições, equivale ao método de Newton. Seu desempenho computacional e precisão assemelham-se aos do SQP.
-
SQP
O SQP é um algoritmo de otimização de segunda ordem que suporta restrições. Na ausência de restrições, comporta-se de maneira idêntica ao método de Newton. Recomendamos geralmente o uso do SQP, pois seu desempenho é similar ao do método de barreira.
NotaL-BFGS e o método de Newton são algoritmos de otimização irrestrita. O método de barreira e o SQP são algoritmos de otimização restrita.
Se você não estiver familiarizado com algoritmos de otimização, defina o algoritmo como Auto Selection. O sistema escolhe automaticamente o mais adequado com base no tamanho dos seus dados e nas restrições aplicadas.
-
Seleção de features
O componente de treinamento suporta seleção de features passo a passo. Esse método combina seleção direta e eliminação reversa. Sempre que uma nova variável é adicionada ao modelo por meio da seleção direta, o sistema executa uma etapa de eliminação reversa em todas as variáveis já presentes para remover aquelas que não atendem mais ao requisito de significância. Como suporta múltiplas funções objetivo e métodos de transformação de features, o processo passo a passo aceita os seguintes critérios de seleção:
-
Contribuição marginal: Aplicável a todas as funções objetivo e métodos de engenharia de features.
A contribuição marginal de uma variável X é a diferença entre os valores da função objetivo de dois modelos na convergência: Modelo A (sem X) e Modelo B (com todas as variáveis de A mais X). Ao utilizar a transformação de variável dummy, a contribuição marginal da variável original X é definida como a diferença na função objetivo entre dois modelos: um incluindo todas as variáveis dummy para X e outro sem elas. Portanto, o uso da contribuição marginal para seleção de features é compatível com todos os métodos de engenharia de features.
A vantagem desse método é sua flexibilidade. Ele não se limita a um tipo específico de modelo e seleciona diretamente as variáveis que melhoram a função objetivo. A desvantagem é que, diferentemente da significância estatística (onde um valor-p de 0,05 é um limiar comum), a contribuição marginal não possui um limiar universalmente aceito. Para novos usuários, recomendamos começar com um limiar de 10E-5.
-
Teste de escore: Suporta apenas regressão logística com conversão WOE ou sem engenharia de features.
No processo de seleção direta, treina-se primeiro um modelo contendo apenas o intercepto. Em cada etapa subsequente, calcula-se a estatística qui-quadrado de escore para cada variável ainda não incluída no modelo. A variável com o maior qui-quadrado de escore é adicionada ao modelo. O processo então calcula um valor-p correspondente a essa estatística com base na distribuição qui-quadrado. Se o valor-p da melhor variável for maior que o limiar de entrada especificado (slentry), a variável não é adicionada e o processo de seleção é interrompido.
Após uma rodada de seleção direta, executa-se uma rodada de eliminação reversa nas variáveis já presentes no modelo. Durante a eliminação reversa, o processo calcula a estatística qui-quadrado de Wald e seu valor-p correspondente para cada variável no modelo. Se o valor-p de uma variável exceder o limiar de remoção especificado (slstay), ela é removida do modelo e o processo continua para a próxima iteração.
-
Teste F: Suporta apenas regressão linear com conversão WOE ou sem engenharia de features.
No processo de seleção direta, treina-se primeiro um modelo contendo apenas o intercepto. Em cada etapa subsequente, calcula-se o valor F para cada variável ainda não incluída no modelo. Calcular o valor F assemelha-se a calcular a contribuição marginal, pois requer o treinamento de dois modelos. O valor F segue uma distribuição F, e seu valor-p correspondente pode ser derivado de sua função de densidade de probabilidade. Se o valor-p de uma variável exceder o limiar de entrada especificado (slentry), ela não é adicionada ao modelo e o processo é interrompido.
O processo de eliminação reversa também utiliza o valor F para calcular a significância, de forma muito semelhante ao teste de escore.
-
-
Variáveis forçadas
Antes do início da seleção de features, force a inclusão de certas variáveis no modelo. Essas variáveis são excluídas dos processos de seleção direta e reversa, sendo incluídas no modelo final independentemente de sua significância. Use o parâmetro -Dselected na linha de comando para especificar o número de iterações e os limiares de significância no formato JSON. O código a seguir mostra um exemplo.
{"max_step":2, "slentry": 0.0001, "slstay": 0.0001}Se o parâmetro -Dselected estiver vazio ou se max_step for 0, o processo de treinamento prossegue sem seleção de features.
Configuração do componente
Configure o componente Scorecard Training no Machine Learning Designer usando a interface visual ou executando um comando PAI. O código a seguir mostra um exemplo de comando PAI.
pai -name=linear_model -project=algo_public
    -DinputTableName=input_data_table
    -DinputBinTableName=input_bin_table
    -DinputConstraintTableName=input_constraint_table
    -DoutputTableName=output_model_table
    -DlabelColName=label
    -DfeatureColNames=feaname1,feaname2
    -Doptimization=barrier_method
    -Dloss=logistic_regression
-Dlifecycle=8|
Parâmetro |
Obrigatório |
Padrão |
Descrição |
|
inputTableName |
Sim |
N/A |
Tabela de dados de features de entrada. |
|
inputTablePartitions |
Não |
Toda a tabela |
Partições selecionadas da tabela de features de entrada. |
|
inputBinTableName |
Não |
N/A |
Tabela de resultados de binning de entrada. Se especificada, o sistema discretiza as features originais com base nas regras de binning desta tabela antes do treinamento. |
|
featureColNames |
Não |
Todas as colunas, exceto a coluna de rótulo. |
Colunas de features a serem usadas da tabela de entrada. |
|
labelColName |
Sim |
N/A |
Coluna de rótulo. |
|
outputTableName |
Sim |
N/A |
Tabela de modelo de saída. |
|
inputConstraintTableName |
Não |
N/A |
Tabela de entrada que contém as restrições formatadas em JSON, armazenadas em uma única célula. |
|
optimization |
Não |
auto |
Algoritmo de otimização. Valores válidos:
Apenas sqp e barrier_method suportam restrições. auto seleciona automaticamente o algoritmo de otimização mais adequado com base nos seus dados e parâmetros. Se você não estiver familiarizado com algoritmos de otimização, use auto. |
|
loss |
Não |
logistic_regression |
Tipo de função de perda. Os valores válidos são logistic_regression e least_square. |
|
iterations |
Não |
100 |
Número máximo de iterações de otimização. |
|
l1Weight |
Não |
0 |
Peso da regularização L1. Válido apenas para o algoritmo de otimização lbfgs. |
|
l2Weight |
Não |
0 |
Peso da regularização L2. |
|
m |
Não |
10 |
Comprimento do histórico para o processo de otimização lbfgs. Aplicável apenas ao algoritmo lbfgs. |
|
scale |
Não |
Vazio |
Informações usadas para escalar os pesos do scorecard. |
|
selected |
Não |
Vazio |
Configurações de seleção de features para o scorecard. |
|
convergenceTolerance |
Não |
1e-6 |
Tolerância de convergência. |
|
positiveLabel |
Não |
1 |
Rótulo para amostras positivas. |
|
lifecycle |
Não |
N/A |
Ciclo de vida da tabela de saída. |
|
coreNum |
Não |
Determinado pelo sistema |
Número de núcleos. |
|
memSizePerCore |
Não |
Determinado pelo sistema |
Tamanho da memória por núcleo, em MB. |
Saída do componente
O componente Scorecard Training gera um relatório de modelo que inclui informações de binning, restrições de bin e estatísticas principais, como WOE e contribuição marginal. A tabela a seguir descreve as colunas do relatório de avaliação do modelo exibido no console web do PAI.
|
Coluna |
Tipo |
Descrição |
|
feaname |
STRING |
Nome da feature. |
|
binid |
BIGINT |
ID do bin. |
|
bin |
STRING |
Descrição do bin, indicando o intervalo de valores. |
|
constraint |
STRING |
Restrição aplicada a este bin durante o treinamento. |
|
weight |
DOUBLE |
Peso da variável com binning após o treinamento. Para modelos que não são scorecards e onde nenhuma entrada de binning foi especificada, representa o peso da variável do modelo. |
|
scaled_weight |
DOUBLE |
Valor de pontuação resultante da aplicação da transformação de pontuação especificada ao peso da variável com binning durante o treinamento do modelo. |
|
woe |
DOUBLE |
Valor WOE deste bin no conjunto de treinamento. |
|
contribution |
DOUBLE |
Valor de contribuição marginal deste bin no conjunto de treinamento. |
|
total |
BIGINT |
Número total de amostras neste bin no conjunto de treinamento. |
|
positive |
BIGINT |
Número de amostras positivas neste bin no conjunto de treinamento. |
|
negative |
BIGINT |
Número de amostras negativas neste bin no conjunto de treinamento. |
|
percentage_pos |
DOUBLE |
Razão entre as amostras positivas neste bin e o total de amostras positivas no conjunto de treinamento. |
|
percentage_neg |
DOUBLE |
Razão entre as amostras negativas neste bin e o total de amostras negativas no conjunto de treinamento. |
|
test_woe |
DOUBLE |
Valor WOE deste bin no conjunto de teste. |
|
test_contribution |
DOUBLE |
Valor de contribuição marginal deste bin no conjunto de teste. |
|
test_total |
BIGINT |
Número total de amostras neste bin no conjunto de teste. |
|
test_positive |
BIGINT |
Número de amostras positivas neste bin no conjunto de teste. |
|
test_negative |
BIGINT |
Número de amostras negativas neste bin no conjunto de teste. |
|
test_percentage_pos |
DOUBLE |
Razão entre as amostras positivas neste bin e o total de amostras positivas no conjunto de teste. |
|
test_percentage_neg |
DOUBLE |
Razão entre as amostras negativas neste bin e o total de amostras negativas no conjunto de teste. |