O Mixtral-8x7B é um modelo open source de Mixture-of-Experts esparso da Mistral AI que supera o GPT-3.5 em diversos benchmarks. O PAI Model Gallery oferece implantação pronta para uso e ajuste fino LoRA para este modelo.
Visão geral do modelo
O Mixtral-8x7B é um LLM baseado apenas em decodificador com arquitetura Sparse Mixture-of-Experts (SMoE), lançado sob a licença Apache 2.0. Uma rede roteadora seleciona dois dos oito grupos de especialistas por token e combina suas saídas. Embora o modelo possua 47 bilhões de parâmetros no total, apenas 13 bilhões ficam ativos por token, resultando em uma velocidade de inferência comparável à de um modelo de 13B.
O Mixtral-8x7B suporta inglês, francês, alemão, espanhol e italiano, com um contexto de 32 mil tokens. Ele iguala ou supera o LLaMA2-70B e o GPT-3.5 em todos os benchmarks avaliados, além de apresentar desempenho significativamente superior ao LLaMA2-70B em tarefas de matemática, geração de código e cenários multilíngues.
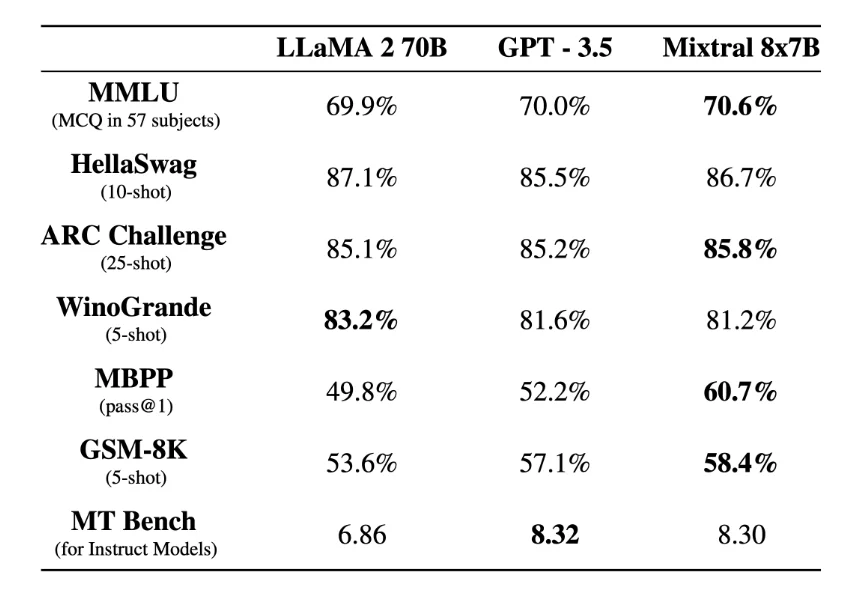
*Fonte: arXiv:2401.04088*
A Mistral AI também lançou o Mixtral-8x7B-Instruct-v0.1, uma variante ajustada para instruções e otimizada com ajuste fino supervisionado e Direct Preference Optimization (DPO). Essa versão segue instruções humanas com maior precisão e supera outros modelos open source ajustados para instruções em tarefas conversacionais.
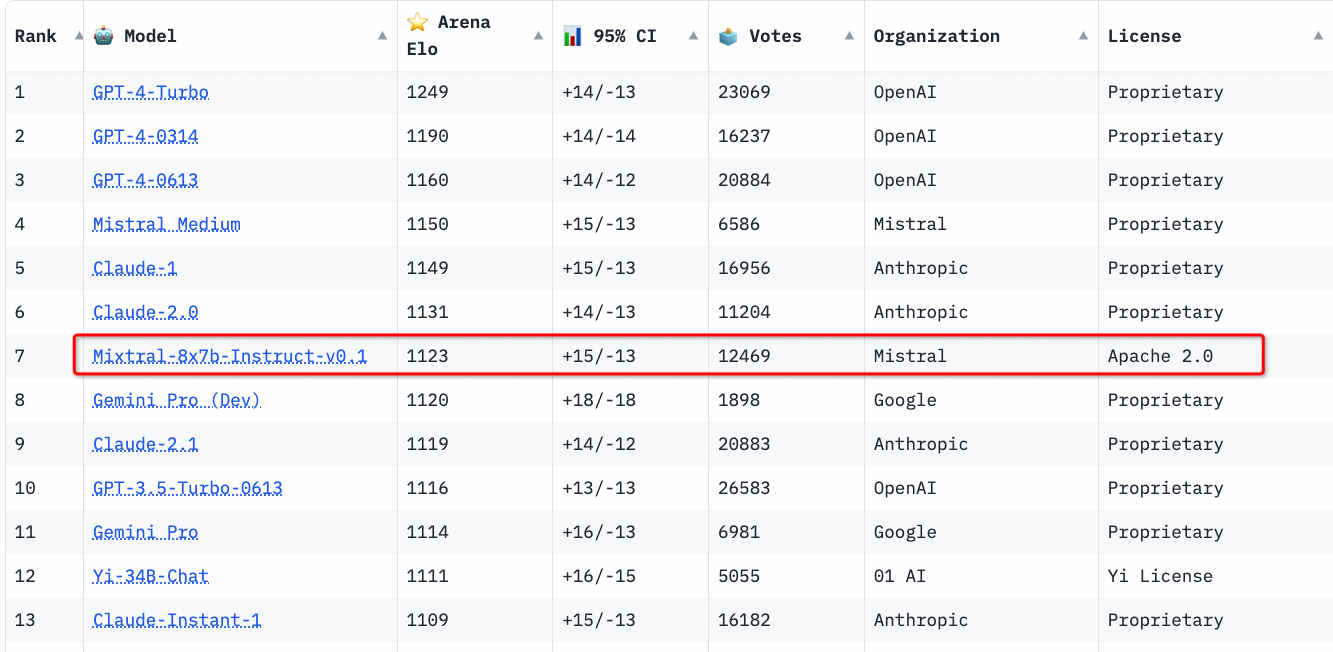
*Fonte: Chatbot Arena Leaderboard*
Pré-requisitos
Ative os recursos do Lingjun Intelligent Computing Service. Crie um grupo de recursos e adquira recursos do Lingjun Intelligent Computing Service.
Requisitos de ambiente
Este exemplo requer clusters PAI Lingjun na região China (Ulanqab).
Recomenda-se o uso de GPUs GU108 (80 GB de VRAM). A inferência exige pelo menos duas GPUs; o ajuste fino LoRA necessita de no mínimo quatro.
Usar o modelo no PAI console
Implantar e chamar o modelo
-
Acesse a página Model Gallery.
Faça login no PAI console.
Na barra de navegação superior, selecione a região China (Ulanqab).
No painel de navegação à esquerda, clique em workspaces. Na página Workspaces, clique no nome do workspace desejado.
No painel de navegação à esquerda, escolha QuickStart > Model Gallery para acessar a página Model Gallery.
Na lista de modelos à direita, clique no cartão do modelo Mixtral-8x7B-Instruct-v0.1 para abrir a página Model Details.
-
No canto superior direito, clique em Deploy. Configure os recursos de computação Lingjun e clique em Deploy para implantar o modelo no PAI-EAS.
Este modelo requer recursos do Lingjun Intelligent Computing Service. A cota de recursos deve incluir pelo menos duas GPUs GU108.
No painel de configuração de implantação, defina Resource group type como Lingjun Intelligent Computing Service, Number of instances como 1, CPU como 40 e Memory (MB) como 256000. Em seguida, clique em Deploy.
-
Chame o service de inferência.
HTTP API
O service de inferência oferece suporte a uma API compatível com OpenAI. Obtenha o endpoint e o token de acesso na página de detalhes do service e chame-o usando curl:
# Replace  and  with the actual endpoint and token of your service.
export API_ENDPOINT="<ENDPOINT>"
export API_TOKEN="<TOKEN>"
# List available models
curl $API_ENDPOINT/v1/models \
	-H "Content-Type: application/json" \
	-H "Authorization: Bearer $API_TOKEN"
# Call the general text completion API
curl $API_ENDPOINT/v1/completions \
    -H "Content-Type: application/json" \
    -H "Authorization: Bearer $API_TOKEN" \
    -d '{
			"model": "Mixtral-8x7B-Instruct-v0.1",
			"prompt": "San Francisco is a",
			"max_tokens": 256,
			"temperature": 0
	}'
# Call the chat completion API
curl $API_ENDPOINT/v1/chat/completions \
    -H "Authorization: Bearer $API_TOKEN" \
    -H "Content-Type: application/json" \
    -d '{
			"model": "Mixtral-8x7B-Instruct-v0.1",
      "messages": [
          {"role": "user", "content": "Tell me about the history of Shanghai."}
        ]
      }'
SDK
Para chamar o service com o SDK OpenAI, instale primeiro o SDK:
# Install the SDK to call the service
python -m pip install openai
Chame o service de inferência usando o SDK:
import openai
# Replace  and  with the token and endpoint from the service details page.
openai.api_key = "<TOKEN>"
openai.base_url = "<ENDPOINT>" + "/v1"
# Call the chat completion API
completion = openai.chat.completions.create(
    model="Mixtral-8x7B-Instruct-v0.1",
    temperature=0.0,
    top_p=0.8,
    frequency_penalty=0.0,
    messages=[{"role": "user", "content": "Tell me about yourself."}],
    # stream=True,
)
# Print the output content
print(completion.choices[0].message.content)
Ajustar o modelo
O Model Gallery disponibiliza um algoritmo de ajuste fino pronto para uso com o Mixtral-8x7B-Instruct-v0.1.
Os dados de treinamento devem estar no formato JSON. Cada entrada exige um campo instruction (pergunta) e um campo output (resposta):
[
    {
        "instruction": "Write a poem on a topic 'On a Political Prisoner': \n",
        "output": "She that but little patience knew,\r\nFrom childhood on, had now so much\r\nA grey gull lost its fear and flew\r\nDown to her cell and there alit,\r\nAnd there endured her fingers' touch\r\nAnd from her fingers ate its bit.\r\nDid she in touching that lone wing."
    },
    {
        "instruction": "Write a poem on a topic 'To His Love': ",
        "output": "He's gone, and all our plans\r\n   Are useless indeed.\r\nWe'll walk no more on Cotswold\r\n   Where the sheep feed\r\n   Quietly and take no heed.\r\n His body that was so quick\r\n   Is not as you\r\nKnew it, on Severn river\r\n   Under the blue\r\n   Driving our small boat through."
    }
]-
Na página Model Details, clique em Fine-tune no canto superior direito. As principais configurações são:
Configuração de dataset: Faça upload dos dados para um bucket OSS ou especifique um dataset NAS ou CPFS. O PAI também fornece datasets públicos para testes.
Configuração de recursos de computação: São necessárias quatro GPUs GU108 (80 GB de VRAM). Verifique se há cota suficiente.
-
Configuração de hiperparâmetros: Ajuste os hiperparâmetros abaixo conforme seus dados e recursos de computação ou utilize os valores padrão.
Parâmetro
Tipo
Padrão
Obrigatório
Descrição
learning_rate
float
5e-5
Sim
Controla o tamanho do passo nas atualizações de peso durante o treinamento.
num_train_epochs
int
1
Sim
Número de iterações completas sobre o dataset de treinamento.
per_device_train_batch_size
int
1
Sim
Amostras processadas por GPU a cada iteração. Valores maiores aumentam o throughput, mas elevam o uso de VRAM.
seq_length
int
128
Sim
Comprimento da sequência de entrada por etapa de treinamento.
lora_dim
int
16
Não
Dimensão do LoRA. Se lora_dim > 0, ativa o ajuste fino leve com LoRA ou QLoRA.
lora_alpha
int
32
Não
Fator de escala alpha do LoRA. Utilizado quando lora_dim > 0.
load_in_4bit
bool
true
Não
Define se o modelo deve ser carregado em 4 bits.
Se lora_dim > 0, load_in_4bit for true e load_in_8bit for false, o ajuste fino leve usará QLoRA de 4 bits.
load_in_8bit
bool
false
Não
Define se o modelo deve ser carregado em 8 bits.
Se lora_dim > 0, load_in_4bit for false e load_in_8bit for true, o ajuste fino leve usará QLoRA de 8 bits.
gradient_accumulation_steps
int
8
Não
Número de etapas de acumulação de gradiente.
apply_chat_template
bool
true
Não
Indica se o algoritmo aplica o template de chat padrão do modelo aos dados de treinamento. Exemplo:
-
Pergunta:
<|begin_of_text|><|start_header_id|>user<|end_header_id|>\n\n + instruction + <|eot_id|> -
Resposta:
<|start_header_id|>assistant<|end_header_id|>\n\n + output + <|eot_id|>
-
-
Ao clicar em Fine-tune, a página do job de treinamento será aberta e o job iniciará automaticamente.
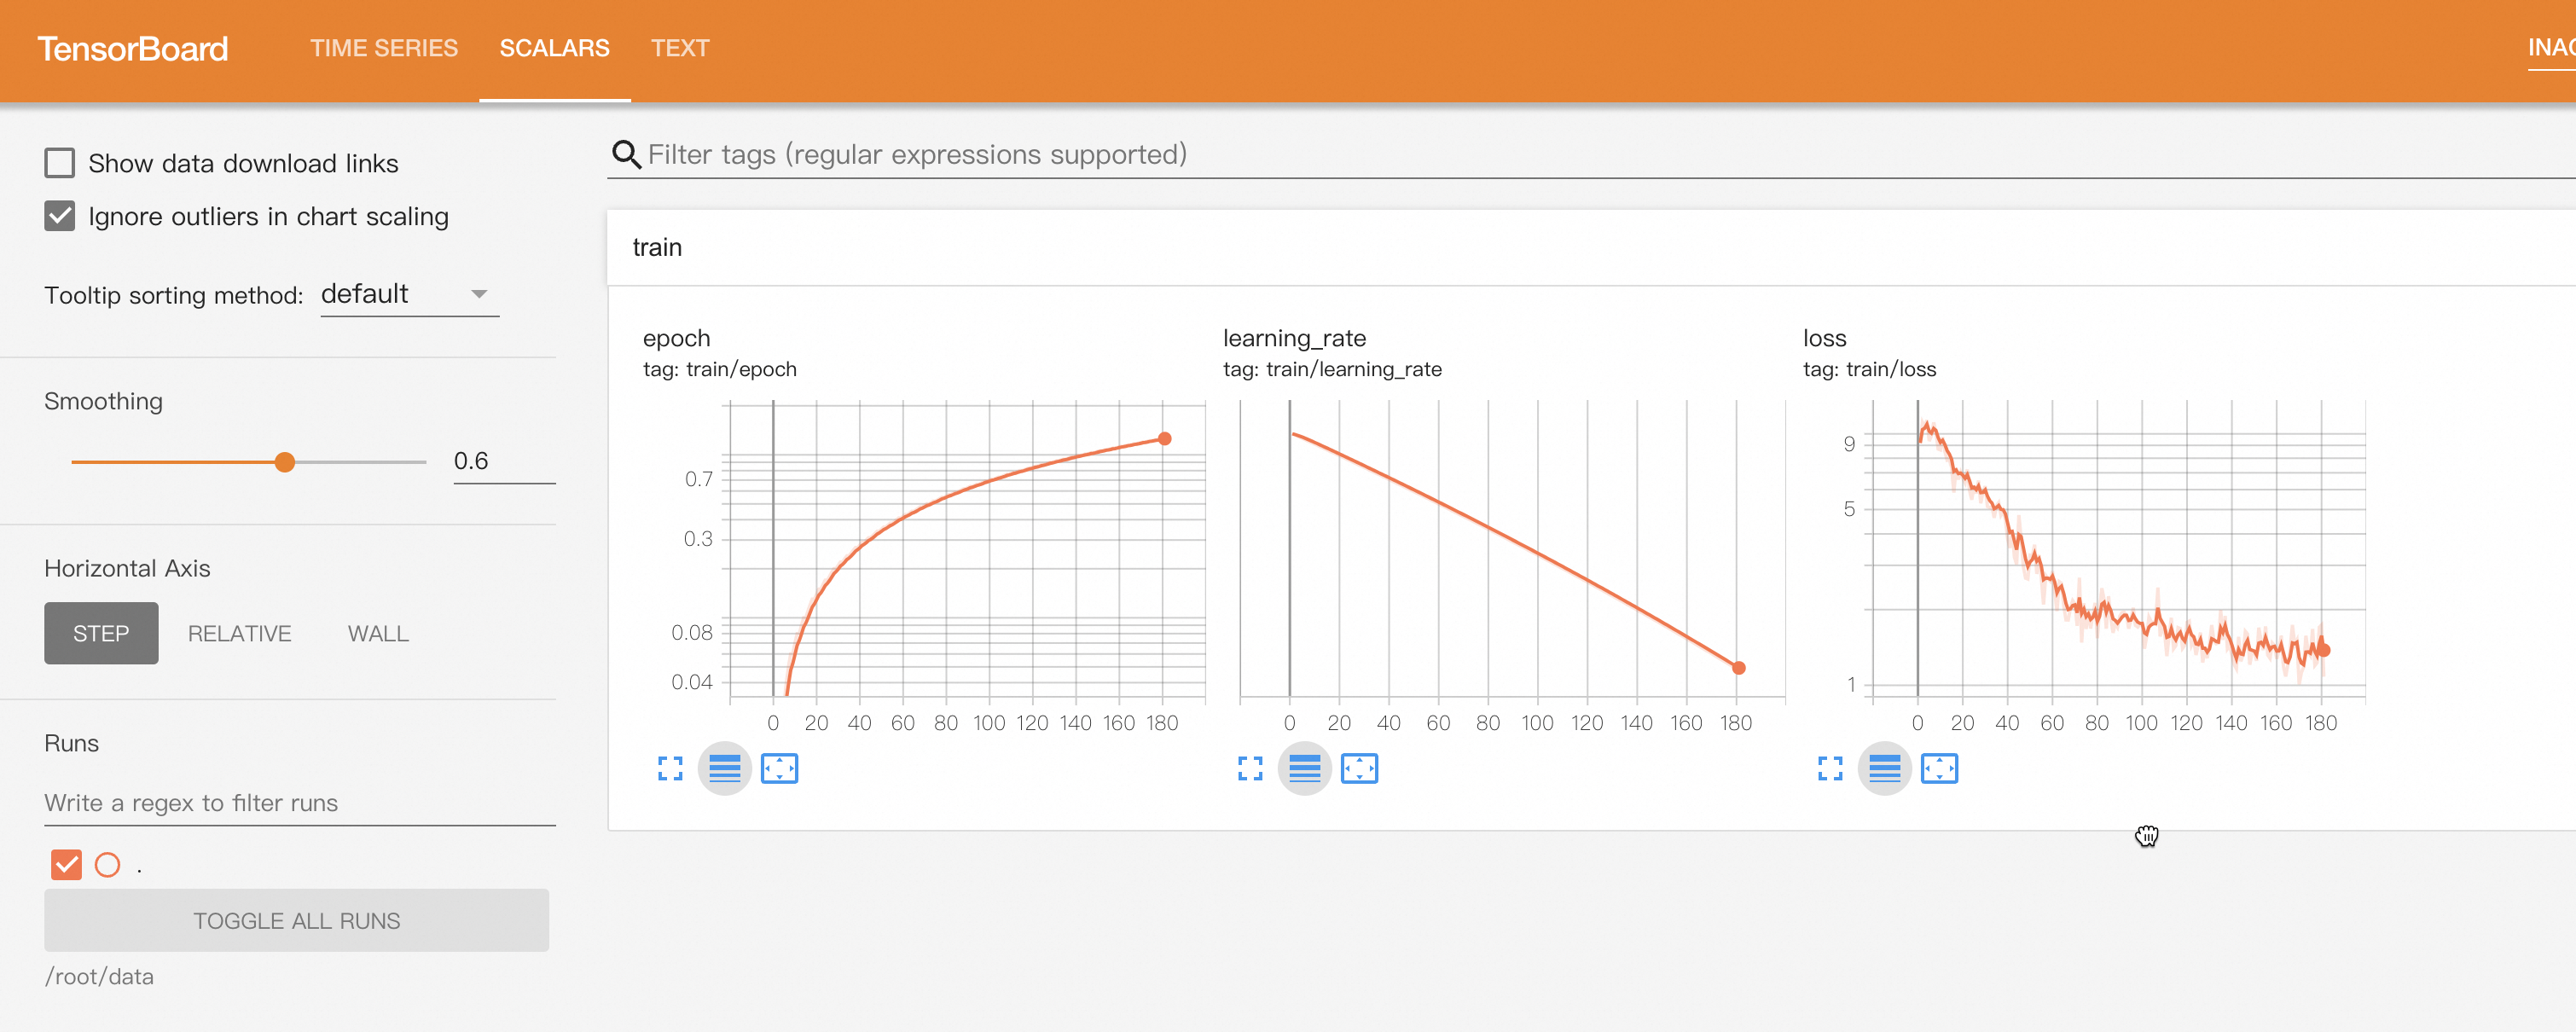
No canto superior direito, clique em Tensorboard para abrir o TensorBoard e monitorar a convergência do modelo.
O modelo treinado é registrado automaticamente em AI Assets - Model Management. Registre e gerencie modelos.
Usar o modelo com o PAI SDK
Também é possível utilizar modelos do Model Gallery com o PAI SDK for Python. Instale e configure o SDK:
# Install the PAI SDK for Python
python -m pip install alipai --upgrade
# Interactively configure your access credentials, PAI workspace, and other information
python -m pai.toolkit.config
Configure as credenciais de acesso (par AccessKey) e o workspace conforme descrito em Instalação e configuração.
Implantar e chamar o modelo
Implante o modelo Mixtral no PAI-EAS usando as configurações de inferência pré-definidas do Model Gallery. Forneça o nome do service e os detalhes dos recursos:
from pai.session import get_default_session
from pai.model import RegisteredModel
from pai.common.utils import random_str
from pai.predictor import Predictor
session = get_default_session()
# Get the model provided by PAI QuickStart
m = RegisteredModel(
    model_name="Mixtral-8x7B-Instruct-v0.1",
    model_provider="pai",
)
# View the default deployment configuration of the model
print(m.inference_spec)
# Deploy the inference service
# You must provide the ID of a Lingjun resource quota (QuotaId) that has at least two GU108 (80 GB of VRAM) GPU cards.
predictor = m.deploy(
    service_name="mixtral_8_7b_{}".format(random_str(6)),
    options={
        # Resource quota ID
        "metadata.quota_id": "<LingJunResourceQuotaId>",
        "metadata.quota_type": "Lingjun",
        "metadata.workspace_id": session.workspace_id,
    }
)
# Get the endpoint and token of the inference service
endpoint = predictor.internet_endpoint
token = predictor.access_token
Chame o service de inferência pelos métodos Chame o service de inferência acima ou use diretamente o PAI SDK:
from pai.predictor import Predictor
p = Predictor("<MixtralServiceName>")
res = p.raw_predict(
    path="/v1/chat/completions",
    method="POST",
    data={
        "model": "Mixtral-8x7B-Instruct-v0.1",
        "messages": [
            {"role": "user", "content": "Tell me about the history of Shanghai."}
        ]
    }
)
print(res.json())
Após os testes, exclua o service pelo console ou via SDK para liberar os recursos.
# Delete the service
predictor.delete_service()
Ajustar o modelo
Recupere um modelo do Model Gallery para visualizar seu algoritmo de ajuste fino, os hiperparâmetros suportados e a configuração de entrada/saída:
from pai.model import RegisteredModel
# Get the Mixtral-8x7B-Instruct-v0.1 model provided by PAI QuickStart
m = RegisteredModel(
    model_name="Mixtral-8x7B-Instruct-v0.1",
    model_provider="pai",
)
# Get the fine-tuning algorithm configured for the model
est = m.get_estimator()
# View the supported hyperparameters and the input/output information of the algorithm
print(est.hyperparameter_definitions)
print(est.input_channel_definitions)
Atualmente, o algoritmo de ajuste fino do Mixtral-8x7B-Instruct-v0.1 suporta apenas recursos do Lingjun Intelligent Computing Service. Obtenha o ID da sua cota de recursos no PAI console e configure os hiperparâmetros antes de enviar o job:
# Configure the Lingjun resource quota ID for the training job
est.resource_id = "<LingjunResourceQuotaId>"
# Configure the hyperparameters for the training job
hps = {
    "learning_rate": 1e-5,
    "per_device_train_batch_size": 2,
}
est.set_hyperparameters(**hps)
O algoritmo de ajuste fino aceita três entradas:
model: O modelo pré-treinado Mixtral-8x7B-Instruct-v0.1.train: O dataset de treinamento para o ajuste fino.validation: O dataset de validação para o ajuste fino.
O formato necessário do dataset está descrito na seção Ajuste o modelo. Faça upload dos dados para um bucket OSS usando ossutil, o console ou o SDK:
from pai.common.oss_utils import upload
# View the inputs used by the model's fine-tuning algorithm
# Get the input data for the algorithm, including the model and a public dataset for testing.
training_inputs = m.get_estimator_inputs()
print(training_inputs)
# {
#     "model": "oss://pai-quickstart-cn-wulanchabu.oss-cn-wulanchabu-internal.aliyuncs.com/huggingface/models/Mixtral-8x7B-Instruct-v0.1/main/",
#     "train": "oss://pai-quickstart-cn-wulanchabu.oss-cn-wulanchabu-internal.aliyuncs.com/huggingface/datasets/llm_instruct/en_poetry_train_mixtral.json",
#     "validation": "oss://pai-quickstart-cn-wulanchabu.oss-cn-wulanchabu-internal.aliyuncs.com/huggingface/datasets/llm_instruct/en_poetry_test_mixtral.json",
# }
# Upload user data. Replace the following local file path and the destination OSS bucket path.
train_data_uri = upload("/path/to/local/train.json", "path/of/train/data")
validation_data_uri = upload("/path/to/local/validation.json", "path/of/validation/data")
# Replace the training data with your own.
# training_inputs["train"] = train_data_uri
# training_inputs["validation"] = validation_data_uri
Substitua as entradas train e validation pelos seus próprios datasets e envie o job de ajuste fino. Use o link exibido para verificar o status e os logs no PAI console ou abra o TensorBoard para monitorar a convergência:
from pai.common.oss_utils import download
# Submit the training job and print the link to the job
est.fit(
    inputs=training_inputs,
    wait=False,
)
# Open TensorBoard to view training progress
est.tensorboard()
# Wait for the training job to complete
est.wait()
# View the model path on the OSS bucket
print(est.model_data())
# You can download the model to your local machine by using ossutil or the utility methods provided by the SDK.
download(est.model_data())
Guia completo de integração com o SDK: Usar modelos pré-treinados — PAI SDK for Python.