O componente Linear Model Feature Importance calcula a importância das features para modelos lineares, incluindo regressão linear e regressão logística para classificação binária. Ele aceita formatos de dados esparsos e densos. Este tópico descreve como configurar o componente.
Limitações
O mecanismo de computação compatível é o MaxCompute.
Configuração do componente
Configure os parâmetros do componente Linear Model Feature Importance de uma das seguintes maneiras:
Método 1: Interface visual
Defina os parâmetros do componente na página de pipeline no Machine Learning Designer.
|
Aba |
Parâmetro |
Descrição |
|
Fields Setting |
Feature Columns |
Colunas de features da tabela de entrada usadas no treinamento. Parâmetro opcional. Por padrão, todas as colunas são utilizadas, exceto a coluna de rótulo. |
|
Target Column |
Obrigatório. Clique em Select Fields para selecionar a coluna de rótulo. |
|
|
Input table data is in sparse format |
Opcional. |
|
|
Tuning |
Number of Cores |
Número de núcleos para computação. Opcional. |
|
Memory per Core (MB) |
Memória por núcleo, em MB. Opcional. |
Método 2: Comando PAI
Defina os parâmetros executando um comando PAI no componente SQL Script. Para mais informações, consulte SQL Script.
PAI -name regression_feature_importance -project algo_public
    -DmodelName=xlab_m_logisticregressi_20317_v0
    -DoutputTableName=pai_temp_2252_20321_1
    -DlabelColName=y
    -DfeatureColNames=pdays,previous,emp_var_rate,cons_price_idx,cons_conf_idx,euribor3m,nr_employed,age,campaign
-DenableSparse=false -DinputTableName=pai_dense_10_9;|
Parâmetro |
Obrigatório |
Descrição |
Padrão |
|
inputTableName |
Sim |
Nome da tabela de entrada. |
Nenhum |
|
outputTableName |
Sim |
Nome da tabela de saída. |
Nenhum |
|
labelColName |
Sim |
Nome da coluna de rótulo na tabela de entrada. |
Nenhum |
|
modelName |
Sim |
Nome do modelo de entrada. |
Nenhum |
|
featureColNames |
Não |
Colunas de features a serem selecionadas na tabela de entrada. |
Todas as colunas, exceto a coluna de rótulo. |
|
inputTablePartitions |
Não |
Partições a serem usadas da tabela de entrada. |
Tabela inteira. |
|
enableSparse |
Não |
Indica se os dados de entrada estão em formato esparso. |
false |
|
itemDelimiter |
Não |
Delimitador entre pares chave-valor para dados de entrada em formato esparso. |
Espaço |
|
kvDelimiter |
Não |
Delimitador entre chave e valor para dados de entrada em formato esparso. |
Dois pontos (:) |
|
lifecycle |
Não |
Ciclo de vida da tabela de saída, em dias. |
Não especificado |
|
coreNum |
Não |
Número de núcleos. |
Automático |
|
memSizePerCore |
Não |
Memória por núcleo, em MB. |
Automático |
Exemplo
Crie uma tabela chamada
bank_datae importe dados para ela. Para mais informações, consulte Criar uma tabela e Importar dados.-
Execute a seguinte instrução SQL para gerar os dados de treinamento:
create table if not exists pai_dense_10_9 as select age,campaign,pdays, previous, emp_var_rate, cons_price_idx, cons_conf_idx, euribor3m, nr_employed, fixed_deposit from bank_data limit 10; -
Construa e execute um pipeline. Para mais informações, consulte Modelagem de algoritmos. Para conectar os componentes, ligue a saída de Read Table-1 às entradas de Logistic Regression for Multiclass Classification e Linear Model Feature Importance. Em seguida, conecte a saída de Logistic Regression for Multiclass Classification à entrada de Linear Model Feature Importance.
Arraste os componentes Read Table, Logistic Regression for Multiclass Classification e Linear Model Feature Importance da lista de componentes no Machine Learning Designer para o canvas.
Conecte os componentes para montar o pipeline.
-
Configure os parâmetros de cada componente:
No canvas, clique em Read Table-1. No painel à direita, na aba Select Table, defina Table Name como
bank_data.No canvas, clique em Logistic Regression for Multiclass Classification-1. No painel à direita, na aba Fields Setting, defina Feature Columns como
age,campaign,pdays,previous,emp_var_rate,cons_price_idx,cons_conf_idx,euribor3menr_employed. Defina Target Column comofixed_deposit. Mantenha os valores padrão para os demais parâmetros.No canvas, clique em Linear Model Feature Importance-1. No painel à direita, na aba Fields Setting, defina Target Column como
fixed_deposit. Mantenha os valores padrão para os demais parâmetros.
Após configurar os parâmetros, clique em Run
 .
-
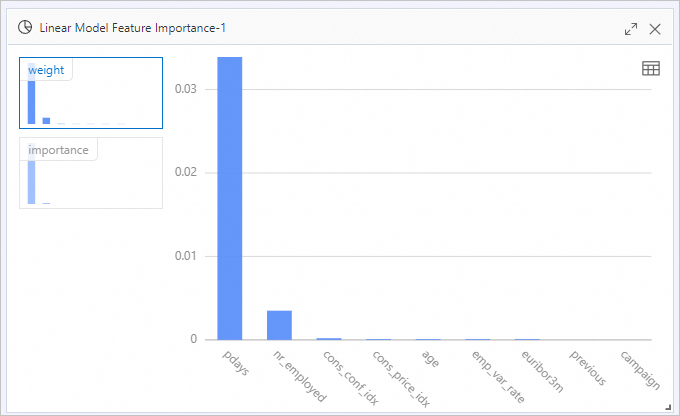
Após a execução bem-sucedida do pipeline, clique com o botão direito no componente Linear Model Feature Importance-1 e escolha . O componente Linear Model Feature Importance gera uma tabela que exibe colname, weight e importance de cada feature. Os valores aparecem em notação científica. Por exemplo, o peso da feature
ageé9.61816270808075E-5.As fórmulas das métricas são as seguintes:
Nome da coluna
Fórmula
weight
abs(w_)
importance
abs(w_j) * STD(f_i)
Notaabs(w_j)é o valor absoluto do coeficiente da feature, eSTD(f_i)é o desvio padrão dos dados de treinamento. Clique com o botão direito no componente Linear Model Feature Importance-1 e selecione View Analytics Report.
Documentos relacionados
Para mais informações sobre os componentes do Machine Learning Designer, consulte Visão geral do Machine Learning Designer.
Para explorar outros componentes de algoritmos integrados adequados ao seu caso de uso, consulte Referência de componentes: Todos os componentes.