A matriz de confusão é usada em aprendizado supervisionado e equivale a uma matriz de correspondência no aprendizado não supervisionado. Na avaliação de desempenho, ela compara os resultados da classificação com os valores reais e exibe a precisão da classificação em formato matricial. Este tópico descreve como configurar o componente Confusion Matrix.
Limitações
O MaxCompute é o único mecanismo de computação compatível.
Configuração do componente
Configure o componente Confusion Matrix por um dos métodos a seguir.
Método 1: Usar a interface
Defina os parâmetros do componente na página de pipeline do Machine Learning Designer.
|
Parâmetro |
Descrição |
|
Original Label Column |
Aceita tipos de dados numéricos. |
|
Prediction Result Label Column |
Obrigatório se Threshold não for especificado. |
|
Threshold |
Uma amostra é considerada positiva se seu valor for superior a este limiar. |
|
Prediction Result Detail Column |
Incompatível com Prediction Result Label Column. Necessário se Threshold estiver definido. |
|
Positive Sample Label |
Obrigatório se Threshold for especificado. |
Método 2: Usar um comando PAI
Use comandos PAI para definir os parâmetros do componente. Execute esses comandos pelo componente SQL Script. Para mais informações, consulte Script SQL.
-
Sem definição de limiar
pai -name confusionmatrix -project algo_public -DinputTableName=wpbc_pred -DoutputTableName=wpbc_confu -DlabelColName=label -DpredictionColName=prediction_result; -
Com limiar definido
pai -name confusionmatrix -project algo_public
    -DinputTableName=wpbc_pred
    -DoutputTableName=wpbc_confu
    -DlabelColName=label
    -DpredictionDetailColName=prediction_detail
    -Dthreshold=0.8
    -DgoodValue=N;
|
Parâmetro |
Obrigatório |
Descrição |
Padrão |
|
inputTableName |
Sim |
Nome da tabela de entrada (tabela de saída de um componente de previsão). |
N/A |
|
inputTablePartition |
Não |
Partição da tabela de entrada. |
Tabela inteira |
|
outputTableName |
Sim |
Nome da tabela de saída para armazenar a matriz de confusão. |
N/A |
|
labelColName |
Sim |
Nome da coluna de rótulo original. |
N/A |
|
predictionColName |
Não |
Nome da coluna de resultado da previsão. Obrigatório se threshold não for especificado. |
N/A |
|
predictionDetailColName |
Não |
Nome da coluna de detalhes do resultado da previsão. Obrigatório se threshold for especificado. |
N/A |
|
threshold |
Não |
Limiar para classificar amostras positivas. |
0,5 |
|
goodValue |
Não |
Valor do rótulo que representa um resultado positivo na classificação binária. Obrigatório se threshold for especificado. |
N/A |
|
coreNum |
Não |
Número de núcleos para processamento. |
Alocação automática |
|
memSizePerCore |
Não |
Memória por núcleo, em MB. |
Alocação automática |
|
lifecycle |
Não |
Ciclo de vida da tabela de saída. |
N/A |
Exemplo
Crie uma tabela chamada test_data com um cliente MaxCompute, contendo as seguintes colunas:
id bigint, label string, prediction_result string. Para instale e configure o cliente MaxCompute, consulte Conectar usando um cliente local (odpscmd). Para crie tabelas, veja Criar uma tabela.-
Importe os dados de exemplo a seguir para a tabela test_data. Para instruções sobre importação de dados, consulte Importar dados.
id
label
prediction_result
0
A
A
1
A
B
2
A
A
3
A
A
4
B
B
5
B
B
6
B
A
7
B
B
8
B
A
9
A
A
-
Crie um pipeline e execute os componentes. Para mais informações, consulte Modelagem de algoritmos.
Na lista de componentes à esquerda do Machine Learning Designer, localize os componentes Read Table e Confusion Matrix e arraste-os para o canvas.
Conecte os componentes para criar o pipeline.
-
Configure os parâmetros dos componentes.
Clique em no componente Read Table-1 no canvas. Na aba Select Table do painel direito, defina Table Name como test_data.
-
Clique em no componente Confusion Matrix-1 no canvas. No painel direito, configure os parâmetros conforme a tabela a seguir. Mantenha os demais parâmetros com os valores padrão.
Parâmetro
Descrição
Original Label Column
Selecione a coluna label.
Prediction Result Label Column
Insira prediction_result.
Após configurar os parâmetros, clique em no botão Run
 para execute o pipeline.
-
Quando a execução terminar, clique com o botão direito no componente Confusion Matrix-1 e selecione Visual Analysis no menu de contexto para visualize a saída.
-
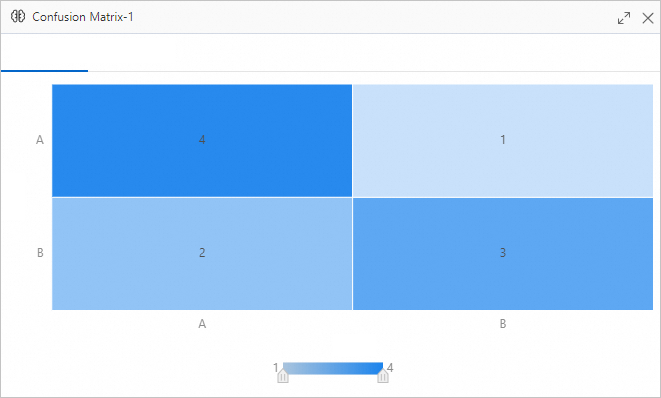
Clique em na aba Confusion Matrix para ver a matriz de confusão resultante.
-
Clique em na aba Statistics para consultar as estatísticas do modelo.
As estatísticas incluem TruePositive, FalsePositive, Accuracy, Precision, Recall e F1 score. Por exemplo, para o Modelo A, os valores das métricas são 4, 2, 0,7, 0,6667, 0,8 e 0,7273. Para o Modelo B, os valores são 3, 1, 0,7, 0,75, 0,6 e 0,6667.
-
Tópicos relacionados
Para obter mais informações sobre os componentes do Machine Learning Designer, consulte Visão geral do Machine Learning Designer.
O Machine Learning Designer oferece diversos componentes de algoritmo. Escolha os componentes adequados para processamento de dados conforme o seu caso de uso. Para mais detalhes, consulte Referência de componentes.