Ao armazenar grandes volumes de dados não estruturados — como imagens e vídeos — no Object Storage Service (OSS), métodos de busca tradicionais baseados em nomes de arquivos ou tags manuais se tornam ineficientes. Esses métodos não conseguem compreender a semântica do conteúdo dos arquivos. O OSS utiliza modelos de IA multimodais para extrair automaticamente descrições semânticas e resumos concisos dos arquivos em um bucket, construindo a partir dessas informações um índice pesquisável. Isso permite buscar o conteúdo dos arquivos diretamente com linguagem natural, incluindo recursos avançados como busca de texto para imagem e busca de texto para vídeo. O resultado é uma melhoria significativa na precisão e na eficiência da recuperação de dados, além de uma base sólida para a construção de aplicações de alto nível, como recuperação com geração aumentada (RAG).
Cenários
Busca inteligente para cenários de câmeras ip (IPC): Em ambientes de segurança inteligente, esse recurso suporta busca semântica para reprodução de vídeo, envio de eventos de monitoramento e recomendações de palavras-chave em tendência nos aplicativos. Por exemplo, quando um usuário final acessa uma reprodução, o sistema pode gerar automaticamente "Palavras-chave em tendência hoje".
Base de conhecimento com recuperação e geração aumentada (RAG): Construa uma base de conhecimento RAG externa aproveitando o grande volume de dados e as capacidades de reconhecimento de conteúdo do OSS. Quando um usuário faz uma pergunta, o recurso de reconhecimento de conteúdo aprimora o processo de recuperação RAG, fornecendo aos modelos de linguagem um contexto mais preciso e relevante para gerar respostas de maior qualidade.
Plataforma de armazenamento e gerenciamento de conhecimento: Construa plataformas de gestão do conhecimento, plataformas de gerenciamento de ativos de mídia e plataformas corporativas de escritório inteligente com base no conteúdo gerado pelo índice de dados e pelo reconhecimento de conteúdo do OSS. Esses recursos extraem cerca de 70 itens de metadados de arquivos multimídia, que podem ser utilizados para criar plataformas de gestão do conhecimento baseadas em cloud.
Como funciona
O núcleo do AI Content Awareness é a busca semântica. Em vez de depender da correspondência tradicional por palavras-chave, o sistema compreende a linguagem natural para associar consultas ao conteúdo multimídia dos arquivos. O processo ocorre da seguinte forma:
Ative o recurso e realize a indexação inicial: Ao ativar esse recurso para um bucket, o sistema dispara uma varredura única dos arquivos existentes e processa de forma assíncrona todos os arquivos suportados no bucket.
Extraia características e gere descrições: O sistema utiliza um modelo de linguagem de grande escala para extrair as principais características semânticas de cada arquivo, gerando dois tipos de texto descritivo com reconhecimento de conteúdo: uma descrição detalhada (cerca de 100 palavras) e um resumo conciso (menos de 20 palavras).
Vetorize e construa o índice: O sistema vetoriza as características semânticas e as descrições geradas pelo reconhecimento de conteúdo dos arquivos, construindo em seguida uma biblioteca de índice vetorial para suportar buscas em larga escala com alto desempenho.
Execute a busca semântica e o reranking: Quando um usuário inicia uma consulta, o sistema vetoriza o termo de busca e recupera os arquivos mais similares no índice vetorial. Em seguida, combina as representações vetoriais e as descrições de reconhecimento de conteúdo para reordenar os resultados, melhorando a precisão e a taxa de recall, identificando com exatidão as informações-chave em grandes conjuntos de dados e viabilizando uma busca semântica aprimorada.
Retorne os resultados para as aplicações: Os resultados da busca incluem as descrições detalhadas e os resumos concisos gerados pelo recurso de reconhecimento de conteúdo. Obtenha diretamente as informações principais e utilize-as para construir aplicações de alto nível, como "Tendências de Busca" ou "Resumo Diário".
A indexação inicial é executada de forma assíncrona. O tempo necessário pode variar de alguns minutos a várias horas, dependendo do número e do tamanho dos arquivos no bucket. Durante esse período, os arquivos existentes não podem ser pesquisados. Para arquivos novos ou atualizados, o sistema dispara automaticamente uma atualização incremental do índice.
Limites
Antes de começar, verifique se o seu bucket está em uma das seguintes regiões com suporte ao AI Content Awareness: China (Beijing), China (Zhangjiakou), China (Hangzhou), China (Shanghai), China (Shenzhen) e China (Chengdu).
1. Crie um bucket e faça upload dos arquivos
Faça login no OSS console.
Na página Buckets, clique em Create Bucket.
Na página Create Bucket, insira um nome de bucket relevante para o seu negócio, como
videos-oss-metaquery. Mantenha os valores padrão para os demais parâmetros.Clique em Create. Na página de confirmação, clique em View Bucket.
Na página Objects, clique em . Selecione os arquivos de vídeo para upload, como VideoA.mp4, VideoB.mp4 e VideoC.mp4. Mantenha os valores padrão para os demais parâmetros e clique em Upload.
2. Ative o AI Content Awareness
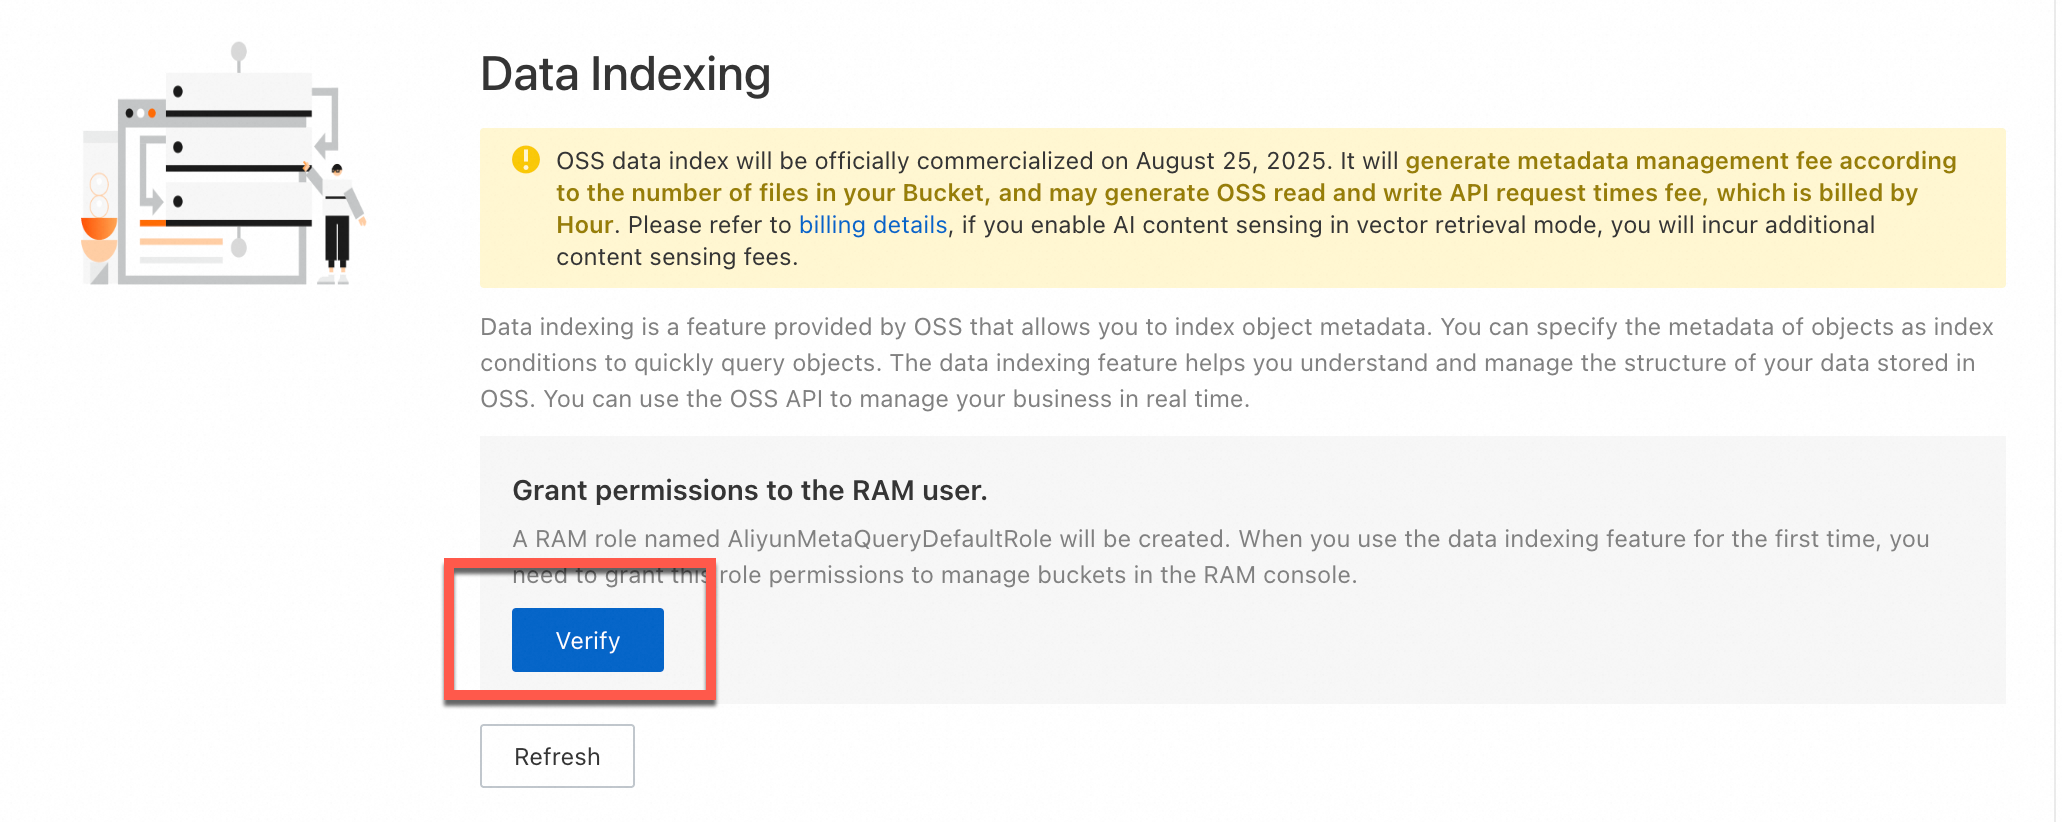
Ative o OSS AI Content Awareness para o seu bucket por meio do recurso Data Index - AISearch. Após a ativação, utilize a API de consulta do Data Index para realizar buscas e consultas semânticas.
Nota Building the metadata index takes some time. The duration depends on the number of objects in the bucket. If it takes too long, you can refresh the page to check the enabling status. |
|

3. Execute uma consulta
Após a construção do índice, realize buscas semânticas pelo console, por um SDK ou pela interface de linha de comando. Insira um texto descritivo, como a yard with a parked car, e o sistema retornará os arquivos correspondentes juntamente com seus resumos de conteúdo. Desenvolva aplicações diretamente com base nessa API ou SDK, sem precisar gerenciar a elasticidade dos recursos subjacentes, o processo de vetorização nem a construção e o armazenamento de índices — o service é completamente serverless.
Console
Na página Buckets, clique no nome do seu bucket.
Na página Objects, confirme que os vídeos foram carregados.
No painel de navegação à esquerda, escolha .
Na página Data Index, insira
a yard with a parked carna caixa de busca. Na seção Media Type, selecioneVideo. Clique em Query Now. A busca retorna os vídeos que correspondem à descrição, juntamente com seus resumos de conteúdo.
SDK
Java
O recurso de busca vetorial está disponível somente no Java SDK 3.18.2 e versões posteriores. Para mais informações, consulte Vector Search (Java SDK V1).
import com.aliyun.oss.*;
import com.aliyun.oss.common.auth.CredentialsProviderFactory;
import com.aliyun.oss.common.auth.EnvironmentVariableCredentialsProvider;
import com.aliyun.oss.common.comm.SignVersion;
import com.aliyun.oss.model.*;
import java.util.ArrayList;
import java.util.List;

public class DoMetaQuery {
    public static void main(String[] args) throws Exception {
        // The endpoint is set to China (Hangzhou) in this example. Replace it with the actual endpoint.
        String endpoint = "https://oss-cn-hangzhou.aliyuncs.com";
        // Specify the bucket name, for example, examplebucket.
        String bucketName = "examplebucket";
        // Obtain access credentials from environment variables. Before you run this sample code, make sure that the OSS_ACCESS_KEY_ID and OSS_ACCESS_KEY_SECRET environment variables are set.
        EnvironmentVariableCredentialsProvider credentialsProvider = CredentialsProviderFactory.newEnvironmentVariableCredentialsProvider();
        // Specify the region where the bucket is located. This example uses cn-hangzhou, which indicates the China (Hangzhou) region.
        String region = "cn-hangzhou";

        // Create an OSSClient instance.
        // When the OSSClient instance is no longer needed, call the shutdown method to release its resources.
        ClientBuilderConfiguration clientBuilderConfiguration = new ClientBuilderConfiguration();
        clientBuilderConfiguration.setSignatureVersion(SignVersion.V4);
        OSS ossClient = OSSClientBuilder.create()
                .endpoint(endpoint)
                .credentialsProvider(credentialsProvider)
                .clientConfiguration(clientBuilderConfiguration)
                .region(region)
                .build();

        try {
            int maxResults = 20;
            List<String> mediaTypes = new ArrayList<String>();
            mediaTypes.add("image");
            String query = "Snow";
            String simpleQuery = "{\"Operation\":\"gt\", \"Field\": \"Size\", \"Value\": \"30\"}";
            String sort = "Size";
            DoMetaQueryRequest doMetaQueryRequest = new DoMetaQueryRequest(bucketName, maxResults, query, sort, MetaQueryMode.SEMANTIC, mediaTypes, simpleQuery);
            DoMetaQueryResult doMetaQueryResult = ossClient.doMetaQuery(doMetaQueryRequest);
        } catch (OSSException oe) {
            System.out.println("Error Message: " + oe.getErrorMessage());
            System.out.println("Error Code:       " + oe.getErrorCode());
            System.out.println("Request ID:      " + oe.getRequestId());
            System.out.println("Host ID:           " + oe.getHostId());
        } catch (ClientException ce) {
            System.out.println("Error Message: " + ce.getMessage());
        } finally {
            if(ossClient != null){
                ossClient.shutdown();
            }
        }
    }
}
Python
Para mais informações, consulte AISearch.
import argparse
import alibabacloud_oss_v2 as oss

# Create a command-line argument parser to process command-line input.
parser = argparse.ArgumentParser(description="do meta query semantic sample")
# Add the necessary command-line arguments.
parser.add_argument('--region', help='The region in which the bucket is located.', required=True)  # The region where the bucket is located.
parser.add_argument('--bucket', help='The name of the bucket.', required=True)  # The name of the bucket.
parser.add_argument('--endpoint', help='The domain names that other services can use to access OSS')  # The OSS domain name, which is optional.

def main():
    # Parse command-line arguments.
    args = parser.parse_args()

    # Load access credentials from environment variables.
    # Before running, you need to set the environment variables: OSS_ACCESS_KEY_ID and OSS_ACCESS_KEY_SECRET.
    credentials_provider = oss.credentials.EnvironmentVariableCredentialsProvider()

    # Load the default SDK configurations.
    cfg = oss.config.load_default()
    # Set the credential provider.
    cfg.credentials_provider = credentials_provider
    # Set the region.
    cfg.region = args.region
    # If an endpoint is provided, update the endpoint in the configuration.
    if args.endpoint is not None:
        cfg.endpoint = args.endpoint

    # Create an OSS client instance.
    client = oss.Client(cfg)

    # Initiate a metadata query request in AISearch mode.
    result = client.do_meta_query(oss.DoMetaQueryRequest(
            bucket=args.bucket,
            mode='semantic',
            meta_query=oss.MetaQuery(
                max_results=1000,
                query='An aerial view of a snow-covered forest',
                order='desc',
                media_types=oss.MetaQueryMediaTypes(
                    media_type=['image']
                ),
                simple_query='{"Operation":"gt", "Field": "Size", "Value": "30"}',
            ),
    ))

    # Print the retrieval results.
    print(vars(result))

if __name__ == "__main__":
    main()
Go
Para mais informações, consulte AISearch (Go SDK V2).
package main
import (
"context"
"flag"
"log"
"github.com/aliyun/alibabacloud-oss-go-sdk-v2/oss"
"github.com/aliyun/alibabacloud-oss-go-sdk-v2/oss/credentials"
)
var (
region string
bucketName string
)
func init() {
// Set a command-line flag to specify the region.
flag.StringVar(®ion, "region", "", "The region in which the bucket is located.")
// Set a command-line flag to specify the bucket name.
flag.StringVar(&bucketName, "bucket", "", "The name of the bucket.")
}
func main() {
flag.Parse()
// Check if the bucket name is provided.
if len(bucketName) == 0 {
flag.PrintDefaults()
log.Fatalf("invalid parameters, bucket name required")
}
// Check if the region is provided.
if len(region) == 0 {
flag.PrintDefaults()
log.Fatalf("invalid parameters, region required")
}
// Create a client configuration and use credentials from environment variables and the specified region.
cfg := oss.LoadDefaultConfig().
WithCredentialsProvider(credentials.NewEnvironmentVariableCredentialsProvider()).
WithRegion(region)
client := oss.NewClient(cfg) // Create an OSS client.
// Perform an AISearch operation.
request := &oss.DoMetaQueryRequest{
Bucket: oss.Ptr(bucketName),
Mode: oss.Ptr("semantic"),
MetaQuery: &oss.MetaQuery{
MaxResults: oss.Ptr(int64(99)),
Query: oss.Ptr(`{"Operation":"match","Field":"Filename","Value":"snow"}`), // The Query parameter must be in JSON format (for example, {"Operation":"match","Field":"Filename","Value":"snow"}).
MediaTypes: &oss.MetaQueryMediaTypes{
MediaTypes: []string{"image"}, // Specify the media types to search. In this example, "image".
},
SimpleQuery: oss.Ptr(`{"Operation":"gt", "Field": "Size", "Value": "30"}`),
},
}
result, err := client.DoMetaQuery(context.TODO(), request)
if err != nil {
log.Fatalf("failed to do meta query %v", err)
}
log.Printf("do meta query result:%#v\n", result)
}
PHP
Para mais informações, consulte AISearch (PHP SDK V2).
<?php

// Import the autoloader file to ensure that dependency libraries are correctly loaded.
require_once __DIR__ . '/../vendor/autoload.php';

use AlibabaCloud\Oss\V2 as Oss;

// Define the description of command line arguments.
$optsdesc = [
    "region" => ['help' => 'The region in which the bucket is located.', 'required' => True], // The region where the bucket is located. This parameter is required.
    "endpoint" => ['help' => 'The domain names that other services can use to access OSS.', 'required' => False], // The endpoint that other services can use to access OSS. This parameter is optional.
    "bucket" => ['help' => 'The name of the bucket', 'required' => True], // The name of the bucket. This parameter is required.
];

// Convert the argument description to the long option format required by getopt.
// A colon (:) after each argument indicates that the argument requires a value.
$longopts = \array_map(function ($key) {
    return "$key:";
}, array_keys($optsdesc));

// Parse the command line arguments.
$options = getopt("", $longopts);

// Check whether required arguments are specified.
foreach ($optsdesc as $key => $value) {
    if ($value['required'] === True && empty($options[$key])) {
        $help = $value['help']; // Obtain the help information of the argument.
        echo "Error: the following arguments are required: --$key, $help" . PHP_EOL;
        exit(1); // If a required argument is not specified, exit the program.
    }
}

// Extract values from the parsed arguments.
$region = $options["region"]; // The region where the bucket is located.
$bucket = $options["bucket"]; // The name of the bucket.

// Load the credential information from environment variables.
// Use EnvironmentVariableCredentialsProvider to read the Access Key ID and Access Key Secret from environment variables.
$credentialsProvider = new Oss\Credentials\EnvironmentVariableCredentialsProvider();

// Use the default configurations of the SDK.
$cfg = Oss\Config::loadDefault();
$cfg->setCredentialsProvider($credentialsProvider); // Set the credential provider.
$cfg->setRegion($region); // Set the region where the bucket is located.
if (isset($options["endpoint"])) {
    $cfg->setEndpoint($options["endpoint"]); // If an endpoint is provided, set the endpoint.
}

// Create an OSS client instance.
$client = new Oss\Client($cfg);

// Perform an AISearch query for objects that meet the specified conditions.
$request = new Oss\Models\DoMetaQueryRequest($bucket, new Oss\Models\MetaQuery(
    maxResults: 99,
    query: "Overlook the snow-covered forest",
    mediaTypes: new Oss\Models\MetaQueryMediaTypes('image'),
    simpleQuery: '{"Operation":"gt", "Field": "Size", "Value": "30"}',
), 'semantic');

$result = $client->doMetaQuery($request);
printf(
    'status code:' . $result->statusCode . PHP_EOL .
    'request id:' . $result->requestId . PHP_EOL .
    'result:' . var_export($result, true)
);
ossutil
O exemplo a seguir demonstra como consultar arquivos que atendem a condições específicas no bucket examplebucket.
ossutil api do-meta-query --bucket examplebucket --meta-query "{\"Query\":\"Overlooking the snow covered forest\",\"MediaTypes\":{\"MediaType\":\"video\"},\"SimpleQuery\":\"{\\\"Operation\\\":\\\"gt\\\", \\\"Field\\\": \\\"Size\\\", \\\"Value\\\": \\\"1\\\"}\"}" --meta-query-mode semanticPara mais informações sobre esse comando, consulte do-meta-query.
Faturamento
O uso do recurso AI Content Awareness gera as seguintes cobranças:
Data indexing fees: É necessário ativar o AI Content Awareness no modo Data Index - AISearch, o que gera taxas relacionadas ao Data Index - AISearch.
AI Content Awareness fees: Essas taxas incluem cobranças pelo reconhecimento de conteúdo de imagens e vídeos, calculadas com base no tipo e no volume de arquivos processados. Após a ativação do AI Content Awareness, o OSS verifica automaticamente os arquivos de imagem e vídeo existentes no bucket. Novos arquivos de imagem ou vídeo carregados também acionam o AI Content Awareness automaticamente e geram as respectivas cobranças. Monitore suas faturas com atenção.
-
API request fees: As taxas de requisição de API são geradas durante a indexação dos arquivos existentes e a atualização dos índices para arquivos incrementais, cobradas com base no número de chamadas de API. As operações de API envolvidas são as seguintes:
Operação
API
Varrer arquivos em um bucket
ListObjects
Construir um índice para arquivos em um bucket
HeadObject e GetObject
O arquivo no bucket possui uma tag
GetObjectTag
O arquivo no bucket possui metadados personalizados
GetObjectMeta
O bucket contém um arquivo de link simbólico
GetSymlink
Para interromper as cobranças relacionadas, disable AISearch imediatamente.
APIs relacionadas
O recurso AI Content Awareness é implementado com base nas seguintes APIs RESTful. Caso sua aplicação tenha requisitos elevados de personalização, chame essas APIs diretamente para o desenvolvimento. No entanto, o cálculo de assinatura deve ser implementado manualmente.
Para mais informações sobre como ativar o recurso de gerenciamento de metadados, consulte OpenMetaQuery.
Para mais informações sobre como consultar o status atual do gerenciamento de metadados, consulte GetMetaQueryStatus.
Para mais informações sobre como consultar arquivos que atendem a condições específicas, consulte DoMetaQuery.
Para mais informações sobre como desativar o recurso de gerenciamento de metadados, consulte CloseMetaQuery.