Introdução à Vector Search Edition
A OpenSearch Vector Search Edition é um mecanismo de busca distribuído de grande escala desenvolvido pela Alibaba. Ela oferece funcionalidade de busca em todo o ecossistema do Alibaba Group, incluindo Taobao, Tmall, Cainiao, Youku e operações de comércio eletrônico internacionais, além da Alibaba Cloud OpenSearch. Ao longo de anos de evolução, a plataforma atendeu a requisitos rigorosos de alta disponibilidade, desempenho em tempo real e baixo custo, e conta com um sistema automatizado de O&M que simplifica a construção de um search service para a sua operação.
Arquitetura
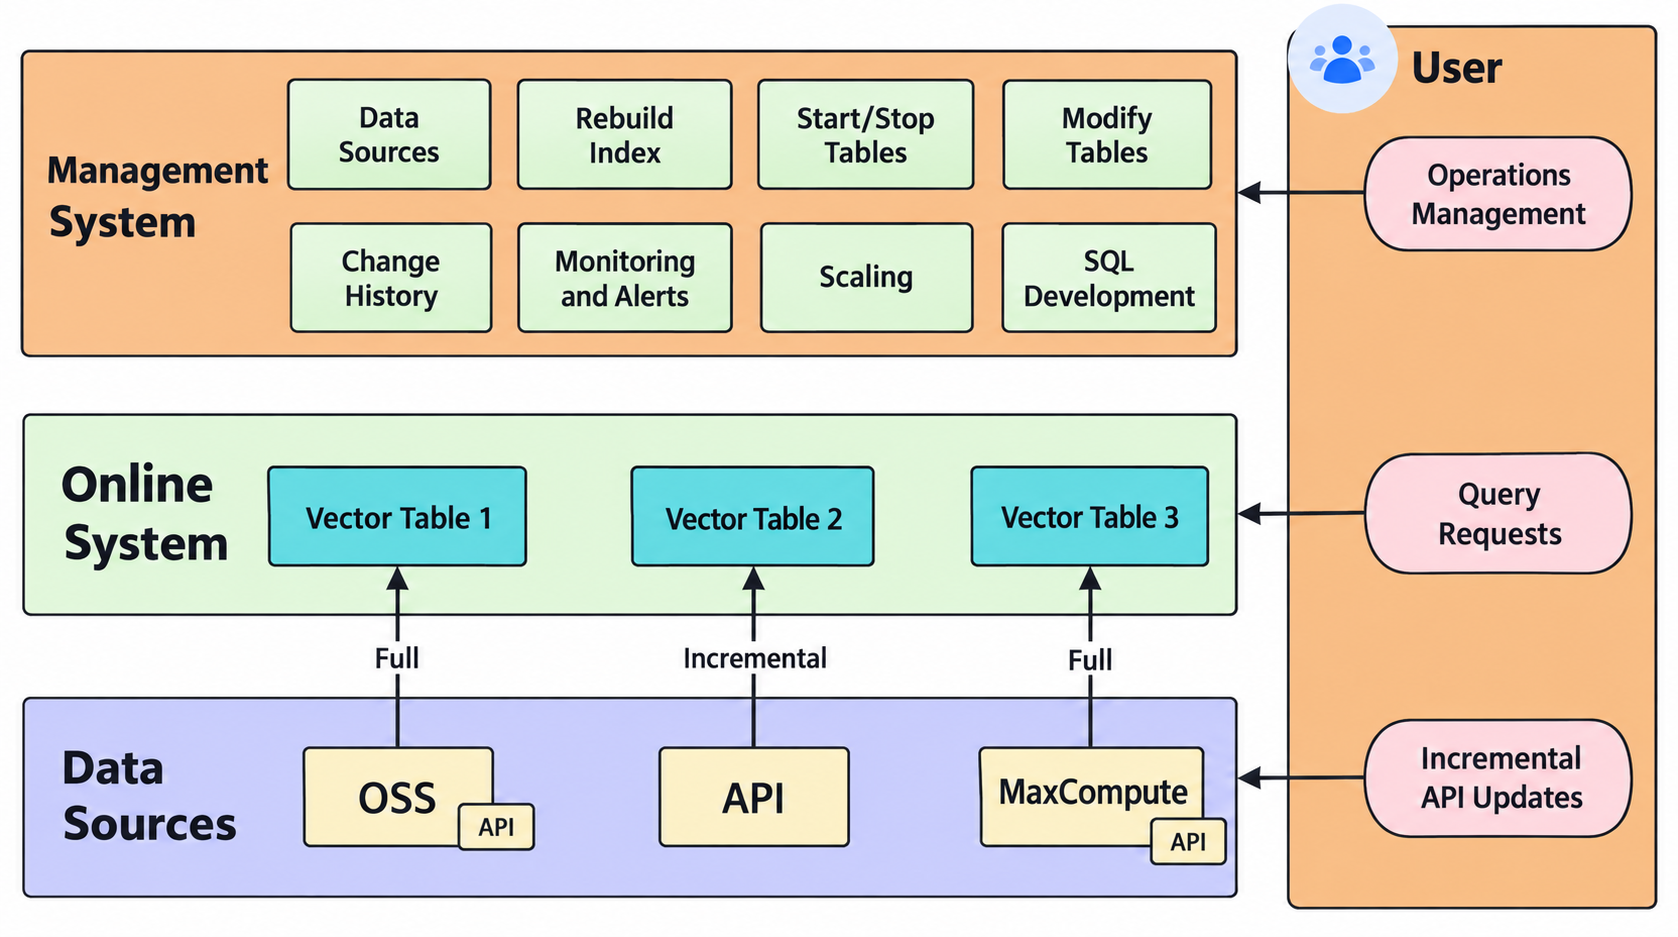
A OpenSearch Vector Search Edition é composta por três componentes principais: um sistema de gerenciamento, um sistema online e fontes de dados. O sistema online carrega os índices e disponibiliza a busca vetorial. As fontes de dados permitem configure importações completas de dados e dão suporte a gravações em tempo real. O sistema de gerenciamento automatiza o O&M para criação e gestão de cluster.
Arquitetura do sistema
Sistema de busca online
Na perspectiva do usuário, o sistema online é organizado por tabela. É possível consultar cada tabela vetorial de forma independente por meio de API e gerencie seus campos, índices vetoriais, data source e simultaneidade de dados em tempo real.
O sistema online de backend utiliza uma arquitetura distribuída de nós de consulta e nós de dados organizados em múltiplas linhas e colunas:
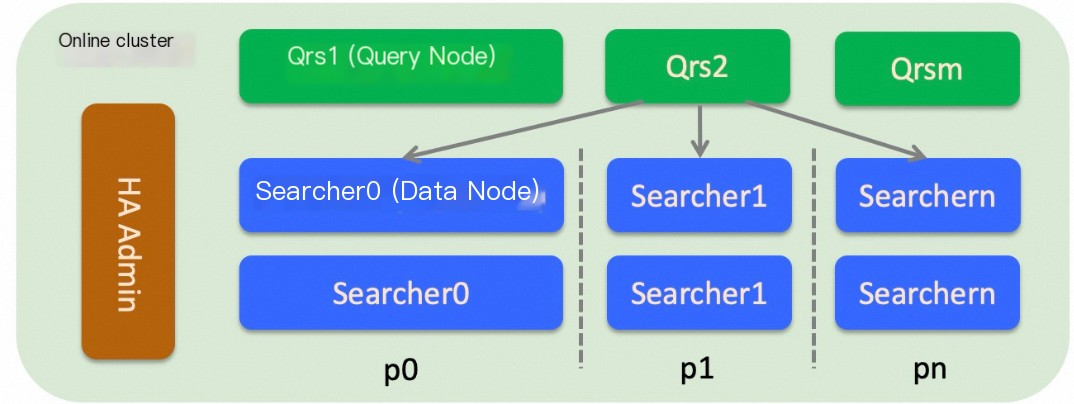
Os nós de consulta analisam, validam ou reescrevem as consultas recebidas e encaminham as solicitações processadas aos nós de dados. Eles coletam e mesclam os resultados, aplicam o tratamento final e retornam a resposta ao usuário. Um nó de consulta é orientado a computação e não carrega dados do cliente. Seus requisitos de memória costumam ser baixos, mas aumentam quando muitos documentos ou entradas estatísticas são retornados. Caso a capacidade do nó de consulta se torne um gargalo, adicione réplicas do nó ou atualize as especificações.
Os nós de dados carregam os dados do índice e realizam a recuperação, filtragem, agregação e classificação de documentos. O índice em um nó de dados pode ser fragmentado. Os valores do campo de fragmentação passam por hash para o intervalo [0,65535], que é dividido pela quantidade de shards definida na criação do índice. A fragmentação melhora o desempenho de solicitações individuais para conjuntos de dados extensos ou consultas complexas. Para elevar a capacidade total do cluster, por exemplo, de 1000 QPS para 10000 QPS, inclua réplicas. Adicionar uma réplica significa provisionar os múltiplos nós Searcher que, em conjunto, armazenam todos os dados, em vez de incluir apenas um único nó Searcher. Os shards precisam cobrir integralmente o intervalo [0,65535].
As tabelas compartilham os recursos dos nós de dados, incluindo CPU, memória e disco:
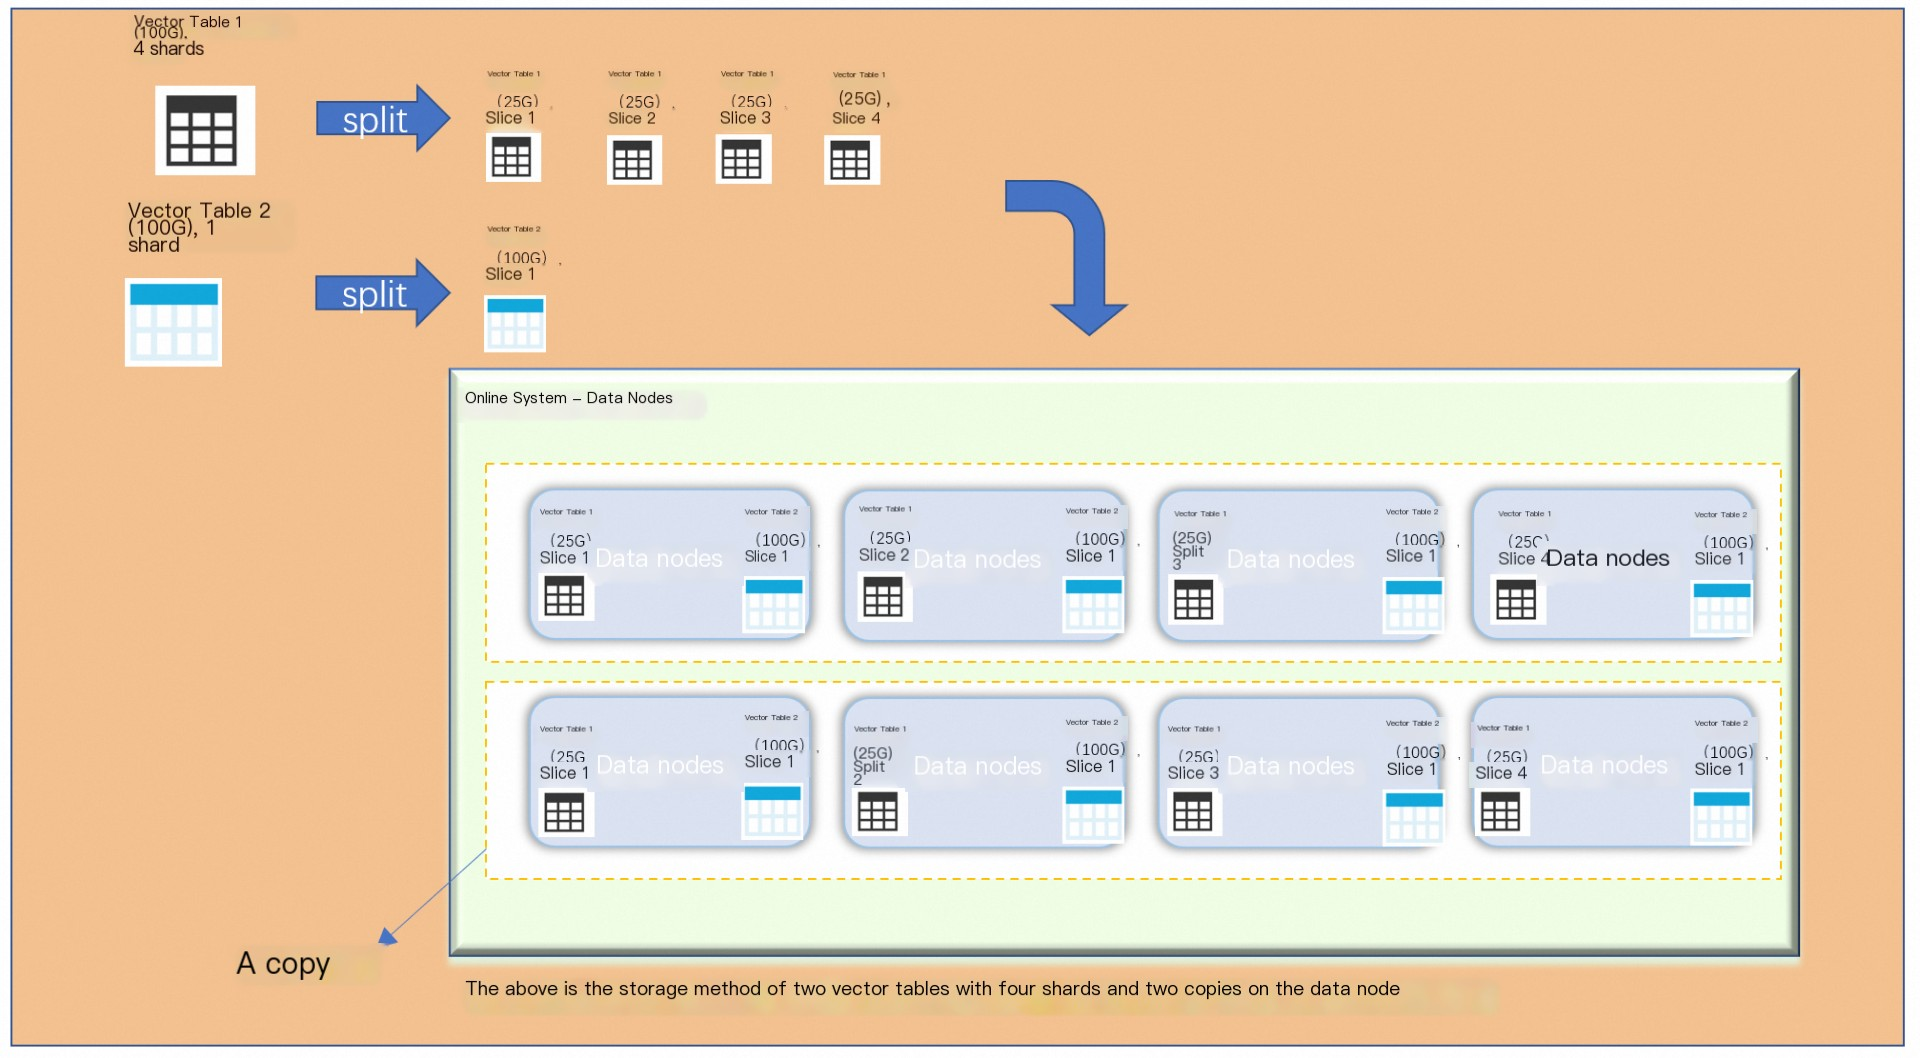
A figura anterior apresenta duas tabelas vetoriais: uma com quatro shards e outra com um shard. A tabela de quatro shards distribui os dados do índice uniformemente entre as partições. A tabela de um shard opera como tabela de broadcast, mantendo uma cópia completa da tabela vetorial 2 em cada nó de dados.
Fontes de dados
configure uma fonte de dados para reconstruir um índice a partir dos dados brutos completos e importar o índice gerado para uma tabela online para consulta. As fontes de dados e as tabelas mantêm uma relação de um para um. Os source compatíveis são MaxCompute, Saro e API. Uma fonte de dados via API inicia vazia, sendo necessário enviar todos os registros para a tabela online por meio de chamadas de API.
Sistema de gerenciamento
O sistema de gerenciamento atua como a plataforma de O&M para uma instância da OpenSearch Vector Search Edition e reduz significativamente os custos operacionais.
Sincronização de dados
Indexação completa
A OpenSearch Vector Search Edition oferece suporte a múltiplas versões de índice. Cada versão é construída a partir de uma cópia dos dados brutos; as fontes de dados via API iniciam vazias por padrão. A reconstrução de um índice aciona o processo de indexação completa. Trata-se de uma tarefa não residente, que é encerrada assim que o processamento gera o índice completo. O índice resultante é então ativado no cluster online para atender às consultas.
O uso de múltiplas versões de índice aumenta a estabilidade durante alterações de dados. Ao modificar o esquema do índice ou a estrutura dos dados, um novo índice completo é construído de forma isolada em relação à versão anterior. Caso uma modificação gere problemas, você pode reverter a operação.
A indexação completa abrange processamento de dados, construção de índice e fusão de índices. configure a simultaneidade em cada etapa para acelerar a geração do índice completo.
Indexação incremental em tempo real
Após a geração do índice completo, cada versão completa mantém um processo residente de indexação incremental. A sincronização incremental é executada pelos nós de atualização de dados.
As fontes do MaxCompute, OSS e API enviam dados incrementais em tempo real para as tabelas por meio de chamadas de API. Os nós de atualização de dados consomem as informações incrementais, enquanto os nós de dados constroem os índices em tempo real para as consultas.
A indexação incremental opera como um processo residente. Cada versão completa de cada tabela possui seu próprio processo incremental. Aumente a quantidade de nós de atualização de dados para elevar a capacidade de processamento em tempo real.
Recursos da Vector Search Edition
Estabilidade
A Vector Search Edition é desenvolvida em C++. Há mais de dez anos, ela sustenta negócios críticos e é altamente indicada para cenários de busca principais que demandam estabilidade elevada.
Eficiência
A OpenSearch Vector Search Edition é um mecanismo de busca distribuído que recupera grandes conjuntos de dados com alta eficiência e dá suporte a update em tempo real, com aplicação em questão de segundos. É a escolha ideal para cenários que exigem baixa latência de consulta e dados sempre atualizados.
Baixo custo
A OpenSearch Vector Search Edition conta com diversas políticas de compressão de índice e testes de carregamento de índices multivalorados, permitindo atender aos requisitos de busca com custos reduzidos.