Introdução ao OpenSearch Vector Search Edition
O OpenSearch Vector Search Edition é um mecanismo de busca distribuído de grande escala desenvolvido internamente pela Alibaba. Ele oferece suporte aos services de busca de todo o Alibaba Group, incluindo Taobao, Tmall, Cainiao, Youku e negócios de e-commerce no exterior, além de impulsionar os services do OpenSearch na Alibaba Cloud. Ao longo de anos de desenvolvimento, o OpenSearch Vector Search Edition atendeu aos requisitos de negócios para alta disponibilidade, alta tempestividade e baixo custo. Esse histórico também resultou em um sistema automatizado de O&M que permite aos usuários criar facilmente seus próprios services de busca com base nas características de seus negócios.
Arquitetura do OpenSearch Vector Search Edition

O OpenSearch Vector Search Edition é composto por três partes: o sistema de gerenciamento e controle, o sistema online e as sources de dados. O sistema online carrega índices e fornece services de recuperação de vetores. As sources de dados são usadas para configurar o ponto de entrada para a importação de dados completos, além de oferecer suporte a gravações de dados em tempo real. O sistema de gerenciamento e controle fornece services automatizados de O&M. Com ele, crie clusters facilmente e execute diversas operações de O&M.
Arquitetura do sistema
Sistema online
Na perspectiva do usuário, o sistema online é dividido por tabela. Consulte os dados de cada tabela de vetores separadamente por meio de APIs e gerencie cada tabela de forma independente. Para isso, configure campos de tabela, configure índices de vetores, configure sources de dados e controle a simultaneidade de dados em tempo real de cada tabela.
No backend, o sistema online utiliza uma arquitetura distribuída com várias linhas e colunas, composta por nós de consulta e nós de dados:
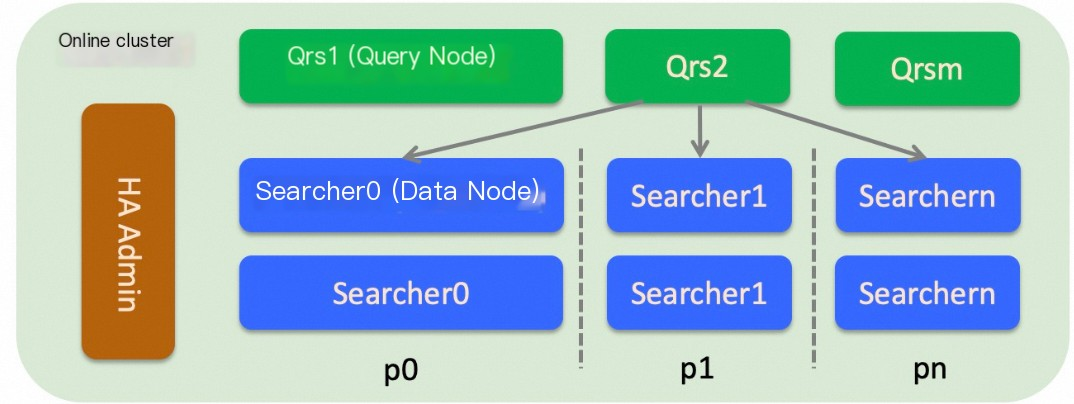
Nós de consulta: um nó de consulta analisa, valida ou reescreve as solicitações de consulta recebidas, encaminha as solicitações analisadas para os nós de dados para execução, coleta e mescla os resultados retornados pelos nós de dados e devolve os resultados processados ao usuário. Os nós de consulta são nós de computação que não carregam dados do usuário e, geralmente, não exigem muita memória. No entanto, eles consomem uma grande quantidade de memória quando um grande número de documentos é retornado ou quando as estatísticas geram um grande número de entradas. Se a capacidade de processamento dos nós de consulta atingir um gargalo, aumente o número de réplicas de nós de consulta ou atualize as especificações do nó de consulta.
Nós de dados: um nó de dados carrega os dados de índice do usuário e, com base nas consultas, recupera documentos e executa operações como filtragem, estatísticas e classificação. Os índices nos nós de dados podem ser divididos em shards. O sharding consiste em aplicar hash ao campo de sharding no intervalo [0,65535] e dividir esse intervalo em um número especificado de shards (especificado quando o índice é criado). Para clusters com grandes volumes de dados ou altos requisitos de desempenho de consulta, o sharding pode melhorar o desempenho de processamento de uma única solicitação. Para melhorar a capacidade de processamento de todo o cluster (por exemplo, de 1.000 QPS para 10.000 QPS), adicione réplicas. Adicionar uma réplica não significa adicionar apenas um nó Searcher, mas sim adicionar vários nós Searcher que, juntos, armazenam todos os dados (os shards devem cobrir juntos o intervalo completo [0,65535]).
As tabelas compartilham recursos de nós de dados (CPU, memória e disco):
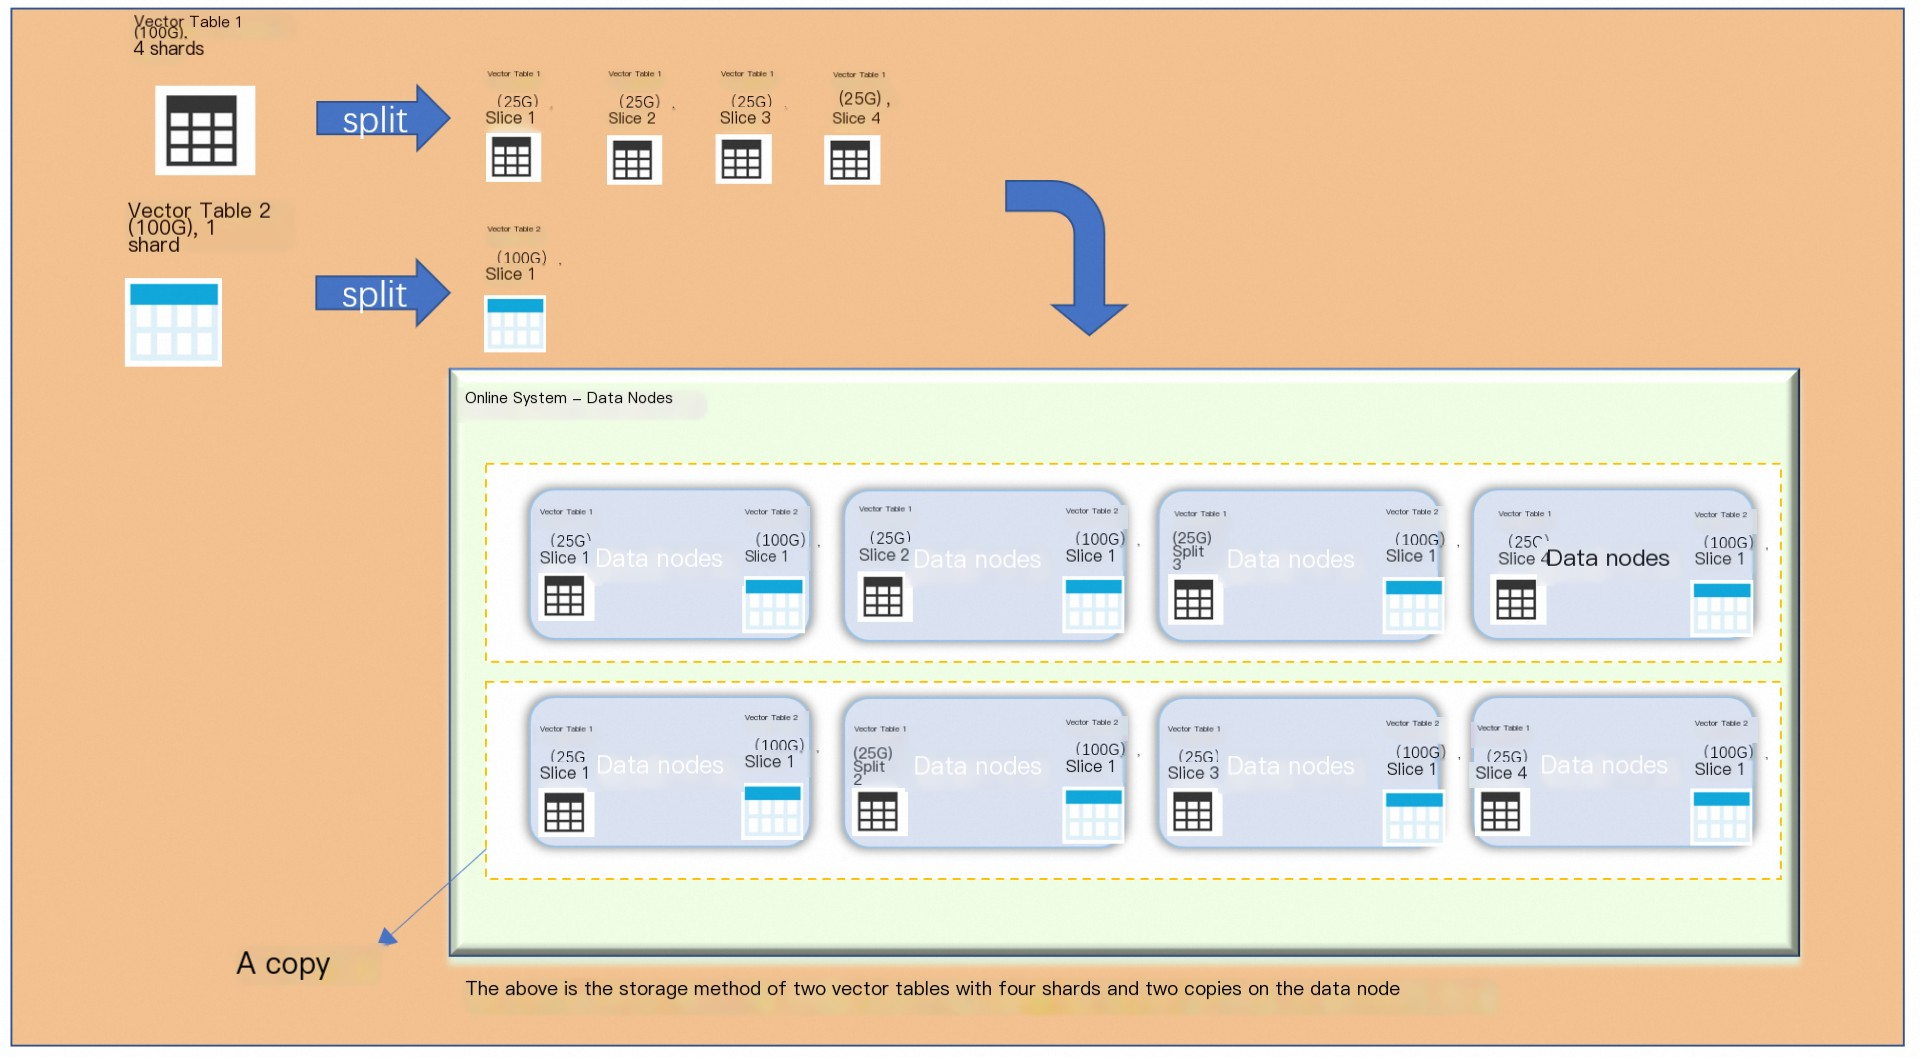
A figura anterior mostra duas tabelas de vetores, uma com 4 shards e outra com 1 shard. Para a tabela de 4 shards, os dados são distribuídos uniformemente para cada shard com base no índice gerado. A tabela de vetores de 1 shard se torna uma tabela de broadcast, e cada nó de dados armazena uma cópia completa dos dados de índice da tabela de vetores 2.
Sources de dados
Ao configurar uma source de dados, é possível reconstruir índices (dados completos) a partir de dados brutos e importar os dados de índice reconstruídos para tabelas no sistema online para recuperação de dados. As sources de dados e as tabelas possuem uma relação de um para um. Atualmente, o sistema oferece suporte às seguintes sources de dados: MaxCompute, Saro e API. A API é uma source de dados vazia, e todos os dados devem ser enviados pelos usuários para as tabelas no sistema online por meio de APIs.
Sistema de gerenciamento e controle
O sistema de gerenciamento e controle é a plataforma de O&M para uma instância do OpenSearch Vector Search Edition. Essa plataforma reduz significativamente os custos de O&M.
Processo de sincronização de dados
Processo de dados completos
O OpenSearch Vector Search Edition oferece suporte a várias versões de índice. Cada versão de índice é criada com base em uma cópia de dados brutos (a source de dados de API não contém dados por padrão). Cada reconstrução de índice acionada é um processo de dados completos. O processo de dados completos é uma tarefa não residente: após a conclusão do processamento de dados, um índice completo é gerado e o processo de dados completos é encerrado. O índice completo gerado é então alternado para o cluster online por meio de um switchover completo para fornecer services de recuperação.
O suporte a várias versões de índice garante a estabilidade das alterações de dados. Quando o esquema do índice ou a estrutura de dados muda, o novo índice gerado por meio do processo de dados completos fica completamente isolado do índice da versão anterior. Se uma alteração causar problemas, faça a reversão prontamente.
A geração de um índice completo envolve processos como processamento de dados, criação de índice e mesclagem de índice. Em cada etapa, defina a simultaneidade do processamento de índice para acelerar a geração do índice completo.
Processo incremental em tempo real
Após a geração de um índice completo, cada versão completa possui um processo incremental residente, e a sincronização de dados incrementais é executada pelos nós de atualização de dados.
As sources de dados MaxCompute, OSS e API enviam dados incrementais em tempo real por meio de APIs. Os dados incrementais são enviados para as tabelas por meio de APIs, consumidos pelos nós de atualização de dados e, finalmente, indexados em tempo real pelos nós de dados para as consultas dos usuários.
O processo incremental é uma tarefa residente. Cada versão completa de cada tabela corresponde a um processo incremental. Controle o número de nós de atualização de dados para melhorar a capacidade de processamento de dados em tempo real.
Recursos do OpenSearch Vector Search Edition
Estável
A camada subjacente do OpenSearch Vector Search Edition é implementada em C++. Com mais de dez anos de desenvolvimento, ele ofereceu suporte a vários negócios principais e é muito estável, sendo ideal para cenários de busca principais que exigem alta estabilidade.
Eficiente
O OpenSearch Vector Search Edition é um mecanismo de busca distribuído que oferece suporte eficiente à recuperação de grandes quantidades de dados e também oferece suporte a atualizações de dados em tempo real (com efeitos em segundos). É ideal para cenários de busca sensíveis à latência de consulta e que exigem alta tempestividade.
Baixo custo
O OpenSearch Vector Search Edition oferece suporte a várias políticas de compactação de índice, bem como a testes de carregamento de índice de múltiplos valores, e pode atender aos requisitos de consulta dos usuários a um custo relativamente baixo.