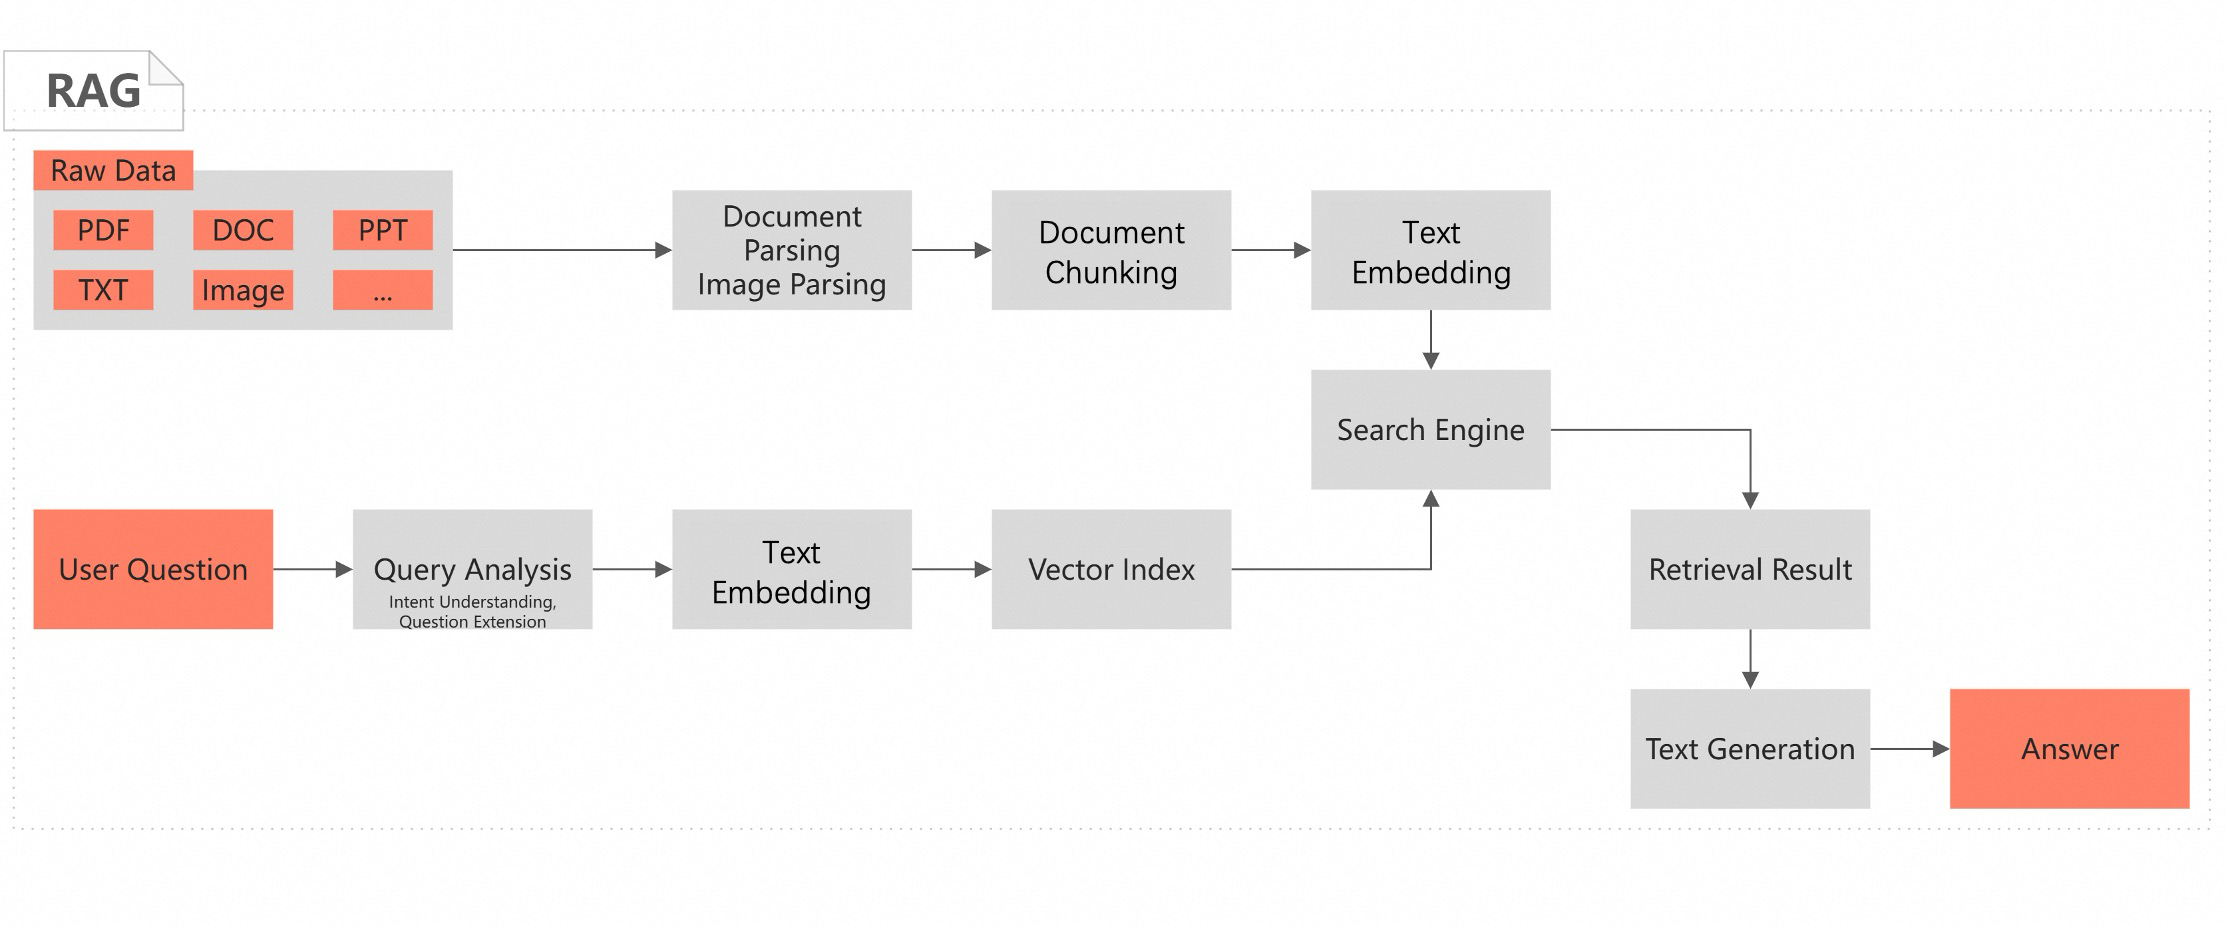
Para cenários de perguntas e respostas com base de conhecimento online, o OpenSearch LLM-Based Conversational Search (AI Search Open Platform) oferece uma solução completa para construir um pipeline de desenvolvimento de geração aumentada por recuperação (RAG). Esse pipeline é composto por três módulos: pré-processamento de dados, service de recuperação e geração de resumos de perguntas e respostas. A AI Search Open Platform disponibiliza os serviços de algoritmos de cada módulo como componentes. Selecione flexivelmente os serviços utilizados em cada módulo, como análise de documentos, classificação e resumo de perguntas e respostas, e gere código de desenvolvimento rapidamente. A AI Search Open Platform expõe seus serviços como APIs. Baixe o código para seu ambiente local e substitua a API_KEY, o endpoint da API, a base de conhecimento local e outras informações seguindo as etapas deste tópico. Assim, você constrói rapidamente uma aplicação de perguntas e respostas com base de conhecimento baseada no pipeline de desenvolvimento RAG.
Como funciona
A Geração Aumentada por Recuperação (RAG) é um método de IA que combina tecnologias de recuperação e geração para melhorar a relevância, a precisão e a diversidade do conteúdo gerado por um modelo. Ao processar uma tarefa de geração, o RAG recupera primeiro os segmentos mais relevantes para a entrada a partir de um grande volume de dados externos ou de uma base de conhecimento. Em seguida, o RAG envia as informações recuperadas, juntamente com a entrada original, para um modelo de linguagem grande (LLM) como prompt ou contexto, orientando o modelo a gerar uma resposta mais precisa e abrangente. Esse método permite que o modelo não dependa apenas de seus parâmetros internos e dados de treinamento ao gerar respostas, mas também utilize informações externas atualizadas ou específicas do domínio para aumentar a precisão das respostas.
Cenários
O sistema de perguntas e respostas com base de conhecimento online é comum em cenários de negócios como recuperação e sumarização de bases de conhecimento corporativas internas e atendimento online em domínios verticais. Com base nos documentos profissionais da base de conhecimento do cliente, as tecnologias RAG e LLM compreendem e respondem a consultas complexas em linguagem natural. Isso ajuda os clientes empresariais a usar linguagem natural para recuperar rapidamente as informações necessárias em documentos PDF, Word, planilhas e imagens.
Na interface conversacional de perguntas e respostas, após o usuário enviar uma pergunta em linguagem natural, o sistema retorna uma resposta em formato de etapas estruturadas e fornece perguntas recomendadas abaixo da resposta para exploração adicional.
Pré-requisitos
A AI Search Open Platform está ativada. Para mais informações, consulte Activate the service.
-
Obtenha o endpoint do service e as informações de autenticação de identidade. Para mais informações, consulte Obtain a service endpoint e Obtain an API key.
A AI Search Open Platform permite chamar serviços pela Internet ou usando um endpoint de virtual private cloud (VPC), além de suportar chamadas de service entre regiões via VPCs. Atualmente, usuários nas regiões China (Shanghai), China (Hangzhou), China (Shenzhen), China (Beijing), China (Zhangjiakou) e China (Qingdao) podem chamar os serviços da AI Search Open Platform usando endpoints VPC.
Na página API Keys, a seguinte mensagem aparece na parte superior: "API keys are used for service invocation permissions. Keep them secure. If an API key is leaked, disable it immediately. Up to 10 API keys can be enabled at the same time." A seção Access Domain exibe o Public API Domain e o Private API Domain. Ambos suportam acesso HTTPS.
Crie uma instância do Alibaba Cloud Elasticsearch (ES) versão 8,5 ou posterior. Para mais informações, consulte Create an Alibaba Cloud Elasticsearch cluster. Para acessar uma instância do Alibaba Cloud ES pela Internet ou por uma rede interna, adicione o endereço IP do dispositivo que acessa a instância à lista de permissões de acesso da instância. Para mais informações, consulte Manage IP address whitelists.
Instale o Python 3.7 ou posterior e importe as dependências de pacotes Python aiohttp 3.8.6 e elasticsearch 8.14 para o ambiente de desenvolvimento.
Construa um pipeline de desenvolvimento RAG
Para facilitar o uso, a AI Search Open Platform oferece quatro tipos de frameworks de desenvolvimento:
Java SDK.
Python SDK.
Caso seu negócio já utilize o framework de desenvolvimento LangChain, selecione LangChain como framework de desenvolvimento.
Se o seu negócio já utiliza o framework de desenvolvimento LlamaIndex, selecione LlamaIndex como framework de desenvolvimento.
Etapa 1: Selecione os serviços e baixe o código
Selecione os serviços de algoritmo e o framework de desenvolvimento para usar no pipeline RAG com base na sua base de conhecimento e nos requisitos de negócios. Este tópico usa o framework de desenvolvimento Python SDK como exemplo para descrever como construir um pipeline RAG.
Faça login no console da AI Search Open Platform.
-
Selecione a região China (Shanghai), mude para AI Search Open Platform e alterne para o workspace desejado.
NotaA AI Search Open Platform está disponível apenas nas regiões China (Shanghai) e Germany (Frankfurt).
Usuários nas regiões China (Hangzhou), China (Shenzhen), China (Beijing), China (Zhangjiakou) e China (Qingdao) podem usar um endpoint VPC para chamar serviços da AI Search Open Platform entre regiões.
No painel de navegação à esquerda, selecione Scene Center e clique em Enter no lado direito de RAG Scene-Knowledge Base Online Q & A..
-
Escolha os serviços necessários nas listas suspensas com base nas informações do service e nas características do seu negócio. Visualize os detalhes dos serviços na página Service Details.
NotaAo chamar um service de algoritmo no pipeline RAG usando uma API, especifique o ID do service (service_id). Por exemplo, o ID do service de análise de conteúdo de documento é ops-document-analyze-001.
Após alternar para um service diferente na lista de serviços, o service_id no código gerado é atualizado automaticamente. Depois de baixar o código para o ambiente local, ainda é possível alterar o service_id para chamar o service correspondente.
Estágio
Descrição do service
Análise de conteúdo de documento
Serviço de análise de conteúdo de documento (ops-document-analyze-001): fornece um service de análise de documentos de uso geral. Extrai estruturas hierárquicas lógicas, como títulos e parágrafos, de documentos não estruturados (texto, tabelas, imagens, entre outros) e gera a saída em formato estruturado.
Análise de conteúdo de imagem
-
Serviço de compreensão de conteúdo de imagem (ops-image-analyze-vlm-001): utiliza um modelo grande multimodal para analisar e compreender o conteúdo da imagem e reconhecer texto em imagens. O texto analisado pode ser usado em cenários de recuperação de imagens e perguntas e respostas.
-
Serviço de reconhecimento de texto em imagem (ops-image-analyze-ocr-001): usa reconhecimento óptico de caracteres (OCR) para identificar texto em imagens. O texto extraído pode ser aplicado em cenários de recuperação de imagens e perguntas e respostas.
Divisão de documentos
Serviço de divisão de documentos (ops-document-split-001): oferece um service de divisão de texto de uso geral. Divide dados estruturados nos formatos HTML, Markdown e TXT com base em parágrafos do documento, semântica do texto ou regras especificadas. Também extrai códigos, imagens e tabelas de documentos como rich text.
Embedding de texto
-
OpenSearch text embedding service-001 (ops-text-embedding-001): fornece um service de embedding de texto para mais de 40 idiomas. O comprimento máximo do texto de entrada é 300, e o vetor de saída possui 1.536 dimensões.
-
OpenSearch general text embedding service-002 (ops-text-embedding-002): oferece um service de embedding de texto para mais de 100 idiomas. O comprimento máximo do texto de entrada é 8.192, e o vetor de saída tem 1.024 dimensões.
-
OpenSearch text embedding service-Chinese-001 (ops-text-embedding-zh-001): disponibiliza um service de embedding de texto para textos em chinês. O comprimento máximo do texto de entrada é 1.024, e o vetor de saída possui 768 dimensões.
-
OpenSearch text embedding service-English-001 (ops-text-embedding-en-001): provê um service de embedding de texto para textos em inglês. O comprimento máximo do texto de entrada é 512, e o vetor de saída tem 768 dimensões.
Embedding esparso de texto
Oferece um service que converte dados de texto em vetores esparsos. Vetores esparsos exigem menos espaço de armazenamento e são comumente usados para representar palavras-chave e informações de frequência de termos. Podem ser usados junto com vetores densos para recuperação híbrida, melhorando o desempenho da recuperação.
OpenSearch text sparse embedding service (ops-text-sparse-embedding-001): fornece um service de embedding de texto para mais de 100 idiomas. O comprimento máximo do texto de entrada é 8.192.
Análise de consulta
O Query analysis service 001 (ops-query-analyze-001) fornece um service de análise de consulta de uso geral. Utiliza um LLM para compreender a intenção das consultas do usuário e expandi-las com perguntas semelhantes.
Motor de busca
-
Alibaba Cloud Elasticsearch: um service de cloud totalmente gerenciado baseado no Elasticsearch open source. É 100% compatível com recursos open source e está pronto para uso imediato com faturamento pagamento conforme o uso.
NotaSe você selecionar o Alibaba Cloud Elasticsearch como service de motor de busca, o service de embedding esparso de texto ficará indisponível devido a problemas de compatibilidade. Recomendamos o uso dos serviços de embedding de texto.
-
O OpenSearch Vector Search Edition é um motor de busca vetorial distribuído de grande escala desenvolvido pela alibaba. Suporta múltiplos algoritmos de recuperação vetorial e entrega excelente desempenho com alta precisão. Constrói índices e realiza recuperações em grande escala com alta relação custo-benefício. Além disso, os índices suportam dimensionamento horizontal e mesclagem, construção de índices em streaming, consultas em tempo real sobre dados recém-adicionados e atualizações dinâmicas de dados em tempo real.
NotaPara utilizar a solução de engine OpenSearch Vector Search Edition, substitua a configuração da engine e o código no pipeline RAG.
Serviço de classificação
Modelo de reranking BGE (ops-bge-reranker-larger): um service de pontuação de documentos de uso geral. Classifica os documentos em ordem decrescente de pontuação com base na relevância entre a consulta e o conteúdo do documento, e gera os resultados da pontuação.
LLM
-
OpenSearch-Qwen-Turbo (ops-qwen-turbo): utiliza o LLM qwen-turbo como modelo base e aplica ajuste fino supervisionado para aprimorar o aumento por recuperação e reduzir conteúdo nocivo.
-
Qwen-Turbo (qwen-turbo): um modelo de linguagem de ultra-grande escala Qwen que suporta entrada em diferentes idiomas, como chinês e inglês. Para mais informações, consulte Qwen Large Language Model Overview.
-
Qwen-Plus (qwen-plus): uma versão aprimorada do modelo de linguagem de ultra-grande escala Qwen que aceita entradas em diferentes idiomas, como chinês e inglês. Para mais informações, consulte Qwen Large Language Model Overview.
-
Qwen-Max (qwen-max): um modelo de linguagem de ultra-grande escala Qwen com centenas de bilhões de parâmetros que suporta entrada em diferentes idiomas, como chinês e inglês. Para mais informações, consulte Qwen Large Language Model Overview.
-
Após selecionar os serviços, clique em After the configuration is completed, enter the code query para visualizar e baixar o código.
Com base no fluxo de execução quando uma aplicação chama o pipeline RAG, o código divide-se em duas partes: processamento offline de documentos e processamento online de perguntas e respostas do usuário.
Processo
Finalidade
Descrição
Processamento offline de documentos
Processa documentos, incluindo análise de documentos, extração de imagens, divisão, embedding e gravação dos resultados do processamento de documentos em um índice ES.
A função principal document_pipeline_execute executa o seguinte processo. Forneça os documentos a serem processados usando URLs de documentos ou codificação Base64.
-
Análise de documento. Para informações sobre como chamar o service, consulte Document parsing API.
-
Chama a operação assíncrona de análise de documento para extrair o conteúdo de um documento a partir de uma URL, ou decodifica o conteúdo de um arquivo codificado em Base64.
-
Utiliza a função create_async_extraction_task para criar uma tarefa de análise e a função poll_task_result para verificar periodicamente o status de conclusão da tarefa.
-
-
Extração de imagem. Para informações sobre como chamar o service, consulte Image content extraction API.
-
Chama a operação assíncrona de análise de imagem para extrair o conteúdo de uma imagem a partir de uma URL, ou decodifica o conteúdo de um arquivo codificado em Base64.
-
Usa a função create_image_analyze_task para criar uma tarefa de análise de imagem e a função get_image_analyze_task_status para obter o status da tarefa de análise de imagem.
-
-
Divisão de documento. Para informações sobre como chamar o service, consulte Document splitting API.
-
Chama a operação de divisão de documento para dividir o documento analisado com base na estratégia especificada.
-
Utiliza a função document_split para dividir documentos. Isso inclui a divisão de documentos e a análise de conteúdo rich text.
-
-
Embedding de texto. Para informações sobre como chamar o service, consulte Text embedding API.
-
Chama a operação de representação vetorial densa de texto para converter o texto dividido em vetores.
-
Usa a função text_embedding para calcular o vetor de embedding de cada chunk.
-
-
Gravação de dados no ES. Para informações sobre como chamar o service, consulte Use the kNN search feature of Elasticsearch.
-
Cria a configuração do índice ES, que especifica o campo vetorial embedding e o campo de conteúdo do documento content.
ImportanteQuando um índice ES é criado, o sistema exclui qualquer índice existente com o mesmo nome. Para evitar que um índice existente com o mesmo nome seja excluído acidentalmente, altere o nome do índice no código.
-
Utiliza a função helpers.async_bulk para gravar os resultados de embedding no índice ES em lotes.
-
Processamento online de perguntas e respostas
Processa consultas online de usuários, incluindo geração de vetores de consulta, análise de consultas, recuperação de chunks de documentos relevantes, classificação dos resultados de recuperação e geração de respostas com base nos resultados recuperados.
A função principal query_pipeline_execute executa o seguinte processo para lidar com consultas de usuários e gerar respostas.
-
Embedding de consulta. Para informações sobre como chamar o service, consulte Text embedding API.
-
Chama a operação de representação vetorial densa de texto para converter consultas de usuários em vetores.
-
Usa a função text_embedding para gerar vetores de consulta.
-
-
Chame o service de análise de consulta. Para mais informações, consulte Query analysis API.
Chama a operação de análise de consulta para identificar a intenção das perguntas do usuário e gerar perguntas semelhantes analisando mensagens históricas.
-
Busca de chunks de embedding. Para informações sobre como chamar o service, consulte Use the kNN search feature of Elasticsearch.
-
Usa o ES para recuperar chunks de documentos no índice que sejam semelhantes ao vetor de consulta.
-
Utiliza a operação search do AsyncElasticsearch juntamente com uma consulta KNN para realizar a recuperação por similaridade.
-
-
Chame o service de classificação. Para mais informações, consulte Ranking API.
-
Chama a operação do service de classificação para pontuar e classificar os chunks relevantes recuperados.
-
Usa a função documents_ranking para pontuar e classificar o conteúdo do documento com base na consulta do usuário.
-
-
Chame um LLM para gerar uma resposta. Para informações sobre como chamar o service, consulte Answer generation API.
Chama o service LLM e usa a função llm_call para gerar a resposta final com base nos resultados da recuperação e na consulta do usuário.
Em Code Query, selecione Document processing flow e Online Q & A Process sucessivamente, e clique em Copy Code ou Download File para baixar o código para o seu ambiente local.
-
Etapa 2: Adapte o ambiente local e teste o pipeline de desenvolvimento RAG
Após baixar o código para dois arquivos locais, como online.py e offline.py, configure os parâmetros principais no código.
|
Categoria |
Parâmetro |
Descrição |
|
AI Search Open Platform |
api_key |
A chave de API usada para chamadas de API. Para informações sobre como obter a chave de API, consulte Manage API keys. |
|
aisearch_endpoint |
O endpoint da API. Para informações sobre como obter o endpoint, consulte Obtain a service endpoint. Nota
Nota: Remova "http://". Chame a API pela Internet ou por uma VPC. |
|
|
workspace_name |
AI Search Open Platform |
|
|
service_id |
Os IDs dos serviços. Para facilitar a operação, use service_id_config para configurar cada service e seu ID no código de processamento offline de documentos (offline.py) e no código de processamento online de perguntas e respostas (online.py). |
|
|
Motor de busca ES |
es_host |
O endpoint da instância do Elasticsearch (ES). Para acessar uma instância do Alibaba Cloud ES pela Internet ou por uma rede interna, adicione primeiro o endereço IP do dispositivo que acessa a instância à lista de permissões de acesso da instância. Para mais informações, consulte Manage IP address whitelists. |
|
es_auth |
O nome de usuário e a senha usados para acessar a instância do Elasticsearch. O nome de usuário é elastic, e a senha é aquela definida durante a criação da instância. Caso tenha esquecido a senha, redefina-a. Para mais informações, consulte Reset the Elasticsearch cluster password. |
|
|
Outros parâmetros |
Nenhuma modificação é necessária se você usar os dados de amostra. |
|
Após configurar os parâmetros, execute o arquivo de processamento offline de documentos offline.py e, em seguida, o arquivo de processamento online de perguntas e respostas online.py em um ambiente Python 3.7 ou posterior para verificar se os resultados estão corretos.
Por exemplo, se o documento da base de conhecimento for AI Search Open Platform overview, faça a seguinte pergunta sobre o documento: O que a AI Search Open Platform pode fazer?
Os seguintes resultados são retornados:
-
Resultado do processamento offline de documentos
image analyze :https://img.alicdn.com/imgextra/i2/O1CN01bYc1m81RrcSAyOjMu_!!6000000002165-54-tps-60-60.apng https://img.alicdn.com/imgextra/i2/O1CN01bYc1m81RrcSAyOjMu_!!6000000002165-54-tps-60-60.apng is not analyzable. image analyze :https://help-static-aliyun-doc.aliyuncs.com/assets/img/zh-CN/3873436171/p802381.png image analyze :https://help-static-aliyun-doc.aliyuncs.com/assets/img/zh-CN/0650850271/p819277.png image analyze :https://help-static-aliyun-doc.aliyuncs.com/assets/img/zh-CN/0650850271/p819277.png image analyze ://gw.alicdn.com/tfs/TB1GxwdSXXXXXa.aXXXXXXXXXXX-65-70.gif https://gw.alicdn.com/tfs/TB1GxwdSXXXXXa.aXXXXXXXXXXX-65-70.gif is not analyzable. image analyze ://img.alicdn.com/tfs/TB1..50QpXXXX7XpXXXXXXXXXX-40-40.png image analyze :https://img.alicdn.com/tfs/TB1A0dINW6qK1RjSZFmXXX0PFXa-258-258.jpg image analyze ://gw.alicdn.com/tfs/TB1GxwdSXXXXXa.aXXXXXXXXXXX-65-70.gif https://gw.alicdn.com/tfs/TB1GxwdSXXXXXa.aXXXXXXXXXXX-65-70.gif is not analyzable. image analyze ://img.alicdn.com/tfs/TB1..50QpXXXX7XpXXXXXXXXXX-40-40.png image analyze ://gw.alicdn.com/tfs/TB1GxwdSXXXXXa.aXXXXXXXXXXX-65-70.gif https://gw.alicdn.com/tfs/TB1GxwdSXXXXXa.aXXXXXXXXXXX-65-70.gif is not analyzable. image analyze ://img.alicdn.com/tfs/TB1..50QpXXXX7XpXXXXXXXXXX-40-40.png text-embedding done OS write response: {"status":"OK","code":200} -
Resultado do processamento online de perguntas e respostas
/opt/miniconda3/envs/QA-pytest-base-lib1/bin/python /Users/liu/codeRepos/QA-pytest-base-lib/rag/case/SDK/python_sdk_es_zx.py query analysis rewrite result:What can the OpenSearch search development platform do? LLM final answer: The OpenSearch search development platform provides intelligent search services. It supports the search services of core Alibaba Group businesses, including Taobao and Tmall, and provides intelligent search solutions for external customers in various industries. It offers industry-specific query semantic understanding and machine learning ranking algorithms, which help developers build intelligent search services with good performance. In addition, OpenSearch also The platform is suitable for a variety of scenarios, including but not limited to: - E-commerce and retail intelligent search - Content and news search - Gaming industry search - Healthcare industry search - Financial industry search The OpenSearch search development workbench focuses on intelligent search and RAG (Retrieval-Augmented Generation) scenarios, and provides componentized services and flexible invocation mechanisms. It has built-in services such as document parsing, document splitting, text embedding, retrieval, ranking, and LLMs, enabling one-stop, flexible AI search business development. With these services, users can easily work with RAG and search pipelines, Process finished with exit code 0 -
View source code files
FAQ
Durante a execução do código, uma mensagem Unclosed connector pode aparecer porque os recursos não foram liberados em tempo hábil. Ignore essa mensagem.