O qwen3.5-livetranslate-flash-realtime é um modelo de tradução em tempo real com aprimoramento visual compatível com 60 idiomas (29 com áudio e texto, 31 apenas com texto). Ele processa entradas de áudio e imagem de fluxos de vídeo ou arquivos locais, usa o contexto visual para melhorar a precisão e gera texto e áudio traduzidos em tempo real.
Experimente uma demonstração online com one-click deployment using Function Compute .
Recursos
- Suporte multilíngue: Traduz entre 60 idiomas — 29 com saída de áudio e texto, 31 apenas com saída de texto — incluindo chinês, inglês, francês, alemão, russo, japonês, coreano, espanhol, português e árabe.
- Aprimoramento visual: Analisa pistas visuais, como movimentos labiais, gestos e textos na tela, para aumentar a precisão da tradução, especialmente em ambientes ruidosos ou para palavras ambíguas.
- Latência de 2,3 segundos: Oferece interpretação simultânea com latência mínima de 2,3 segundos.
- Separação de falantes em tempo real: Distingue os falantes e o conteúdo de suas falas quando várias pessoas falam alternadamente, permitindo identificar quem disse o quê.
- Interpretação simultânea sem perdas: Prevê unidades semânticas para resolver diferenças na ordem das palavras entre idiomas, alcançando qualidade comparável à tradução offline.
- Voz natural: Reproduz automaticamente a entonação e a emoção do áudio original.
- Configuração de hotwords: Hotwords configuráveis melhoram a precisão da tradução para termos específicos.
- Clonagem de voz: Clona a voz do falante para a saída traduzida. Compatível com clonagem em tempo real e perfis de voz pré-clonados.
Procedimento
1. Configurar a conexão
Ao conectar via WebSocket, use os seguintes parâmetros:
Oferece suporte ao acesso via AOQ, WebRTC e WebSocket. Para integrações no lado do cliente que priorizam latência estável, resiliência em redes instáveis e supressão de ruído e cancelamento de eco full-duplex integrados, recomenda-se o uso do AOQ. Para obter uma comparação dos protocolos, consulte Realtime API overview.
| Parâmetro | Descrição |
|---|---|
endpoint | Região China (Beijing): wss://{WorkspaceId}.cn-beijing.maas.aliyuncs.com/api-ws/v1/realtime. Substitua {WorkspaceId} pelo ID real do seu workspace. Região Singapore: wss://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api-ws/v1/realtime. Substitua |
query parameter | Defina o query parameter do modelo com o nome do modelo. Exemplo: |
message header | Use um Bearer Token para autenticação: Authorization: Bearer DASHSCOPE_API_KEY
|
Exemplo de código de conexão (Python):
Código de exemplo em Python para conexão WebSocket
# pip install websocket-client
import json
import websocket
import os

API_KEY=os.getenv("DASHSCOPE_API_KEY")
API_URL = "wss://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api-ws/v1/realtime?model=qwen3.8-livetranslate-flash-realtime"

headers = [
    "Authorization: Bearer " + API_KEY
]

def on_open(ws):
    print(f"Connected to server: {API_URL}")
def on_message(ws, message):
    data = json.loads(message)
    print("Received event:", json.dumps(data, indent=2))
def on_error(ws, error):
    print("Error:", error)

ws = websocket.WebSocketApp(
    API_URL,
    header=headers,
    on_open=on_open,
    on_message=on_message,
    on_error=on_error
)

ws.run_forever()
2. Configurar idioma, modalidade e voz
Envie session.update e aguarde session.updated antes do áudio.
-
Idioma de destino: Defina
session.translation.language, com padrãoen(inglês). Veja os idiomas. Comqwen3.8-livetranslate-flash-realtime, o idioma de origem é detectado automaticamente.ObservaçãoCom
qwen3.5-livetranslate-flash-realtime, definasession.input_audio_transcription.languagepara indicar o idioma de origem ou omita o campo para a detecção automática. -
Saída: Com
qwen3.8-livetranslate-flash-realtime, configuresession.output_modalitiescomo["text"]para texto ou["text", "audio"]para texto e fala (padrão). Um idioma que aceita apenas texto exige["text"].ObservaçãoCom
qwen3.5-livetranslate-flash-realtime, usesession.modalities. Os valores disponíveis e o valor padrão são os mesmos. -
Transcrição original: Com
qwen3.8-livetranslate-flash-realtime, ela está sempre ativada e não pode ser desativada. Receba os incrementos porconversation.item.input_audio_transcription.deltae o resultado completo porconversation.item.input_audio_transcription.completed.ObservaçãoCom
qwen3.5-livetranslate-flash-realtime, ela está ativada por padrão. Definasession.input_audio_transcription.modelcomoqwen3-asr-flash-realtimepara ativá-la ounullpara desativá-la. Os incrementos são retornados porconversation.item.input_audio_transcription.texte o resultado completo porconversation.item.input_audio_transcription.completed. -
Áudio e voz: Com
qwen3.8-livetranslate-flash-realtime, os padrões são entrada PCM 16000 Hz, saída PCM 24000 Hz e vozTina. Para enviar áudio Opus, definasession.audio.input.format.typecomoopus. Confirasession.audio.output.voiceem session.created para ver a voz. Para preservar a voz do falante, veja Clonagem de voz.ObservaçãoCom
qwen3.5-livetranslate-flash-realtime, configure o áudio porsession.sample_rate,session.input_audio_formatesession.output_audio_format, e a voz porsession.voice. A voz padrão também éTina. -
Palavras-chave: Defina
session.translation.corpus.phrasespara marcas e traduções obrigatórias. Veja a configuração.ObservaçãoRecomenda-se configurar no máximo 1.000 hotwords.
{"type": "session.update", "session": {"output_modalities": ["text", "audio"], "translation": {"language": "en"}}}
3. Enviar áudio e imagens
Envie dados de áudio e imagem codificados em Base64 usando os eventos input_audio_buffer.append e input_image_buffer.append. A entrada de áudio é obrigatória; a entrada de imagem é opcional.
As imagens podem vir de um arquivo local ou ser capturadas em tempo real de um fluxo de vídeo.
Com qwen3.8-livetranslate-flash-realtime, o padrão é session.audio.input.turn_detection.type = speaker_detection. Envie áudio continuamente; o servidor detecta os limites das falas e gera traduções sem um commit manual para cada fala. Consulte Identificar falantes para a configuração e os identificadores dos falantes.
qwen3.5-livetranslate-flash-realtime: Modos VAD e Manual
A forma como o modelo determina que um enunciado foi concluído depende do modo VAD ou do modo manual configurado via parâmetro turn_detection:
- Modo VAD (padrão): O cliente envia eventos input_audio_buffer.append continuamente. Quando o servidor detecta o início ou fim da fala, ele retorna os eventos
input_audio_buffer.speech_startedeinput_audio_buffer.speech_stopped, respectivamente, confirma automaticamente o buffer de áudio e aciona a tradução. As respostas de tradução são geradas sincronizadamente com o fluxo de áudio e geralmente começam durante a entrada de áudio, sem esperar que a fala termine. - Modo manual: Defina
session.turn_detectioncomonull. Depois que o cliente termina de enviar um enunciado completo, ele envia um evento input_audio_buffer.commit para confirmar o buffer de áudio. Após o servidor retornar um eventoinput_audio_buffer.committedcomo confirmação, ele inicia automaticamente a geração da resposta de tradução; o cliente não precisa enviar nenhum outro evento para acionar a resposta. Para limpar áudios não confirmados antes da confirmação, envie um evento input_audio_buffer.clear.
4. Receber a resposta do modelo
Com qwen3.8-livetranslate-flash-realtime, receba as respostas de acordo com as modalidades de saída:
- Origem: Acumule
conversation.item.input_audio_transcription.delta; obtenha o texto completo comconversation.item.input_audio_transcription.completed. - Tradução: Use
response.text.deltapara texto ouresponse.audio_transcript.deltapara texto e áudio. Acumule os valoresdeltade cada item de mensagem na ordem recebida, sem substituir o texto anterior. - Fala: Decodifique de Base64 o campo
deltaderesponse.audio.deltae reproduza ou salve os blocos em ordem.
response.done encerra uma resposta de tradução; verifique response.status para saber se a geração foi concluída com sucesso. A sessão continua aberta para receber áudio.
qwen3.5-livetranslate-flash-realtime: Diferenças entre eventos de resposta
-
Gerar resultados de reconhecimento do idioma de origem
Defina
session.input_audio_transcription.modelcomoqwen3-asr-flash-realtime. Assim, o servidor retorna tanto a tradução quanto o resultado do reconhecimento de fala (texto original) do áudio de entrada.O servidor retorna estes eventos:
conversation.item.input_audio_transcription.text: Transmite os resultados de reconhecimento em fluxo contínuo.conversation.item.input_audio_transcription.completed: Retorna o resultado final após a conclusão do reconhecimento.conversation.item.input_audio_transcription.failed: Retorna informações de erro quando o reconhecimento falha.
As respostas de tradução são geradas sincronizadamente com o fluxo de áudio e normalmente não exigem espera até o fim da fala (consulte a descrição dos modos VAD/manual na seção anterior). O formato da resposta depende da modalidade de saída.
-
Saída apenas de texto
O servidor transmite texto traduzido incrementalmente (incluindo texto confirmado e texto previsto provisoriamente) por meio de eventos response.text.text; após a conclusão, o texto traduzido completo é retornado em um evento response.text.done.
-
Saída de texto e áudio
-
Texto
O servidor transmite texto traduzido incrementalmente por meio de eventos response.audio_transcript.text; após a conclusão, o texto traduzido completo é retornado em um evento response.audio_transcript.done.
-
Áudio
O servidor retorna dados de áudio incrementais codificados em Base64 em eventos response.audio.delta.
-
Texto
ImportanteO modelo de tradução em tempo real usa o evento response.text.text para entrega incremental de texto, o que difere do evento response.text.delta usado pelos modelos Omni (conversa de voz full-duplex). Esses eventos possuem estruturas de campos e semânticas diferentes — não os utilize de forma intercambiável.
Associar o texto original à tradução
Para exibir as legendas originais e traduzidas juntas, associe-as pelo evento conversation.item.created da tradução. item.id é o ID da tradução, e previous_item_id, no nível superior do evento, é o ID do original correspondente.
O original ou a tradução pode chegar primeiro. Armazene os resultados separadamente, associe-os por esse mapeamento e atualize cada legenda usando seu próprio item_id. Consulte Associação entre original e tradução para ver as definições dos campos.
5. Encerrar a sessão
Após enviar todo o áudio, envie um evento session.finish e aguarde o servidor retornar um evento session.finished antes de fechar a conexão WebSocket.
Se você fechar o WebSocket sem enviar session.finish, o VAD do servidor não conseguirá detectar o fim do último segmento de fala. Isso causa a perda total dos resultados de tradução desse segmento, e a conexão pode ficar travada indefinidamente. Sempre envie este evento antes de desconectar.
Modelos compatíveis
Modelos recomendados
| Modelo | Versão | Janela de contexto | Entrada máxima | Saída máxima |
|---|---|---|---|---|
| (tokens) | ||||
| qwen3.8-livetranslate-flash-realtime | Estável | 53,248 | 49,152 | 4,096 |
qwen3.5-livetranslate-flash-realtime
| Estável | 53.248 | 49.152 | 4.096 |
qwen3.5-livetranslate-flash-realtime-2026-05-19 | Snapshot | |||
Primeiros passos
Traduzir a entrada do microfone em tempo real
-
Use Python 3.10 ou posterior e instale
pyaudio:macOS
brew install portaudio && pip install pyaudioDebian/Ubuntu
sudo apt-get install python3-pyaudioCentOS
sudo yum install -y portaudio portaudio-devel && pip install pyaudioWindows
pip install pyaudioInstale a dependência WebSocket:
pip install websocket-client. -
Defina estas variáveis de ambiente. A chave de API e o espaço de trabalho devem pertencer à região da URL de conexão:
DASHSCOPE_API_KEY: Chave de API para a região e o espaço de trabalho. Consulte Obter uma chave de API.DASHSCOPE_WORKSPACE_ID: ID do espaço de trabalho. Consulte Espaços de trabalho e regiões.
-
Salve o código abaixo como
livetranslate_client.py, executepython livetranslate_client.pye fale no microfone.
O exemplo usa qwen3.8-livetranslate-flash-realtime para traduzir a entrada do microfone para inglês, imprimir o texto e reproduzir a fala traduzida em tempo real. A entrada é PCM mono, 16 bits, 16000 Hz; a reprodução é PCM mono, 16 bits, 24000 Hz. Pressione Ctrl+C para parar a gravação. O exemplo envia session.finish, recebe e reproduz os resultados restantes e fecha a conexão após session.finished. Use fones de ouvido para evitar que a fala traduzida seja gravada novamente.
import base64
import json
import os
import signal
import threading
import time

import pyaudio
import websocket

model = "qwen3.8-livetranslate-flash-realtime"
workspace_id = os.environ["DASHSCOPE_WORKSPACE_ID"]
api_key = os.environ["DASHSCOPE_API_KEY"]
url = (
    f"wss://{workspace_id}.ap-southeast-1.maas.aliyuncs.com"
    f"/api-ws/v1/realtime?model={model}"
)
stop_recording = False
send_errors = []
ws = None
audio = None
input_stream = None
output_stream = None
sender = None
previous_sigint_handler = None


def receive():
    event = json.loads(ws.recv())
    if event.get("type") == "error" or event.get("code"):
        raise RuntimeError(event)
    return event


def stop_input(signum, frame):
    global stop_recording
    stop_recording = True


def send_audio():
    try:
        while not stop_recording:
            chunk = input_stream.read(1600)
            ws.send(json.dumps({
                "type": "input_audio_buffer.append",
                "audio": base64.b64encode(chunk).decode("ascii"),
            }))
    except Exception as error:
        send_errors.append(error)
    finally:
        try:
            ws.send(json.dumps({"type": "session.finish"}))
        except Exception as error:
            send_errors.append(error)
            ws.close()


def receive_translation():
    while True:
        event = receive()
        event_type = event.get("type")
        if event_type in ("response.text.delta", "response.audio_transcript.delta"):
            print(event["delta"], end="", flush=True)
        elif event_type == "response.audio.delta":
            output_stream.write(base64.b64decode(event["delta"]))
        elif event_type == "response.done":
            if event["response"]["status"] != "completed":
                raise RuntimeError(event["response"])
            print()
        elif event_type == "session.finished":
            return


try:
    ws = websocket.create_connection(
        url, header={"Authorization": f"Bearer {api_key}"}, timeout=30
    )
    while receive().get("type") != "session.created":
        pass
    ws.send(json.dumps({
        "type": "session.update",
        "session": {
            "output_modalities": ["text", "audio"],
            "translation": {"language": "en"},
        },
    }))
    while receive().get("type") != "session.updated":
        pass
    audio = pyaudio.PyAudio()
    input_stream = audio.open(
        format=pyaudio.paInt16, channels=1, rate=16000,
        input=True, frames_per_buffer=1600,
    )
    output_stream = audio.open(
        format=pyaudio.paInt16, channels=1, rate=24000, output=True,
    )
    print("Comece a falar. Pressione Ctrl+C para parar a gravação e aguardar o restante da tradução.")
    previous_sigint_handler = signal.signal(signal.SIGINT, stop_input)
    sender = threading.Thread(target=send_audio, daemon=True)
    sender.start()
    receive_translation()
    stop_recording = True
    sender.join()
    if send_errors:
        raise send_errors[0]
except Exception:
    if send_errors:
        raise send_errors[0]
    raise
finally:
    stop_recording = True
    if ws is not None:
        ws.close()
    if sender is not None:
        sender.join()
    for stream in (input_stream, output_stream):
        if stream is not None:
            stream.stop_stream()
            stream.close()
    if audio is not None:
        audio.terminate()
    if previous_sigint_handler is not None:
        signal.signal(signal.SIGINT, previous_sigint_handler)
Configurar hotwords
Adicionar hotwords pode melhorar a precisão da tradução quando é necessário usar uma tradução fixa ou distinguir palavras homófonas. Por exemplo:
- Tradução fixa: o slogan da Alibaba Cloud, “Computação, pelo valor que não pode ser calculado.”, tem a versão inglesa definida “Computing, for the value beyond computation.”. É preciso preservar as palavras e sua ordem.
- Nomes de marca homófonos: Qoder tem a mesma pronúncia da palavra comum em inglês coder. Quando o falante se refere ao produto Qoder, a tradução precisa manter a grafia da marca.
A tabela a seguir compara as saídas de dois testes. Em cada par, o áudio é idêntico e apenas a configuração de hotwords muda.
| Conteúdo do áudio de entrada | Sem hotwords | Com hotwords |
|---|---|---|
| Computação, pelo valor que não pode ser calculado. | computation, or by the value that cannot be calculated. | Computing, for the value beyond computation. |
| Qoder é uma plataforma agêntica voltada para o trabalho real. | Coder is an agentic platform focused on real-world work. | Qoder is a platform focused on real-world work. |
Configuração
Configure hotwords por meio de session.translation.corpus.phrases, usando pares chave-valor para mapear palavras ou expressões do idioma de origem para as traduções desejadas.
Na primeira solicitação session.update de Primeiros passos, incorpore o objeto translation abaixo ao objeto session existente. Mantenha a modalidade de saída, a voz e as demais configurações da sessão.
{
  "event_id": "configure-hotwords",
  "type": "session.update",
  "session": {
    "translation": {
      "language": "en",
      "corpus": {
        "phrases": {
          "Computação, pelo valor que não pode ser calculado.": "Computing, for the value beyond computation.",
          "Qoder": "Qoder"
        }
      }
    }
  }
}
Configure a sessão antes de enviar o áudio. Aguarde o evento session.updated do servidor antes de começar a enviar eventos input_audio_buffer.append.
Identificar falantes
qwen3.8-livetranslate-flash-realtime pode identificar diferentes falantes e marcá-los com speaker_id. Associe esse ID aos textos original e traduzido para exibir legendas por falante.
Mantenha speaker_detection padrão ou configure-o em session.update. threshold distingue o silêncio da fala válida. Os sons abaixo desse limiar são filtrados e não são enviados ao modelo. O limiar é fixo em 0.5.
{"type": "session.update", "session": {"audio": {"input": {"turn_detection": {"type": "speaker_detection", "threshold": 0.5}}}}}
- Registre
speaker_ide oitem_idoriginal deinput_audio_buffer.speech_started. - Leia o texto desse
item_idemconversation.item.input_audio_transcription.delta. - No
conversation.item.createdda tradução, associeitem.idaoprevious_item_idno nível superior do evento. - Use o
item_idde cada incremento traduzido para encontrar a origem e o falante e atualizar a legenda.
Coloque as variáveis e funções abaixo antes de def receive_translation(): no exemplo de microfone dos primeiros passos. Dentro dessa função, chame handle_speaker_event(event) logo após event = receive() e substitua o print(event["delta"], end="", flush=True) original por pass, para que o trecho abaixo cuide de toda a saída das legendas. O trecho imprime ID, origem e tradução a cada atualização, para exibir legendas por falante. Mantenha o tratamento de áudio e de encerramento.
speaker_by_source = {}
source_by_translation = {}
source_text = {}
translation_text = {}


def show_subtitle(translation_id):
    source_id = source_by_translation.get(translation_id)
    if source_id not in speaker_by_source or translation_id not in translation_text:
        return
    print({
        "speaker_id": speaker_by_source[source_id],
        "source": source_text.get(source_id, ""),
        "translation": translation_text[translation_id],
    })


def handle_speaker_event(event):
    event_type = event.get("type")
    if event_type in ("response.text.delta", "response.audio_transcript.delta"):
        item_id = event["item_id"]
        translation_text[item_id] = translation_text.get(item_id, "") + event["delta"]
        show_subtitle(item_id)
        return
    if event_type == "conversation.item.created":
        item = event["item"]
        if any(part.get("type") == "input_audio" for part in item.get("content", [])):
            return
        source_id = event.get("previous_item_id")
        if item.get("role") == "assistant" and source_id is not None:
            source_by_translation[item["id"]] = source_id
            show_subtitle(item["id"])
        return
    if event_type == "input_audio_buffer.speech_started" and "speaker_id" in event:
        source_id = event["item_id"]
        speaker_by_source[source_id] = event["speaker_id"]
    elif event_type == "conversation.item.input_audio_transcription.delta":
        source_id = event["item_id"]
        source_text[source_id] = source_text.get(source_id, "") + event["delta"]
    elif event_type == "conversation.item.input_audio_transcription.completed":
        source_id = event["item_id"]
        source_text[source_id] = event["transcript"]
    else:
        return
    for translation_id, mapped_source in source_by_translation.items():
        if mapped_source == source_id:
            show_subtitle(translation_id)
Veja IDs de falante e Associação entre origem e tradução.
Melhorar a tradução com imagens
Os modelos Qwen de tradução em tempo real aceitam imagens para desambiguar homônimos e reconhecer nomes próprios incomuns durante a tradução. Envie no máximo 2 imagens por segundo.
Baixe as seguintes imagens de exemplo: medical mask.png, masquerade mask.png
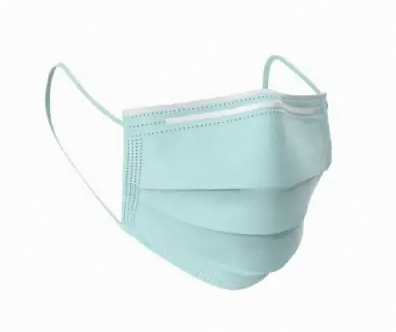
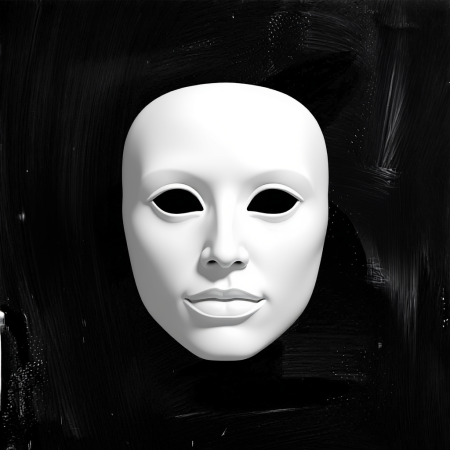
Reutilize a entrada do microfone e a conexão dos primeiros passos:
- Instale
Pillow:pip install Pillow. - Defina
translation.languagecomopte diga “What is mask?” no microfone ao executar o exemplo. - Coloque a leitura da imagem abaixo antes de
def send_audio():no exemplo de microfone e substituasend_audio()por esta versão. Ela usainput_stream,stop_recording,ws,send_errorse as importações existentes.
import io
from PIL import Image

IMAGE_PATH = "medical-mask.png"
# IMAGE_PATH = "masquerade-mask.png"
with Image.open(IMAGE_PATH) as image:
    buffer = io.BytesIO()
    image.convert("RGB").save(buffer, format="JPEG")
image_bytes = buffer.getvalue()
if len(image_bytes) > 500_000:
    raise ValueError("JPEG > 500 KB")
image_b64 = base64.b64encode(image_bytes).decode("ascii")


def send_audio():
    try:
        last_image_time = None
        while not stop_recording:
            chunk = input_stream.read(1600)
            ws.send(json.dumps({
                "type": "input_audio_buffer.append",
                "audio": base64.b64encode(chunk).decode("ascii"),
            }))
            now = time.monotonic()
            if last_image_time is None or now - last_image_time >= 0.5:
                ws.send(json.dumps({
                    "type": "input_image_buffer.append",
                    "image": image_b64,
                }))
                last_image_time = now
    except Exception as error:
        send_errors.append(error)
    finally:
        try:
            ws.send(json.dumps({"type": "session.finish"}))
        except Exception as error:
            send_errors.append(error)
            ws.close()
Áudio e imagens são intercalados, com no máximo uma imagem a cada 0,5 segundo. Teste cada imagem e confira se “mask” é traduzido como o objeto correspondente. Após Ctrl+C parar a gravação, o exemplo solicita o fim da sessão e recebe os resultados restantes.
Clonagem de voz
O modelo clona a voz do falante a partir do áudio de entrada e a utiliza na saída traduzida. Use um perfil de voz pré-clonado ou faça a clonagem em tempo real durante a tradução. Útil para interpretação de conferências, transmissões ao vivo e dublagem de vídeos.
Clonagem em tempo real: Tanto no qwen3.8-livetranslate-flash-realtime quanto no qwen3.5-livetranslate-flash-realtime, a clonagem da voz a partir do áudio durante a tradução não tem taxa adicional de clonagem. As chamadas ao modelo continuam sendo cobradas pelo uso de tokens.
Criar uma voz antecipadamente: A API de clonagem de voz cobra US$ 0,01 por voz; criações com falha não são cobradas. Consulte essa seção para as regiões, os limites e a validade da cota gratuita. A tradução com uma voz criada é cobrada pelos tokens do modelo.
Defina os seguintes parâmetros em session.update para ativar a clonagem de voz:
-
session.enable_voice_clone: Defina comotruepara ativar a clonagem de voz. -
session.voice_clone_options.frequency: Controla quando a clonagem de voz ocorre. Valores aceitos:never: Use uma voz criada previamente, sem extrair outra voz nesta sessão. Definasession.voicecom seu ID de voz clonada.once: Extraia a voz uma vez no início da sessão e reutilize-a nas traduções seguintes da mesma sessão. “Uma vez” indica a extração, não uma única saída de áudio. Adequado para apresentações com um falante; definasession.voicecomodefault.always: Extraia a voz antes de cada resposta de áudio traduzido, acompanhando as mudanças de falante. Adequado para conversas com vários falantes; definasession.voicecomodefault.
-
session.voice: Especifica a voz de saída. O valor depende da configuração defrequency:- Defina como
default: Use comfrequencydefinido comoonceoualways. Clona a voz do falante a partir do áudio de entrada. Uma voz padrão é usada até que a clonagem seja concluída. - Defina como um ID de voz clonada personalizada (por exemplo,
qwen-translate-vc-xxx-yyy-zzz): Use comfrequencydefinido comonever. Você deve preparar a voz antecipadamente usando Voice Cloning API comtarget_modeldefinido como o modelo de tradução utilizado.
- Defina como
Quando
frequencyestiver definido comoonceoualways, o parâmetrovoicedeve ser definido comodefault. Qualquer outro valor fará com que o servidor retorne um erro.
Exemplos de configuração de clonagem de voz
Com qwen3.8-livetranslate-flash-realtime, substitua a configuração session.update do exemplo desse modelo no Início rápido pela configuração adequada ao cenário.
ObservaçãoCom qwen3.5-livetranslate-flash-realtime, substitua session.output_modalities por session.modalities nos exemplos. Os demais parâmetros de clonagem são iguais. Informe esse modelo no parâmetro de conexão model e trate os eventos de resposta conforme descrito em Receber respostas do modelo.
Perfil de voz pré-clonado (para cenários que exigem uma voz fixa):
{
    "type": "session.update",
    "session": {
        "output_modalities": ["text","audio"],
        "voice": "qwen-translate-vc-xxx-yyy-zzz",
        "translation": {
            "language": "en"
        },
        "enable_voice_clone": true,
        "voice_clone_options": {
            "frequency": "never"
        }
    }
}
Reutilizar uma voz na sessão atual (um falante):
{
    "type": "session.update",
    "session": {
        "output_modalities": ["text","audio"],
        "voice": "default",
        "translation": {
            "language": "en"
        },
        "enable_voice_clone": true,
        "voice_clone_options": {
            "frequency": "once"
        }
    }
}
Acompanhar a voz do falante atual (vários falantes):
{
    "type": "session.update",
    "session": {
        "output_modalities": ["text","audio"],
        "voice": "default",
        "translation": {
            "language": "en"
        },
        "enable_voice_clone": true,
        "voice_clone_options": {
            "frequency": "always"
        }
    }
}
Implantação com um clique no Function Compute
Para implantar o aplicativo:
-
Acesse o modelo do Function Compute, insira sua chave de API e clique em Create and Deploy Default Environment para testar o aplicativo.
-
Aguarde cerca de um minuto. Em Environment Details > Environment Context, obtenha o endpoint, altere o protocolo de http para https (por exemplo, https://qwen-livetranslate-flash-realtime-intl.fcv3.xxx.ap-southeast-1.fc.devsapp.net/) e abra a URL em um navegador para interagir com o modelo.
ImportanteEste endpoint usa um certificado autoassinado e destina-se apenas a testes temporários. Seu navegador exibirá um aviso de segurança na primeira visita. Esse comportamento é esperado. Não use este endpoint em um ambiente de produção. Para prosseguir, siga as instruções na tela (por exemplo, clique em Advanced → Proceed to (unsafe)).
Se for solicitado que você configure permissões do Resource Access Management, siga as instruções na tela.
Para visualizar o código-fonte do projeto, acesse Resource Information > Function Resources .
Tanto o Function Compute quanto o Model Studio oferecem uma cota gratuita para novos usuários, suficiente para depuração básica. Após o esgotamento da cota gratuita, aplica-se o faturamento de pagamento conforme o uso.
Fluxo de interação
As principais etapas de interação com qwen3.8-livetranslate-flash-realtime são as seguintes:
| Etapa | Cliente | Servidor |
|---|---|---|
| Conexão | URL e autenticação | session.created |
| Configuração | session.update | session.updated ou error |
| Entrada | input_audio_buffer.append contínuo; imagens opcionais | IDs de falante e transcrição original |
| Recepção | Acumular texto, decodificar áudio | Incrementos; response.done encerra uma resposta |
| Fim | Parar entrada, enviar session.finish, continuar recebendo | session.finished; fechar e terminar a reprodução |
qwen3.5-livetranslate-flash-realtime: Fluxo de interação
A tradução utiliza um modelo WebSocket orientado a eventos. A forma como os limites de fala são determinados depende do modo VAD ou do modo manual (consulte 3. Input audio and images). A tabela abaixo baseia-se no modo VAD (padrão) e anota os diferentes eventos do servidor no modo manual.
| Ciclo de vida | Evento do cliente | Evento do servidor |
|---|---|---|
Inicialização da sessão | session.update
| session.created
session.updated
|
Entrada de áudio do usuário | input_audio_buffer.append
input_image_buffer.append
input_audio_buffer.commit
| Modo VAD: input_audio_buffer.speech_started
input_audio_buffer.speech_stopped
Modo manual: input_audio_buffer.committed
|
Saída de áudio do servidor | Nenhum | response.created
response.output_item.added
conversation.item.created
response.content_part.added
response.text.text
response.audio_transcript.text
response.audio.delta
response.text.done
response.audio_transcript.done
response.audio.done
response.content_part.done
response.output_item.done
response.done
|
Encerramento da sessão | session.finish
| session.finished
|
Após enviar todo o áudio, envie um evento session.finish e aguarde session.finished antes de fechar o WebSocket. Se você fechar a conexão sem enviar session.finish, o servidor não saberá que a entrada de áudio terminou, e os resultados de reconhecimento e tradução do último segmento de fala serão perdidos.
API
- Qwen-Livetranslate-Realtime.
- AOQ client SDK
- Realtime API overview (Descrição do protocolo WebRTC)
Faturamento
Qwen3.8-LiveTranslate-Flash-Realtime / Qwen3.5-LiveTranslate-Flash-Realtime-
Áudio: 7 tokens por segundo de áudio de entrada; 12,5 tokens por segundo de áudio de saída.
Com a detecção de fala no servidor, a duração do áudio de entrada é calculada com base no áudio enviado ao modelo após a filtragem. O silêncio removido pela filtragem não entra nessa duração. Consulte a contagem real de tokens de áudio de entrada em
response.usage.input_tokens_details.audio_tokensno eventoresponse.done. -
Imagem: Cada 32×32 pixels consome 0,5 tokens.
Preços: Model list.
Clonagem em tempo real: Tanto no qwen3.8-livetranslate-flash-realtime quanto no qwen3.5-livetranslate-flash-realtime, a clonagem da voz a partir do áudio durante a tradução não tem taxa adicional de clonagem. As chamadas ao modelo continuam sendo cobradas pelo uso de tokens.
Criar uma voz antecipadamente: A API de clonagem de voz cobra US$ 0,01 por voz; criações com falha não são cobradas. Consulte essa seção para as regiões, os limites e a validade da cota gratuita. A tradução com uma voz criada é cobrada pelos tokens do modelo.
Limites de taxa
Para obter informações sobre os limites de taxa do modelo, consulte Rate limiting.
Idiomas compatíveis
Use os seguintes códigos de idioma para especificar os idiomas de origem e de destino.
Alguns idiomas de destino suportam apenas texto.
Código do idioma | Idioma | Saída |
|---|---|---|
zh | Chinês | Áudio + texto |
en | Inglês | Áudio + texto |
ar | Árabe | Áudio + texto |
de | Alemão | Áudio + texto |
fr | Francês | Áudio + texto |
es | Espanhol | Áudio + texto |
pt | Português | Áudio + texto |
id | Indonésio | Áudio + texto |
it | Italiano | Áudio + texto |
ko | Coreano | Áudio + texto |
ru | Russo | Áudio + texto |
th | Tailandês | Áudio + texto |
vi | Vietnamita | Áudio + texto |
ja | Japonês | Áudio + texto |
tr | Turco | Áudio + texto |
hi | Híndi | Áudio + texto |
ms | Malaio | Áudio + texto |
nl | Holandês | Áudio + texto |
ur | Urdu | Áudio + texto |
nb | Norueguês Bokmål | Áudio + texto |
sv | Sueco | Áudio + texto |
da | Dinamarquês | Áudio + texto |
he | Hebraico | Áudio + texto |
fi | Finlandês | Áudio + texto |
pl | Polonês | Áudio + texto |
is | Islandês | Áudio + texto |
cs | Tcheco | Áudio + texto |
fil | Filipino | Áudio + texto |
fa | Persa | Áudio + texto |
yue | Cantonês | Texto |
el | Grego | Texto |
af | Africâner | Texto |
ast | Asturiano | Texto |
be | Bielorrusso | Texto |
bg | Búlgaro | Texto |
bn | Bengali | Texto |
bs | Bósnio | Texto |
ca | Catalão | Texto |
ceb | Cebuano | Texto |
et | Estoniano | Texto |
gl | Galego | Texto |
gu | Guzerate | Texto |
hr | Croata | Texto |
hu | Húngaro | Texto |
jv | Javanês | Texto |
kk | Cazaque | Texto |
kn | Canarês | Texto |
ky | Quirguiz | Texto |
lv | Letão | Texto |
mk | Macedônio | Texto |
ml | Malaiala | Texto |
mr | Marata | Texto |
pa | Panjabi | Texto |
ro | Romeno | Texto |
sk | Eslovaco | Texto |
sl | Esloveno | Texto |
sw | Suaíli | Texto |
tg | Tadjique | Texto |
az | Azeri | Texto |
uk | Ucraniano | Texto |
Vozes compatíveis
Para obter as vozes compatíveis e os valores correspondentes do parâmetro voice, consulte Voice list.
Perguntas frequentes
Há cobrança enquanto a conexão está aberta, mas ninguém fala?
Manter a conexão aberta, por si só, não gera cobrança. Quando você envia silêncio, a contabilização como entrada de áudio depende do modo usado:
- Detecção de fala no servidor: O silêncio filtrado não é contabilizado como entrada de áudio.
- Modo Manual: O silêncio confirmado explicitamente pelo cliente é contabilizado como entrada de áudio.
A quantidade de tokens de entrada de áudio é retornada em response.done, no campo response → usage → input_tokens_details → audio_tokens. O modelo é cobrado por tokens de entrada e saída. Veja Faturamento para preços e regras de cálculo.
Como migrar do Gummy para o LiveTranslate?
gummy-realtime-v1 e qwen3.8-livetranslate-flash-realtime usam protocolos diferentes. Além do nome do modelo, altere o código que abre a conexão, envia o áudio, recebe as traduções e encerra a sessão.
Este exemplo usa o SDK Python para gerar legendas em inglês. Reutilize o áudio PCM mono de 16 bits a 16 kHz e altere estas quatro chamadas.
Etapa | Gummy | LiveTranslate |
|---|---|---|
Conexão e configuração |
|
Configure a sessão após a conexão. Aguarde |
Envio de áudio |
|
|
Exibição de legendas |
|
Acrescente o conteúdo de cada campo |
Fim da sessão |
|
Continue recebendo as legendas e feche a conexão após receber |
Exemplo em Python: traduzir uma gravação para legendas em inglês
Instale o DashScope 2.0.2. Defina DASHSCOPE_API_KEY com a chave de API de Pequim e DASHSCOPE_WORKSPACE com o ID do espaço de trabalho dessa região. Salve o código como subtitles.py e execute python subtitles.py input.wav com um arquivo WAV PCM mono de 16 bits a 16 kHz.
import os
import sys
import time
import wave
from concurrent.futures import ThreadPoolExecutor

import dashscope


def send_audio(session, recording):
    while chunk := recording.readframes(1600):
        session.append_audio(chunk)
        time.sleep(len(chunk) / 32000)
    session.end_session()


def translate(path):
    client = dashscope.Client(api_key=os.environ["DASHSCOPE_API_KEY"],
                              workspace=os.environ["DASHSCOPE_WORKSPACE"],
                              region="cn-beijing")
    with wave.open(path, "rb") as recording:
        if (recording.getframerate(), recording.getnchannels(), recording.getsampwidth()) != (16000, 1, 2):
            raise ValueError("Expected a 16 kHz mono 16-bit PCM WAV file")
        with client.audio.realtime.connect(model="qwen3.8-livetranslate-flash-realtime", timeout=30) as session:
            events = session.events()
            for event in events:
                if event["type"] == "session.created":
                    session.update_session(output_modalities=["text"], translation_params={"language": "en"})
                elif event["type"] == "session.updated":
                    break
                elif event["type"] == "error":
                    raise RuntimeError(event["error"])
            else:
                raise RuntimeError("Session closed before configuration completed")

            with ThreadPoolExecutor(max_workers=1) as pool:
                sender = pool.submit(send_audio, session, recording)
                try:
                    for event in events:
                        kind = event["type"]
                        if kind == "response.text.delta":
                            print(event["delta"], end="", flush=True)
                        elif kind == "response.text.done":
                            print(flush=True)
                        elif kind == "response.done" and event["response"]["status"] != "completed":
                            raise RuntimeError(event["response"].get("status_details"))
                        elif kind == "error":
                            raise RuntimeError(event["error"])
                        elif kind == "session.finished":
                            break
                    else:
                        raise RuntimeError("Session closed before session.finished")
                except BaseException:
                    session.close()
                    raise
                sender.result()


if __name__ == "__main__":
    translate(sys.argv[1])
Para uma conexão WebSocket direta, faça estas três alterações. Veja o exemplo completo em Primeiros passos.
- Endereço: substitua
/api-ws/v1/inferencepor/api-ws/v1/realtime?model=qwen3.8-livetranslate-flash-realtime. - Áudio: substitua os quadros binários por eventos JSON
input_audio_buffer.appende envie o PCM codificado em Base64 no campoaudio. - Tradução: substitua
result-generatedporresponse.text.deltae acrescente cadadeltaà legenda. Após enviar o áudio, enviesession.finishe aguardesession.finishedantes de fechar a conexão.