Para dar suporte à arquitetura integrada de armazenamento e processamento completo e incremental, as tabelas Delta fornecem um formato de dados unificado. Elas oferecem todos os recursos das tabelas padrão do MaxCompute e são adequadas para novos cenários que envolvem processamento incremental, como consultas time travel e operações UPSERT. Este tópico descreve o formato de dados das tabelas Delta.
Principais propriedades das tabelas Delta
O sistema oferece suporte apenas a tabelas Delta com chave primária. Para criar uma tabela Delta com chave primária por meio da instrução CREATE TABLE, configure as seguintes propriedades principais: primary key e tblproperties ("transactional"="true").
primary key**: Após configurar essa propriedade, importe dados no modo UPSERT de forma eficiente. O sistema mescla várias linhas de registros com a mesma chave primária em uma única linha após uma consulta baseada em snapshot ou a operação de compaction, mantendo apenas o status mais recente.
tblproperties ("transactional"="true"): A propriedade transactional indica as características de transação ACID (atomicidade, consistência, isolamento e durabilidade) para garantir o isolamento de snapshot e o controle sobre operações simultâneas de leitura e escrita. O sistema adiciona um campo de propriedade transacional a cada linha de dados gravada na tabela. Por exemplo, o campo timestamp é incluído em cada linha para obter os registros da versão de dados necessária nas time travel queries.
Você também pode definir outras propriedades importantes da tabela. Por exemplo, use a propriedade write.bucket.num para especificar o grau de paralelismo de gravação e a propriedade acid.data.retain.hours para definir o intervalo de tempo efetivo para consultas de dados históricos. Para obter mais informações sobre as propriedades da tabela, consulte Parameters for Delta tables.
Formatos de arquivo compatíveis com tabelas Delta
As tabelas Delta aceitam vários formatos de arquivo, o que ajuda a garantir alta eficiência em cenários de leitura e gravação completa, além de leituras e gravações incrementais em tempo quase real. Os formatos compatíveis incluem arquivos base e arquivos delta.
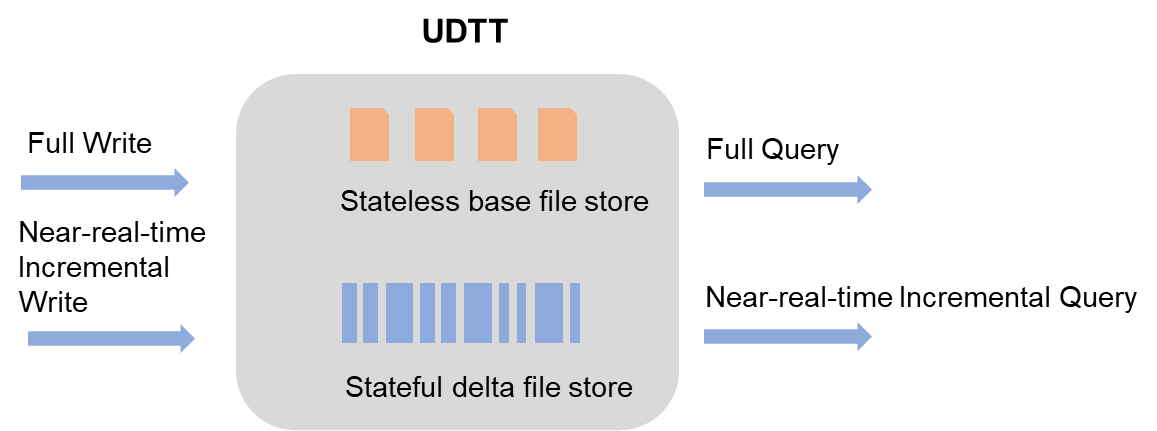
Descrição dos arquivos base e delta:
Arquivo delta: tipo de arquivo gerado sempre que uma transação é confirmada e os dados são gravados no modo UPDATE ou DELETE. Esse arquivo armazena o status histórico intermediário de cada linha de dados para atender aos requisitos de leitura e gravação incremental em tempo quase real. O sistema também gera um arquivo delta sempre que executa a operação de clustering. Esses arquivos utilizam armazenamento orientado a colunas e compressão.
Arquivo base: tipo de arquivo gerado após a operação de compaction nos arquivos delta. Em um arquivo base, o status histórico intermediário é removido e apenas uma linha de dados é mantida para registros com a mesma chave primária. Arquivos base usam armazenamento orientado a colunas e compressão para dar suporte a consultas eficientes de dados completos.
Ao consultar dados em uma tabela Transaction Table 2.0, observe os seguintes pontos:
O MaxCompute busca o arquivo base mais recente sempre que realiza uma consulta baseada em snapshot. Em seguida, localiza todos os arquivos delta nos quais os dados foram gravados após a geração do arquivo base e mescla as informações desses arquivos. Portanto, o modo de consulta é Merge On Read (MOR). Para obter mais informações, consulte Time travel queries and incremental queries.
Todos os arquivos de dados são classificados com base no valor da coluna de chave primária. Isso melhora significativamente a eficiência da mesclagem e ajuda a otimizar consultas com data skipping. Como os arquivos de dados usam armazenamento orientado a colunas e compressão, é possível reduzir efetivamente o volume de dados armazenados, economizar custos e aumentar a eficiência de E/S.
Buckets
Para aumentar ainda mais a eficiência de leitura e gravação, as tabelas Delta permitem dividir os dados para armazenamento com base na coluna de índice de bucket. Por padrão, essa coluna reutiliza os dados da coluna de chave primária. Configure a propriedade write.bucket.num para especificar o número de buckets nos quais os dados serão gravados. Dessa forma, os dados gravados na mesma tabela ou partição são divididos conforme o valor da chave primária. Registros com a mesma chave primária ficam armazenados no mesmo bucket.
O recurso de Near-real-time incremental import oferece suporte a alta concorrência com base no dimensionamento horizontal do número de buckets. Por isso, avalie e especifique uma quantidade adequada de buckets considerando o tráfego de gravação de dados e o tamanho total de armazenamento da tabela. Se o número de buckets for excessivamente alto, muitos arquivos pequenos poderão ser gerados, afetando a eficiência de leitura e gravação, além da estabilidade do armazenamento. Caso o número seja muito baixo, os requisitos de importação em tempo quase real com alto tráfego e velocidade podem não ser atendidos.
Esse recurso também contribui para melhorar a eficiência das consultas de dados. Se a condição de filtro for aplicada à coluna de índice de bucket, o pruning de bucket pode ocorrer de maneira eficiente para reduzir o volume de dados consultados. Quando a coluna chave na cláusula GROUP BY ou na operação JOIN coincide com a coluna de índice de bucket, execute diretamente operações locais de join ou GROUP BY. Isso ajuda a reduzir o shuffling, economizar recursos computacionais e melhorar o desempenho da consulta.
Operações de gerenciamento e otimização de dados, como clustering e compactação de arquivos pequenos, podem ser executadas em paralelo com base nos buckets para aumentar a eficiência de execução e reduzir o tempo de processamento.
Tipos de registro
Apenas registros de dados dos tipos UPSERT e DELETE podem ser gravados e armazenados. O tipo UPSERT contém duas semânticas implícitas: INSERT e UPDATE. Se um registro não existir anteriormente, o tipo será INSERT. Caso o registro já exista, o tipo será UPDATE.