Quando seu pipeline de dados conecta bancos de dados, sistemas de log ou filas de mensagens ao MaxCompute, os carregamentos em lote introduzem latência e tornam os dados recentes indisponíveis para consultas. A gravação incremental em tempo quase real resolve esse problema ao escrever continuamente as linhas recebidas em uma tabela delta em intervalos de minutos. Assim, os dados confirmados ficam imediatamente disponíveis para consulta, sem necessidade de aguardar um ciclo completo de carregamento.
Escolha um modo de gravação
|
Modo de gravação |
Latência |
Quando usar |
|
Gravação incremental em tempo quase real |
Nível de minuto |
Fluxos contínuos de dados; requer baixa latência e tolerância a falhas |
|
Gravação completa de dados |
Mais alta |
Carregamentos periódicos em lote; substitui todo o conjunto de dados de uma vez |
Como funciona
O MaxCompute fornece um plug-in conector do Flink de código source que se integra ao Data Integration do DataWorks e a outras ferramentas de importação para oferecer suporte a gravações incrementais em tempo quase real.
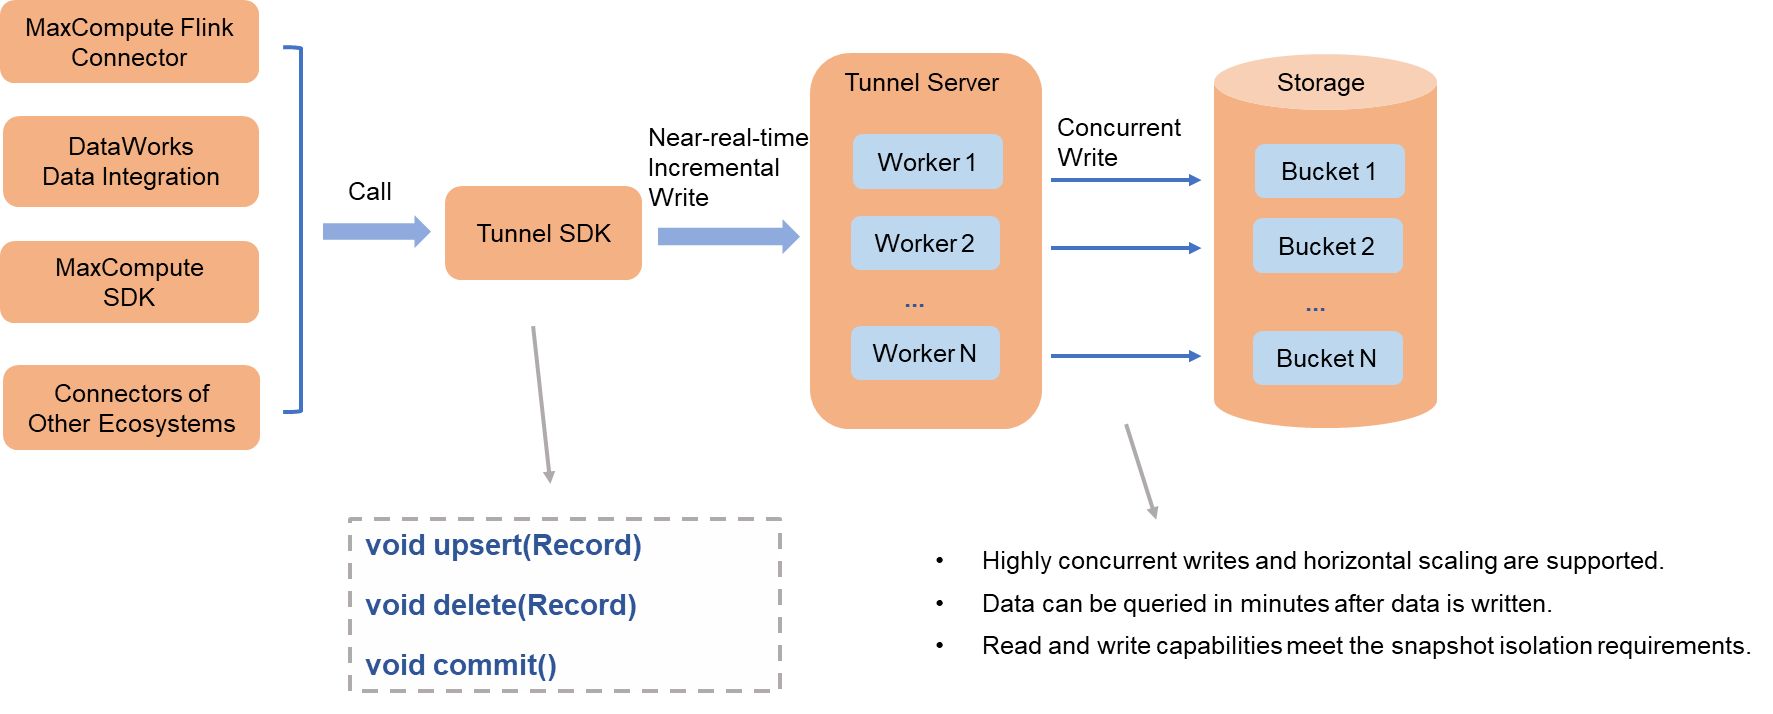
A figura anterior ilustra o processamento de dados de negócios.
O fluxo de dados funciona da seguinte maneira:
Uma ferramenta de importação usa o cliente SDK do serviço MaxCompute Tunnel para gravar dados simultaneamente no servidor Tunnel em intervalos de minutos.
O servidor Tunnel distribui as gravações entre vários nós worker, que escrevem os dados em paralelo nos arquivos de dados de cada bucket.
Ao chamar a interface de commit, a ferramenta de importação confirma atomicamente todos os dados gravados até aquele momento na tabela delta e os torna imediatamente consultáveis.
Controle de concorrência
Defina o parâmetro write.bucket.num para controlar a concorrência de gravação. Um número maior de buckets aumenta o throughput de escrita. Para obter detalhes sobre como os buckets afetam o desempenho, consulte Formato de dados da tabela.
Operações compatíveis
A interface de gravação do SDK do Tunnel oferece suporte às seguintes operações:
|
Operação |
Descrição |
|
UPSERT |
Insere uma nova linha ou atualize uma linha existente |
|
DELETE |
Exclua uma linha da tabela delta |
Semântica de commit e tolerância a falhas
Cada chamada à interface de commit representa uma confirmação atômica de todos os dados gravados antes dessa invocação. Os dados confirmados atendem ao isolamento de snapshot de leitura e escrita.
Em caso de sucesso: Os dados confirmados tornam-se imediatamente consultáveis e respeitam o isolamento de snapshot de leitura e escrita.
Em caso de falha: Se a chamada falhar, tente gravar os dados novamente. Caso a falha não decorra de um erro irrecuperável, como corrupção de dados, a nova tentativa pode ser bem-sucedida sem necessidade de regravar os dados. Caso contrário, regrave e confirme os dados novamente.
|
Tipo de falha |
Ação de recuperação |
|
Não irrecuperável (por exemplo, não causada por corrupção de dados) |
Tente o commit diretamente — não é necessário regravar os dados |
|
Irrecuperável (por exemplo, corrupção de dados ou erro permanente) |
Regrave os dados e faça o commit novamente |
Próximos passos
Formato de dados da tabela — entenda como os buckets afetam o desempenho de gravação
Plug-in conector do Flink — defina o conector de código source para gravações incrementais