O MaxCompute Graph é um framework de computação em grafos iterativo. Ele permite criar modelos de grafos e executar algoritmos — como PageRank, caminho mais curto de fonte única (SSSP) e clustering k-means — diretamente nos dados armazenados no MaxCompute. Use o SDK for Java fornecido pelo MaxCompute Graph para desenvolver seus programas de computação em grafos.
Funcionamento
Algoritmos de grafos são inerentemente iterativos: a propriedade de um vértice depende das propriedades de seus vizinhos, que, por sua vez, dependem dos vizinhos destes. O MaxCompute Graph captura esse comportamento modificando repetidamente o grafo até atingir uma condição de convergência. Cada iteração é chamada de superstep.
Um programa de grafo executa em três fases:
Carregamento do grafo — Um
GraphLoaderpersonalizado lê registros de uma tabela de entrada e os converte em vértices e arestas. Em seguida, umPartitionerpersonalizado distribui os vértices entre os workers. Por padrão, o MaxCompute Graph particiona os vértices aplicando hash ao ID de cada vértice pelo módulo do número de workers.-
Computação iterativa — Cada superstep percorre todos os vértices não paralisados e quaisquer vértices paralisados que receberam mensagens e chama
compute(ComputeContext context, Iterable messages)em cada um deles. Dentro decompute(), cada vértice pode:Processar mensagens enviadas pelo superstep anterior.
Alterar os valores de vértices ou arestas.
Enviar mensagens para outros vértices.
Adicionar ou remover vértices e arestas.
Usar um
Aggregatorpara coletar e atualizar informações globais. Para obter detalhes, consulte Mecanismo de implementação do Aggregator.Definir seu próprio estado como paralisado ou não paralisado.
O MaxCompute Graph envia mensagens de forma assíncrona aos workers relacionados em cada superstep. O processamento dessas mensagens ocorre no superstep seguinte.
-
Término da iteração — A computação para quando qualquer uma das condições abaixo for verdadeira:
Todos os vértices estão paralisados (Halted = true) e nenhuma nova mensagem foi gerada.
O número máximo de iterações foi atingido.
O método
terminate()de um aggregator retornatrue.
O pseudocódigo a seguir ilustra o fluxo completo de execução:
// 1. load
for each record in input_table {
  GraphLoader.load();
}
// 2. setup
WorkerComputer.setup();
for each aggr in aggregators {
  aggr.createStartupValue();
}
for each v in vertices {
  v.setup();
}
// 3. superstep
for (step = 0; step < max; step ++) {
  for each aggr in aggregators {
    aggr.createInitialValue();
  }
  for each v in vertices {
    v.compute();
  }
}
// 4. cleanup
for each v in vertices {
  v.cleanup();
}
WorkerComputer.cleanup();
Conceitos principais
|
Termo |
Definição |
|
Grafo |
Estrutura de dados abstrata que representa relacionamentos entre objetos por meio de vértices e arestas. |
|
Vértice |
Representa um objeto em um grafo. Estrutura: |
|
Aresta |
Aresta direcionada única que indica a relação entre dois objetos. Estrutura: |
|
Grafo direcionado |
Grafo no qual as arestas possuem direção, classificadas como arestas de saída ou de entrada. |
|
Grafo não direcionado |
Grafo no qual as arestas não possuem direção. |
|
Aresta de saída |
Aresta direcionada cuja origem é o vértice atual. |
|
Aresta de entrada |
Aresta direcionada cujo destino é o vértice atual. |
|
Grau |
Número de arestas conectadas a um vértice. |
|
Grau de saída |
Número de arestas de saída conectadas a um vértice. |
|
Grau de entrada |
Número de arestas de entrada conectadas a um vértice. |
|
Superstep |
Uma iteração da computação do grafo. |
Estrutura de dados do grafo
O MaxCompute Graph processa grafos direcionados. Como o MaxCompute usa uma estrutura de armazenamento baseada em tabelas bidimensionais, converta os dados do grafo para esse formato antes de armazená-los.
Durante a computação, um GraphLoader personalizado converte os registros da tabela novamente em vértices e arestas.
Estrutura do vértice: <ID, Value, Halted, Edges>
|
Campo |
Descrição |
|
|
ID do vértice. |
|
|
Valor do vértice. |
|
|
Indica se o vértice parou de iterar. |
|
|
Arestas de saída deste vértice. |
Estrutura da aresta: <DestVertexID, Value>
|
Campo |
Descrição |
|
|
ID do vértice de destino. |
|
|
Valor da aresta. |
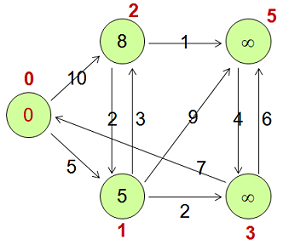
O grafo acima corresponde à seguinte tabela bidimensional:
|
Vértice |
<ID, Value, Halted, Edges> |
|
v0 |
|
|
v1 |
|
|
v2 |
|
|
v3 |
|
|
v5 |
|
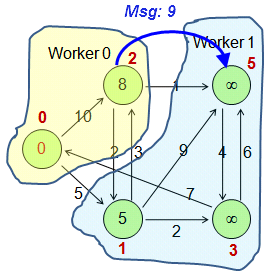
A figura a seguir mostra como os vértices se distribuem entre dois workers durante o carregamento do grafo. Os IDs dos vértices passam por hash com módulo 2: v0 e v2 (ID módulo 2 = 0) vão para o Worker 0; v1, v3 e v5 (ID módulo 2 = 1) vão para o Worker 1.
Ao editar um vértice ou aresta, use código para manter os relacionamentos entre vértices e arestas.