O Aggregator é um recurso comum no MaxCompute Graph para agregar e processar informações globais em todos os workers de um job distribuído. Use-o para verificar se uma condição global foi atendida (como a convergência em machine learning) ou para manter estatísticas que abrangem vários workers.
Como funciona
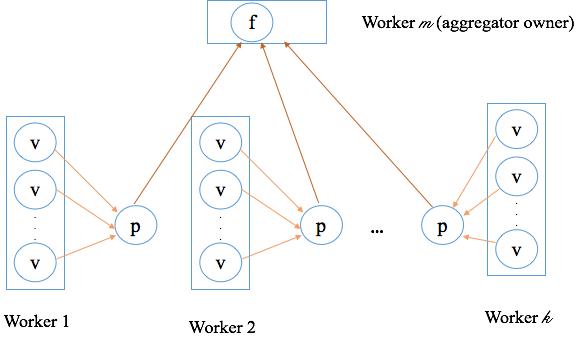
A lógica do Aggregator executa em dois locais: de forma distribuída em todos os workers, para agregação parcial, e em um único worker designado (o proprietário do Aggregator), para a agregação global.
Cada superstep segue esta sequência:
Cada worker chama
createStartupValuena inicialização para criar umAggregatorValue.No início de cada iteração, cada worker chama
createInitialValuepara inicializar oAggregatorValuedessa iteração.Durante a iteração, cada vértice chama
context.aggregate(), acionandoaggregate()para construir um resultado parcial no worker.Cada worker envia seu resultado parcial ao worker proprietário do Aggregator.
O worker proprietário do Aggregator chama
mergerepetidamente para combinar todos os resultados parciais em um resultado de agregação global.O worker proprietário do Aggregator chama
terminatepara finalizar o resultado global e decidir se deve encerrar a iteração.
Em seguida, o resultado global é distribuído a todos os workers no início do próximo superstep.
Operações da API
O Aggregator fornece cinco operações de API. Três executam em todos os workers e lidam com a agregação parcial; duas executam apenas no worker proprietário do Aggregator e lidam com a agregação global.
|
API |
Executa em |
Chamado por |
Finalidade |
|
|
Todos os workers |
Framework, uma vez antes de cada superstep |
Inicializar |
|
|
Todos os workers |
Framework, uma vez no início de cada superstep |
Inicializar |
|
|
Todos os workers |
Chamada explícita via |
Agregação parcial |
|
|
Apenas proprietário do Aggregator |
Framework |
Mesclar resultados parciais no resultado global |
|
|
Apenas proprietário do Aggregator |
Framework, após |
Finalizar o resultado global; retornar |
createStartupValue(context)
Este método é chamado uma vez em todos os workers antes do início de cada superstep. Use-o para inicializar o AggregatorValue. No superstep 0, chame WorkerContext.getLastAggregatedValue() ou ComputeContext.getLastAggregatedValue() para obter o objeto inicializado.
createInitialValue(context)
Invocado uma vez em todos os workers no início de cada superstep. Serve para inicializar o AggregatorValue da iteração atual. Normalmente, chame WorkerContext.getLastAggregatedValue() para obter o resultado da iteração anterior e inicialize a partir dele.
aggregate(value, item)
Executado em todos os workers. Diferentemente de createStartupValue e createInitialValue, este método não é chamado automaticamente. Ele é acionado quando o código do vértice chama ComputeContext#aggregate(item).
value: resultado de agregação atual do worker para este superstep, inicializado porcreateInitialValueitem: valor passado porComputeContext#aggregate(item)
Atualize value usando item para construir o resultado parcial. Após a conclusão de todas as chamadas de aggregate, o framework envia value ao worker proprietário do Aggregator.
merge(value, partial)
Chamado no worker proprietário do Aggregator para combinar resultados parciais de todos os workers.
value: resultado de agregação global em andamentopartial: resultado parcial recebido de um worker
Use partial para atualizar value. Por exemplo, se os workers w0, w1 e w2 produzirem resultados parciais p0, p1 e p2, e eles chegarem na ordem p1, p0, p2:
merge(p1, p0)— p1 é atualizado para incluir p0merge(p1, p2)— p1 é atualizado para incluir p2; p1 torna-se o resultado da agregação global
Se existir apenas um worker, merge() não será chamado.
terminate(context, value)
Invocado no worker proprietário do Aggregator após a conclusão de todas as chamadas de merge(). O parâmetro value contém o resultado da agregação global.
Modifique value se necessário e retorne:
true— encerra a iteração para todo o jobfalse— continua para a próxima iteração
Após o retorno de terminate(), o framework distribui o objeto de agregação global a todos os workers para o próximo superstep. Retornar true quando a convergência estiver completa interrompe os jobs imediatamente. Esse é o padrão típico em cenários de machine learning.
Exemplo de clustering K-means
O exemplo a seguir demonstra como implementar o Aggregator para clustering K-means. A lógica principal concentra-se na classe Aggregator, que coordena a agregação parcial entre os workers e conduz a convergência.
Para obter o código-fonte completo, baixe o arquivo Kmeans.gz . O código abaixo é um trecho para referência.
GraphLoader
KmeansReader carrega cada linha da tabela de entrada como um vértice. recordNum torna-se o ID do vértice, e os dados da linha são armazenados como um DenseVector no valor do vértice. (DenseVector proviene de matrix-toolkits-java.)
public static class KmeansValue implements Writable {
    DenseVector sample;
    public KmeansValue() {
    }
    public KmeansValue(DenseVector v) {
        this.sample = v;
    }
    @Override
        public void write(DataOutput out) throws IOException {
        wirteForDenseVector(out, sample);
    }
    @Override
        public void readFields(DataInput in) throws IOException {
        sample = readFieldsForDenseVector(in);
    }
}
public static class KmeansReader extends
GraphLoader<LongWritable, KmeansValue, NullWritable, NullWritable> {
@Override
public void load(
LongWritable recordNum,
WritableRecord record,
MutationContext<LongWritable, KmeansValue, NullWritable, NullWritable> context)
throws IOException {
KmeansVertex v = new KmeansVertex();
v.setId(recordNum);
int n = record.size();
DenseVector dv = new DenseVector(n);
for (int i = 0; i < n; i++) {
dv.set(i, ((DoubleWritable)record.get(i)).get());
}
v.setValue(new KmeansValue(dv));
context.addVertexRequest(v);
}
}Vertex
Cada vértice contribui com sua amostra para a agregação parcial. Toda a lógica de computação resume-se a uma única chamada de context.aggregate():
public static class KmeansVertex extends
    Vertex<LongWritable, KmeansValue, NullWritable, NullWritable> {
    @Override
        public void compute(
        ComputeContext<LongWritable, KmeansValue, NullWritable, NullWritable> context,
        Iterable<NullWritable> messages) throws IOException {
        context.aggregate(getValue()); // submit this vertex's sample for partial aggregation
    }
}
Aggregator
KmeansAggrValue armazena os dados agregados entre os workers e redistribuídos a cada superstep:
public static class KmeansAggrValue implements Writable {
    DenseMatrix centroids; // K x m matrix of current cluster centers
    DenseMatrix sums;      // running sums per cluster dimension, for recomputing centers
    DenseVector counts;    // number of samples assigned to each cluster center
    @Override
        public void write(DataOutput out) throws IOException {
        wirteForDenseDenseMatrix(out, centroids);
        wirteForDenseDenseMatrix(out, sums);
        wirteForDenseVector(out, counts);
    }
    @Override
        public void readFields(DataInput in) throws IOException {
        centroids = readFieldsForDenseMatrix(in);
        sums = readFieldsForDenseMatrix(in);
        counts = readFieldsForDenseVector(in);
    }
}
sums(i,j) armazena a soma da dimensão j em todas as amostras mais próximas do centro i. Em conjunto com counts, recalcula a nova posição do centro a cada superstep.
createStartupValue — lê os centros iniciais do arquivo de cache centers e inicializa sums e counts com zero:
public static class KmeansAggregator extends Aggregator<KmeansAggrValue> {
    public KmeansAggrValue createStartupValue(WorkerContext context) throws IOException {
        KmeansAggrValue av = new KmeansAggrValue();
        byte[] centers = context.readCacheFile("centers"); // load initial cluster centers
        String lines[] = new String(centers).split("\n");
        int rows = lines.length;
        int cols = lines[0].split(",").length; // assumption rows >= 1
        av.centroids = new DenseMatrix(rows, cols);
        av.sums = new DenseMatrix(rows, cols);
        av.sums.zero();   // initialize to zero before first superstep
        av.counts = new DenseVector(rows);
        av.counts.zero(); // initialize to zero before first superstep
        for (int i = 0; i < lines.length; i++) {
            String[] ss = lines[i].split(",");
            for (int j = 0; j < ss.length; j++) {
                av.centroids.set(i, j, Double.valueOf(ss[j]));
            }
        }
        return av;
    }
}
createInitialValue — redefine sums e counts para zero, mantendo os centroids da iteração anterior:
@Override
public KmeansAggrValue createInitialValue(WorkerContext context)
    throws IOException {
    KmeansAggrValue av = (KmeansAggrValue)context.getLastAggregatedValue(0);
    // reset accumulators; retain centroids from the previous iteration
    av.sums.zero();
    av.counts.zero();
    return av;
}
aggregate — encontra o centroide mais próximo para cada amostra e acumula sums e counts (agregação parcial em cada worker):
@Override
public void aggregate(KmeansAggrValue value, Object item)
    throws IOException {
    DenseVector sample = ((KmeansValue)item).sample;
    int min = findNearestCentroid(value.centroids, sample); // find closest cluster center
    for (int i = 0; i < sample.size(); i ++) {
        value.sums.add(min, i, sample.get(i)); // accumulate sample dimensions
    }
    value.counts.add(min, 1.0d); // increment sample count for this cluster
}
merge — combina resultados parciais de todos os workers somando sums e counts (agregação global no worker proprietário do Aggregator):
@Override
public void merge(KmeansAggrValue value, KmeansAggrValue partial)
    throws IOException {
    value.sums.add(partial.sums);     // accumulate sums from this worker
    value.counts.add(partial.counts); // accumulate counts from this worker
}
terminate — calcula novos centros de cluster, verifica a convergência usando distância euclidiana com limiar de 0,05 e decide se deve encerrar a iteração:
@Override
public boolean terminate(WorkerContext context, KmeansAggrValue value)
    throws IOException {
    // Calculate new centers from the aggregated sums and counts
    DenseMatrix newCentriods = calculateNewCentroids(value.sums, value.counts, value.centroids);
    // print old centroids and new centroids for debugging
    System.out.println("\nsuperstep: " + context.getSuperstep() +
                       "\nold centriod:\n" + value.centroids + " new centriod:\n" + newCentriods);
    boolean converged = isConverged(newCentriods, value.centroids, 0.05d); // Euclidean distance threshold
    System.out.println("superstep: " + context.getSuperstep() + "/"
                       + (context.getMaxIteration() - 1) + " converged: " + converged);
    if (converged || context.getSuperstep() == context.getMaxIteration() - 1) {
        // converged or reached max iterations — write final centers and stop
        for (int i = 0; i < newCentriods.numRows(); i++) {
            Writable[] centriod = new Writable[newCentriods.numColumns()];
            for (int j = 0; j < newCentriods.numColumns(); j++) {
                centriod[j] = new DoubleWritable(newCentriods.get(i, j));
            }
            context.write(centriod);
        }
        return true;  // end iteration
    }
    value.centroids.set(newCentriods); // update centers for next iteration
    return false; // continue iteration
}
Método main
O método main constrói o GraphJob, configura todas as classes de componentes e envia o job. O número máximo padrão de iterações é 30, configurável por meio do terceiro argumento.
public static void main(String[] args) throws IOException {
    if (args.length < 2)
        printUsage();
    GraphJob job = new GraphJob();
    job.setGraphLoaderClass(KmeansReader.class);
    job.setRuntimePartitioning(false); // each worker loads and retains its own data partition
    job.setVertexClass(KmeansVertex.class);
    job.setAggregatorClass(KmeansAggregator.class); // register the Aggregator implementation
    job.addInput(TableInfo.builder().tableName(args[0]).build());
    job.addOutput(TableInfo.builder().tableName(args[1]).build());
    // default max iteration is 30
    job.setMaxIteration(30);
    if (args.length >= 3)
        job.setMaxIteration(Integer.parseInt(args[2]));
    long start = System.currentTimeMillis();
    job.run();
    System.out.println("Job Finished in "
                       + (System.currentTimeMillis() - start) / 1000.0 + " seconds");
}Quandojob.setRuntimePartitioningé definido comofalse, os dados carregados por cada worker não são particionados pelo particionador. Cada worker carrega e mantém seus próprios dados.