O MaxCompute suporta gravações de dados em tempo real e atualizações de chave primária em minutos usando tabelas Delta. Isso reduz a latência entre a ingestão e a disponibilidade dos dados para consulta para 5 a 10 minutos.
Pipelines tradicionais em lote disponibilizam os dados apenas no dia seguinte, o que é lento demais para eventos sensíveis ao tempo, como logs de comportamento do cliente, comentários, avaliações ou curtidas em conteúdo viral. A ingestão em tempo quase real sincroniza dados incrementais em uma tabela Delta em poucos minutos. Se você já tem uma tarefa em produção gravando na camada de armazenamento operacional de dados (ODS) no MaxCompute, use o recurso UPSERT das tabelas Delta para ingerir dados sem modificar essa tarefa. O UPSERT evita registros duplicados, melhora a eficiência do armazenamento e reduz custos.
Como funciona a ingestão em tempo quase real
A solução usa o conector Flink para gravar dados em streaming em uma tabela Delta do MaxCompute por meio de uma sessão upsert gerenciada pelo serviço de túnel.

Gravar dados do Flink em uma tabela Delta
O conector Flink grava dados em uma tabela Delta do MaxCompute em um processo de seis etapas.
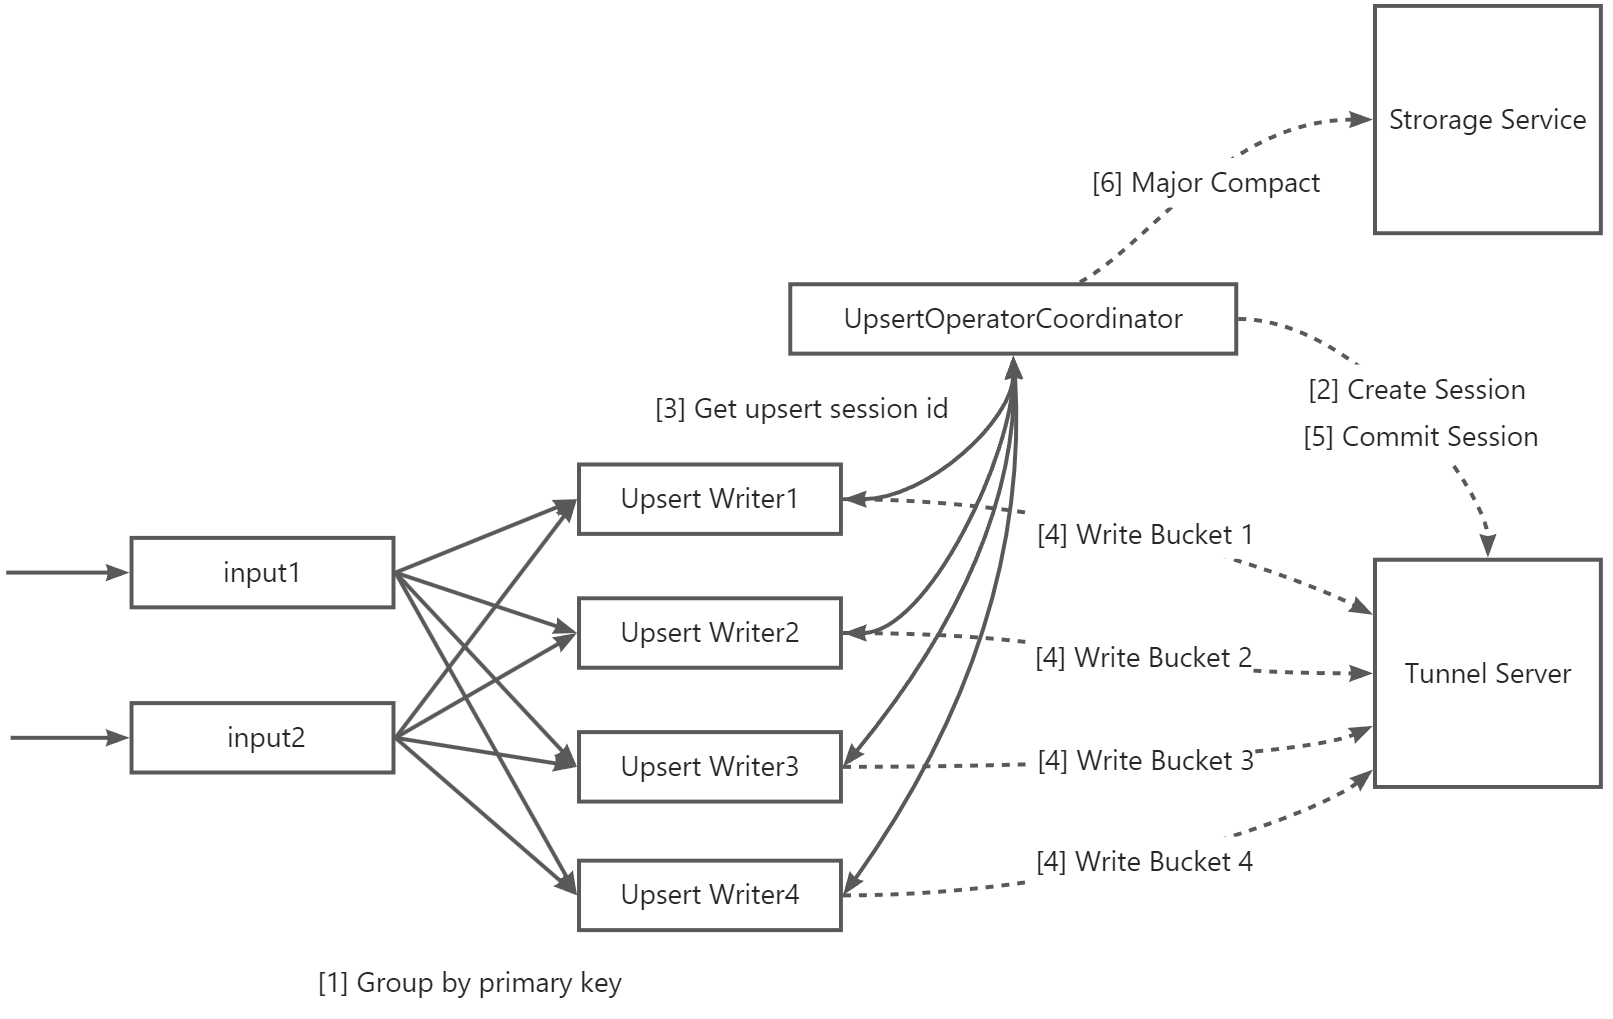
| Etapa | Descrição |
|---|---|
| 1 | Os dados são agrupados por chave primária e gravados simultaneamente na tabela. Como alternativa, agrupe os dados pela coluna da chave de partição quando houver gravação simultânea em muitas partições, distribuição uniforme dos dados entre as partições e a tabela tiver menos de 10 buckets. |
| 2 | O UpsertWriterTask analisa as partições às quais os dados pertencem e envia uma solicitação ao UpsertOperatorCoordinator. O UpsertOperatorCoordinator cria uma sessão upsert para gravações em tempo real nessas partições. |
| 3 | O UpsertOperatorCoordinator retorna o ID da sessão upsert ao UpsertWriterTask. |
| 4 | Com base na sessão, o UpsertWriterTask cria um Upsert Writer e se conecta ao MaxCompute Tunnel Server para gravar dados continuamente. No modo de cache de arquivos, os dados ficam em buffer no disco local do nó Flink e são transmitidos ao Tunnel Server quando o tamanho do arquivo atinge um limiar ou quando um checkpoint é iniciado. |
| 5 | Ao iniciar um checkpoint, o Upsert Writer envia todos os dados ao Tunnel Server e aciona um commit. Os dados tornam-se visíveis após o sucesso do commit. |
| 6 | Se a compactação principal automática estiver ativada, o UpsertOperatorCoordinator inicia uma operação de compactação principal no Storage Service quando o número de commits de partição excede um limiar. Aviso
A compactação principal pode aumentar a latência na importação de dados em tempo real, dependendo do volume de dados da tabela. Use a compactação principal automática com cautela. |
Para obter um guia completo, consulte Usar o Flink para gravar dados em uma tabela Delta.
Ajustar parâmetros de UPSERT para throughput
Os parâmetros padrão de UPSERT atendem à maioria das cargas de trabalho, mas você pode ajustá-los para atingir metas específicas de throughput ou estabilizar o desempenho em cenários com alto número de partições. Para referência completa dos parâmetros, consulte Parâmetros da instrução UPSERT.
Linha de base: buckets e paralelismo do sink
Dois parâmetros determinam o limite máximo de throughput:
Número de buckets: O throughput máximo estimado de gravação é 1 MB/s × número de buckets. Defina este valor com base na sua taxa sustentada de ingestão.
sink.parallelism: Para desempenho ideal, defina este valor igual ao número de buckets. No mínimo, o número de buckets deve ser um múltiplo inteiro desink.parallelism.
A quantidade de buckets atribuída a cada nó sink é calculada por: número de buckets ÷ sink.parallelism.
Tabelas não particionadas
Quando usar: Seus dados não possuem colunas de chave de partição ou você está gravando em uma única partição lógica.
Se o aumento de sink.parallelism não melhorar o throughput, provavelmente o gargalo está antes do nó sink. Otimize primeiro o pipeline de processamento de dados upstream.
Se o resultado de upsert.writer.buffer-size ÷ buckets-per-sink-node ficar abaixo de 128 KB, a eficiência da transmissão de rede cai. Aumente upsert.writer.buffer-size para recuperar o desempenho.
Para elevar o throughput, aumente upsert.flush.concurrent (padrão: 2). Monitore o desempenho durante o ajuste. Valores excessivamente altos fazem com que vários buckets realizem flush simultaneamente, causando congestionamento de rede e redução do throughput geral.
Poucas partições
Quando usar: Você está gravando simultaneamente em um pequeno número de partições.
Siga as orientações para tabelas não particionadas acima e considere também:
Durante um checkpoint, as gravações em cada partição são confirmadas independentemente, o que pode limitar o throughput geral.
A memória máxima de buffer por nó sink corresponde a
upsert.writer.buffer-size × número de partições. Se ocorrer um erro de falta de memória (OOM), diminuaupsert.writer.buffer-size.Aumente
upsert.commit.thread-num(padrão:16) para paralelizar commits durante um checkpoint. Não ultrapasse32. Acima desse limiar, problemas decorrentes de concorrência excessiva degradam o desempenho.
Muitas partições (modo de cache de arquivos)
Quando usar: Você está gravando simultaneamente em um grande número de partições e o tempo de commit do checkpoint representa o gargalo.
Aplique as orientações para poucas partições mencionadas anteriormente e considere também:
Os dados de cada partição são armazenados em cache em um arquivo local e gravados simultaneamente no MaxCompute durante um checkpoint.
O parâmetro
sink.file-cached.writer.num(padrão:16) controla quantas partições um único nó sink grava simultaneamente. Não defina este valor acima de32.A contagem efetiva de buckets de gravação simultânea é dada por
sink.file-cached.writer.num × upsert.flush.concurrent. Ajuste ambos os parâmetros em conjunto, mas mantenha o produto baixo o suficiente para evitar congestionamento de rede.
Para a lista completa de parâmetros do modo de cache de arquivos, consulte Parâmetros para gravação de dados no modo de cache de arquivos.
Referência de parâmetros principais
|
Parâmetro |
Padrão |
Máximo recomendado |
Descrição |
|
|
— |
— |
Paralelismo dos nós sink; defina como igual ao número de buckets |
|
|
— |
— |
Tamanho do buffer por bucket; aumente se o throughput cair abaixo de 128 KB por bucket |
|
|
2 |
— |
Buckets liberados simultaneamente; aumente gradualmente e monitore quanto a congestionamentos de rede |
|
|
16 |
32 |
Threads para commits paralelos de partições durante o checkpoint; acima de 32, problemas causados por concorrência excessiva reduzem o throughput |
|
|
16 |
32 |
Gravadores simultâneos de partições no modo de cache de arquivos; acima de 32, o congestionamento de rede reduz o throughput |
Quando os ajustes não surtem efeito
Se as metas de throughput ainda não forem atingidas após os ajustes:
A cota do grupo de recursos público do Tunnel para cada projeto possui um limite. Ao atingir esse teto, as gravações são rejeitadas, reduzindo o throughput efetivo. Migre para um grupo de recursos exclusivo do Tunnel ou reduza a concorrência.
O pipeline de processamento de dados upstream que alimenta o conector pode ser o gargalo. Analise e otimize o pipeline upstream.
Resiliência e tratamento de erros
Projete seu pipeline para lidar com os seguintes modos de falha antes de entrar em produção.
Checkpoint expira antes da conclusão
Erro: Checkpoint xxx expired before completing
Muitas partições estão sendo gravadas durante um único intervalo de checkpoint, fazendo com que a fase de commit exceda o tempo limite do checkpoint.
Para resolver isso:
Aumente o intervalo de checkpoint do Flink para conceder mais tempo à fase de commit.
Ative o modo de cache de arquivos definindo
sink.file-cached.enablecomotrue.
Para parâmetros do modo de cache de arquivos, consulte Apêndice: Parâmetros do conector Flink da nova versão.
OperatorEvent perdido, failover de tarefa acionado
Erro: org.apache.flink.util.FlinkException: An OperatorEvent from an OperatorCoordinator to a task was lost. Triggering task failover to ensure consistency.
A comunicação entre JobManager e TaskManager foi interrompida. A tarefa tenta nova execução automaticamente. Se o problema persistir, aumente os recursos da tarefa para estabilizar a conexão.
Desvio de oito horas no timestamp após gravar dados TIMESTAMP
O tipo TIMESTAMP do Flink não carrega informações de fuso horário. O MaxCompute trata os valores TIMESTAMP recebidos como UTC+0 e depois os converte para o fuso horário configurado no projeto durante a leitura. Isso gera um desvio aparente de 8 horas para projetos em UTC+8.
Substitua as colunas TIMESTAMP na sua tabela sink do MaxCompute por TIMESTAMP_LTZ. O TIMESTAMP_LTZ mantém o contexto de fuso horário ao longo do pipeline, evitando qualquer desvio de conversão na leitura.
Erro do Tengine durante a gravação de dados
Erro: Uma página HTML do Tengine exibindo Sorry, the page you are looking for is currently unavailable.
O serviço Tunnel está temporariamente indisponível. Aguarde a recuperação do serviço. A tarefa Flink tenta nova execução automaticamente e retoma a gravação assim que o Tunnel for restaurado.
SlotExceeded: cota de gravação excedida
Erro: java.io.IOException: RequestId=xxxxxx, ErrorCode=SlotExceeded, ErrorMessage=Your slot quota is exceeded.
O número de slots de gravação simultâneos excedeu a cota do projeto. Diminua a concorrência de gravação (reduza sink.parallelism) ou aumente o paralelismo dos grupos de recursos exclusivos do Tunnel para expandir a cota disponível.