Os workflows em lote tradicionais do MaxCompute importam dados incrementais ao longo de horas ou dias e exigem jobs complexos de mesclagem ETL, resultando em alta latência, custos elevados de armazenamento e manutenção difícil. A arquitetura integrada para armazenamento e processamento de dados completos e incrementais em tempo quase real resolve esse problema ao introduzir as Delta tables: um formato de tabela unificado que suporta upserts por chave primária, consultas time travel e governança automatizada de dados em um único sistema totalmente gerenciado. Reduza a latência de dados de ponta a ponta de horas ou dias para 5 a 10 minutos sem executar pipelines ETL separados.
Contexto
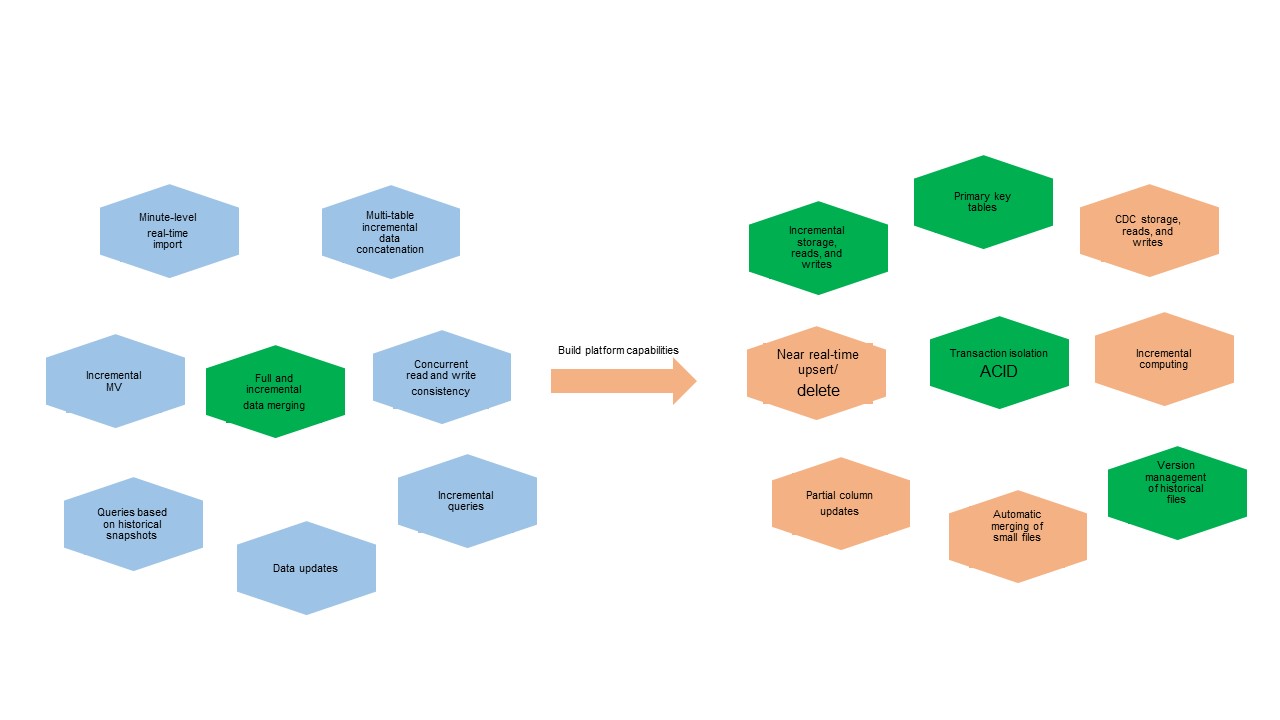
Com o crescimento dos volumes de dados e a maior exigência dos cenários de negócios, a importação de dados em tempo quase real demanda engines de plataforma com isolamento de transações e mesclagem automática de arquivos pequenos. Mesclar dados completos e incrementais requer capacidade de armazenar, ler e gravar dados incrementais usando chaves primárias.
Antes desta arquitetura integrada, três soluções anteriores atendiam a essas necessidades, cada uma com compromissos entre custo, facilidade de uso, latência e throughput:
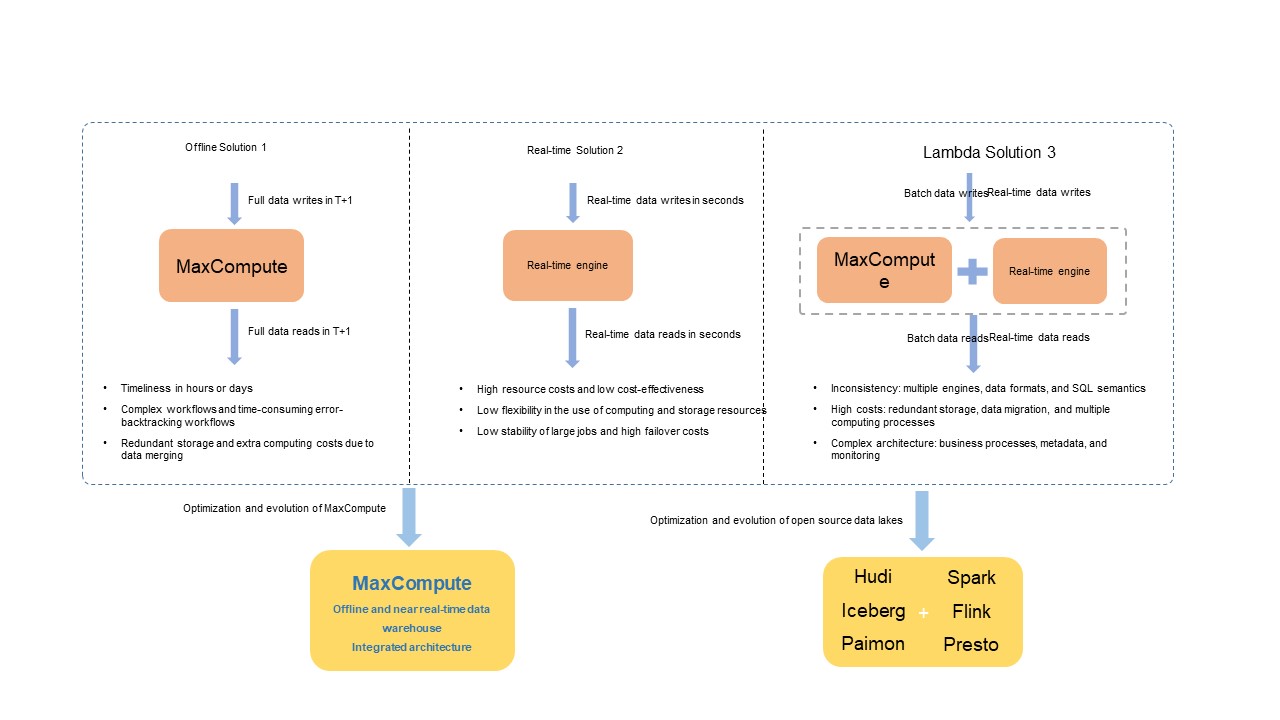
No ecossistema open-source, engines como Spark, Flink e Trino — integradas a formatos de data lake como Apache Hudi, Delta Lake, Apache Iceberg e Apache Paimon — resolvem problemas semelhantes na arquitetura Lambda ao combinar engines de computação abertas com armazenamentos de dados unificados.
Arquitetura integrada para armazenamento e processamento de dados completos e incrementais em tempo quase real
A arquitetura integrada do MaxCompute suporta uma ampla variedade de fontes de dados. Importe dados completos e incrementais para um serviço de armazenamento dedicado usando ferramentas de desenvolvimento personalizadas. Um serviço de gerenciamento de dados no backend otimiza e orquestra automaticamente a estrutura de armazenamento. Engines de computação unificadas processam tanto dados incrementais em tempo quase real quanto dados em lote. Um serviço de metadados unificado gerencia metadados de transações e arquivos.
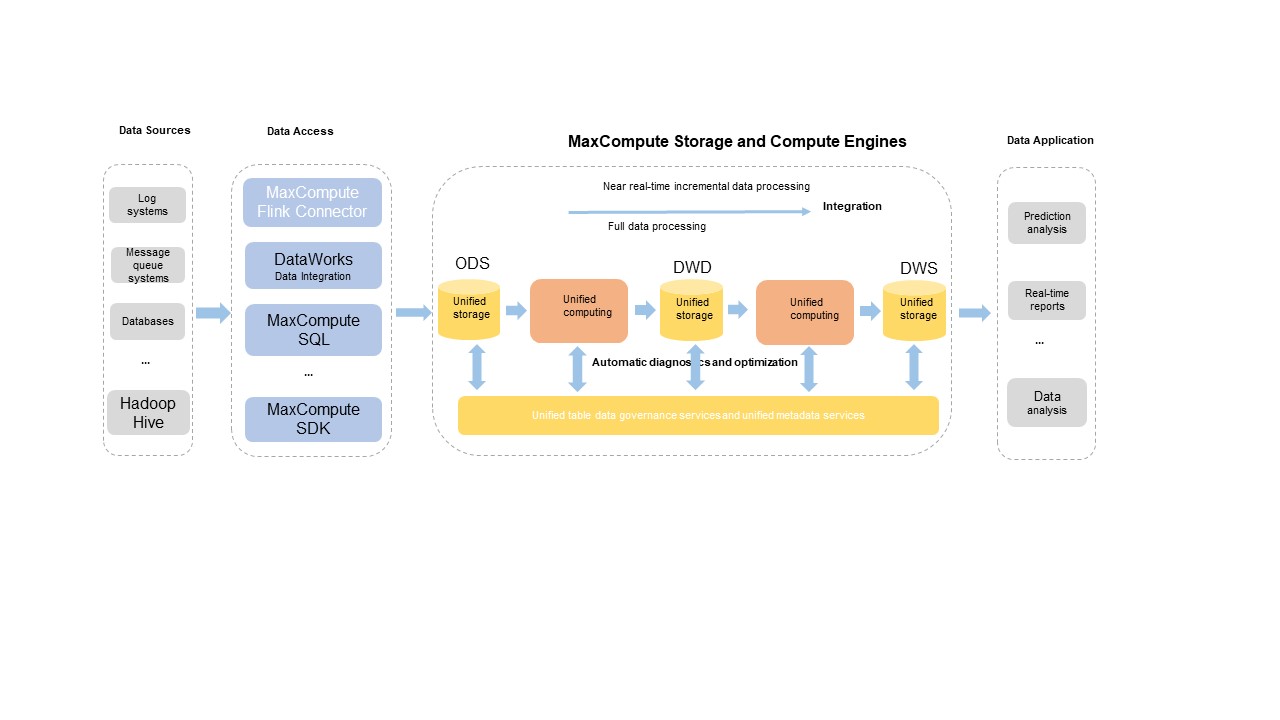
A arquitetura oferece as seguintes capacidades principais:
Tabelas com chave primária
Upserts em tempo real
Consultas time travel
Consultas incrementais
Operações de linguagem de manipulação de dados (DML) SQL
Governança e otimização automáticas dos dados da tabela
Para obter detalhes sobre o funcionamento da arquitetura e operações relacionadas, consulte Visão geral das Delta Tables e Operações básicas.
Benefícios da arquitetura
A arquitetura integrada suporta os principais recursos comuns de formatos de data lake open-source, como Apache Hudi e Apache Iceberg, facilitando a migração entre processos de negócios. Por ser uma arquitetura nativa da plataforma desenvolvida pela Alibaba Cloud, ela também oferece as seguintes vantagens:
|
Vantagem |
Descrição |
|
Integração unificada |
Utiliza serviços de armazenamento, serviços de metadados e engines de computação unificados para uma integração profunda e eficiente, oferecendo armazenamento econômico, gerenciamento eficiente de arquivos, alta eficiência de consulta e consultas time travel em dados incrementais. |
|
Sintaxe SQL completa |
Oferece um sistema de sintaxe SQL de uso geral projetado para suportar todos os recursos principais. |
|
Ferramentas de importação de dados otimizadas |
Disponibiliza ferramentas altamente personalizadas para importação de dados em cenários de negócios complexos. |
|
Compatibilidade total |
Integra-se aos cenários de negócios existentes no MaxCompute sem exigir migração de dados ou custos adicionais de armazenamento e computação. |
|
Gerenciamento automatizado de arquivos |
Garante gerenciamento de arquivos totalmente automatizado para maior estabilidade e desempenho nas operações de leitura e gravação, com otimização automática da eficiência de armazenamento. |
|
Totalmente gerenciado, sem configuração |
Baseado no serviço totalmente gerenciado do MaxCompute, disponível imediatamente sem custos adicionais de acesso. Basta crie uma Delta table para que a arquitetura entre em vigor imediatamente. |
|
Cronograma de desenvolvimento autônomo |
Mantém um cronograma de desenvolvimento autônomo e controlável. |
Cenários de negócios
Formatos de tabela e governança de dados
Criação de tabelas
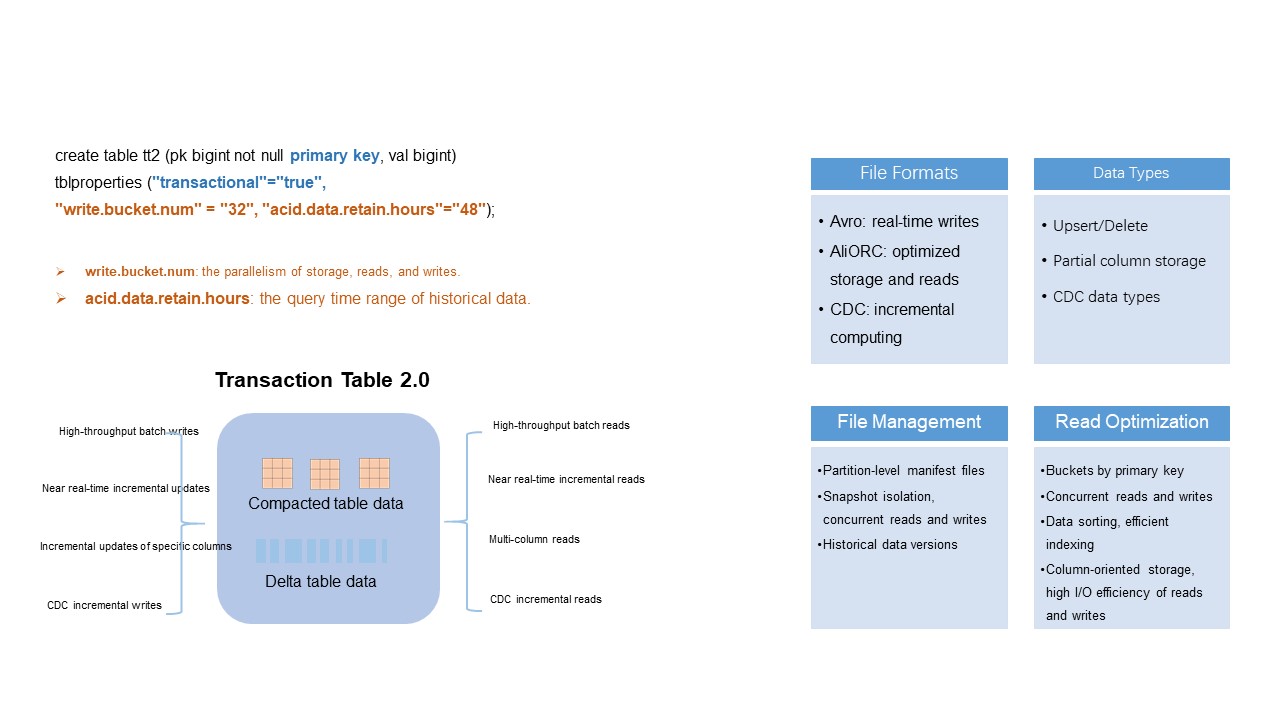
O MaxCompute introduz as Delta tables com um formato de dados de tabela unificado para suportar a arquitetura integrada. As Delta tables suportam todos os recursos dos workflows de processamento em lote existentes, além de novos workflows, como armazenamento e processamento de dados incrementais em tempo quase real.
Para crie uma Delta table, especifique as chaves primárias e defina "transactional"="true" na instrução CREATE TABLE:
CREATE TABLE tt2 (pk BIGINT NOT NULL PRIMARY KEY, val STRING) tblproperties ("transactional"="true");
CREATE TABLE par_tt2 (pk BIGINT NOT NULL PRIMARY KEY, val STRING)  PARTITIONED BY (pt STRING) tblproperties ("transactional"="true");
As chaves primárias garantem a unicidade das linhas. A propriedade transactional habilita o mecanismo de transação ACID (atomicidade, consistência, isolamento e durabilidade) com isolamento de snapshot para operações de leitura e gravação. Para mais detalhes, consulte Operações de tabela.
Parâmetros principais para Delta tables
Para a referência completa de parâmetros, consulte a seção "Parâmetros para Delta tables" em Operações de tabela.
write.bucket.num
Especifica o número de buckets por tabela particionada ou não particionada e o número de nós de gravação simultâneos. O valor padrão é 16. Valores válidos: (0, 4096].
Para tabelas particionadas: o valor pode ser alterado e se aplica automaticamente às novas partições.
Para tabelas não particionadas: o valor não pode ser alterado após a criação.
Mais buckets aumentam o paralelismo de gravação e consulta, mas também geram mais arquivos pequenos, elevando os custos de armazenamento e reduzindo a eficiência de leitura. Siga estas diretrizes ao dimensionar os buckets:
|
Cenário |
Recomendação |
|
Dados < 1 GB (não particionado ou particionado) |
4 a 16 buckets |
|
Dados > 1 GB |
Manter cada bucket entre 128 MB e 256 MB |
|
Dados > 1 TB |
Manter cada bucket entre 500 MB e 1 GB |
|
Tabela particionada com > 500 partições, cada uma com algumas dezenas de MB |
1 a 2 buckets por partição para evitar proliferação de arquivos pequenos |
acid.data.retain.hours
Define o intervalo de tempo de dados históricos disponíveis para consultas time travel. O valor padrão é 24. Valores válidos: [0, 168] (unidade: horas).
Defina como
0para desativar consultas time travel e reduzir significativamente os custos de armazenamento de dados históricos.Para dados históricos com mais de 168 horas (7 dias), entre em contato com o suporte técnico do MaxCompute.
Defina um período de retenção compatível com seus requisitos de negócios. Períodos de retenção mais longos aumentam os custos de armazenamento e podem tornar as consultas mais lentas. Após o término do período de retenção, o sistema recupera e limpa automaticamente os dados históricos, incluindo logs de operação e arquivos de dados. Depois disso, não é mais possível consultar esses dados via time travel. Para limpar forçadamente os dados históricos antes do fim do período, execute o comando purge.
Evolução de schema
As Delta tables suportam evolução completa de schema, incluindo adição e exclusão de colunas. Ao consultar dados históricos com time travel, o sistema lê os dados com base no schema daquela versão histórica.
Chaves primárias não podem ser modificadas.
O exemplo a seguir adiciona uma coluna:
ALTER TABLE tt2 ADD columns (val2 string);Para a sintaxe DDL completa, consulte Operações de tabela.
Formatos de dados da tabela
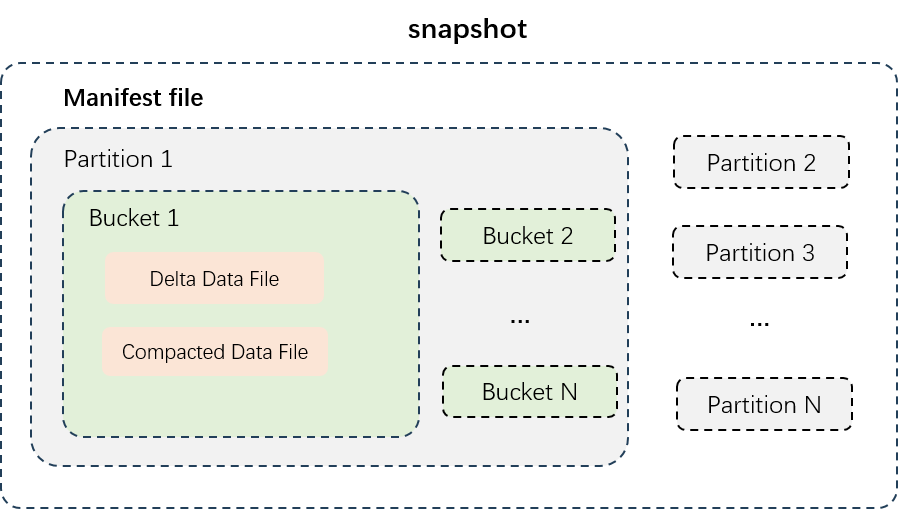
A figura acima mostra a estrutura de dados de uma tabela particionada. Os arquivos de dados são fisicamente isolados por partição (armazenados em diretórios separados), e os dados de cada partição são divididos em buckets. As Delta tables usam dois tipos de arquivos de dados:
|
Tipo de arquivo |
Descrição |
Formato de armazenamento |
Ideal para |
|
Arquivos de dados Delta |
Dados incrementais gerados após cada gravação de transação ou mesclagem de arquivos pequenos. Armazena dados históricos intermediários de todas as linhas para suportar leituras e gravações em tempo quase real. |
Orientado a linhas (Avro) |
Ingestão em tempo quase real; time travel em versões recentes |
|
Arquivos de dados compactados |
Gerados após a compactação dos arquivos delta. Retém apenas o registro mais recente por chave primária, sem histórico intermediário. Otimizado para consultas rápidas. |
Orientado a colunas (AliORC) |
Consultas analíticas; leituras em lote de alto throughput |
Governança e otimização automáticas de dados
Problema: proliferação de arquivos pequenos
As Delta tables suportam importação de dados incrementais em tempo quase real, na casa dos minutos. Em cenários de gravação de alto tráfego com muitos buckets, o número de arquivos pequenos de dados incrementais pode crescer rapidamente, causando excesso de solicitações de acesso, custos elevados e baixa eficiência de I/O. Operações intensivas de UPDATE e DELETE agravam ainda mais esse cenário ao gerar grande quantidade de registros históricos intermediários redundantes.
Solução: quatro serviços de governança automatizados
O engine de armazenamento do MaxCompute governa e otimiza automaticamente os dados armazenados sem necessidade de configuração manual. O engine identifica inteligentemente as características dos dados em múltiplas dimensões e aplica políticas automaticamente.
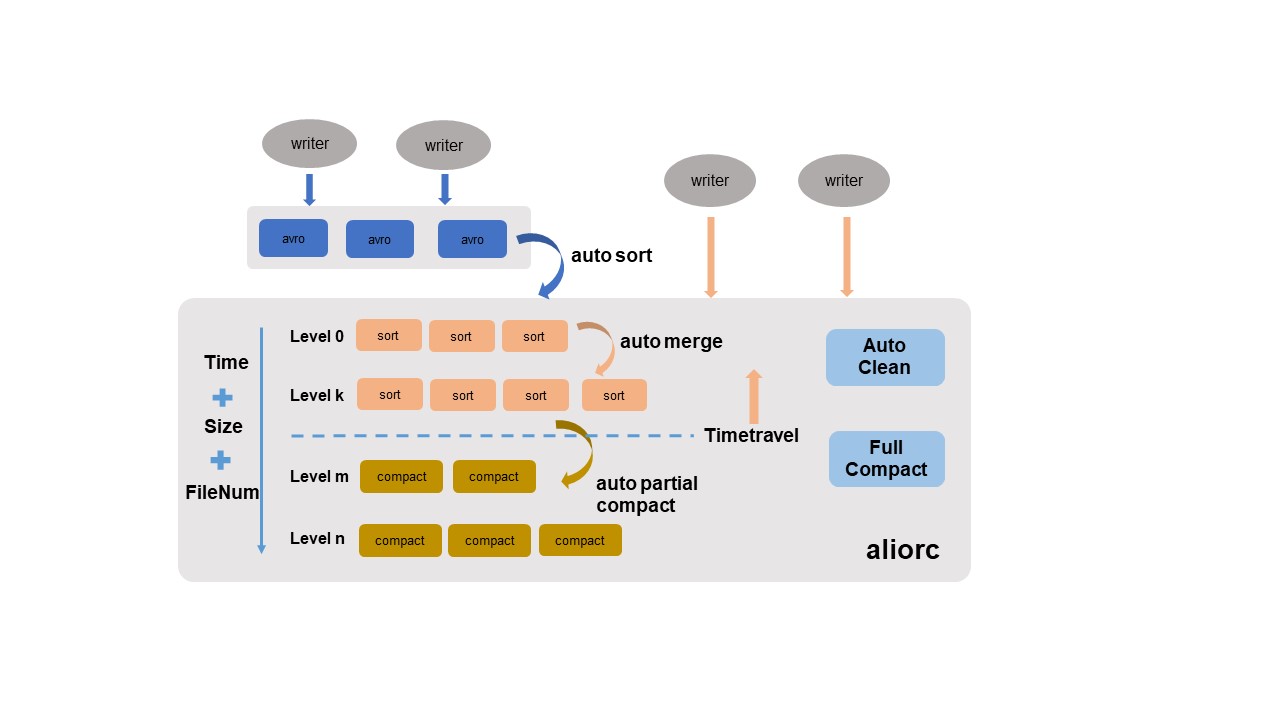
|
Serviço |
Função |
|
Auto sort |
Converte arquivos Avro orientados a linhas, gravados em tempo real, em arquivos AliORC orientados a colunas. Reduz custos de armazenamento e melhora o desempenho de leitura. |
|
Auto merge |
Mescla arquivos pequenos periodicamente, analisando tamanho, quantidade e série temporal de gravação, e depois mesclando por nível. Os dados históricos intermediários são preservados para manter a integridade do time travel. |
|
Auto partial compact |
Mescla arquivos e limpa registros históricos fora da janela de retenção do time travel. Reduz custos de armazenamento em cargas de trabalho intensivas de UPDATE/DELETE e melhora a eficiência de leitura. |
|
Auto clean |
Exclui arquivos originais após o auto sort, auto merge ou auto partial compact gerar novos arquivos substitutos. Libera espaço de armazenamento em tempo real. |
O auto partial compact limpa apenas registros históricos cuja data de criação ultrapassa a janela de retenção do time travel.
Para cenários que exigem desempenho máximo de consulta, acione uma compactação principal (major compaction) manualmente:
SET odps.merge.task.mode=service;
ALTER TABLE tt2 compact major;A compactação principal consolida todos os dados em cada bucket, limpa todos os dados históricos e gera arquivos AliORC orientados a colunas. Isso gera sobrecarga adicional de execução e aumenta os custos de armazenamento dos novos arquivos. Use apenas quando necessário.
Para mais informações, consulte COMPACTION.
Gravação de dados
Upserts em tempo quase real na casa dos minutos
Por que usar Delta tables: O processamento em lote tradicional importa dados incrementais para uma nova tabela ou partição ao longo de horas ou dias e, em seguida, aciona um processo ETL offline para unir e mesclar esses dados incrementais com os dados existentes na tabela. Essa abordagem apresenta alta latência e custos elevados de recursos e armazenamento.
Com as Delta tables, o pipeline de upsert mantém uma latência de 5 a 10 minutos entre a gravação dos dados e a consulta. Não há necessidade de processos complexos de mesclagem ETL, o que reduz tanto os custos de computação quanto os de armazenamento.
É comum encontrar diversas fontes de dados em produção, como bancos de dados, sistemas de log e filas de mensagens. O MaxCompute fornece um plug-in conector Flink open-source que funciona com o DataWorks Data Integration e outras ferramentas de importação de dados. Ele suporta design personalizado e otimização de desenvolvimento para cenários de alta concorrência, tolerância a falhas e submissão de transações.
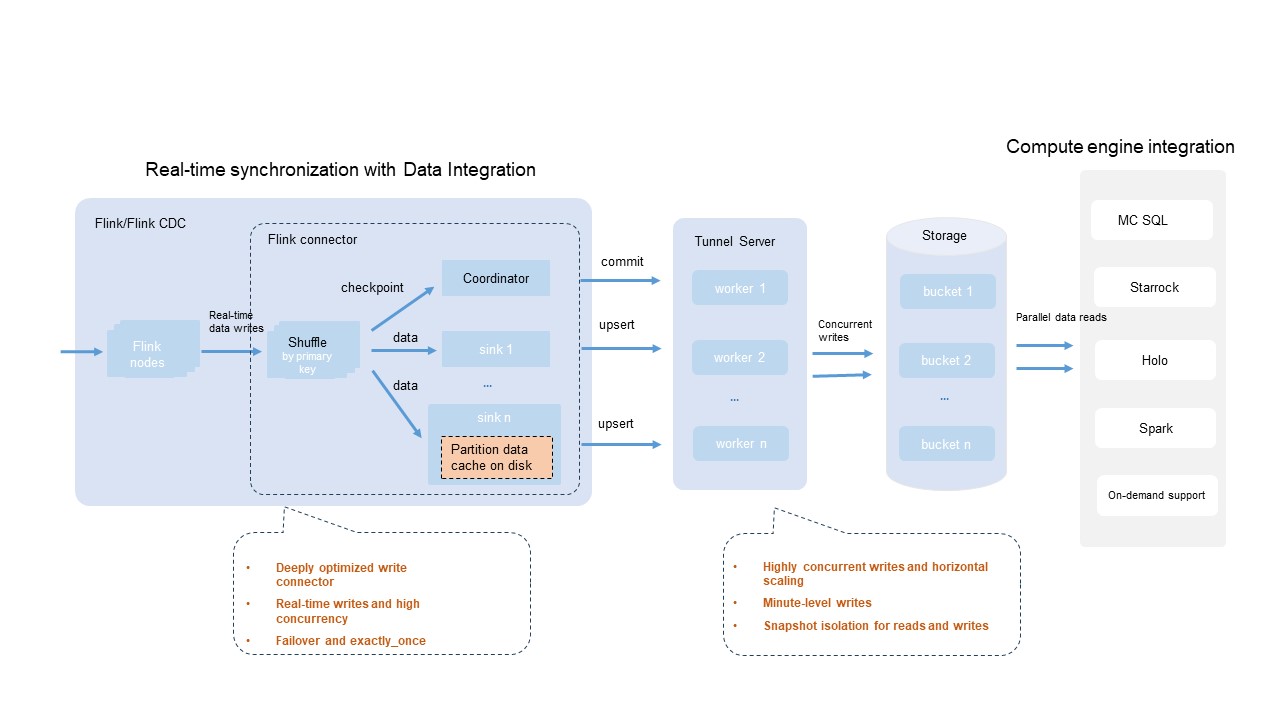
Principais capacidades da integração com o conector Flink:
|
Capacidade |
Descrição |
|
Ampla compatibilidade de engines |
A maioria das engines de computação e ferramentas compatíveis com o ecossistema Flink suporta implantações Flink que usam o conector Flink do MaxCompute para gravar dados em Delta tables em tempo real. |
|
Paralelismo de gravação configurável |
Ajuste o parâmetro |
|
Semântica exactly-once |
Utiliza o mecanismo nativo de checkpoint do Flink para tolerância a falhas, garantindo que o processamento de dados siga a semântica exactly-once. |
|
Gravação em partições em larga escala |
Suporta gravação simultânea em milhares de partições. |
|
Visibilidade em tempo quase real |
Os dados ficam visíveis em minutos, com isolamento de snapshot para operações de leitura e gravação. |
O throughput de tráfego varia conforme o ambiente e a configuração. Estime o throughput máximo com base na capacidade de processamento de um único bucket (1 MB/s). O grupo de recursos compartilhados do Tunnel é usado por padrão no MaxCompute Tunnel, o que pode causar instabilidade no throughput sob forte contenção de recursos. Também existem limites impostos ao consumo de recursos.
Sincronização de dados em tempo real de bancos de dados usando DataWorks Data Integration
Muitos sistemas de produção combinam processamento de transações online (OLTP), processamento analítico online (OLAP) e engines de análise offline. Um workflow comum é sincronizar novos registros de uma única tabela ou de um banco de dados inteiro para o MaxCompute em tempo real para análise.
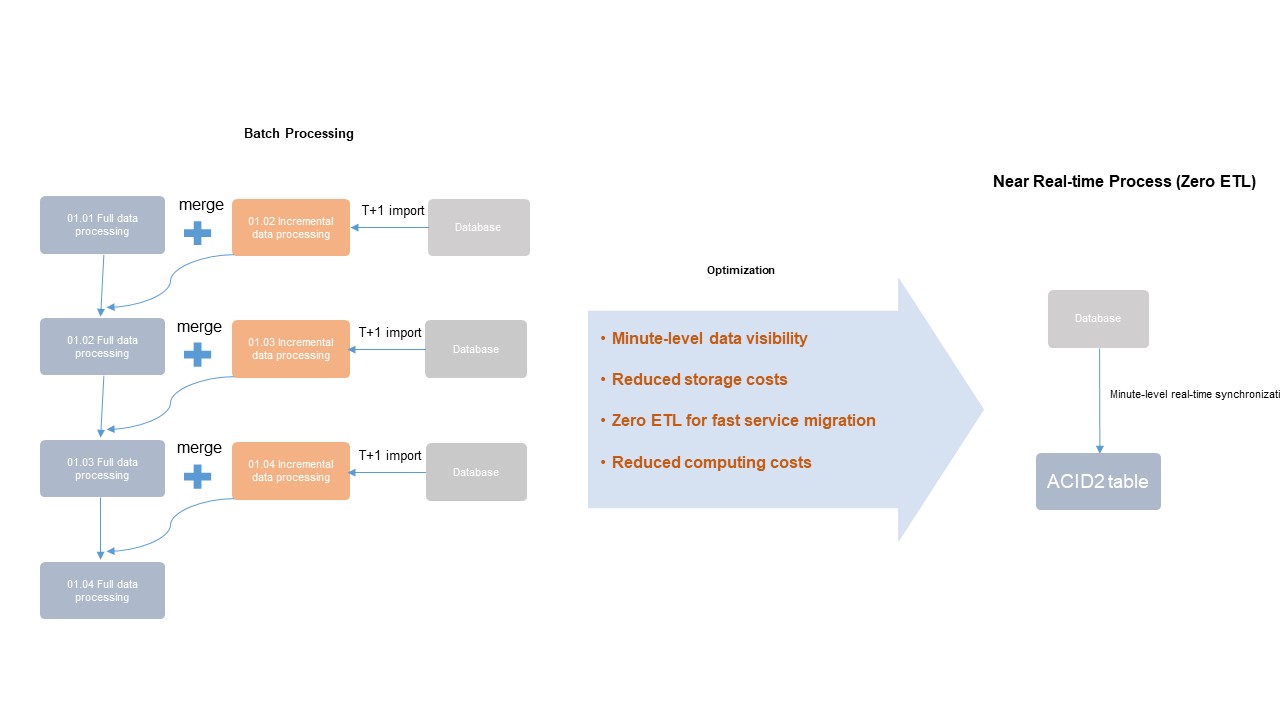
A figura acima contrasta duas abordagens:
Esquerda (processamento em lote): Dados incrementais são importados para uma nova tabela ou partição ao longo de horas ou dias. Um processo ETL offline une e mescla os dados incrementais com os dados existentes na tabela. Essa abordagem apresenta alta latência e custos elevados de recursos e armazenamento.
Direita (arquitetura integrada): Novos registros são lidos dos bancos de dados em minutos. Não há necessidade de extração ou mesclagem periódica de dados — as Delta tables lidam diretamente com as atualizações, minimizando os custos de computação e armazenamento.
Processamento em lote usando instruções SQL DML e upserts
Os módulos Compiler, Optimizer e Runtime do engine SQL foram modificados e otimizados para operações com Delta tables. Isso inclui análise de sintaxe, planos de otimização, lógica de deduplicação baseada em chave primária e upserts em runtime para fornecer suporte completo à sintaxe SQL.
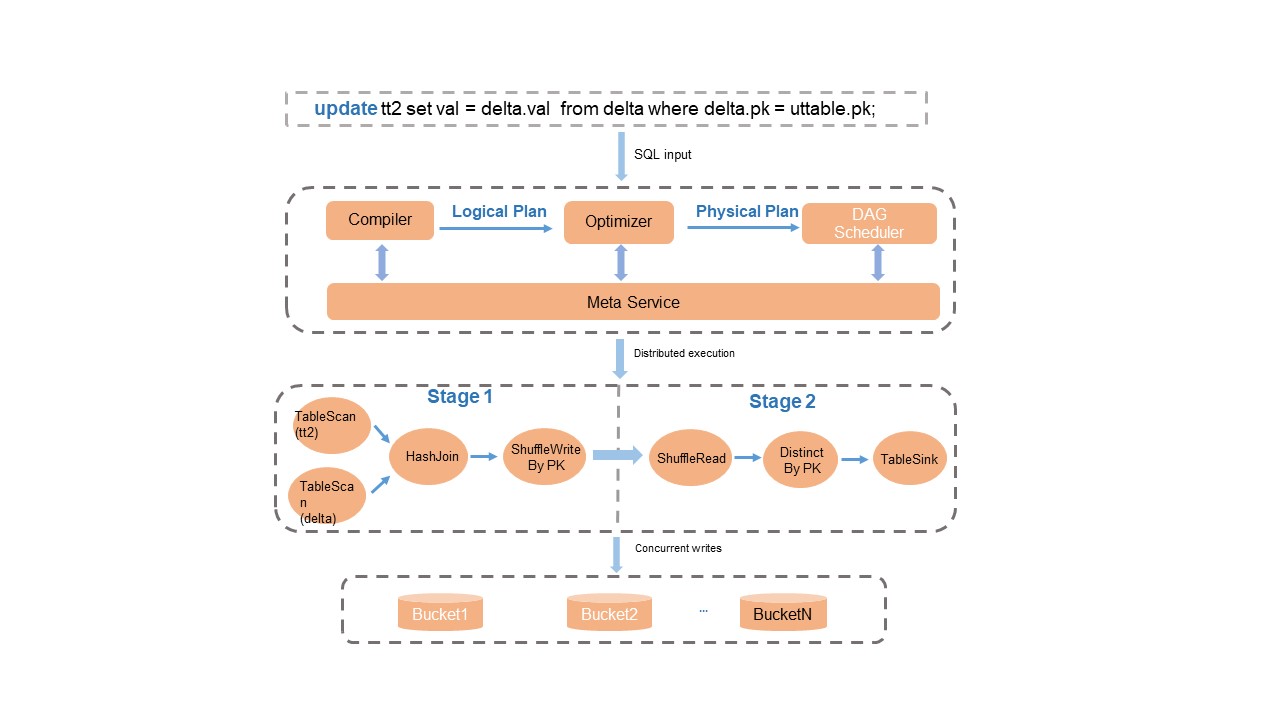
Comportamentos principais:
Consistência transacional: Após a conclusão do processamento de dados, o serviço de metadados realiza detecção de conflitos de transação e atualizações atômicas de metadados, garantindo isolamento de leitura/gravação e consistência transacional.
Upserts simplificados: O sistema mescla automaticamente os registros com base nas chaves primárias durante consultas em Delta tables. Para cenários que misturam operações INSERT e UPDATE, use
INSERT INTOem vez de sintaxes complexas comoUPDATEouMERGE INTO. Isso reduz o I/O de leitura e economiza recursos de computação.
Para a sintaxe completa de SQL DML, consulte Operações DML.
Consultas de dados
Consultas time travel
As consultas time travel permitem consultar versões históricas de uma Delta table. Os casos de uso comuns incluem:
Recuperação de dados: Restaurar dados para uma versão histórica específica após modificação ou exclusão acidental.
Rastreamento histórico: Auditar ou reanalisar dados de negócios de um ponto anterior no tempo.
Exemplos de consultas:
-- Query historical data at a specific timestamp.
SELECT * FROM tt2 TIMESTAMP AS OF '2024-04-01 01:00:00';
-- Query historical data from 5 minutes before the current time.
SELECT * FROM tt2 TIMESTAMP AS OF CURRENT_TIMESTAMP() - 300;
-- Query historical data from the second-to-last commit.
SELECT * FROM tt2 TIMESTAMP AS OF GET_LATEST_TIMESTAMP('tt2', 2);
A figura a seguir ilustra o funcionamento de uma consulta time travel:
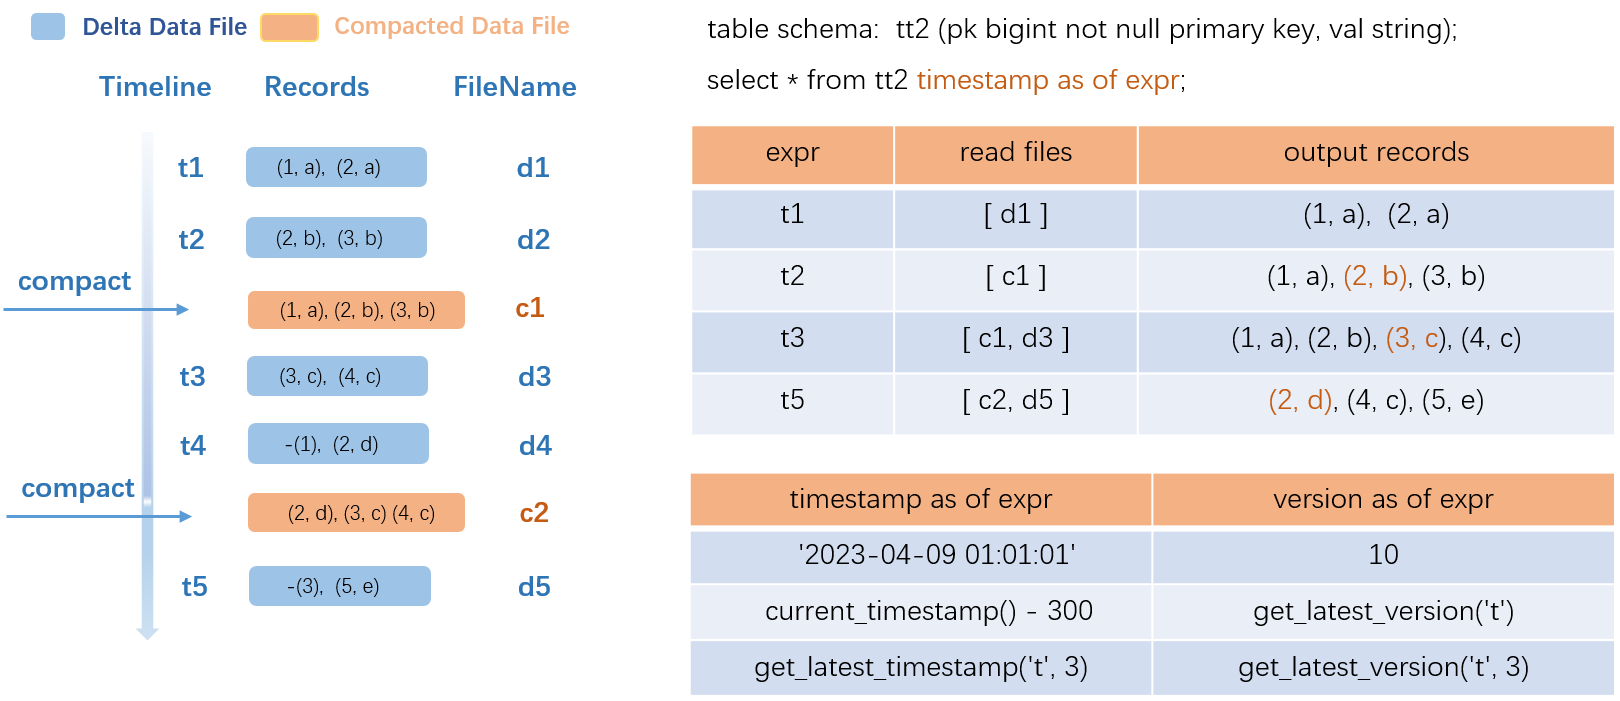
O exemplo utiliza uma tabela transacional chamada src:
Lado esquerdo (processo de atualização de dados): As transações t1 a t5 geram, cada uma, um arquivo de dados delta. A COMPACTION é executada em t2 e t4, produzindo os arquivos compactados c1 e c2. Em c1, o registro histórico intermediário
(2,a)é excluído e o registro mais recente(2,b)é retido.Resolução da consulta: Para consultar dados históricos em t1, o sistema lê apenas o arquivo delta d1. Para consultar em t2, ele lê o arquivo compactado c1 e retorna três registros. Para consultar em t3, ele lê c1 e o arquivo delta d3, mesclando-os para a saída. Execuções mais frequentes de COMPACTION aceleram as consultas, mas aumentam a sobrecarga operacional. Escolha uma política de acionamento adequada aos seus requisitos.
A sintaxe SQL suporta constantes, funções comuns e as cláusulas TIMESTAMP AS OF expr e VERSION AS OF expr para consultas históricas precisas. Para detalhes, consulte Consultas time travel.
Consultas incrementais
O MaxCompute projeta e desenvolve uma nova sintaxe de consulta incremental SQL para otimizar consultas incrementais e computação incremental em Delta tables. Após o envio de uma instrução de consulta incremental SQL, o engine do MaxCompute analisa as versões históricas de dados incrementais a serem consultadas, recupera os arquivos de dados compactados relevantes, mescla os dados dos arquivos e retorna a saída.
A figura a seguir mostra o processo de consulta incremental:
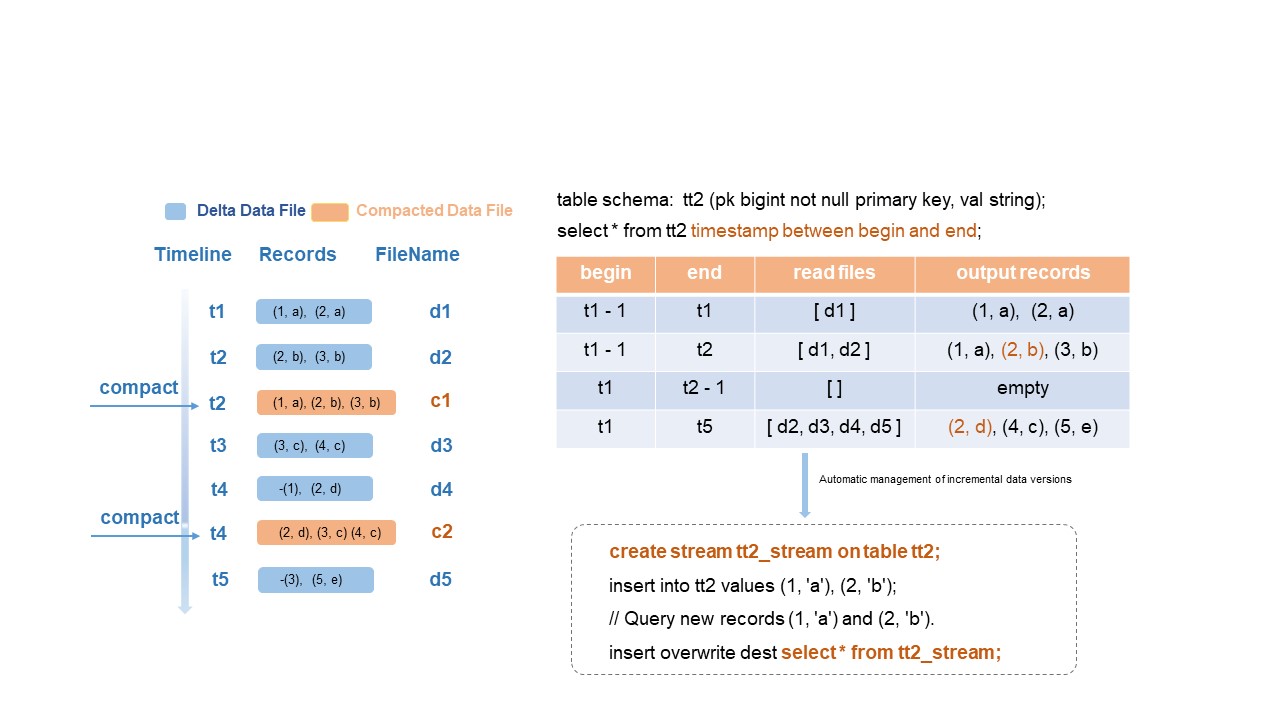
O exemplo usa a mesma tabela transacional src com as transações t1 a t5 e os arquivos compactados c1 (em t2) e c2 (em t4):
Se
beginfor t1-1 eendfor t1, o sistema lê apenas o arquivo delta d1 em t1.Se
endfor t2, o sistema lê os arquivos delta d1 e d2.Se
beginfor t1 eendfor t2-1, o intervalo da consulta abrange de t1 a t2. Como não existem dados incrementais nesse intervalo, linhas vazias são retornadas.
Os dados nos arquivos compactados c1 e c2 gerados pela COMPACTION não são considerados novos dados para a saída da consulta incremental.
Para a sintaxe de consulta incremental e limites de parâmetros, consulte a seção "Parâmetros e limites de consultas incrementais" em Consultas time travel e consultas incrementais.
Data skipping otimizado baseado em chave primária
A distribuição de dados e os índices das Delta tables são construídos com base nos valores das colunas de chave primária. Ao consultar por chave primária, o sistema aplica filtros em vários níveis para reduzir significativamente a leitura de dados, melhorando a eficiência da consulta em centenas a milhares de vezes.
Exemplo: Uma Delta table contém 100 milhões de registros. Filtrar por um único valor de chave primária pode exigir a leitura de apenas 10.000 registros.
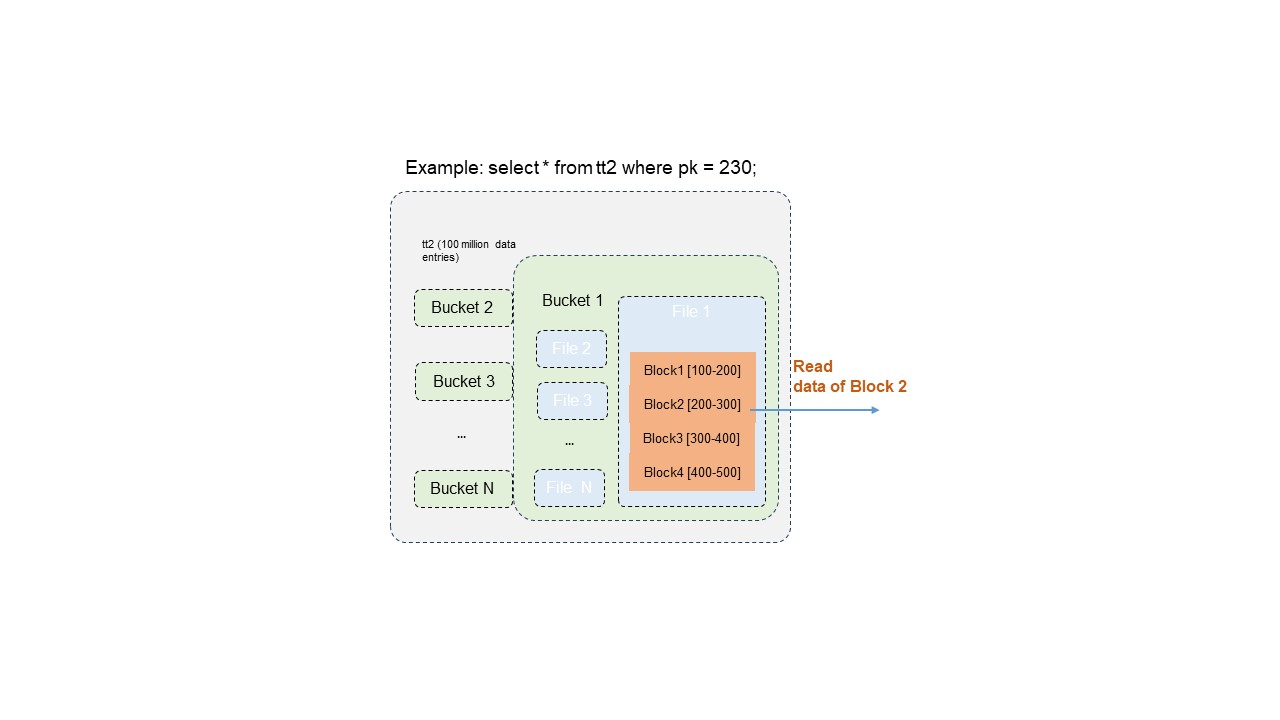
O processo de filtragem em três níveis:
Poda de buckets (Bucket pruning): Localiza o bucket que contém a chave primária alvo, eliminando varreduras em todos os outros buckets.
Poda de arquivos de dados: Dentro do bucket alvo, identifica apenas os arquivos de dados que contêm o valor da chave primária.
Filtragem de intervalo no nível de bloco: Aplica filtragem precisa com base na distribuição de valores da chave primária dentro dos blocos de arquivo, extraindo apenas os blocos que contêm o valor alvo.
Planos de consulta e análise SQL otimizados
Cada bucket em uma Delta table armazena dados únicos e ordenados pelo valor da chave primária. O Otimizador SQL aproveita essas propriedades para eliminar operações custosas:
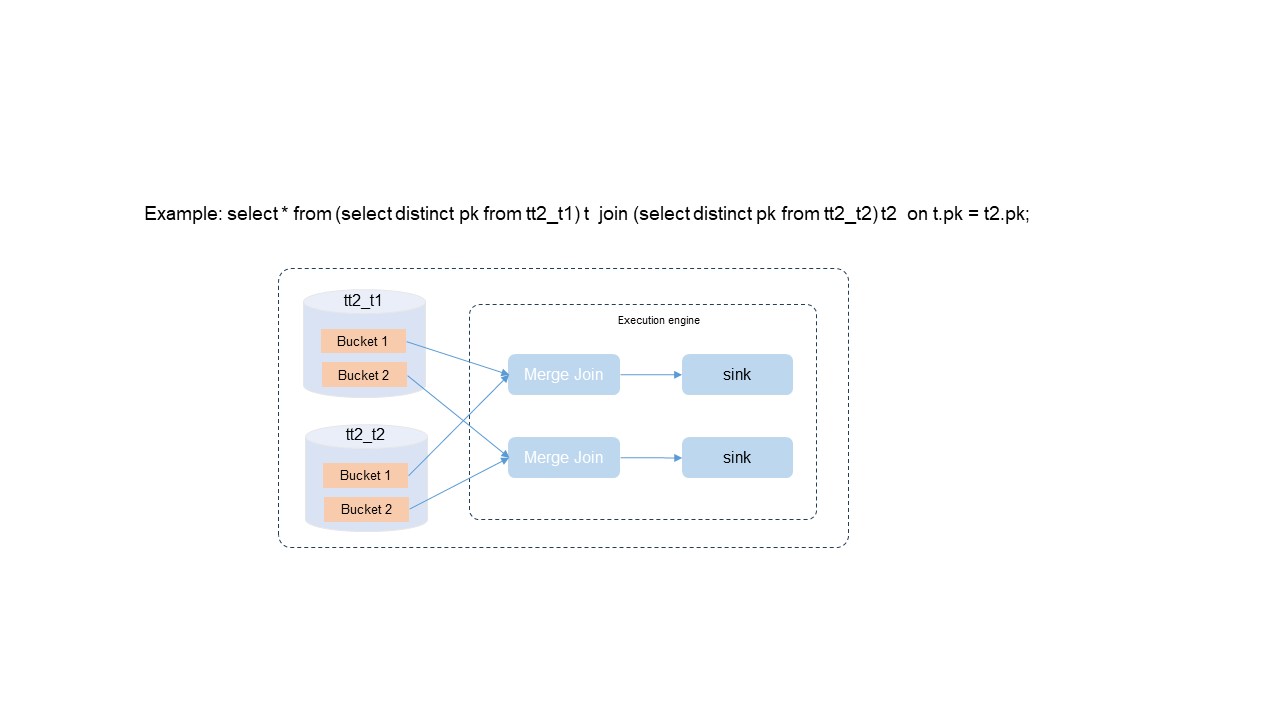
|
Otimização |
Funcionamento |
Benefício |
|
Eliminação de DISTINCT |
A unicidade da chave primária garante que não haja duplicatas, permitindo que o otimizador ignore completamente a operação DISTINCT. |
Remove sobrecarga desnecessária de computação. |
|
Join local no bucket |
Quando a chave de join corresponde à chave primária, o otimizador selecione uma política de join local no bucket em vez de um shuffle global. |
Reduz a troca de dados em larga escala entre nós, diminuindo o consumo de recursos e melhorando o throughput. |
|
Merge join sem ordenação |
Os dados em cada bucket já estão ordenados pela chave primária. O otimizador usa um algoritmo de merge join em vez de pré-ordenação. |
Simplifica a computação e economiza recursos de processamento. |
Após eliminar DISTINCT, ordenação e shuffle global, o desempenho da consulta melhora em 100%.