Este tópico descreve os desafios de negócios que a solução de data warehouse quase em tempo real resolve e suas principais características arquiteturais.
Informações de fundo
Com o aumento da complexidade nos cenários de processamento de dados, muitos casos de uso já não exigem a exibição de dados atualizados em segundos ou atualizações no nível de linha. Em vez disso, há uma demanda por processamento quase em tempo real com granularidade de minutos ou horas, combinado ao processamento em lote de grandes volumes de dados. O MaxCompute oferece as tabelas Delta para atender aos requisitos de armazenamento e processamento de dados completos e incrementais quase em tempo real.
Análise da situação atual
Em cenários de negócios com baixa exigência de latência, nos quais é necessário processar grandes volumes de dados em lote, o MaxCompute atende plenamente aos requisitos. Já em situações que demandam alta tempestividade, como processamento de dados em tempo real no nível de segundos ou processamento de streaming, é indispensável utilizar um sistema dedicado a dados em tempo real ou um sistema de streaming. No entanto, em cenários abrangentes — que combinam processamento quase em tempo real (minutos ou horas) com processamento em lote de grandes volumes — podem surgir problemas específicos, independentemente do uso de um único mecanismo ou de múltiplos mecanismos federados.
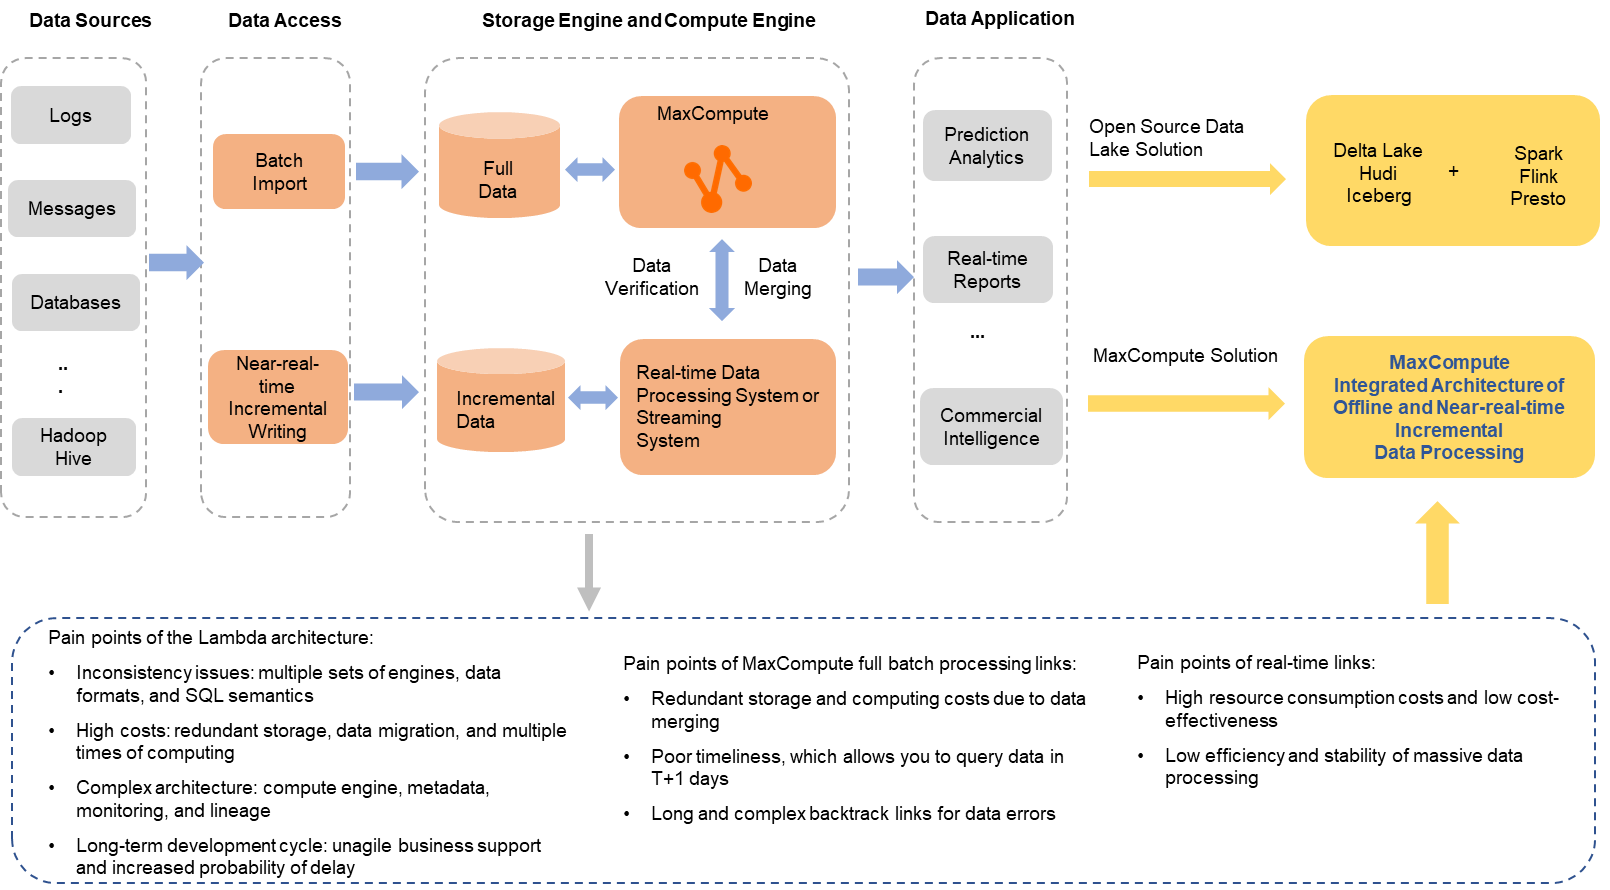
Conforme ilustra a figura anterior, o uso exclusivo do MaxCompute para processamento em lote pode gerar dificuldades em determinados contextos. Por exemplo, ao mesclar e armazenar continuamente dados incrementais e completos de usuários no nível de minutos, os custos de computação e armazenamento aumentam significativamente. Além disso, quando fluxos e lógicas complexas de processamento precisam ser convertidos para lotes com periodicidade T+1, a complexidade operacional cresce e a tempestividade deixa de atender às expectativas do negócio. Por outro lado, adotar apenas um sistema de processamento em tempo real nesses mesmos cenários resulta em alto consumo de recursos, baixa eficiência de custos e instabilidade no processamento em lote de grande escala. A arquitetura Lambda surge frequentemente como alternativa, utilizando o MaxCompute para processar dados completos em lote e um sistema em tempo real para dados incrementais. Contudo, essa abordagem traz problemas conhecidos: inconsistência de dados entre diferentes mecanismos de processamento e armazenamento, custos adicionais decorrentes da redundância de armazenamento e computação, complexidade arquitetural elevada e ciclos longos de desenvolvimento.
Para solucionar essas questões, o ecossistema open source de big data lançou diversas alternativas nos últimos anos. A mais adotada integra profundamente mecanismos de processamento como Spark, Flink ou Presto a data lakes open source como Hudi, Delta Lake e Iceberg, unificando computação e armazenamento. Essa estratégia mitiga vários problemas da arquitetura Lambda. Com base na estrutura do MaxCompute, foi desenvolvida uma arquitetura de armazenamento e processamento de dados incrementais que oferece uma solução integrada para processamento em lote e processamento incremental quase em tempo real. Ela preserva a relação custo-benefício do processamento em lote e atende aos requisitos de leitura, escrita e processamento de dados incrementais no nível de minutos. Recursos práticos como a operação UPSERT e o Time Travel ampliam os casos de uso, reduzindo custos de computação, armazenamento e migração de dados, além de melhorar a experiência do usuário.
Arquitetura quase em tempo real do MaxCompute
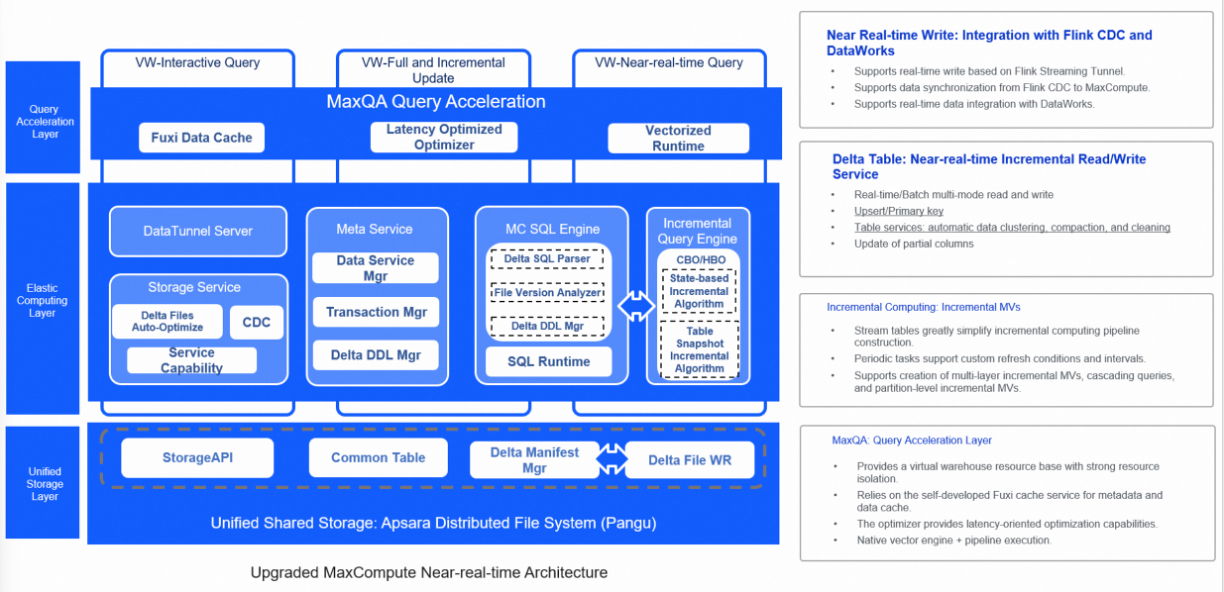
A figura acima apresenta a nova arquitetura que permite ao MaxCompute suportar eficientemente os cenários abrangentes mencionados. Nela, o MaxCompute aceita diversas fontes de dados, facilitando a ingestão de dados incrementais e completos em um armazenamento unificado por meio de ferramentas de acesso personalizadas. Um service de gerenciamento de dados em segundo plano otimiza automaticamente a estrutura de armazenamento. Um mecanismo de computação unificado suporta tanto o processamento incremental quase em tempo real quanto o processamento em lote de grande escala, enquanto um service de metadados unificado gerencia transações e metadados de arquivos. Essa nova arquitetura elimina problemas comuns ao uso isolado de sistemas em lote — como redundância de computação e armazenamento e baixa tempestividade —, evita o alto consumo de recursos típico de sistemas em tempo real ou de streaming, resolve inconsistências de dados inerentes à arquitetura Lambda e reduz custos com armazenamento redundante e migração entre sistemas.
Essa arquitetura integrada de ponta a ponta atende aos requisitos de otimização de computação e armazenamento para processamento incremental com tempestividade no nível de minutos, mantém a eficiência global do processamento em lote e reduz efetivamente os custos de recursos.
Recursos principais
O data warehouse quase em tempo real do MaxCompute oferece três funcionalidades essenciais: a MC Delta Table, que permite ingestão de dados no nível de minutos; capacidades de computação incremental, que equilibram melhor latência e throughput; e o MCQA2.0 recém-atualizado, que proporciona respostas a consultas no nível de segundos.
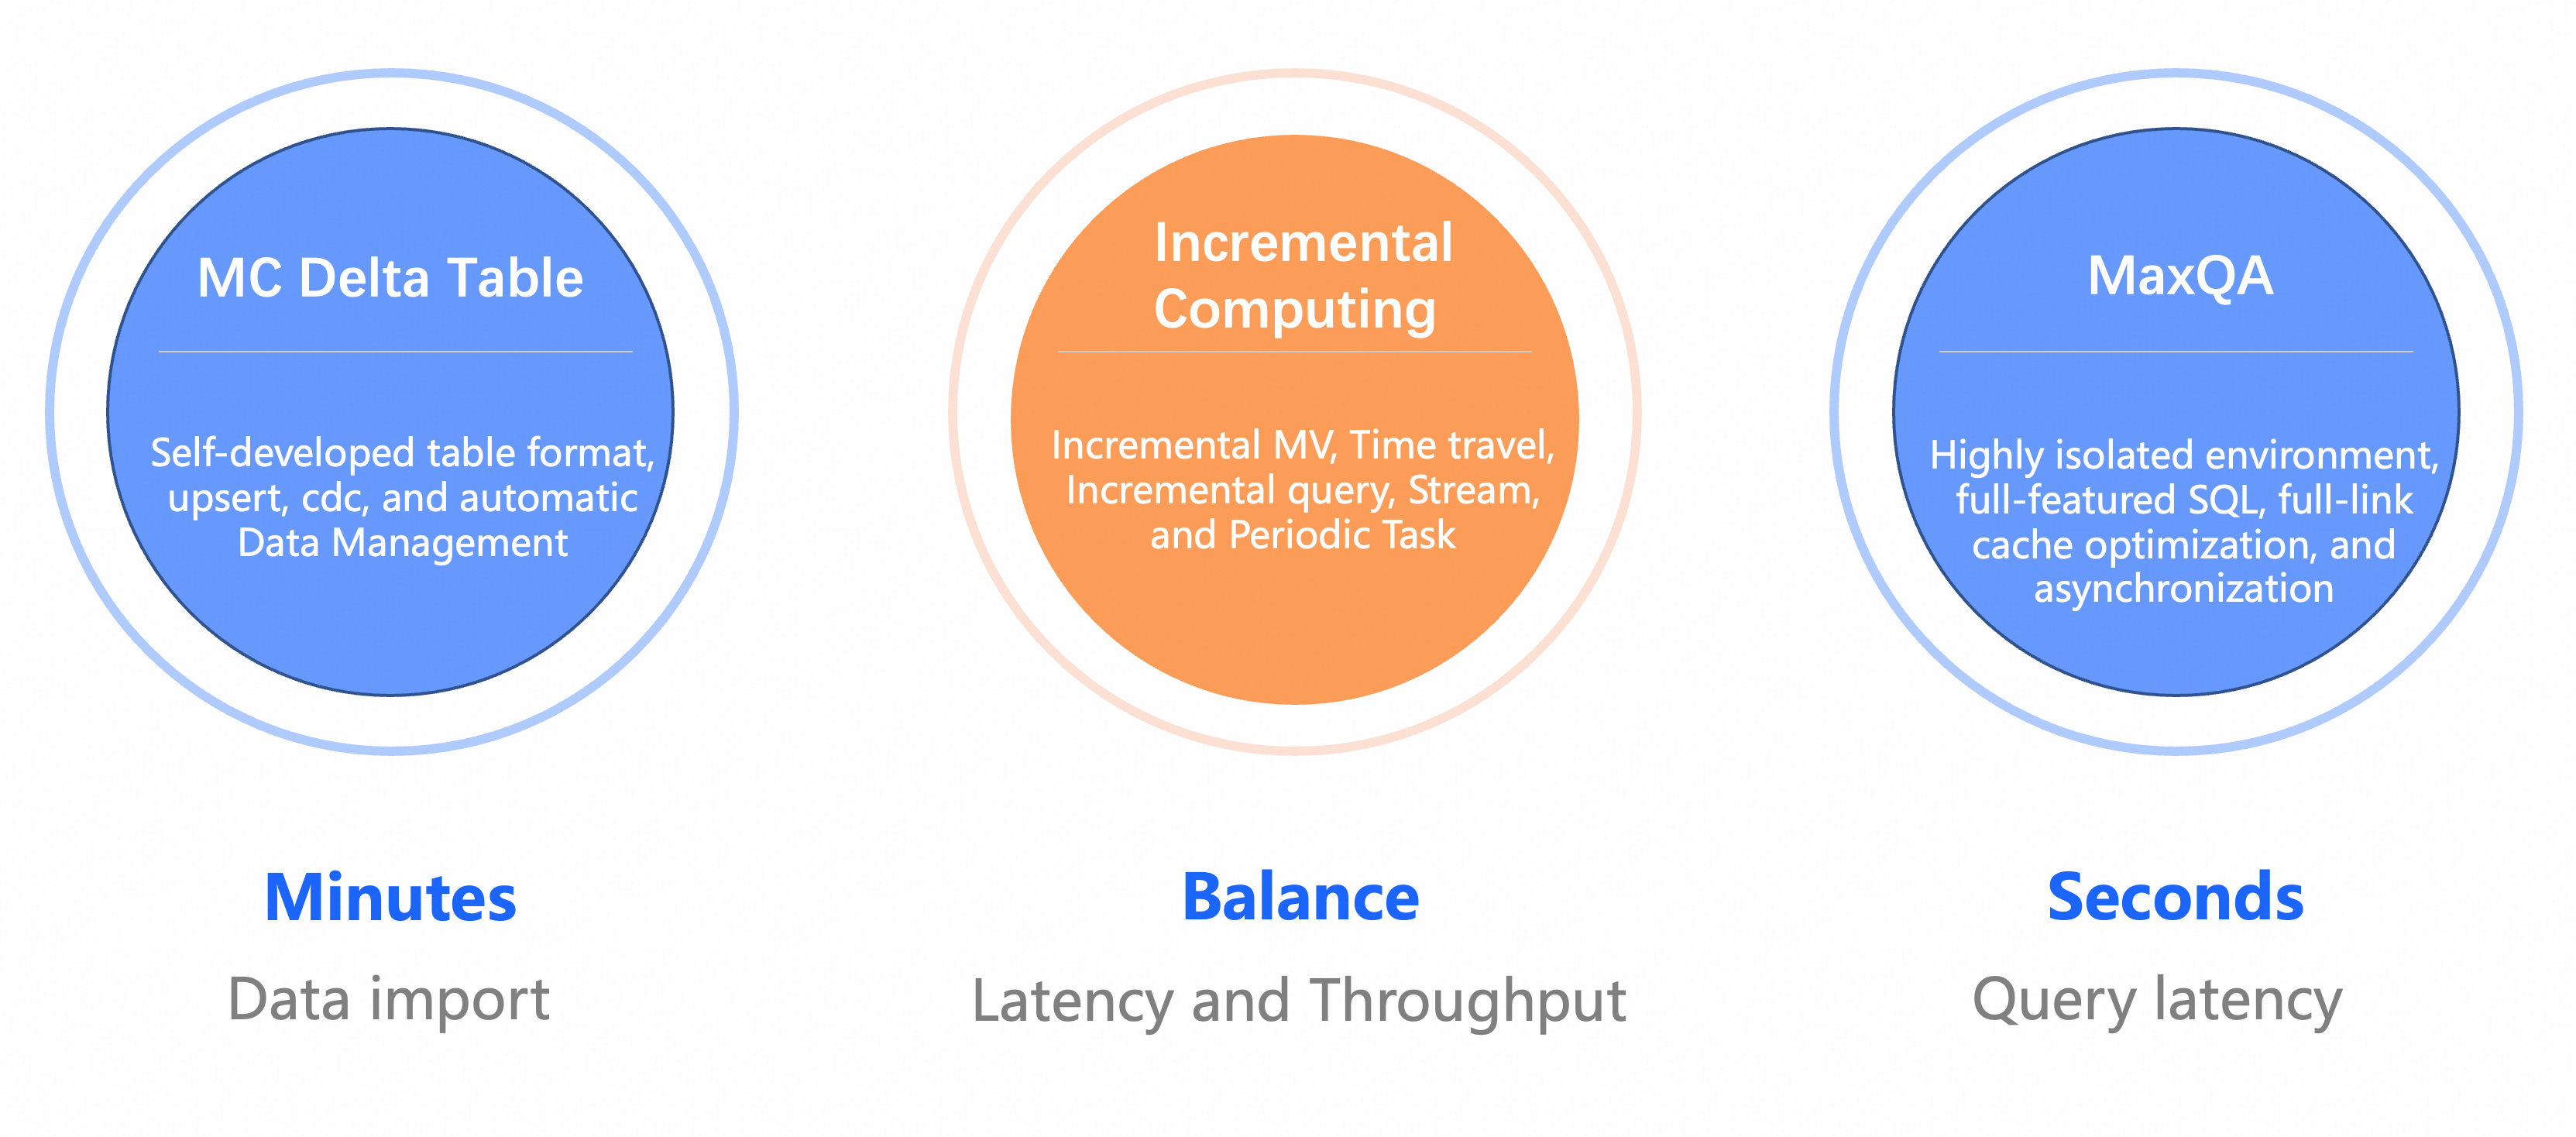
Os três recursos principais são:
Formato Delta Table: Permite a ingestão de dados no nível de minutos. Utiliza AliORC como formato de arquivo subjacente, suporta semântica UPSERT e oferece métodos padrão de CDC (Change Data Capture) para leitura e escrita de dados incrementais. Depende do service de armazenamento e do service global de metadados do MaxCompute para o gerenciamento automático dos dados.
Computação incremental: Baseado no formato Delta Table, o MaxCompute adicionou uma série de capacidades de computação incremental, como materialized views incrementais, Time Travel e Stream Table. As materialized views incrementais e as tarefas agendadas periodicamente oferecem diferentes frequências de acionamento, proporcionando mais opções para equilibrar latência e throughput.
Aceleração de consultas MCQA2.0: Representa uma atualização completa da aceleração de consultas do MaxCompute. Melhora a estabilidade do desempenho por meio de um ambiente fortemente isolado e estende o suporte do MCQA 1.0 — antes restrito a consultas DQL SELECT — para toda a funcionalidade SQL, incluindo DDL e DML. O desempenho é ainda mais aprimorado com cache de ponta a ponta e métodos de otimização, como o processamento assíncrono de múltiplas etapas no pipeline de submissão de jobs.
Mais importante ainda, essas novas capacidades foram construídas e implementadas sobre o mecanismo SQL original do MaxCompute. Os usuários podem analisar volumes massivos de dados com maior custo-benefício sem precisar alterar seus hábitos de desenvolvimento.
Benefícios
Para suportar cenários de negócios e migrações provenientes dos data lakes open source Hudi e Iceberg, a nova arquitetura disponibiliza recursos comuns específicos. Sendo uma arquitetura proprietária desenvolvida internamente, ela também entrega os seguintes benefícios em termos de funcionalidade, desempenho, estabilidade e integração:
Oferece design unificado para armazenamento, metadados e mecanismos de computação, garantindo integração profunda e eficiente. Isso resulta em baixos custos de armazenamento, gerenciamento eficaz de arquivos de dados e alta eficiência nas consultas. Além disso, diversas regras de otimização de consultas em lote do MaxCompute podem ser reutilizadas pelo Time Travel e pelas consultas incrementais.
Disponibiliza um conjunto completo e unificado de sintaxe SQL para suportar todos os recursos da nova arquitetura, simplificando a operação pelos usuários.
Inclui ferramentas de ingestão de dados profundamente personalizadas e otimizadas para atender a diversos cenários de negócios complexos.
Integra-se perfeitamente aos cenários de negócios existentes no MaxCompute, reduzindo custos de migração, armazenamento e computação.
Gerencia arquivos de dados automaticamente, assegurando maior estabilidade nas operações de leitura e escrita, além de otimizar a eficiência e os custos de armazenamento de forma autônoma.
É totalmente gerenciado no MaxCompute. Você pode utilizar a nova arquitetura imediatamente, sem custos adicionais de acesso. Basta crie uma tabela Delta para aproveitar todos os recursos.
Trata-se de uma arquitetura desenvolvida internamente, permitindo que você adapte o desenvolvimento de dados às necessidades específicas do seu negócio com total autonomia.