O recurso de processamento vetorial do Hologres é ideal para buscas por similaridade, recuperação de imagens e reconhecimento de cenas. Ele aprimora o processamento e a análise de dados, permitindo capacidades de busca e recomendação mais precisas. Este tópico descreve como usar o Proxima para processamento vetorial no Hologres e fornece um exemplo completo.
Procedimento
-
Conecte-se a uma instância do Hologres.
Use uma ferramenta de desenvolvimento para conectar-se à instância do Hologres. Para mais informações, consulte Conectar a uma ferramenta de desenvolvimento. Se utilizar JDBC, adote o modo
PreparedStatement. -
Instale a extensão Proxima.
O Proxima conecta-se ao Hologres como uma extensão. Antes de usá-lo, um superusuário deve executar o comando abaixo para instalar a extensão Proxima.
--Install the Proxima extension.
CREATE EXTENSION proxima;
A instalação da extensão Proxima ocorre no nível do banco de dados. Instale-a apenas uma vez por banco de dados. Para desinstalar a extensão, execute o seguinte comando:
DROP EXTENSION proxima;ImportanteNão use o comando
DROP EXTENSION <extension_name> CASCADE;para desinstalar uma extensão. A opçãoCASCADEexclui a extensão especificada e remove todos os dados associados, como PostGIS, RoaringBitmap, Proxima, Binlog e BSI, além de quaisquer objetos dependentes da extensão, incluindo metadados, tabelas, visualizações e dados do servidor. -
Crie uma tabela vetorial e um índice vetorial.
No Hologres, vetores são geralmente representados como arrays do tipo
FLOAT4. A sintaxe para criar uma tabela vetorial é apresentada a seguir.NotaÍndices vetoriais têm suporte apenas em tabelas orientadas a colunas e tabelas híbridas linha-coluna. Tabelas orientadas a linhas não são suportadas.
Ao definir um vetor, defina a dimensão do array como
1. O segundo parâmetro tanto dearray_ndimsquanto dearray_lengthdeve ser definido como1.A partir do Hologres V2.0.11, é possível importar dados antes de criar o índice vetorial. Essa abordagem reduz o tempo de criação do índice, pois elimina a necessidade de construí-lo durante a compactação de arquivos.
-
Criar o índice vetorial antes da importação de dados: método adequado para cenários de dados em tempo real.
--Set a single index BEGIN; CREATE TABLE feature_tb ( id BIGINT, feature_col FLOAT4[] CHECK(array_ndims(feature_col) = 1 AND array_length(feature_col, 1) = <value>) --Define a vector ); CALL set_table_property( 'feature_tb', 'proxima_vectors', '{"<feature_col>":{"algorithm":"Graph", "distance_method":"<value>", "builder_params":{"min_flush_proxima_row_count" : 1000, "min_compaction_proxima_row_count" : 1000, "max_total_size_to_merge_mb" : 2000}}}'); --Build a vector index COMMIT; --Set multiple indexes BEGIN; CREATE TABLE t1 ( f1 INT PRIMARY KEY, f2 FLOAT4[] NOT NULL CHECK(array_ndims(f2) = 1 AND array_length(f2, 1) = 4), f3 FLOAT4[] NOT NULL CHECK(array_ndims(f3) = 1 AND array_length(f3, 1) = 4) ); CALL set_table_property( 't1', 'proxima_vectors', '{"f2":{"algorithm":"Graph", "distance_method":"InnerProduct", "builder_params":{"min_flush_proxima_row_count" : 1000, "min_compaction_proxima_row_count" : 1000, "max_total_size_to_merge_mb" : 2000}}, "f3":{"algorithm":"Graph", "distance_method":"InnerProduct", "builder_params":{"min_flush_proxima_row_count" : 1000, "min_compaction_proxima_row_count" : 1000, "max_total_size_to_merge_mb" : 2000}}}'); COMMIT; -
Importar dados antes da criação do índice vetorial: recomendado para cenários de análise offline.
NotaA partir do Hologres V2.1.17, há suporte para Serverless Computing. Em situações como importação offline de grandes conjuntos de dados vetoriais ou consultas vetoriais em larga escala, use o Serverless Computing para aproveitar recursos serverless adicionais. Essa estratégia evita o consumo dos recursos da própria instância, melhorando significativamente sua estabilidade e reduzindo o risco de erros de falta de memória (OOM). A cobrança ocorre apenas pela tarefa executada. Para mais detalhes sobre o Serverless Computing, consulte Serverless Computing. Para saber como usar esse recurso, veja Usar Serverless Computing.
--Set a single index
BEGIN;
CREATE TABLE feature_tb (
    id BIGINT,
    feature_col FLOAT4[] CHECK(array_ndims(feature_col) = 1 AND array_length(feature_col, 1) = <value>) --Define a vector
);
COMMIT;
-- (Optional) We recommend using Serverless Computing for large-scale offline imports and ETL.
SET hg_computing_resource = 'serverless';
-- Import data
INSERT INTO feature_tb ...;
VACUUM feature_tb;
-- Build the vector index
CALL set_table_property(
'feature_tb',
'proxima_vectors',
'{"<feature_col>":{"algorithm":"Graph",
"distance_method":"<value>",
"builder_params":{"min_flush_proxima_row_count" : 1000,
"min_compaction_proxima_row_count" : 1000,
"max_total_size_to_merge_mb" : 2000}}}');
-- Reset the configuration to ensure that non-essential SQL statements do not use serverless resources.
RESET hg_computing_resource;
A tabela a seguir descreve os parâmetros.
Categoria
Parâmetro
Descrição
Exemplo
Propriedades básicas do vetor
feature_col
Nome da coluna vetorial.
feature
array_ndims
Dimensão do vetor. Apenas vetores unidimensionais são suportados.
O exemplo abaixo mostra como criar um vetor unidimensional com comprimento 4.
feature float4[] check(array_ndims(feature) = 1 and array_length(feature, 1) = 4)array_length
Comprimento do vetor. O valor máximo é 1.000.000.
Configurações do índice vetorial
proxima_vectors
Especifica as propriedades do índice vetorial. Trata-se de uma string JSON contendo os seguintes parâmetros:
-
algorithm: algoritmo usado para construir o índice vetorial. Atualmente, apenas
Graphé suportado. -
distance_method: função de distância usada na construção do índice vetorial. As seguintes funções são suportadas:
-
(Recomendado)
SquaredEuclidean: calcula a distância euclidiana ao quadrado. Oferece o melhor desempenho de consulta e é adequada para consultas que usam a funçãopm_approx_squared_euclidean_distance. -
Euclidean: calcula a distância euclidiana. Indicada apenas para consultas que usam a funçãopm_approx_euclidean_distance. -
(Use com cautela)
InnerProduct: calcula a distância por produto interno. Internamente, esse cálculo converte-se em uma distância euclidiana envolvendo raiz quadrada. Tal conversão adiciona sobrecarga computacional tanto na criação do índice quanto nas consultas, reduzindo a eficiência. Evite essa função, a menos que seu caso de negócio exija. Ela é adequada apenas para consultas que usam a funçãopm_approx_inner_product_distance.
-
-
builder_params: string no formato JSON que especifica parâmetros para controlar o processo de construção do índice. Inclui os seguintes itens:-
min_flush_proxima_row_count: número mínimo de linhas necessário para construir um índice quando os dados são liberados para o disco. Valor recomendado: 1.000. -
min_compaction_proxima_row_count: número mínimo de linhas necessário para construir um índice durante a compactação de dados no disco. Valor recomendado: 1.000. -
max_total_size_to_merge_mb: tamanho máximo dos arquivos a serem mesclados durante a compactação de dados, em megabytes (MB). Valor recomendado: 2.000.
-
-
proxima_builder_thread_count: quantidade de threads usadas para construir o índice vetorial durante a gravação de dados. O valor padrão é 4. Geralmente, não é necessário alterar esse valor.
NotaO exemplo a seguir demonstra como criar um índice vetorial para consultas baseadas na distância euclidiana ao quadrado.
call set_table_property( 'feature_tb', 'proxima_vectors', '{"feature":{"algorithm":"Graph", "distance_method":"SquaredEuclidean", "builder_params":{"min_flush_proxima_row_count" : 1000, "min_compaction_proxima_row_count" : 1000, "max_total_size_to_merge_mb" : 2000}}}'); -
Importe dados vetoriais.
É possível importar dados para a tabela vetorial em modo offline ou em tempo real. Após uma importação em lote, execute os comandos
VACUUMeANALYZEpara melhorar o desempenho das consultas.-
O comando
VACUUMaumenta a eficiência das consultas ao compactar arquivos de backend em arquivos maiores. Esse processo consome recursos de CPU e sua duração cresce conforme o tamanho da tabela. Se houver um processoVACUUMem execução, aguarde sua conclusão.VACUUM <tablename>; -
O comando
ANALYZEcoleta estatísticas que o Query Optimizer (QO) usa para gerar planos de execução mais eficientes.analyze <tablename>;
-
-
Consulte dados vetoriais.
O Hologres suporta consultas de correspondência exata e consultas de correspondência aproximada. Funções definidas pelo usuário (UDFs) com o prefixo
pm_realizam consultas de correspondência exata, enquanto UDFs com o prefixopm_approx_executam consultas de correspondência aproximada. Somente consultas de correspondência aproximada podem usar um índice vetorial. Para cenários em que um índice vetorial foi criado, recomenda-se o uso de consultas de correspondência aproximada para obter melhor desempenho. Um índice vetorial só pode ser usado em consultas de tabela única. Priorize consultas vetoriais em tabelas únicas e evite operações de junção (join).-
Consultas de correspondência aproximada (usando índice vetorial)
Consultas aproximadas conseguem acessar o índice vetorial e são mais adequadas para cenários que exigem varredura de grandes volumes de dados com alta eficiência de execução. Por padrão, a precisão de recall é de 99% ou superior. Para usar o índice vetorial, basta adicionar o prefixo
approx_à função de cálculo de distância correspondente. As funções de cálculo de distância disponíveis são:NotaPara consultas de correspondência aproximada usando distância euclidiana ao quadrado e distância euclidiana, o índice vetorial é usado apenas quando
ORDER BY distance ASCé especificado. A ordem decrescente não é suportada.Para consultas de correspondência aproximada usando distância por produto interno, o índice vetorial é usado apenas quando
ORDER BY distance DESCé especificado. A ordem crescente não é suportada.
FLOAT4 pm_approx_squared_euclidean_distance(FLOAT4[], FLOAT4[])
FLOAT4 pm_approx_euclidean_distance(FLOAT4[], FLOAT4[])
FLOAT4 pm_approx_inner_product_distance(FLOAT4[], FLOAT4[])
A função usada na consulta deve corresponder ao parâmetro
distance_methoddoproxima_vectordefinido durante a criação da tabela. O exemplo a seguir mostra como consultar os Top N resultados. Em uma consulta de correspondência aproximada, o segundo parâmetro deve ser um valor constante.NotaConsultas baseadas em índice são lossy, o que pode resultar em alguma perda de precisão. A taxa de recall padrão geralmente fica acima de 99%.
-- Calculate the top K results based on the squared Euclidean distance. The distance_method parameter in the proxima_vector property of the table must be set to SquaredEuclidean. SELECT pm_approx_squared_euclidean_distance(feature, '{0.1,0.2,0.3,0.4}') AS distance FROM feature_tb ORDER BY distance ASC limit 10 ; -- Calculate the top K results based on the Euclidean distance. The distance_method parameter in the proxima_vector property of the table must be set to Euclidean. SELECT pm_approx_euclidean_distance(feature, '{0.1,0.2,0.3,0.4}') AS distance FROM feature_tb ORDER BY distance ASC limit 10 ; -- Calculate the top K results based on the inner product distance. The distance_method parameter in the proxima_vector property of the table must be set to InnerProduct. SELECT pm_approx_inner_product_distance(feature, '{0.1,0.2,0.3,0.4}') AS distance FROM feature_tb ORDER BY distance DESC limit 10 ; -
Consultas de correspondência exata (sem uso de índice vetorial)
Consultas de correspondência exata são indicadas para pequenos conjuntos de dados ou quando uma taxa de recall de 100% é necessária. Os três métodos de cálculo de distância — distância euclidiana, distância euclidiana ao quadrado e distância por produto interno — correspondem às três funções de distância listadas abaixo.
FLOAT4 pm_squared_euclidean_distance(FLOAT4[], FLOAT4[])
FLOAT4 pm_euclidean_distance(FLOAT4[], FLOAT4[])
FLOAT4 pm_inner_product_distance(FLOAT4[], FLOAT4[])
Para encontrar os K vizinhos mais próximos de um vetor alvo, use as seguintes consultas SQL.
NotaOs exemplos a seguir mostram consultas SQL para cálculos de correspondência exata. Durante a execução, o sistema varre todos os vetores na coluna feature, calcula a distância de cada um, ordena os resultados e retorna os 10 primeiros. Essa abordagem é adequada para pequenos conjuntos de dados ou quando uma taxa de recall perfeita é obrigatória.
-- Find the 10 nearest neighbors based on squared Euclidean distance.
SELECT pm_squared_euclidean_distance(feature, '{0.1,0.2,0.3,0.4}') AS distance FROM feature_tb ORDER BY distance ASC limit 10 ;
-- Find the 10 nearest neighbors based on Euclidean distance.
SELECT pm_euclidean_distance(feature, '{0.1,0.2,0.3,0.4}') AS distance FROM feature_tb ORDER BY distance ASC limit 10 ;
-- Find the 10 neighbors with the greatest inner product distance.
SELECT pm_inner_product_distance(feature, '{0.1,0.2,0.3,0.4}') AS distance FROM feature_tb ORDER BY distance DESC limit 10 ;
-
Exemplo completo
O exemplo a seguir demonstra como usar um índice Proxima Graph para encontrar os 40 vizinhos mais próximos em uma tabela de vetores 4-dimensional com 100.000 entradas, com base na distância euclidiana ao quadrado.
-
Crie uma tabela vetorial.
CREATE EXTENSION proxima; BEGIN; -- Create a table group with a shard count of 4. CALL HG_CREATE_TABLE_GROUP ('test_tg_shard_4', 4); CREATE TABLE feature_tb ( id BIGINT, feature FLOAT4[] CHECK (array_ndims(feature) = 1 AND array_length(feature, 1) = 4) ); CALL set_table_property ('feature_tb', 'table_group', 'test_tg_shard_4'); CALL set_table_property ('feature_tb', 'proxima_vectors', '{"feature":{"algorithm":"Graph","distance_method":"SquaredEuclidean","builder_params": {"min_flush_proxima_row_count" : 1000, "min_compaction_proxima_row_count" : 1000, "max_total_size_to_merge_mb" : 2000}}}'); COMMIT; -
Importe dados.
-- (Optional) We recommend using Serverless Computing for large-scale offline imports and ETL. SET hg_computing_resource = 'serverless'; INSERT INTO feature_tb SELECT i, ARRAY[random(), random(), random(), random()]::FLOAT4[] FROM generate_series(1, 100000) i; ANALYZE feature_tb; VACUUM feature_tb; -- Reset the configuration to ensure that non-essential SQL statements do not use serverless resources. RESET hg_computing_resource; -
Execute uma consulta.
-- (Optional) Use Serverless Computing to run large-scale vector query jobs.
SET hg_computing_resource = 'serverless';
SELECT
    pm_approx_squared_euclidean_distance (feature, '{0.1,0.2,0.3,0.4}') AS distance
FROM
    feature_tb
ORDER BY
    distance
LIMIT 40;
-- Reset the configuration to ensure that non-essential SQL statements do not use serverless resources.
RESET hg_computing_resource;
Ajuste de desempenho
-
Cenários para uso de índice vetorial
Para pequenos conjuntos de dados (por exemplo, dezenas de milhares de entradas) ou consultas de baixo volume em instâncias com bons recursos, o cálculo direto sem índice costuma ser suficiente. Considere usar um índice Proxima Graph apenas quando o cálculo direto não atender aos seus requisitos de latência e throughput. Tenha em mente os seguintes pontos:
Índices Proxima são lossy e não garantem a precisão absoluta dos resultados. As distâncias calculadas podem apresentar imprecisões.
Um índice Proxima Graph pode retornar menos resultados do que o solicitado. Por exemplo, uma consulta com
LIMIT 1000pode retornar apenas 500 entradas.O uso de um índice Proxima Graph pode ser complexo.
-
Defina uma contagem de shards adequada
Uma contagem maior de shards resulta em mais arquivos criados para o índice Proxima Graph, o que pode reduzir o throughput das consultas. Recomenda-se definir uma contagem de shards razoável com base nos recursos da sua instância. Como diretriz geral, defina a contagem de shards igual ao número de nós worker. Por exemplo, para uma instância de 64 núcleos, recomenda-se uma contagem de 4 shards. Para reduzir a latência de uma única consulta, diminua a contagem de shards, mas isso degradará o desempenho de gravação.
-- Create a vector table and place it in a table group with a shard count of 4. BEGIN; CALL HG_CREATE_TABLE_GROUP ('test_tg_shard_4', 4); CREATE TABLE proxima_test ( id BIGINT NOT NULL, vectors FLOAT4[] CHECK (array_ndims(vectors) = 1 AND array_length(vectors, 1) = 128), PRIMARY KEY (id) ); CALL set_table_property ('proxima_test', 'proxima_vectors', '{"vectors":{"algorithm":"Graph","distance_method":"SquaredEuclidean","builder_params":{}, "searcher_init_params":{}}}'); CALL set_table_property ('proxima_test', 'table_group', 'test_tg_shard_4'); COMMIT; -
(Recomendado) Consultas sem condições de filtro
O uso de uma cláusula
WHEREpode impactar negativamente o uso do índice e resultar em pior desempenho. Portanto, recomenda-se executar consultas sem condições de filtro. Para buscas vetoriais sem filtros, o estado ideal é ter apenas um arquivo de índice vetorial por shard. Isso minimiza a E/S e melhora o desempenho da consulta dentro de cada shard.Para esse cenário, use uma instrução de criação de tabela semelhante à seguinte:
BEGIN; CREATE TABLE feature_tb ( uuid text, feature FLOAT4[] NOT NULL CHECK (array_ndims(feature) = 1 AND array_length(feature, 1) = N) --Define a vector ); CALL set_table_property ('feature_tb', 'shard_count', '?'); --Specify the shard count based on your business needs. You can omit this if not needed. CALL set_table_property ('feature_tb', 'proxima_vectors', '{"feature":{"algorithm":"Graph","distance_method":"InnerProduct"}}'); --Build a vector index END; -
Consultas com condições de filtro
Para buscas vetoriais com condições de filtro, considere os seguintes cenários comuns.
-
Cenário 1: Filtragem por coluna de string
Um caso de uso comum é buscar dados vetoriais dentro de um grupo específico, como encontrar dados faciais dentro de uma turma. Um exemplo de consulta é:
SELECT pm_xx_distance(feature, '{1,2,3,4}') AS d FROM feature_tb WHERE uuid = 'x' ORDER BY d limit 10;Recomendam-se as seguintes otimizações:
Defina
uuidcomo chave de distribuição. Isso garante que dados com o mesmo valor de filtro sejam armazenados no mesmo shard, fazendo com que a consulta seja roteada para apenas um shard.Defina
uuidcomo chave de clustering da tabela. Isso ordena os dados dentro de cada arquivo pela chave de clustering.
-
Cenário 2: Filtragem por campo de tempo
Geralmente, filtra-se dados vetoriais com base em um campo de tempo. Recomenda-se definir o campo de tempo
time_fieldcomo chave de segmento da tabela para localizar rapidamente os arquivos onde os dados estão armazenados. Um exemplo de consulta é:SELECT pm_xx_distance(feature, '{1,2,3,4}') AS d FROM feature_tb WHERE time_field BETWEEN '2020-08-30 00:00:00' AND '2020-08-30 12:00:00' ORDER BY d limit 10;
Para buscas vetoriais com condições de filtro, a instrução de criação de tabela geralmente segue o modelo abaixo:
BEGIN; CREATE TABLE feature_tb ( time_field timestamptz NOT NULL, uuid text, feature FLOAT4[] NOT NULL CHECK (array_ndims(feature) = 1 AND array_length(feature, 1) = N) ); CALL set_table_property ('feature_tb', 'distribution_key', 'uuid'); CALL set_table_property ('feature_tb', 'segment_key', 'time_field'); CALL set_table_property ('feature_tb', 'clustering_key', 'uuid'); CALL set_table_property ('feature_tb', 'proxima_vectors', '{"feature":{"algorithm":"Graph","distance_method":"InnerProduct"}}'); COMMIT; -- If you do not filter by time, you can remove the indexes related to time_field. -
Perguntas frequentes
-
O que fazer se o erro
ERROR: function pm_approx_inner_product_distance(real[], unknown) does not existfor reportado?Causa: Esse erro geralmente ocorre porque a instrução
CREATE EXTENSION proxima;não foi executada no banco de dados para inicializar a extensão Proxima.Solução: Execute a instrução
CREATE EXTENSION proxima;para inicializar a extensão Proxima. -
O que fazer se o erro
Writing column: feature with array size: 5 violates fixed size list (4) constraint declared in schemafor reportado?Causa: A dimensão dos dados gravados na coluna vetorial não corresponde à dimensão definida no esquema da tabela.
Solução: Verifique seus dados de entrada em busca de vetores com dimensões incorretas.
-
O que fazer se o erro
The size of two arrays must be the same in DistanceFunction, size of left array: 4, size of right array:for reportado?Causa: Na função
pm_xx_distance(left, right), a dimensão do arrayleftnão corresponde à dimensão do arrayright.Solução: Garanta que as dimensões dos arrays
lefterightna funçãopm_xx_distance(left, right)sejam iguais. -
O que fazer se o erro
BackPressure Exceed Reject Limit ctxId: XXXXXXXX, tableId: YY, shardId: ZZfor reportado durante gravações em tempo real?Causa: O trabalho de gravação em tempo real encontrou um gargalo e gerou uma exceção de backpressure. Isso indica que o trabalho de gravação tem alta sobrecarga e está lento. Esse problema é tipicamente causado por um valor pequeno para o parâmetro min_flush_proxima_row_count combinado com uma alta velocidade de gravação em tempo real. Essa configuração resulta em alta sobrecarga para a construção de índices em tempo real, o que bloqueia o processo de gravação.
Defina min_flush_proxima_row_count com um valor maior.
-
Como gravar dados vetoriais usando Java?
O exemplo a seguir mostra como gravar dados vetoriais usando Java.
private static void insertIntoVector(Connection conn) throws Exception { try (PreparedStatement stmt = conn.prepareStatement("insert into feature_tb values(?,?);")) { for (int i = 0; i < 100; ++i) { stmt.setInt(1, i); Float[] featureVector = {0.1f,0.2f,0.3f,0.4f}; Array array = conn.createArrayOf("FLOAT4", featureVector); stmt.setArray(2, array); stmt.execute(); } } } -
Como verificar se um índice Proxima Graph está sendo usado no plano de execução?
Verifique o plano de execução para confirmar o uso do índice Proxima Graph. Execute a instrução
EXPLAIN ANALYZE. Se a saída incluirProxima Filter: ProximaCond, confirma-se que a consulta está usando o índice Proxima Graph. Caso não visualize esse filtro, o índice não foi usado, o que geralmente indica uma incompatibilidade entre a definição da tabela e a instrução de consulta. Abaixo está um exemplo deplano de execuçãoque usa um índice Proxima Graph:test=# explain analyze select pm_approx_squared_euclidean_distance(feature, array[0.1,0.1,0.1,0.1,0.2]::float4[]) from test_get_ordered_array_according_to_docs order by 1 limit 10; QUERY PLAN --------------------------------------------------------------------------------------------------------------------------------------- Limit (cost=0.00..27.64 rows=0 width=4) -> Sort (cost=0.00..27.56 rows=10 width=4) Sort Key: (ProximaDistanceRef) [node_id=7; Row_count=10; Avg_Open_Time=0ms; Max_Open_Time=0ms; Min_Open_Time=0ms; Avg_Get_Next_Time=0ms; Max_Get_Next_Time=0ms; Min_Get_Next_Time=0ms] -> Exchange (Gather Exchange) (cost=0.00..1.68 rows=10 width=4) [node_id=6; Row_count=10; Avg_Open_Time=0ms; Max_Open_Time=0ms; Min_Open_Time=0ms; Avg_Get_Next_Time=0ms; Max_Get_Next_Time=0ms; Min_Get_Next_Time=0ms] -> Decode (cost=0.00..1.68 rows=10 width=4) [node_id=4; Row_count=10; Avg_Open_Time=0ms; Max_Open_Time=0ms; Min_Open_Time=0ms; Avg_Get_Next_Time=0ms; Max_Get_Next_Time=0ms; Min_Get_Next_Time=0ms] -> Result (cost=0.00..1.58 rows=10 width=4) -> Index Scan using holo_index:[1] on test_get_ordered_array_according_to_docs (cost=0.00..0.53 rows=10 width=1) Proxima Filter: ProximaCond -> KNN: $5 distance_method: pm_approx_squared_euclidean_distance search_params: {NULL} args: {featureARRAY[$1, $2, $3, $4]}
Funções de distância
O Hologres suporta as seguintes três funções de distância vetorial:
Distância euclidiana ao quadrado (
SquaredEuclidean). A fórmula é apresentada a seguir.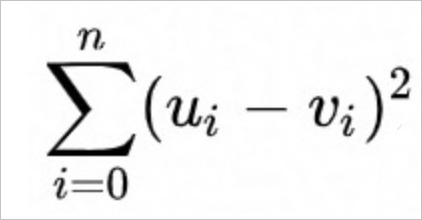
Distância euclidiana (
Euclidean). A fórmula é apresentada a seguir.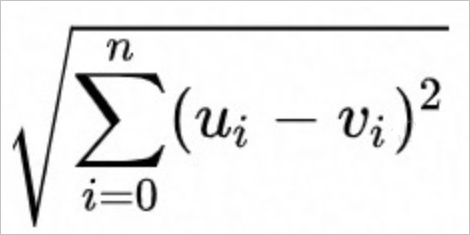
Distância por produto interno (
InnerProduct). A fórmula é apresentada a seguir.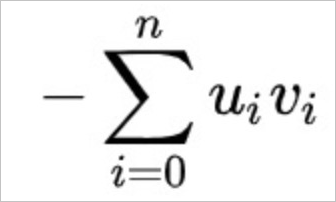
Ao usar uma distância baseada na métrica euclidiana, a distância euclidiana ao quadrado oferece melhor desempenho do que a distância euclidiana padrão, pois evita uma operação custosa de raiz quadrada e ainda produz o mesmo ranking Top-K. Portanto, recomenda-se o uso da distância euclidiana ao quadrado sempre que ela for adequada ao seu caso de uso.