O ES-Hadoop é um conector de código aberto que possibilita a movimentação bidirecional de dados entre o Elasticsearch e o ecossistema Hadoop. Ele integra o Elasticsearch de forma transparente a serviços como o Hive, combinando a capacidade de busca rápida do Elasticsearch com o poder de processamento em lote do Hadoop para análise interativa de dados. Este tópico descreve como usar o ES-Hadoop para ler e gravar dados no Alibaba Cloud Elasticsearch por meio do Hive. Assim, você combina o Elasticsearch com componentes do Hadoop e obtém análises de dados mais flexíveis.
Informações de contexto
O ecossistema Hadoop se destaca no processamento de conjuntos de dados em larga escala, mas costuma apresentar alta latência em análises interativas. Já o Elasticsearch foi projetado para análise interativa e retorna resultados em segundos para diversos tipos de consulta, principalmente as consultas ad hoc. O ES-Hadoop combina os pontos fortes dos dois sistemas. Com pequenas alterações de código, você usa o ES-Hadoop para processar rapidamente os dados armazenados no Elasticsearch e aproveita o ganho de desempenho que ele proporciona.
O ES-Hadoop utiliza o Elasticsearch como fonte de dados para mecanismos de processamento como MapReduce, Spark ou Hive. Em uma arquitetura com separação entre computação e armazenamento, o Elasticsearch atua como camada de armazenamento. O funcionamento é semelhante ao de outras fontes de dados usadas por MapReduce, Spark ou Hive, mas o Elasticsearch oferece seleção e filtragem de dados significativamente mais rápidas — capacidade crítica para qualquer mecanismo de análise.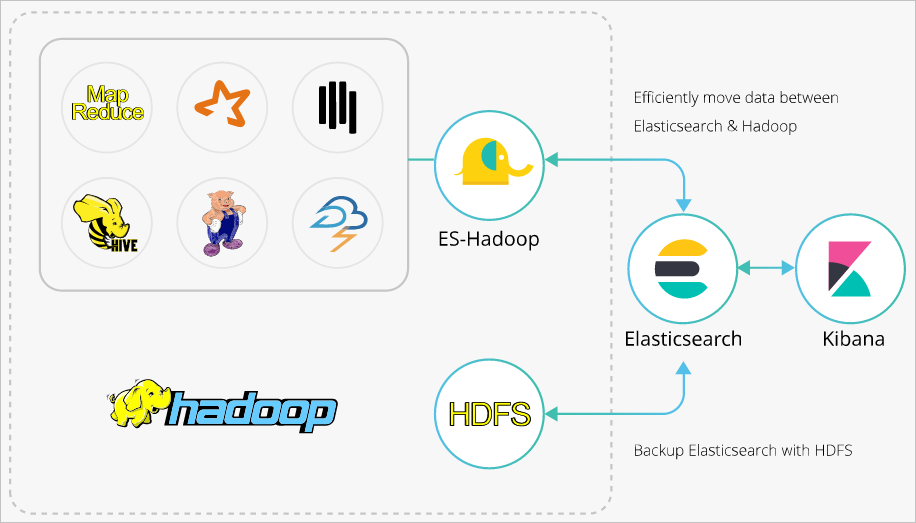
Para saber mais sobre configurações avançadas do ES-Hadoop e do Hive, consulte a documentação oficial do Elasticsearch.
Procedimento
-
Crie um cluster do Alibaba Cloud Elasticsearch e uma instância do E-MapReduce (EMR) na mesma virtual private cloud (VPC); desative o recurso de indexação automática do cluster do Elasticsearch e crie um índice com seus mapeamentos; baixe o pacote de instalação do ES-Hadoop compatível com a versão do seu cluster do Elasticsearch.
-
Step 1: Upload the ES-Hadoop JAR to HDFS
Faça o upload do JAR do ES-Hadoop para um diretório no HDFS do nó master do EMR.
-
Step 2: Create a Hive external table
Crie uma tabela externa no Hive e mapeie seus campos para os campos do índice do Elasticsearch.
-
Step 3: Write data to the index with Hive
Use o HiveSQL para gravar dados no índice do Elasticsearch.
-
Step 4: Read data from the index with Hive
Use o HiveSQL para ler dados do índice do Elasticsearch.
Pré-requisitos
-
Crie um cluster do Alibaba Cloud Elasticsearch.
Este tópico utiliza um cluster na versão 6.7.0. Para mais informações, consulte Create an Alibaba Cloud Elasticsearch cluster.
-
Desative a indexação automática do cluster e crie um índice com seus mapeamentos.
Quando a indexação automática está ativada, o Elasticsearch pode inferir um tipo de dado incorreto. Por exemplo, um campo chamado
ageque você define comoINTpode ser indexado comoLONG. Por isso, recomendamos criar o índice manualmente. O índice e os mapeamentos usados neste tópico são os seguintes.PUT company { "mappings": { "_doc": { "properties": { "id": { "type": "long" }, "name": { "type": "text", "fields": { "keyword": { "type": "keyword", "ignore_above": 256 } } }, "birth": { "type": "text" }, "addr": { "type": "text" } } } }, "settings": { "index": { "number_of_shards": "5", "number_of_replicas": "1" } } } -
Crie um cluster do EMR na mesma virtual private cloud (VPC) do seu cluster do Elasticsearch.
ImportantePor padrão, a lista de permissões de endereços IP privados de um cluster do Elasticsearch é definida como 0.0.0.0/0. Verifique essa configuração na página de configuração de segurança. Se você alterar esse padrão, adicione o endereço IP interno do cluster do EMR à lista de permissões:
Consulte View cluster list and details para obter o endereço IP interno do cluster do EMR.
Consulte Configure a public or private IP address whitelist for an Elasticsearch cluster para configurar a lista de permissões de endereços IP privados da VPC no cluster do Elasticsearch.
Etapa 1: Fazer upload do JAR do ES-Hadoop para o HDFS
-
Baixe o pacote de instalação do ES-Hadoop cuja versão corresponda à do seu cluster do Elasticsearch.
Este tópico utiliza o elasticsearch-hadoop-6.7.0.zip.
-
Faça logon no EMR console, obtenha o endereço IP do nó master e utilize SSH para acessar a instância ECS correspondente.
Para mais informações, consulte Log on to a cluster.
Envie o arquivo elasticsearch-hadoop-6.7.0.zip baixado para o nó master e descompacte-o para obter o elasticsearch-hadoop-hive-6.7.0.jar.
-
Crie um diretório no HDFS e faça upload do elasticsearch-hadoop-hive-6.7.0.jar para esse diretório.
hadoop fs -mkdir /tmp/hadoop-es
hadoop fs -put elasticsearch-hadoop-6.7.0/dist/elasticsearch-hadoop-hive-6.7.0.jar /tmp/hadoop-es
Etapa 2: Criar uma tabela externa no Hive
-
No módulo Data development do EMR console, crie um job HiveSQL.
Para mais informações, consulte Configure a Hive SQL job.
Na caixa de diálogo Create Job, defina Job Name como
hivetest, Folder comoJOB/e clique em OK. -
Configure o job para criar uma tabela externa.
A configuração do job é a seguinte.
-- Add the JAR. This command is valid only for the current session.
add jar hdfs:///tmp/hadoop-es/elasticsearch-hadoop-hive-6.7.0.jar;
-- Create a Hive external table and map it to the Elasticsearch index.
CREATE EXTERNAL table IF NOT EXISTS company(
   id BIGINT,
   name STRING,
   birth STRING,
   addr STRING
)
STORED BY 'org.elasticsearch.hadoop.hive.EsStorageHandler'
TBLPROPERTIES(
    'es.nodes' = 'http://es-cn-mp91kzb8m0009****.elasticsearch.aliyuncs.com',
    'es.port' = '9200',
    'es.net.ssl' = 'true',
    'es.nodes.wan.only' = 'true',
    'es.nodes.discovery'='false',
    'es.input.use.sliced.partitions'='false',
    'es.input.json' = 'false',
    'es.resource' = 'company/_doc',
    'es.net.http.auth.user' = 'elastic',
    'es.net.http.auth.pass' = 'xxxxxx'
);
Tabela 1. Descrição dos parâmetros do ES-Hadoop
Parâmetro
Padrão
Descrição
es.nodes
localhost
O endpoint do cluster do Alibaba Cloud Elasticsearch. Recomendamos utilizar um endpoint privado. Você pode visualizar o endpoint na página de informações básicas do cluster. Para mais informações, consulte View the basic information of a cluster.
es.port
9200
A porta usada para acessar o cluster do Elasticsearch.
es.net.http.auth.user
elastic
O nome de usuário para acessar o cluster do Elasticsearch.
NotaSe você especificar a conta
elasticna sua aplicação, qualquer alteração de senha subsequente dessa conta pode causar interrupções temporárias do serviço devido ao atraso de propagação. Por isso, não é recomendado usar a contaelastic. Em vez disso, crie um usuário dedicado com as permissões adequadas no Kibana console. Para mais informações, consulte Use the RBAC mechanism of Elasticsearch X-Pack to control user access.es.net.http.auth.pass
/
A senha para acessar o cluster do Elasticsearch.
es.nodes.wan.only
false
Indica se o node sniffing deve ser ativado quando o cluster do Elasticsearch utiliza um endereço IP virtual nas conexões.
-
true: ativa o node sniffing.
-
false: desativa o node sniffing.
es.nodes.discovery
true
Indica se o node discovery deve ser utilizado.
-
true: utiliza node discovery.
-
false: não utiliza node discovery.
ImportanteAo usar o Alibaba Cloud Elasticsearch, você deve definir esse parâmetro como
false.
es.input.use.sliced.partitions
true
Indica se as slice partitions devem ser utilizadas.
-
true: utiliza slice partitions. Definir esse parâmetro como
truepode aumentar significativamente o tempo de pré-leitura do índice, às vezes tornando-o muito maior que o próprio tempo de consulta. Recomendamos definir esse parâmetro comofalsepara melhorar o desempenho das consultas. -
false: não utiliza slice partitions.
es.index.auto.create
true
Indica se um índice deve ser criado automaticamente, caso não exista, ao gravar dados de um componente do Hadoop em um cluster do Elasticsearch.
-
true: cria o índice automaticamente.
-
false: não cria o índice automaticamente.
es.resource
/
O índice e o type a serem lidos ou gravados.
es.mapping.names
/
Os mapeamentos entre as colunas da tabela e os campos do índice do Elasticsearch.
es.read.metadata
false
Ative essa propriedade se suas operações envolverem campos internos do Elasticsearch, como _id.
Para saber mais sobre as opções de configuração do ES-Hadoop, consulte a documentação oficial de configuração.
-
-
Salve e execute o job.
add jar hdfs:///tmp/hadoop-es/elasticsearch-hadoop-hive-6.7.0.jar;

CREATE EXTERNAL table IF NOT EXISTS company(
    id BIGINT,
    name STRING,
    birth STRING,
    addr STRING
)
STORED BY 'org.elasticsearch.hadoop.hive.EsStorageHandler'
TBLPROPERTIES(
    'es.nodes' = 'http://es-cn-n6wxxx.elasticsearch.aliyuncs.com',
    'es.port' = '9200',
    'es.net.ssl' = 'true',
    'es.nodes.wan.only' = 'true',
    'es.nodes.discovery'='false',
    'es.input.json' = 'false',
    'es.resource' = 'company/_doc',
    'es.net.http.auth.user' = 'elastic',
    'es.net.http.auth.pass' = 'xxx'
);
Na aba Run Records, verifique o status de execução do job. Quando a coluna Status exibir OK, o job foi executado com sucesso.
Etapa 3: Gravar dados no índice com o Hive
-
Crie um job HiveSQL para gravar os dados.
A configuração do job é a seguinte.
add jar hdfs:///tmp/hadoop-es/elasticsearch-hadoop-hive-6.7.0.jar; INSERT INTO TABLE company VALUES (1, "zhangsan", "1990-01-01","No.969, wenyixi Rd, yuhang, hangzhou"); INSERT INTO TABLE company VALUES (2, "lisi", "1991-01-01", "No.556, xixi Rd, xihu, hangzhou"); INSERT INTO TABLE company VALUES (3, "wangwu", "1992-01-01", "No.699 wangshang Rd, binjiang, hangzhou"); -
Salve e execute o job.
add jar hdfs:///tmp/hadoop-es/elasticsearch-hadoop-hive-6.7.0.jar; INSERT INTO TABLE company VALUES (1, "zhangsan", "1990-01-01","No.969, wenyixi Rd, yuhang, hangzhou"); INSERT INTO TABLE company VALUES (2, "lisi", "1991-01-01", "No.556, xixi Rd, xihu, hangzhou"); INSERT INTO TABLE company VALUES (3, "wangwu", "1992-01-01", "No.699 wangshang Rd, binjiang, hangzhou"); -
Após a execução bem-sucedida do job, faça logon no Kibana console do seu cluster para visualizar os dados no índice
company.Para saber como fazer logon no Kibana console, consulte Log on to the Kibana console. No Kibana console, execute o comando a seguir para visualizar os dados do índice
company.GET company/_searchApós a execução bem-sucedida do comando, o resultado é o seguinte.
{
  "took" : 2,
  "timed_out" : false,
  "_shards" : {
    "total" : 5,
    "successful" : 5,
    "skipped" : 0,
    "failed" : 0
  },
  "hits" : {
    "total" : 3,
    "max_score" : 1.0,
    "hits" : [
      {
        "_index" : "company",
        "_type" : "employees",
        "_id" : "T6XkvnQBHw8DvkRwat8M",
        "_score" : 1.0,
        "_source" : {
          "id" : 1,
          "name" : "zhangsan",
          "birth" : "1990-01-01",
          "addr" : "No.969, wenyixi Rd, yuhang, hangzhou"
        }
      },
      {
        "_index" : "company",
        "_type" : "employees",
        "_id" : "tTPkvnQBNOGEvdaOqoyb",
        "_score" : 1.0,
        "_source" : {
          "id" : 2,
          "name" : "lisi",
          "birth" : "1991-01-01",
          "addr" : "No.556, xixi Rd, xihu, hangzhou"
        }
      },
      {
        "_index" : "company",
        "_type" : "employees",
        "_id" : "D33kvnQBbtHntVTN6dAH",
        "_score" : 1.0,
        "_source" : {
          "id" : 3,
          "name" : "wangwu",
          "birth" : "1992-01-01",
          "addr" : "No.699 wangshang Rd, binjiang, hangzhou"
        }
      }
    ]
  }
}
Etapa 4: Ler dados do índice com o Hive
-
Crie um job HiveSQL para ler os dados.
A configuração do job é a seguinte.
add jar hdfs:///tmp/hadoop-es/elasticsearch-hadoop-hive-6.7.0.jar; select * from company; -
Salve e execute o job.
O editor de código do job contém duas instruções SQL:
add jar hdfs:///tmp/hadoop-es/elasticsearch-hadoop-hive-6.7.0.jar;eselect * from company;. Após a execução bem-sucedida do job, clique na aba Results para visualizar os resultados da consulta. A tabelacompanyretorna 3 registros com as colunascompany.id,company.name,company.birthecompany.addr, contendo os dados de zhangsan (Yuhang), lisi (Xihu) e wangwu (Binjiang).
FAQ
P: O que devo fazer se o seguinte erro ocorrer ao ler ou gravar no Elasticsearch usando o Hive?
Error message: FAILED: Execution Error, return code -101 from org.apache.hadoop.hive.ql.exec.mr.MapRedTask. Could not initialize class org.elasticsearch.hadoop.rest.commonshttp.CommonsHttpTransport。R: O erro ocorre porque o componente Hive do EMR 5.6.0 não possui o arquivo commons-httpclient-3.1.jar. Para resolver o problema, adicione manualmente o arquivo ausente ao diretório lib do Hive. Para obter o link de download do arquivo, consulte commons-httpclient-3.1.