Crie um cluster EMR baseado em Kubernetes e execute engines de big data como Spark, Flink e Presto no ACK.
Pré-requisitos
As políticas AliyunOSSFullAccess e AliyunDLFFullAccess devem estar concedidas. Para mais informações, consulte Grant permissions to access OSS and DLF.
Crie um cluster Kubernetes. Para mais informações, consulte Create an ACK dedicated cluster (discontinued) ou Create an ACK managed cluster.
Crie um pool de nós. Para mais informações, consulte Create and gerencie a node pool.
Ative o Object Storage Service (OSS). Para mais informações, consulte Activate OSS.
Procedimento
Faça login no console do EMR on ACK.
Na página EMR on ACK, clique em Create Cluster.
-
Na página EMR on ACK, configure os parâmetros do cluster.
Parâmetro
Descrição
Region
A região na qual o cluster será implantado. Não pode ser alterada após a criação.
Cluster Type
Os seguintes tipos de cluster são compatíveis:
-
Shuffle Service: um componente de extensão do EMR que fornece um service de shuffle remoto. Permite execute jobs do Spark em nós sem discos locais e oferece suporte à alocação dinâmica de recursos, o que o torna ideal para clusters Spark em um ambiente ACK. Para mais informações, consulte Celeborn.
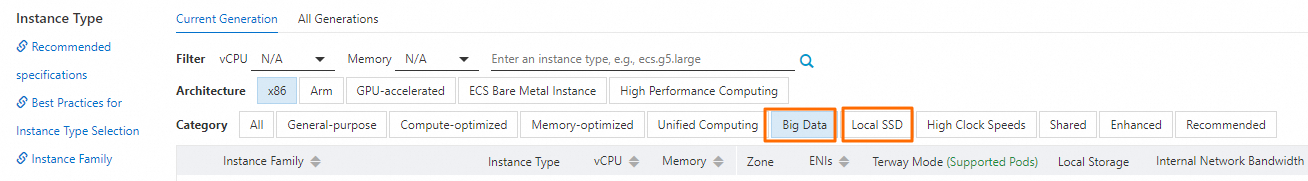
ImportanteAo criar um cluster Shuffle Service, a especificação da instância do pool de nós dedicados ou dos nós no cluster ACK associado deve ser de big data ou SSD local. Caso contrário, a implantação do RSS falhará.
 Nota
Este job otimiza o gerenciamento de armazenamento e evita desperdícios ao remover PVCs inválidos ou redundantes.
-
Presto: uma engine SQL distribuída em memória para consultas interativas.
Oferece suporte a múltiplas source de dados e é adequada para análises em escala de petabytes e consultas entre diferentes source de dados.
-
Spark: uma engine de processamento de big data distribuída e de uso geral para ETL, processamento em lote offline e modelagem de dados.
ImportantePara associar um cluster Spark a um cluster Shuffle Service, as versões principais do product devem corresponder. Por exemplo, um cluster Spark da versão EMR-5.x-ack só pode ser associado a um cluster Shuffle Service da versão EMR-5.x-ack.
-
Flink: uma engine de processamento distribuído para computações com estado em fluxos de dados limitados e ilimitados. Criado sobre o EMR on ACK e o Flink Kubernetes Operator 1.0.1 da comunidade, o Flink on ACK usa o kernel corporativo da equipe oficial do Flink por padrão, proporcionando uma experiência pronta para uso do Flink no Kubernetes.
Product Version
O padrão é a versão mais recente do software.
Component Version
Lista os componentes e as versões incluídas no tipo de cluster selecionado.
ACK cluster
Selecione um cluster ACK existente ou crie um novo no console do Container Service for Kubernetes (ACK).
Clique em Configure Dedicated Nodes para configurar nós dedicados ao EMR. Isso aplica taints e rótulos específicos do EMR a um pool de nós ou a nós individuais, reservando-os exclusivamente para o EMR.
NotaRecomendamos configurar os nós dedicados usando um pool de nós. Se não houver nenhum pool de nós disponível, crie um. Para mais informações, consulte Create a node pool.
OSS bucket
Selecione um bucket existente ou crie um novo no console do Object Storage Service (OSS).
Cluster Name
Deve ter de 1 a 64 caracteres e pode conter apenas caracteres chineses, letras, dígitos, hifens (-) e sublinhados (_).
-
-
Clique em create.
O cluster estará pronto quando seu status mudar para Running.