O Container Compute Service (ACS) aloca dispositivos GPU aos pods com base na topologia de GPU de cada modelo de nó GPU-HPN. Pods no mesmo nó trocam dados por canais como NVLink, e as restrições de partição mantêm a comunicação entre GPUs eficiente e equilibrada.
Pré-requisitos
Este recurso oferece suporte apenas a pods que usam a classe de computação gpu-hpn (compute-class) e os tipos de nó GPU-HPN correspondentes.
Contexto
Em um nó GPU-HPN, os dispositivos GPU se conectam e se comunicam por um ou mais canais. Isso permite executar pods com diferentes quantidades de GPUs solicitadas no mesmo nó. Para garantir uma comunicação eficiente e equilibrada entre GPUs, além de evitar interferências entre pods, o ACS agenda os pods considerando a topologia de GPU do nó. O sistema divide os dispositivos GPU em partições compatíveis com as quantidades solicitadas pelos pods e aloca a partição ideal para cada um.
A figura a seguir mostra um nó com oito GPUs. Cada grupo é formado por quatro GPUs. As GPUs dentro de um grupo são diretamente interconectadas, e os dois grupos se conectam via PCIe.
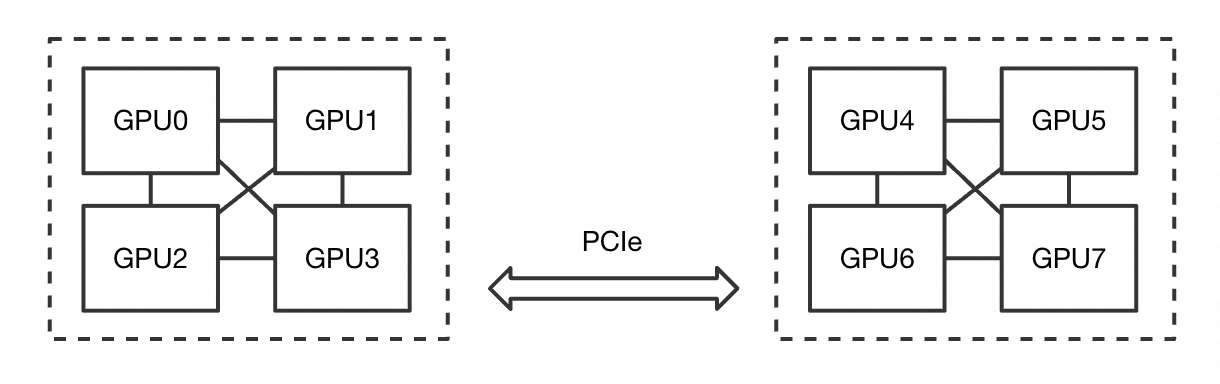
O ACS divide os dispositivos deste nó nas seguintes partições:
|
GPUs solicitadas pelo pod |
Resultados disponíveis de alocação de dispositivos |
|
8 |
[0,1,2,3,4,5,6,7] |
|
4 |
[0,1,2,3], [4,5,6,7] |
|
2 |
[0,1], [2,3], [4,5], [6,7] |
|
1 |
[0], [1], [2], [3], [4], [5], [6], [7] |
A criação e a exclusão repetidas de pods em um nó podem causar fragmentação de partições. Esse cenário impede o agendamento de novos pods e os deixa no estado Pending. Para liberar os dispositivos necessários a um pod pendente, revise os resultados de alocação de dispositivos dos pods no nó e remova alguns deles conforme suas prioridades de negócio. A seção de perguntas frequentes deste tópico descreve como planejar recursos do nó para evitar fragmentação de partições, como selecionar pods para remoção e como o tipo, a versão e a configuração do agendador afetam a consideração das partições durante o agendamento.
Partições dos tipos de nó GPU-HPN
As partições e os modelos de GPU variam conforme os tipos de nó GPU-HPN fornecidos pelo ACS. Para verificar quais partições estão em uso em um nó, visualize os resultados de alocação de dispositivos dos pods em execução nesse nó.
gpu.p16en-16XL
Este tipo de nó possui 16 GPUs do modelo P16EN. A tabela a seguir lista as partições para as quantidades de GPUs solicitadas pelos pods.
|
GPUs solicitadas pelo pod |
Resultados disponíveis de alocação de dispositivos |
|
16 |
[0,1,2,3,4,5,6,7,8,9,10,11,12,13,14,15] |
|
8 |
[0,1,2,3,4,5,6,7], [8,9,10,11,12,13,14,15] |
|
4 |
[0,1,2,3], [4,5,6,7], [8,9,10,11], [12,13,14,15] |
|
2 |
[0,3], [1,2], [4,7], [5,6], [8,11], [9,10], [12,15], [13,14] |
|
1 |
[0], [1], [2], [3], [4], [5], [6], [7], [8], [9], [10], [11], [12], [13], [14], [15] |
Visualizar os resultados de agendamento de um pod
Resultado da alocação de dispositivos
Para um pod GPU-HPN, o resultado da alocação de dispositivos fica registrado nas anotações do pod no seguinte formato:
apiVersion: v1
kind: Pod
metadata:
  annotations:
    alibabacloud.com/device-allocation: '{"gpus": {"minor": [0,1,2,3]}}'
Mensagem de falha de agendamento causada por fragmentação de partição
Um pod não agendado permanece no estado Pending. Execute o comando a seguir para visualizar a mensagem de falha de agendamento:
kubectl describe pod pod-demoSaída esperada, com outros conteúdos omitidos:
...
Events:
  Type     Reason            Age    From               Message
  ----     ------            ----   ----               -------
  Warning  FailedScheduling  26m    default-scheduler  0/5 nodes are available: 2 Node(s) Insufficient Partitioned GPU Devices, 1 Node(s) xxx, 2 Node(s) xxx.
Em uma mensagem semelhante a 0/5 nodes are available: xxx, o termo Insufficient Partitioned GPU Devices indica que o agendamento falhou devido à fragmentação de partição no nó.
Perguntas frequentes
Como planejar recursos e políticas de nó para evitar fragmentação de partição?
Planeje os recursos e as políticas do nó da seguinte forma:
Agrupe nós por quantidade de GPUs solicitadas — Defina rótulos diferentes nos seus nós para gerenciar recursos com base no número de GPUs que seus pods solicitam. Por exemplo, agende pods que solicitam 8 GPUs e pods que solicitam 1 GPU em nós distintos.
Libere dispositivos ociosos quando já houver pods Pending — Quando a fragmentação de partição deixar pods no estado Pending no seu cluster, utilize mecanismos como desagendamento para remover alguns pods de baixa prioridade e liberar dispositivos ociosos para os pods pendentes.
Reserve capacidade quando não for possível planejar rótulos de nó — Se você tiver poucos nós ou não puder planejar rótulos de nó, e seus pods solicitarem uma ampla variedade de quantidades de GPUs, reserve capacidade para atender aos requisitos de recursos das suas aplicações. Para mais informações, consulte GPU pod capacity reservation.
Como selecionar pods para remoção ao resolver fragmentação de partição?
Identifique o número de GPUs que o pod pendente solicita, por exemplo, 8 GPUs.
No nó de destino, leia a anotação
alibabacloud.com/device-allocationde cada pod para determinar quais dispositivos já estão alocados. Para mais informações, consulte device allocation result.Decida quais pods remover com base nos resultados de alocação e garanta que os dispositivos liberados pela remoção atendam tanto à quantidade de GPUs solicitada quanto às restrições de partição do pod pendente. Por exemplo, uma solicitação de 8 GPUs em P16EN exige que os IDs de dispositivo [0,1,2,3,4,5,6,7] ou [8,9,10,11,12,13,14,15] estejam todos desalocados.
Remova os pods executando um comando como
evictoudelete.
O que preciso saber sobre partições ao usar um agendador personalizado?
Depois que um agendador personalizado atribui um pod a um nó, o ACS aloca os dispositivos para o pod nesse nó. Durante a alocação de dispositivos, o ACS agrupa os dispositivos da forma mais densa possível para evitar fragmentação de partição.
Um agendador personalizado precisa considerar apenas a capacidade total de GPU de um nó. Para recursos de GPU, prefira uma política de bin-packing de nó MostAllocated, que reduz a fragmentação de partição.
Quais agendadores reconhecem a topologia de partição GPU-HPN?
Use a tabela a seguir para determinar se o seu agendador reconhece a topologia de partição dos nós GPU-HPN.
Tipo de agendador | Condições | Descrição |
Agendador padrão do ACS | Todas as condições a seguir são atendidas:
e qualquer uma das seguintes condições de versão é atendida:
Para versões com suporte, consulte kube-scheduler. | O agendador reconhece o status de alocação de partição do nó atual e exclui nós cujas partições não possam atender à solicitação. O evento de falha de agendamento do pod inclui a mensagem |
Agendador padrão do ACK | Todas as condições a seguir são atendidas:
Você pode encontrar as versões com suporte em kube-scheduler. | O agendador reconhece o status de alocação de partição do nó atual e exclui nós cujas partições não possam atender à solicitação. O evento de falha de agendamento do pod inclui a mensagem |
Outros tipos de agendador | O tipo de agendador, as condições ou a configuração não atendem aos requisitos anteriores. | O agendador não reconhece a topologia de partição. O nó GPU-HPN aloca dispositivos da forma mais densa possível. Se as partições não puderem atender à solicitação, o pod permanecerá no estado Pending no nó até que as partições possam atendê-la, e o evento de falha de agendamento do pod incluirá a mensagem |