Atualize a versão principal do mecanismo de um cluster do ApsaraDB for ClickHouse Community-compatible Edition migrando seus dados para um novo cluster que execute uma versão mais recente. Essa abordagem está disponível para clusters com a versão 19.15 ou posterior.
Não há suporte para downgrades. Após concluir a atualização, não é possível reverter para a versão principal anterior do mecanismo. Planeje a atualização e a janela de transição antes de iniciar.
Pré-requisitos
Antes de começar, verifique se você tem:
-
Dois clusters Community-compatible Edition, ambos com status Running
Para migrar entre Community-compatible Edition e Enterprise Edition, consulte Migrar um cluster ClickHouse Community-compatible Edition para um cluster Enterprise Edition .
Uma conta de banco de dados e senha configuradas em ambos os clusters
A mesma configuração de armazenamento em camadas para dados quentes e frios em ambos os clusters
-
Ambos os clusters na mesma região e Virtual Private Cloud (VPC), com o endereço IP de cada cluster adicionado à lista de permissões do outro
Execute
SELECT * FROM system.clusters;para obter o endereço IP de um cluster. Para configurar a lista de permissões, consulte Definir uma lista de permissões . Um cluster de destino cuja versão principal do mecanismo seja posterior à do cluster de origem
Armazenamento em disco disponível no cluster de destino (excluindo cold storage) que seja pelo menos 1,2 vezes o armazenamento em disco utilizado pelo cluster de origem (excluindo cold storage)
Cada tabela local no cluster de origem associada a exatamente uma tabela distribuída
Para versões compatíveis, consulte Notas de versão do ApsaraDB for ClickHouse Community-compatible Edition.
O que pode e não pode ser migrado
Conteúdo de migração compatível:
Bancos de dados, tabelas (mecanismo MergeTree), visualizações materializadas, dicionários de dados (apenas criados via SQL), permissões de usuário e configurações de cluster
-
Esquemas de tabelas não-MergeTree (tabelas externas e tabelas Log) — apenas esquemas, sem dados de negócio
Se o cluster de origem contiver tabelas não-MergeTree, o cluster de destino terá apenas seus esquemas após a migração, sem nenhum dado de negócio. Para migrar os dados de negócio, use a função
remote. Para mais informações, consulte Usar a função remote para migrar dados .
Não compatível:
Dicionários de dados criados usando XML
Tabelas com mecanismos Kafka e RabbitMQ (dados de negócio)
Lista de verificação de preparação
Antes de iniciar a migração:
Confirme que nenhuma operação de gerenciamento (scale-out, atualização ou downgrade) esteja em execução em qualquer um dos clusters.
Verifique a existência de dicionários de dados criados via XML executando:
SELECT * FROM system.dictionaries WHERE (database = '') OR isNull(database);— se houver resultados, remova esses dicionários antes de prosseguir.Caso um dicionário de dados acesse um serviço externo, confirme se o serviço está acessível e se sua lista de permissões permite acesso a partir do cluster de destino.
Se um dicionário de dados usar uma tabela interna do ClickHouse como source com o parâmetro
HOSTdefinido como um endereço IP, o IP mudará após a migração — recrie manualmente esse dicionário de dados com o novo IP após a migração.Para tabelas Kafka e RabbitMQ: limpe-as no cluster de origem e recrie-as no cluster de destino, ou use grupos de consumidores diferentes para evitar divisão de dados.
Mantenha o total de dados frios no cluster de origem abaixo de 1 TB. Volumes maiores de dados frios aumentam significativamente o tempo de migração e podem causar falha na tarefa.
Após a atualização, atualize o endpoint nas configurações do seu cliente para apontar para o cluster de destino.
Impactos potenciais
Cluster de origem durante a migração:
As operações de leitura e gravação continuam normalmente.
Operações de Data Definition Language (DDL) (adição, exclusão ou modificação de bancos de dados e tabelas) são bloqueadas.
-
Quando o tempo restante estimado para a migração cair para 10 minutos ou menos, o cluster de origem pausa automaticamente as gravações para manter a consistência dos dados:
Se isso ocorrer dentro da janela predefinida de parada de gravação, as gravações param imediatamente.
Se isso ocorrer fora da janela de parada de gravação e dentro de 5 dias da criação da tarefa, modifique a janela de parada de gravação para continuar.
Se isso ocorrer fora da janela de parada de gravação e após 5 dias da criação da tarefa, a migração falhará. Cancele a tarefa, limpe os dados migrados do cluster de destino e recomece.
As gravações são retomadas automaticamente quando todos os dados forem migrados ou quando a janela de parada de gravação terminar antes da conclusão da migração.
Cluster de destino após a migração:
O cluster de destino executa operações frequentes de merge por um período após a migração, aumentando o uso de I/O e a latência de consulta. Planeje-se para essa latência elevada antes de alternar o tráfego. Para estimar quanto tempo as operações de merge levarão, consulte Calcular a duração do merge após a migração.
Visão geral da migração
Execute todas as etapas no cluster de destino, não no cluster de origem.
Registre e limpe as tabelas com mecanismos Kafka/RabbitMQ (ignore se não aplicável).
Crie uma tarefa de migração no cluster de destino.
Avalie se a migração pode ser concluída (necessário apenas se a velocidade de gravação da origem exceder 20 MB/s).
Monitore a tarefa de migração.
Reconstrua as tabelas com mecanismos Kafka/RabbitMQ no cluster de origem (ignore se não aplicável).
Exclua as tabelas com mecanismos Kafka/RabbitMQ no cluster de origem (ignore se não aplicável).
Reconstrua as tabelas com mecanismos Kafka/RabbitMQ no cluster de destino (ignore se não aplicável).
(Opcional) Cancele a tarefa de migração, se necessário.
(Opcional) Modifique a janela de parada de gravação.
Etapa 1: registrar e limpar tabelas com mecanismos Kafka/RabbitMQ
Se o cluster de origem não contiver tabelas com mecanismos Kafka/RabbitMQ, ignore as Etapas 1, 5, 6 e 7 e comece pela Etapa 2.
Antes de iniciar a migração, registre as definições de todas as tabelas com mecanismos Kafka/RabbitMQ e suas visualizações materializadas downstream no cluster de origem, trate as tabelas implícitas e, em seguida, exclua essas tabelas para evitar erros de migração.
-
Faça logon no cluster de origem e consulte todas as tabelas com mecanismos Kafka e RabbitMQ junto com suas dependências downstream.
/* create_table_query: table definition dependencies_database: database of the table that depends on this table dependencies_table: table that depends on this table From dependencies_database and dependencies_table, you can identify the materialized views that depend on Kafka/RabbitMQ tables */ SELECT * FROM system.tables WHERE engine IN ('RabbitMQ', 'Kafka'); -
Visualize a definição da visualização materializada para verificar se sua tabela de destino é uma tabela implícita.
/* View the materialized view definition. If the target table of the materialized view is an implicit table, pay special attention: Dropping the materialized view will also drop the implicit table, causing data loss. Example: If CREATE MATERIALIZED VIEW [db.]table_name [TO[db.]name] does not specify TO, the system automatically creates an implicit table, possibly in the format '.inner_id.<TABLE_UUID>' or '.inner.<TABLE>' */ SELECT * FROM system.tables WHERE database='<DATABASE>' AND name = '<MATERIALIZED_VIEW_NAME>'; -
Se a tabela de destino de uma visualização materializada for uma tabela implícita, RENOMEIE a tabela de destino para um novo nome para evitar perda de dados quando a visualização materializada for excluída posteriormente.
-- Rename the implicit target table to a new name to protect data RENAME TABLE <DATABASE>.`.inner_id.<TABLE_UUID>` TO <DATABASE>.<new_target_table_name>; -
Exclua as tabelas com mecanismos Kafka/RabbitMQ e suas visualizações materializadas downstream.
-- Drop materialized views first
DROP TABLE <DATABASE>.<MATERIALIZED_VIEW_NAME>;
-- Then drop Kafka/RabbitMQ engine tables
DROP TABLE <DATABASE>.<KAFKA_OR_RABBITMQ_TABLE_NAME>;
Certifique-se de salvar todas as instruções DDL registradas. Você precisará delas para reconstruir essas tabelas tanto no cluster de origem quanto no cluster de destino posteriormente. Se você realizou uma operação RENAME, use a cláusula TO apontando para a tabela de destino renomeada ao reconstruir a visualização materializada. Para mais informações, consulte CREATE MATERIALIZED VIEW.
Etapa 2: criar uma tarefa de migração
Faça logon no console do ApsaraDB for ClickHouse.
Na página Clusters, selecione a aba Clusters of Community-compatible Edition e clique em ID do cluster de destino.
No painel de navegação à esquerda, clique em Data Migration and Synchronization > Migration from ClickHouse.
Clique em Create Migration Task.
-
Configure as instâncias de origem e destino e clique em Test Connectivity and Proceed.
Se o teste de conexão falhar, reconfigure as instâncias conforme indicado pela mensagem de erro.
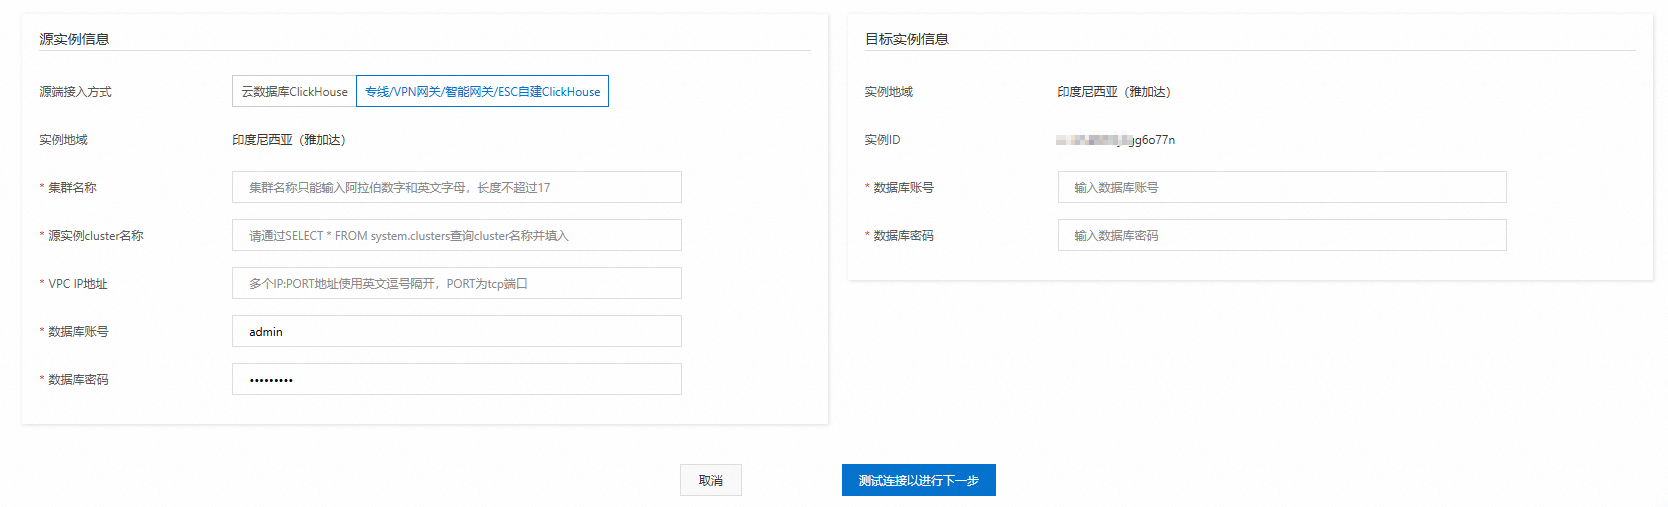
Revise os detalhes do conteúdo da migração e clique em Next: Pre-detect and Start Synchronization.
-
O sistema executa uma pré-verificação com os seguintes itens:
Verificação
Requisito
Status da instância
Nenhuma tarefa de gerenciamento (scale-out, alterações de configuração) em execução em qualquer um dos clusters
Espaço de armazenamento
Armazenamento em disco de destino >= 1,2x armazenamento em disco de origem (excluindo cold storage)
Tabela local e tabela distribuída
Cada tabela local no cluster de origem tem exatamente uma tabela distribuída
-
Se a pré-verificação for bem-sucedida:
Revise os detalhes de impacto na página.
-
Defina o Time of Stopping Data Writing.
Defina a janela de parada de gravação para pelo menos 30 minutos para melhorar a taxa de sucesso da migração. A data final não deve ser superior a 5 dias a partir de hoje. Agende a janela durante horários de menor movimento para minimizar o impacto nos negócios.
Clique em Completed para criar e iniciar a tarefa.
Se a pré-verificação falhar: Resolva os problemas conforme indicado e tente novamente a migração.
-
Etapa 3: avaliar se a migração pode ser concluída
Ignore esta etapa se a velocidade de gravação do cluster de origem for inferior a 20 MB/s.
Se a velocidade de gravação do cluster de origem exceder 20 MB/s, verifique se o cluster de destino consegue acompanhar:
Abra Visualizar informações de monitoramento do cluster e verifique a métrica Disk throughput do cluster de destino.
-
Compare as duas velocidades de gravação:
Velocidade de gravação do destino >= velocidade de gravação da origem: A migração tem alta taxa de sucesso. Prossiga para a Etapa 4.
Velocidade de gravação do destino < velocidade de gravação da origem: A migração pode falhar. Cancele a tarefa de migração e realize uma migração manual em vez disso.
Etapa 4: monitorar a tarefa de migração
Na página Clusters, selecione a aba Clusters of Community-compatible Edition e clique em ID do cluster de destino.
-
No painel de navegação à esquerda, clique em Migration from ClickHouse. A lista de migração mostra o Migration Status, Running Information e Data Write-Stop Window para cada tarefa.
Quando o tempo restante estimado na coluna Running Information cair para 10 minutos ou menos e o status for Migrating , a lógica de parada de gravação será acionada. Consulte Impactos potenciais para saber o que acontece em cada cenário.
ImportanteSe o cluster de origem contiver tabelas com mecanismos Kafka/RabbitMQ: quando a tarefa de migração entrar na fase de migração de dados (ou seja, a migração do esquema da tabela estiver concluída), execute a Etapa 5 para reconstruir as tabelas com mecanismos Kafka/RabbitMQ no cluster de origem, para que os dados incrementais voltem a fluir e sejam sincronizados com o cluster de destino.
Pouco antes da janela de parada de gravação configurada, execute a Etapa 6 para excluir as tabelas com mecanismos Kafka/RabbitMQ e suas visualizações materializadas downstream no cluster de origem, evitando que o acúmulo de mensagens durante o período de parada de gravação cause inconsistência de dados.
Etapa 5: reconstruir tabelas com mecanismos Kafka/RabbitMQ no cluster de origem
Depois que a tarefa de migração entrar na fase de migração de dados (ou seja, a migração do esquema da tabela estiver concluída), use as instruções DDL salvas anteriormente para reconstruir as tabelas com mecanismos Kafka/RabbitMQ e suas visualizações materializadas downstream no cluster de origem. Uma vez reconstruídas, os dados incrementais voltam a fluir e são sincronizados automaticamente com o cluster de destino.
Se você realizou uma operação RENAME em tabelas de destino implícitas anteriormente, use a cláusula TO apontando para a tabela de destino renomeada ao reconstruir a visualização materializada. Para mais informações, consulte CREATE MATERIALIZED VIEW.
-- Rebuild Kafka/RabbitMQ engine tables on the source cluster
CREATE TABLE <database>.<kafka_or_rabbitmq_table_name> (...)
ENGINE = Kafka/RabbitMQ
SETTINGS ...;
-- Rebuild materialized view (pointing to the renamed target table)
CREATE MATERIALIZED VIEW <database>.<materialized_view_name> TO <database>.<new_target_table_name>
AS SELECT ... FROM <database>.<kafka_or_rabbitmq_table_name>;Etapa 6: excluir tabelas com mecanismos Kafka/RabbitMQ no cluster de origem
Pouco antes da janela de parada de gravação configurada, exclua as tabelas com mecanismos Kafka/RabbitMQ e suas visualizações materializadas downstream no cluster de origem para interromper as gravações de dados incrementais e garantir a consistência da sincronização final de dados.
-- Drop materialized views first
DROP TABLE <DATABASE>.<MATERIALIZED_VIEW_NAME>;
-- Then drop Kafka/RabbitMQ engine tables
DROP TABLE <DATABASE>.<KAFKA_OR_RABBITMQ_TABLE_NAME>;
Etapa 7: reconstruir tabelas com mecanismos Kafka/RabbitMQ no cluster de destino
Após a conclusão da tarefa de migração, use as instruções DDL salvas anteriormente para reconstruir as tabelas com mecanismos Kafka/RabbitMQ e suas visualizações materializadas downstream no cluster de destino, restaurando o pipeline de consumo de dados incrementais.
Se você realizou uma operação RENAME em tabelas de destino implícitas anteriormente, use a cláusula TO apontando para a tabela de destino renomeada ao reconstruir a visualização materializada. Para mais informações, consulte CREATE MATERIALIZED VIEW.
-- Rebuild Kafka/RabbitMQ engine tables on the destination cluster
CREATE TABLE <database>.<kafka_or_rabbitmq_table_name> (...)
ENGINE = Kafka/RabbitMQ
SETTINGS ...;
-- Rebuild materialized view
CREATE MATERIALIZED VIEW <database>.<materialized_view_name> TO <database>.<target_table_name>
AS SELECT ... FROM <database>.<kafka_or_rabbitmq_table_name>;Etapa 8: (Opcional) cancelar a tarefa de migração
Na página Clusters, selecione a aba Clusters of Community-compatible Edition e clique em ID do cluster de destino.
No painel de navegação à esquerda, clique em Migration from ClickHouse.
Na coluna Actions da tarefa alvo, clique em Stop Migration.
Na caixa de diálogo Stop Migration, clique em OK.
A lista de tarefas pode não ser atualizada imediatamente após o cancelamento. Atualize a página para verificar o status mais recente. Após o cancelamento, o Migration Status muda para Completed . Antes de iniciar uma nova migração, limpe os dados migrados do cluster de destino para evitar duplicação de dados.
Etapa 9: (Opcional) modificar a janela de parada de gravação
Na página Clusters, selecione a aba Clusters of Community-compatible Edition e clique em ID do cluster de destino.
No painel de navegação à esquerda, clique em Migration from ClickHouse.
Na coluna Actions da tarefa alvo, clique em Modify Data Write-Stop Time Window.
Na caixa de diálogo Modify Data Write-Stop Time Window, selecione um novo Write-stop Time. As mesmas regras aplicáveis na criação da tarefa também se aplicam aqui.
Clique em OK.
Próximos passos
Após confirmar que todos os dados de negócio foram migrados com sucesso para o cluster de destino, exclua o cluster de origem.
A exclusão do cluster de origem remove permanentemente todos os dados nele contidos. Esta ação não pode ser desfeita. Verifique se a migração foi concluída antes de prosseguir.
Para instruções de exclusão, consulte Excluir um cluster.