Use o Data Transmission Service (DTS) para sincronizar dados continuamente do ApsaraDB RDS for MySQL para o AnalyticDB for PostgreSQL. O DTS oferece suporte a uma carga inicial completa seguida pela captura contínua de alterações incrementais (CDC), sendo ideal para criar pipelines de análise em tempo real com base em dados OLTP ativos.
Como funciona
A sincronização ocorre em duas fases sequenciais:
Sincronização de schema e dados completosDefinir restriçõesDefinir distribuição de tabela — O DTS copia os schemas das tabelas e todas as linhas existentes do MySQL para o AnalyticDB for PostgreSQL. Esta fase é gratuita.
Incremental data synchronization — O DTS lê o binlog do MySQL e aplica continuamente operações INSERT, UPDATE, DELETE e ADD COLUMN no destino. Esta fase é faturada.
Pré-requisitos
Antes de começar, certifique-se de que:
Todas as tabelas de origem possuem chaves primárias. O DTS exige chaves primárias para executar a sincronização incremental de forma confiável.
A instância de destino do AnalyticDB for PostgreSQL já foi criada. Para mais informações, consulte Criar uma instância do AnalyticDB for PostgreSQL.Criar uma instância do AnalyticDB for PostgreSQL
Limites
|
Restrição |
Detalhes |
|
Objetos de sincronização |
Apenas tabelas podem ser selecionadas. Não é possível selecionar bancos de dados e schemas diretamente. |
|
Tipos de dados não suportados |
BIT, VARBIT, GEOMETRY, ARRAY, UUID, TSQUERY, TSVECTOR, TXID_SNAPSHOT, POINT |
|
Índices de prefixo |
Não são sincronizados. Se as tabelas de origem possuírem índices de prefixo, a sincronização poderá falhar. |
|
Ferramentas de DDL |
Não utilize gh-ost ou pt-online-schema-change para operações de DDL enquanto uma tarefa de sincronização estiver em execução. |
|
CREATE TABLE |
Não suportado. Para incluir uma nova tabela, adicione-a manualmente aos objetos selecionados. Para mais informações, consulte Adicionar um objeto a uma tarefa de sincronização de dados. |
Topologias de sincronização suportadas
Sincronização unidirecional um para um
Sincronização unidirecional um para muitos
Sincronização unidirecional muitos para um
Mapeamento de termos
|
MySQL |
AnalyticDB for PostgreSQL |
|
Banco de dados |
Schema |
|
Tabela |
Tabela |
Configurar uma tarefa de sincronização
Etapa 1: Adquirir uma instância do DTS
Adquirir uma instância do DTS. Na página de compra, defina o seguinte:
Source Instance: MySQL
Target Instance: AnalyticDB for PostgreSQL
Synchronization Topology: One-Way Synchronization
Etapa 2: Configurar o canal de sincronização
Faça login no console do DTS.console do DTS
No painel de navegação à esquerda, clique em Data Synchronization.
Na parte superior da página Synchronization Tasks, selecione a região onde a instância de destino está localizada.
Localize a instância e clique em Configure Synchronization Channel na coluna Actions.
-
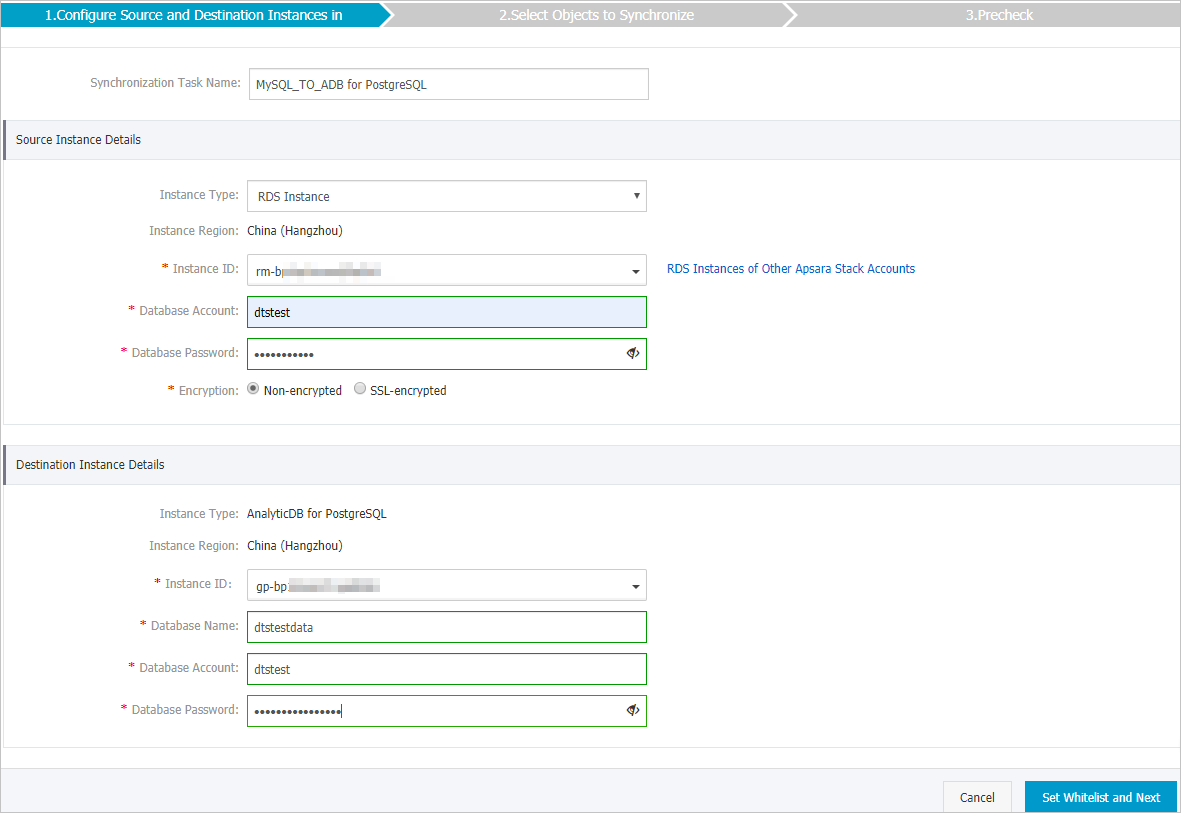
Configure as instâncias de origem e de destino.
Detalhes da instância de origem
Parâmetro Descrição Nome da tarefa de sincronização Gerado automaticamente pelo DTS. Especifique um nome descritivo para identificar a tarefa. O nome não precisa ser único. Tipo de instância Selecione RDS Instance. Região da instância Preenchido automaticamente a partir da página de compra. Não pode ser alterado. ID da instância RDS O ID da instância de origem do ApsaraDB RDS for MySQL. Conta do banco de dados A conta do banco de dados da instância de origem. ImportanteNão obrigatório para MySQL 5.5 ou MySQL 5.6.
Senha do banco de dados A senha da conta do banco de dados. Criptografia Selecione Non-encryptedConfigurar criptografia SSL em uma instância ApsaraDB RDS for MySQL ou SSL-encrypted. Para usar SSL-encrypted, ative primeiro a criptografia SSL na instância RDS. Para mais informações, consulte Configurar criptografia SSL em uma instância ApsaraDB RDS for MySQL.Nota O parâmetro Encryption está disponível apenas nas regiões da China continental e na região China (Hong Kong).NotaO parâmetro Encryption está disponível apenas na China continental e na região China (Hong Kong).
Detalhes da instância de destino
Parâmetro
Descrição
Tipo de instância
Definido como AnalyticDB for PostgreSQL. Não pode ser alterado.
Região da instância
Preenchido automaticamente a partir da página de compra. Não pode ser alterado.
ID da instância
O ID da instância de destino do AnalyticDB for PostgreSQL.
Nome do banco de dados
O nome do banco de dados de destino.
Conta do banco de dados
A initial account da instância do AnalyticDB for PostgreSQL ou uma conta com a permissão RDS_SUPERUSER. Para mais informações, consulte Criar uma conta de banco de dados e Gerenciar usuários e permissões.
Senha do banco de dados
A senha da conta do banco de dados.
-
No canto inferior direito, clique em Set Whitelist and Next. O DTS adiciona automaticamente seus endereços IP de servidor à lista de permissões de instâncias de banco de dados da Alibaba Cloud (como ApsaraDB RDS ou ApsaraDB for MongoDB). Para bancos de dados autogerenciados em instâncias do Elastic Compute Service (ECS), o DTS adiciona automaticamente seus endereços IP às regras do grupo de segurança do ECS — certifique-se de que a instância ECS possa acessar o banco de dados. Se o banco de dados autogerenciado estiver hospedado em várias instâncias ECS, adicione manualmente os blocos CIDR dos servidores DTS às regras do grupo de segurança de cada instância ECS. Para bancos de dados autogerenciados em um data center local ou hospedados por um provedor de nuvem terceirizado, adicione manualmente os blocos CIDR do servidor DTS à lista de permissões de endereços IP do banco de dados. Para mais informações, consulte Adicionar os blocos CIDR dos servidores DTS.
AvisoAdicionar blocos CIDR do DTS à sua lista de permissões ou regras de grupo de segurança introduz riscos potenciais de segurança. Antes de prosseguir, tome medidas preventivas, como usar credenciais fortes, restringir portas expostas, autenticar chamadas de API, revisar regras da lista de permissões regularmente e conectar-se por meio do Express Connect, VPN Gateway ou Smart Access Gateway sempre que possível.
-
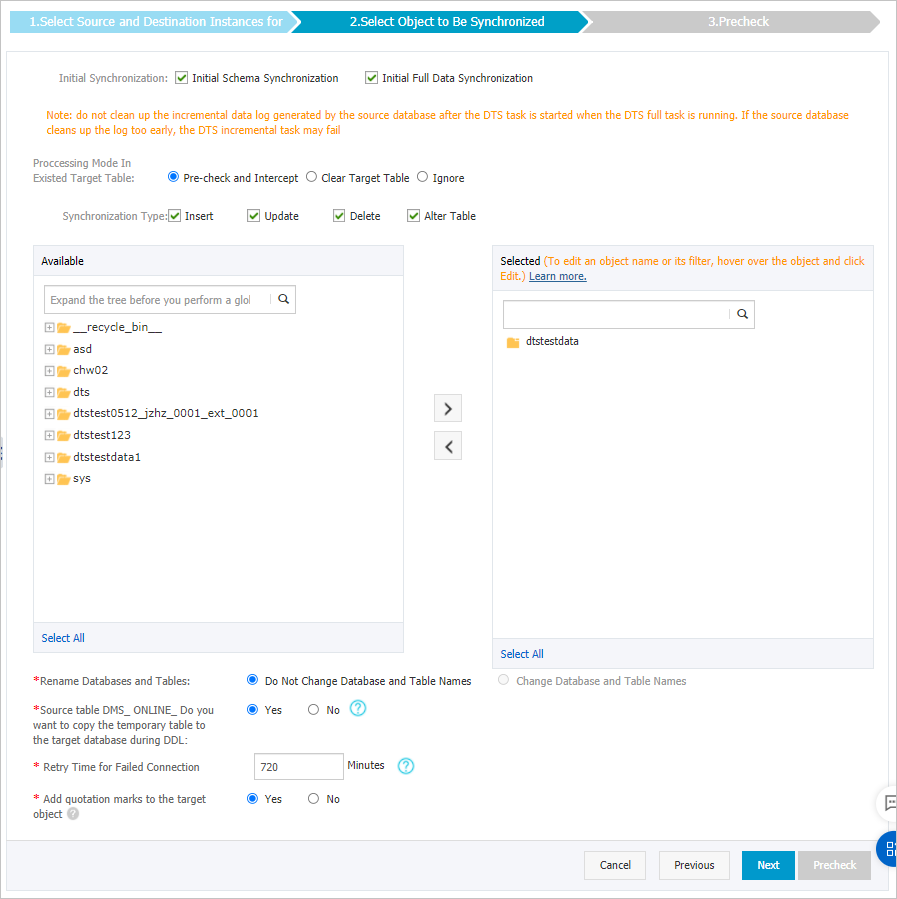
Selecione a política e os objetos de sincronização.
Parâmetro Descrição Sincronização inicial Selecione tanto Initial Schema Synchronization quanto Initial Full Data Synchronization. O DTS sincroniza schemas e dados da origem antes do início da sincronização incremental. Modo de processamento de tabelas conflitantes Clear target table: Ignora o item Schema Name Conflict durante a pré-verificação. Limpa os dados da tabela de destino antes da sincronização completa. Use esta opção para começar do zero, como após testes. Ignore: Ignora o item Schema Name Conflict durante a pré-verificação. Anexa os dados recebidos aos dados existentes no destino. Utilize esta opção para mesclar dados de várias tabelas de origem em uma única tabela de destino. Tipo de sincronização Selecione os tipos de operação a serem sincronizados: Insert, Update, Delete, AlterTable. Selecionar objetos para sincronizar Na seção Available, selecione uma ou mais tabelas e clique no ícone de seta para movê-las para a seção Selected. Use o recurso de mapeamento de nomes de objetos para renomear colunas sincronizadas. Para mais informações, consulte Renomear um objeto a ser sincronizado. Renomear bancos de dados e tabelas Use o recurso de mapeamento de nomes de objetos para renomear objetos sincronizados na instância de destino. Para mais informações, consulte Mapeamento de nomes de objetos. Replicar tabelas temporárias quando o DMS executa operações de DDL Se você utilizar o Data Management (DMS) para operações de DDL online na origem, escolha se deseja sincronizar as tabelas temporárias geradas pelo DMS. Yes: Sincroniza os dados das tabelas temporárias. Grandes operações de DDL podem causar atrasos na sincronização. No: Sincroniza apenas as alterações originais de DDL, sem as tabelas temporárias. As tabelas de destino podem ser bloqueadas temporariamente. Tempo de nova tentativa para conexões com falha Padrão: 720 minutos (12 horas). Se o DTS reconectar dentro desta janela, a tarefa será retomada automaticamente. Caso contrário, a tarefa falhará. Ajuste este valor conforme suas necessidades. NotaA instância do DTS é cobrada durante os períodos de nova tentativa. Libere a instância prontamente se a origem ou o destino não estiverem mais disponíveis.
-
Caso tenha selecionado Initial Schema Synchronization, especifique a coluna de chave primária e a coluna de distribuição para as tabelas a serem sincronizadas com o AnalyticDB for PostgreSQL. Para mais informações, consulte Definir restrições e Definir distribuição de tabela.
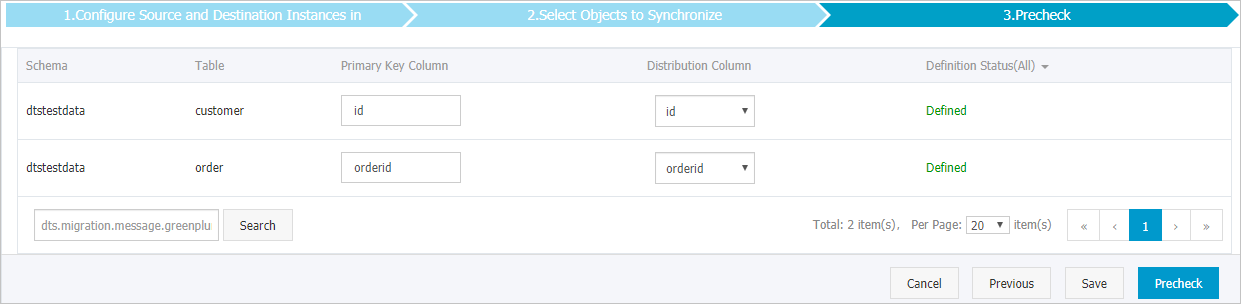
No canto inferior direito, clique em Precheck. O DTS executa uma pré-verificação antes de iniciar a tarefa. Se algum item falhar, clique no ícone ao lado de cada item com falha para visualizar os detalhes. Corrija os problemas e execute a pré-verificação novamente ou ignore os itens com falha e verifique novamente.
Após a aprovação da pré-verificação e a exibição da mensagem The precheck is passed., feche a caixa de diálogo Precheck. A tarefa iniciará automaticamente.
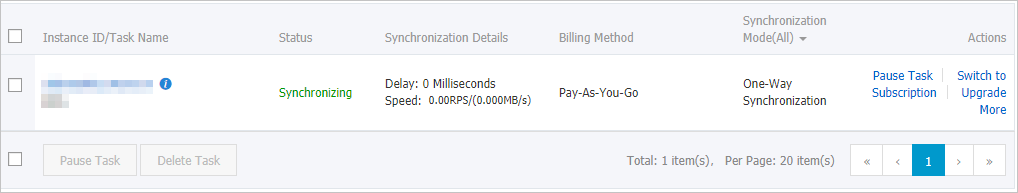
Aguarde até que a sincronização inicial seja concluída e a tarefa entre no estado Synchronizing. Monitore o status da tarefa na página Synchronization Tasks.
Considerações sobre desempenho
O DTS realiza leituras e gravações nos bancos de dados de origem e de destino durante a sincronização inicial completa de dados, o que aumenta a carga do banco de dados. A carga aumenta significativamente se o banco de dados de origem tiver muitas consultas SQL lentas, tabelas sem chaves primárias ou se ocorrerem deadlocks no banco de dados de destino, podendo tornar os serviços de banco de dados indisponíveis.
Execute a tarefa de sincronização fora dos horários de pico, quando a utilização da CPU nos bancos de dados de origem e de destino estiver abaixo de 30%.
Faturamento
|
Tipo de sincronização |
Taxa |
|
Sincronização de schema e sincronização completa de dados |
Gratuita |
|
Sincronização incremental de dados |
Cobrada. Para mais informações, consulte Visão geral do faturamento. |