Use o Data Transmission Service (DTS) para sincronizar dados de um cluster PolarDB for MySQL para uma instância AnalyticDB for PostgreSQL. O DTS executa uma carga inicial completa dos dados, seguida por uma sincronização incremental contínua, mantendo sua instância AnalyticDB for PostgreSQL atualizada com as alterações da source.
Como funciona
O DTS lê o binary log (binlog) do cluster PolarDB for MySQL para capturar alterações no nível da linha. Antes de transmitir as mudanças incrementais, o serviço realiza uma sincronização inicial completa dos dados para estabelecer uma base consistente na instância de destino. A sincronização incremental começa a partir do ponto em que a sincronização completa foi concluída.
Pré-requisitos
Antes de começar, verifique se você tem:
Binary logging ativado no cluster PolarDB for MySQL. Consulte Enable binary logging.Enable binary logging
Chaves primárias em todas as tabelas a serem sincronizadas.
Uma instância AnalyticDB for PostgreSQL. Consulte Create an AnalyticDB for PostgreSQL instance.Create an AnalyticDB for PostgreSQL instance
Limitações
Tipos de objeto
Somente tabelas podem ser selecionadas como objetos de sincronização.
Tipos de dados não suportados
O DTS não sincroniza os seguintes tipos de dados: BIT, VARBIT, GEOMETRY, ARRAY, UUID, TSQUERY, TSVECTOR, TXID_SNAPSHOT e POINT.
Limitações de índice
Índices de prefixo não são suportados na sincronização. Se o cluster source contiver índices desse tipo, a tarefa poderá falhar.
Compatibilidade com ferramentas DDL
Não use gh-ost ou pt-online-schema-change para executar operações DDL nos objetos source durante uma tarefa de sincronização ativa. Essas ferramentas podem causar falhas no processo.
Operações SQL suportadas
|
Tipo |
Operações |
|
DML |
INSERT, UPDATE, DELETE |
|
DDL |
ADD COLUMN |
CREATE TABLE não é suportado. Para sincronizar uma nova tabela, adicione-a aos objetos selecionados na configuração da tarefa. Consulte Add an object to a data synchronization task .
Topologias de sincronização suportadas
Sincronização unidirecional um para um
Sincronização unidirecional um para muitos
Sincronização unidirecional muitos para um
Mapeamento de termos
Ao sincronizar objetos entre o PolarDB for MySQL e o AnalyticDB for PostgreSQL, o DTS aplica o seguinte mapeamento de nomes:
|
PolarDB for MySQL |
AnalyticDB for PostgreSQL |
|
Database |
Schema |
|
Table |
Table |
Considerações sobre desempenho
Impacto na source e no destino durante a sincronização inicial
A sincronização inicial completa dos dados lê do cluster source e grava na instância de destino simultaneamente, o que aumenta a carga em ambos os lados. Para reduzir o risco de degradação do serviço, execute a tarefa de sincronização fora dos horários de pico — quando a utilização da CPU na source e no destino estiver abaixo de 30%.
O consumo elevado de recursos torna-se mais provável se:
O cluster source apresentar um grande volume de consultas lentas.
As tabelas source não possuírem chaves primárias.
A instância de destino enfrentar deadlocks.
Crescimento do tablespace na instância de destino
Operações INSERT concorrentes durante a sincronização inicial completa causam fragmentação das tabelas na instância de destino. Após a conclusão dessa fase, o tablespace da instância de destino será maior que o do cluster source.
Configure a tarefa de sincronização
Etapa 1: Adquirir uma instância DTS
Purchase a DTS instance. Na página de compra, defina os seguintes parâmetros:
Source Instance: PolarDB
Target Instance: AnalyticDB for PostgreSQL
Synchronization Topology: One-Way Synchronization
Etapa 2: Abrir a configuração da tarefa
Faça login no DTS console.DTS console
No painel de navegação à esquerda, clique em Data Synchronization.
Na parte superior da página Synchronization Tasks, selecione a região onde a instância de destino está localizada.
Localize a instância DTS e clique em Configure Synchronization Channel na coluna Actions.
Etapa 3: Configure as instâncias source e de destino
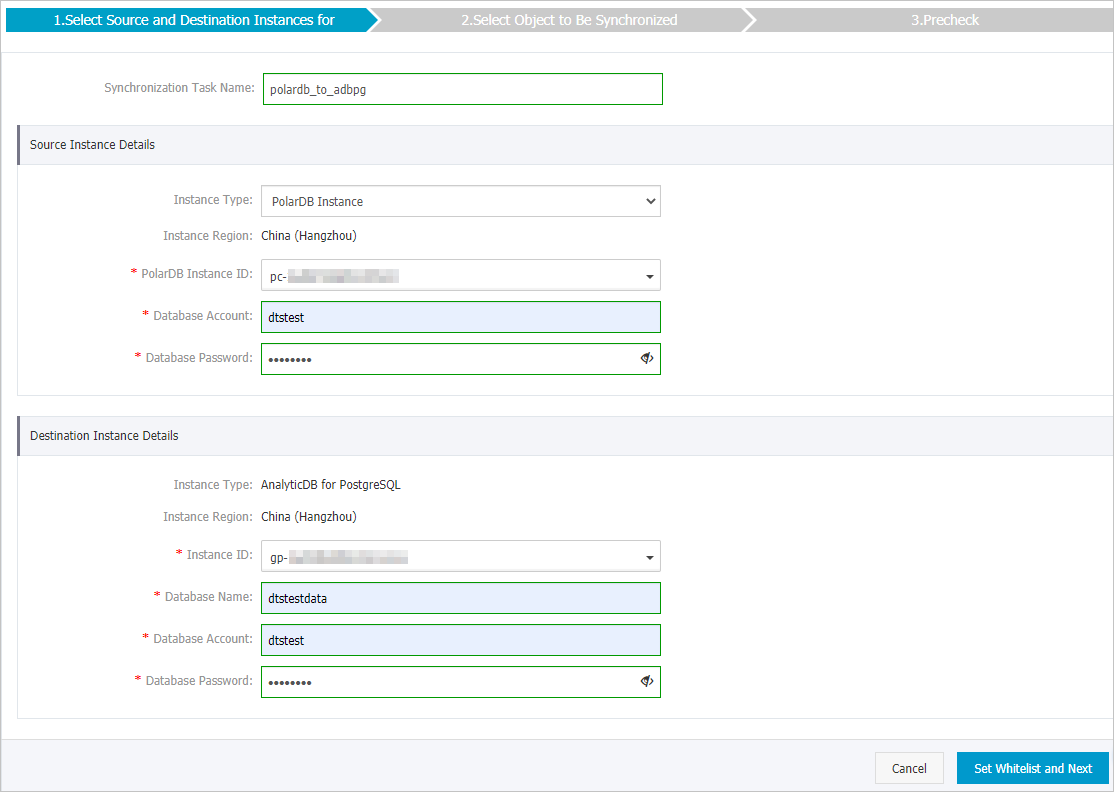
Detalhes da instância source
|
Parâmetro |
Descrição |
|
Synchronization task name |
O DTS gera automaticamente um nome para a tarefa. Recomendamos especificar um nome descritivo para facilitar a identificação. Não é necessário que o nome seja único. |
|
Instance type |
Definido como PolarDB Instance (somente leitura). |
|
Instance region |
Região source selecionada na página de compra (somente leitura). |
|
PolarDB instance ID |
Selecione o ID do cluster PolarDB for MySQL. |
|
Database account |
Insira a conta do banco de dados. A conta deve ter permissões de leitura nos objetos a serem sincronizados. |
|
Database password |
Insira a senha da conta do banco de dados. |
Detalhes da instância de destino
|
Parâmetro |
Descrição |
|
Instance type |
Definido como AnalyticDB for PostgreSQL (somente leitura). |
|
Instance region |
Região de destino selecionada na página de compra (somente leitura). |
|
Instance ID |
Selecione o ID da instância AnalyticDB for PostgreSQL. |
|
Database name |
Insira o nome do banco de dados de destino. |
|
Database account |
Insira a initial account da instância AnalyticDB for PostgreSQL ou uma conta com a permissão RDS_SUPERUSER. Consulte Create a database account e Manage users and permissions. |
|
Database password |
Insira a senha da conta do banco de dados. |
Etapa 4: Configure a lista de permissões e prossiga
Clique em Set Whitelist and Next no canto inferior direito.
O DTS adiciona automaticamente os blocos CIDR dos servidores DTS às listas de permissões do cluster PolarDB for MySQL e da instância AnalyticDB for PostgreSQL, permitindo a conexão do serviço com ambos.
Etapa 5: Selecione a política de sincronização e os objetos
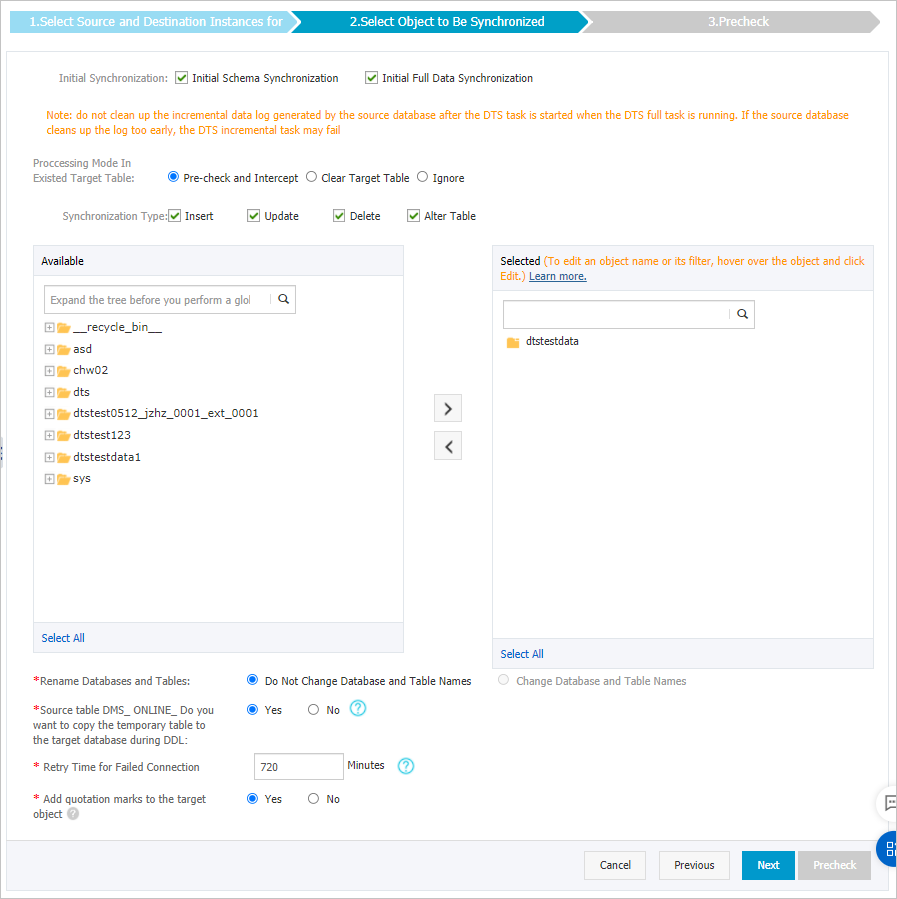
Política de sincronização
|
Parâmetro |
Descrição |
|
Initial synchronization |
Selecione Initial Schema Synchronization e Initial Full Data Synchronization. O DTS sincroniza os schemas e os dados dos objetos selecionados antes de iniciar a sincronização incremental. |
|
Processing mode for conflicting tables |
Clear Target Table: Ignora o item Schema Name Conflict durante a pré-verificação. Limpa todos os dados da tabela de destino antes da sincronização completa inicial. Use esta opção para começar do zero ou após testes. Ignore: Ignora o item Schema Name Conflict durante a pré-verificação. Anexa os dados recebidos aos dados existentes na tabela de destino. Ideal para mesclar dados de várias tabelas em uma só. |
|
Synchronization type |
Selecione os tipos de operação a sincronizar: Insert, Update, Delete, AlterTable. |
Objetos a sincronizar
Na seção Available, selecione as tabelas desejadas e clique em  para movê-las para a seção Selected.
Somente tabelas podem ser selecionadas. Para renomear objetos na instância de destino, use o recurso de mapeamento de nomes de objetos. Consulte Rename an object to be synchronized e Object name mapping .
Replicação DDL online do DMS
Se você usar o Data Management (DMS) para realizar operações DDL online no cluster source, configure a replicação das tabelas temporárias geradas pelo DMS:
Yes: O DTS sincroniza os dados das tabelas temporárias. Isso pode atrasar a tarefa se a operação DDL online gerar grandes volumes de dados.
No: O DTS sincroniza apenas a instrução DDL original, sem os dados das tabelas temporárias. A tabela de destino pode ficar bloqueada durante a operação.
Tempo de nova tentativa para conexões com falha
Por padrão, o DTS tenta reconectar por 720 minutos (12 horas) em caso de falha. Ajuste esse valor conforme suas necessidades. Se a reconexão ocorrer dentro dessa janela, a tarefa retoma automaticamente; caso contrário, ela falhará.
A cobrança do DTS continua durante o período de nova tentativa. Libere a instância DTS prontamente se a instância source ou de destino não estiver mais disponível.
Etapa 6: Configure colunas de chave primária e distribuição
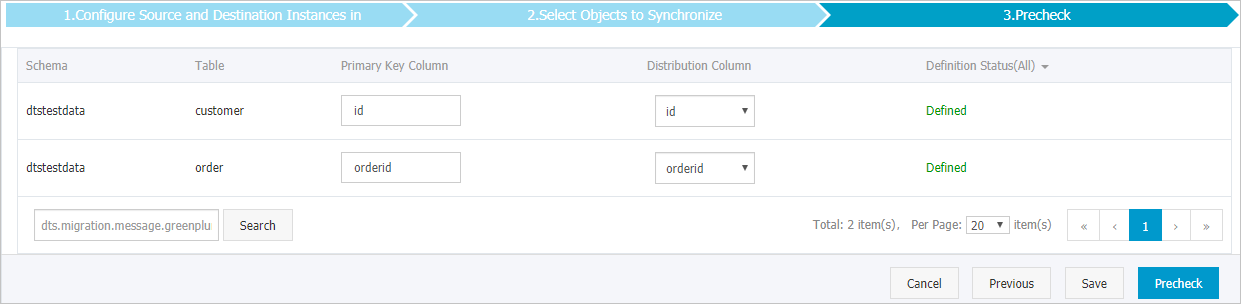
Para cada tabela a ser sincronizada, especifique a coluna de chave primária e a coluna de distribuição na instância AnalyticDB for PostgreSQL. Essas definições determinam como os dados são armazenados e consultados no AnalyticDB for PostgreSQL — configurações incorretas podem afetar o desempenho das consultas e a distribuição dos dados.
Esta etapa aparece apenas se você tiver selecionado Initial Schema Synchronization . Para mais informações, consulte Define constraints Define constraints e Define table distribution Define table distribution .
Etapa 7: Execute a pré-verificação
Clique em Precheck no canto inferior direito. O DTS valida a configuração antes de iniciar a tarefa.
Se algum item da pré-verificação falhar, clique em  ao lado do item com falha para visualizar os detalhes. Corrija o problema e execute uma nova pré-verificação, ou ignore o item com falha e inicie uma nova verificação.
Etapa 8: Iniciar a tarefa de sincronização
Após a aprovação na pré-verificação e o surgimento da mensagem The precheck is passed., feche a caixa de diálogo Precheck. A tarefa de sincronização inicia automaticamente.
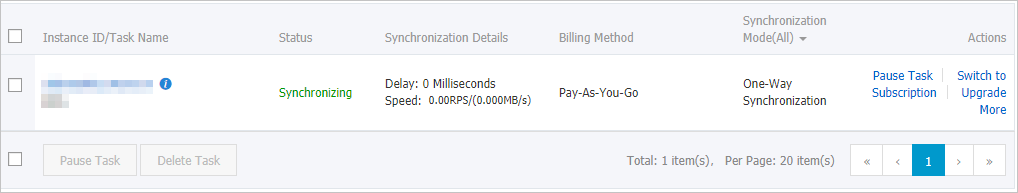
Aguarde a conclusão da sincronização inicial. O status da tarefa mudará para Synchronizing na página Synchronization Tasks.