O Descheduler do ack-koordinator detecta nós sobrecarregados com base na utilização real de recursos e evicta Pods para rebalancear o cluster.
Este tópico descreve como instale o descheduler, ative o desagendamento com detecção de hotspots e configure seus parâmetros avançados.
Limitações
Há suporte apenas para os ACK managed Pro clusters.
-
Versões necessárias dos componentes:
Componente
Versão
ACK Scheduler
v1.22.15-ack-4.0 ou posterior, v1.24.6-ack-4.0 ou posterior
ack-koordinator
v1.1.1-ack.1 ou posterior
Helm
v3.0 ou posterior
O Koordinator Descheduler apenas evicta Pods; o ACK Scheduler é responsável pelo reagendamento. Use o desagendamento com o agendamento com base na carga para evitar que os Pods evictados retornem a nós com hotspots.
Durante o desagendamento, o sistema evicta os Pods antigos antes de criar novos Pods. Certifique-se de que sua aplicação tenha réplicas redundantes suficientes para manter a disponibilidade.
O desagendamento usa a API REST de eviction (ou rest API) padrão do Kubernetes. Certifique-se de que seus Pods sejam reentrantes, para que as reinicializações após a evicção não interrompam seu service.
Faturamento
O ack-koordinator é gratuito para instalação e uso. Contudo, podem ser aplicadas cobranças adicionais nos seguintes cenários:
Recursos de nós workers: o ack-koordinator é um componente autogerenciado que consome recursos dos nós workers. Durante a instalação, configure as solicitações de recursos para cada módulo.
Métricas personalizadas do Prometheus: se você ativar Enable Prometheus Monitoring for ACK-Koordinator e usar o Managed service for Prometheus, o sistema contabiliza as métricas expostas como métricas personalizadas e gera cobrança. As taxas dependem do tamanho do cluster e da quantidade de aplicações. Revise o faturamento de instâncias do Prometheus antes de ativar este recurso. Consulte os dados de uso para monitorar o consumo de recursos.
Como funciona
Ciclo de execução
O Koordinator Descheduler é executado periodicamente. Cada ciclo de execução possui três etapas:
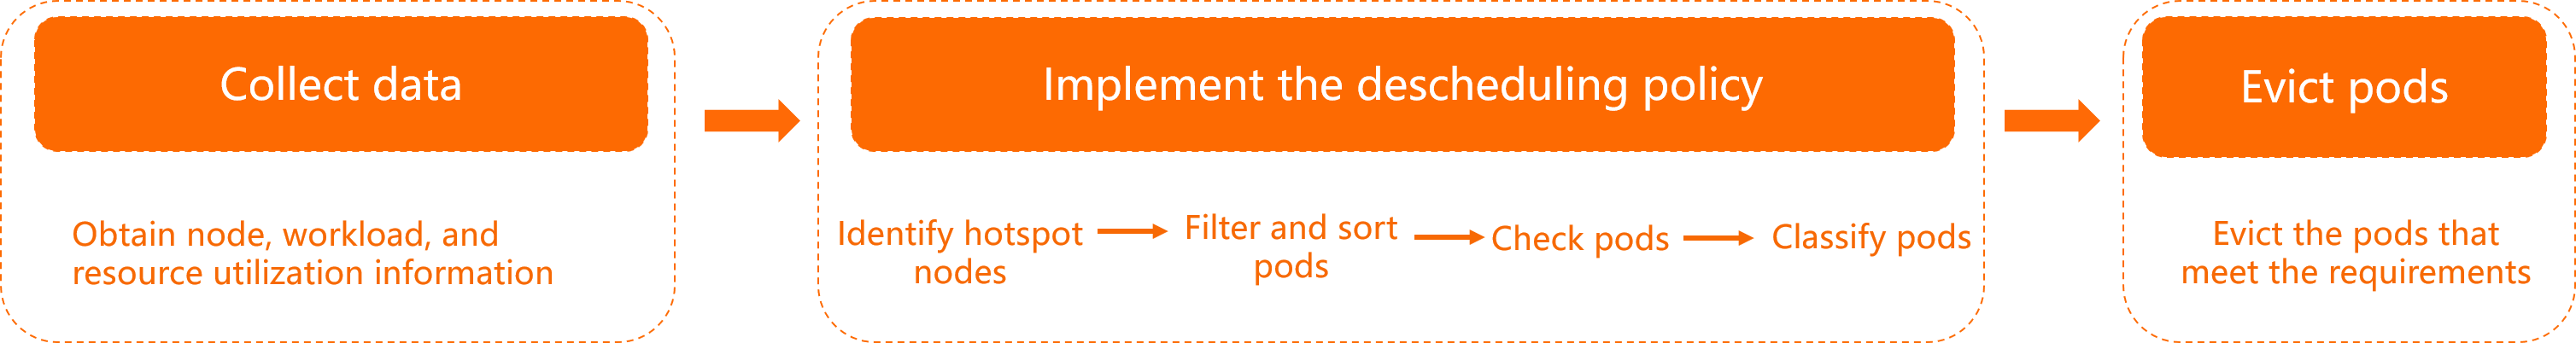
Coleta de dados: busca informações de nós e workloads, além de dados de utilização de recursos.
-
Execução de plugins (exemplo do LowNodeLoad):
Identifica nós com hotspots com base em
highThresholdselowThresholds.Percorre todos os nós com hotspots, pontua os Pods elegíveis e os ordena para evicção. Consulte a Política de pontuação de Pods.
Verifica cada Pod candidato em relação às restrições de migração (capacidade do cluster, utilização de recursos e limites de proporção de réplicas). Consulte as Políticas de desagendamento de hotspots com base na carga.
Marca os Pods aprovados como candidatos à migração e ignora os demais.
Evicção e migração de Pods: evicta os candidatos à migração por meio da API de eviction.
Classificação de nós
O plugin LowNodeLoad classifica os nós em três categorias com base em dois limiares: lowThresholds (limiar de ociosidade) e highThresholds (limiar de hotspot).
Exemplo com lowThresholds = 45% e highThresholds = 70%:

Nó ocioso: a utilização de recursos está abaixo de
lowThresholds(< 45%).Nó normal: a utilização de recursos está entre
lowThresholdsehighThresholds(45%–70%). Esta é a faixa ideal.Nó com hotspot: a utilização de recursos excede
highThresholds(> 70%). O sistema evicta os Pods até que a carga do nó caia para 70% ou menos.
Os dados de utilização de recursos são atualizados a cada minuto e refletem a média de 5 minutos.
Se todos os nós excederemlowThresholds, o sistema considera a carga do cluster alta e suspende o desagendamento, mesmo que alguns nós excedamhighThresholds.
Políticas de desagendamento de hotspots com base na carga
|
Política |
Descrição |
|
|
Repetição da verificação de hotspot |
O sistema classifica um nó como hotspot somente após ele exceder |
|
|
Ordenação de nós |
O desagendamento começa pelo nó com hotspot de maior utilização. O sistema compara CPU e memória em ordem. |
|
|
Pontuação de Pods |
Para cada nó com hotspot, o sistema pontua e ordena os Pods antes da evicção: (1) prioridade (Priority class) mais baixa primeiro (o padrão é 0, a mais baixa); (2) classe de QoS mais baixa; (3) para prioridade e QoS iguais, os Pods são classificados por utilização de recursos e tempo de inicialização. Configure as classes de Priority ou QoS para controlar a ordem de evicção. |
|
|
Filtro |
Restringe o desagendamento a namespaces, Pods ou nós específicos usando seletores de rótulos. Consulte |
|
|
Pré-verificação |
Antes da evicção, o descheduler verifica: (1) se existem nós correspondentes a Node Affinity, Node Selector, Tolerations e requisitos de recursos; (2) se o nó de destino tem capacidade suficiente sem exceder |
|
|
Limitação de migração |
Limita as migrações simultâneas de Pods por nó, namespace e workload. Uma janela de tempo impede que os Pods do mesmo workload migrem com muita frequência. Compatível com o Pod Disruption Budget (PDB) do Kubernetes para um controle de disponibilidade mais refinado. |
|
|
Observabilidade |
O sistema emite eventos de migração para cada Pod, mostrando o motivo e o status. Para monitorar, execute |
grep |
Pré-requisitos
Antes de começar, certifique-se de que você tem:
ACK Scheduler v1.22.15-ack-4.0 ou posterior, ack-koordinator v1.1.1-ack.1 ou posterior e Helm v3.0 ou posterior
Etapa 1: Ativar o desagendamento no ack-koordinator
Nova instalação: instale o ack-koordinator e selecione Enable ACK-Koordinator Descheduling Module na página de configuração.
Instalação existente: na página de configuração, selecione Enable ACK-Koordinator Descheduling Module. Consulte modifique o ack-koordinator.
Etapa 2: Ativar o plugin LowNodeLoad
-
Para começar, crie um ConfigMap
koord-descheduler-config.yamlpara ativar o plugin LowNodeLoad.# koord-descheduler-config.yaml apiVersion: v1 kind: ConfigMap metadata: name: koord-descheduler-config namespace: kube-system data: koord-descheduler-config: | # System configuration for koord-descheduler. Do not modify this section. apiVersion: descheduler/v1alpha2 kind: DeschedulerConfiguration leaderElection: resourceLock: leases resourceName: koord-descheduler resourceNamespace: kube-system deschedulingInterval: 120s # Execution interval. The descheduler runs every 120s. # Must not exceed detectorCacheTimeout (default: 5m). dryRun: false # Set to true to run in read-only mode (no evictions). # End of system configuration. profiles: - name: koord-descheduler plugins: balance: enabled: - name: LowNodeLoad # Enable the LowNodeLoad plugin for hot spot descheduling. evict: enabled: - name: MigrationController # Enable the eviction and migration controller. pluginConfig: - name: MigrationController args: apiVersion: descheduler/v1alpha2 kind: MigrationControllerArgs defaultJobMode: EvictDirectly - name: LowNodeLoad args: apiVersion: descheduler/v1alpha2 kind: LowNodeLoadArgs # A node is idle if usage of ALL resources is below lowThresholds. lowThresholds: cpu: 20 # 20% CPU utilization memory: 30 # 30% memory utilization # A node is a hot spot if usage of ANY resource exceeds highThresholds. highThresholds: cpu: 50 # 50% CPU utilization memory: 60 # 60% memory utilization # Scopes descheduling to specific namespaces. # include and exclude are mutually exclusive—configure only one. evictableNamespaces: include: - default # exclude: # - "kube-system" # - "koordinator-system" -
Aplique o ConfigMap no cluster.
kubectl apply -f koord-descheduler-config.yaml -
Reinicie o Koordinator Descheduler para carregar a nova configuração.
kubectl -n kube-system scale deploy ack-koord-descheduler --replicas 0
kubectl -n kube-system scale deploy ack-koord-descheduler --replicas 1
Etapa 3 (opcional): Ativar o agendamento com base na carga
Para um balanceamento de carga ideal, ative o agendamento com base na carga para que o ACK Scheduler evite colocar Pods em nós com hotspots após a evicção.
Para isso, defina loadAwareThreshold para corresponder a highThresholds. Valores incompatíveis podem fazer com que os Pods evictados sejam reagendados em nós com hotspots, especialmente quando há poucos nós com utilização semelhante.
Etapa 4: Verificar o desagendamento
Este exemplo utiliza um cluster de três nós, em que cada nó possui 104 núcleos e 396 GiB de memória.
-
Primeiro, crie um arquivo
stress-demo.yamlcom o seguinte conteúdo.apiVersion: apps/v1 kind: Deployment metadata: name: stress-demo namespace: default labels: app: stress-demo spec: replicas: 6 selector: matchLabels: app: stress-demo template: metadata: name: stress-demo labels: app: stress-demo spec: containers: - args: - '--vm' - '2' - '--vm-bytes' - '1600M' - '-c' - '2' - '--vm-hang' - '2' command: - stress image: polinux/stress imagePullPolicy: Always name: stress resources: limits: cpu: '2' memory: 4Gi requests: cpu: '2' memory: 4Gi restartPolicy: Always -
Implante o workload de teste de estresse.
kubectl create -f stress-demo.yamlSaída esperada:
deployment.apps/stress-demo created -
Em seguida, verifique se os Pods estão em execução e anote o nó atribuído a eles.
kubectl get pod -o wideSaída esperada:
NAME READY STATUS RESTARTS AGE IP NODE NOMINATED NODE READINESS GATES stress-demo-588f9646cf-s**** 1/1 Running 0 82s 10.XX.XX.53 cn-beijing.10.XX.XX.53 <none> <none> -
Aumente a carga em
cn-beijing.10.XX.XX.53e verifique a utilização do nó.kubectl top nodeSaída esperada:
NAME                      CPU(cores)   CPU%   MEMORY(bytes)   MEMORY%
cn-beijing.10.XX.XX.215   17611m       17%    24358Mi         6%
cn-beijing.10.XX.XX.53    63472m       63%    11969Mi         3%
O nó
cn-beijing.10.XX.XX.53está com 63% de CPU, excedendo o limiar de hotspot de 50%. O nócn-beijing.10.XX.XX.215está com 17% de CPU, abaixo do limiar de ociosidade de 20%. Em seguida, ative o plugin LowNodeLoad conforme descrito na Etapa 2: Ativar o plugin LowNodeLoad.
-
Monitore as alterações nos Pods.
Por padrão, um nó deve exceder
highThresholdspor cinco verificações consecutivas (cerca de 10 minutos no intervalo padrão de 120 segundos) para ser classificado como um hotspot.kubectl get pod -wSaída esperada:
NAME READY STATUS RESTARTS AGE IP NODE NOMINATED NODE READINESS GATES stress-demo-588f9646cf-s**** 1/1 Terminating 0 59s 10.XX.XX.53 cn-beijing.10.XX.XX.53 <none> <none> stress-demo-588f9646cf-7**** 1/1 ContainerCreating 0 10s 10.XX.XX.215 cn-beijing.10.XX.XX.215 <none> <none> -
Por fim, verifique o evento de evicção.
kubectl get event | grep stress-demo-588f9646cf-s****Saída esperada:
2m14s   Normal   Evicting        podmigrationjob/00fe88bd-****   Pod "default/stress-demo-588f9646cf-s****" evicted from node "cn-beijing.10.XX.XX.53" by the reason "node is overutilized, cpu usage(68.53%)>threshold(50.00%)"
101s    Normal   EvictComplete   podmigrationjob/00fe88bd-****   Pod "default/stress-demo-588f9646cf-s****" has been evicted
2m14s   Normal   Descheduled     pod/stress-demo-588f9646cf-s****   Pod evicted from node "cn-beijing.10.XX.XX.53" by the reason "node is overutilized, cpu usage(68.53%)>threshold(50.00%)"
2m14s   Normal   Killing         pod/stress-demo-588f9646cf-s****   Stopping container stress
O descheduler evictou o Pod no nó com hotspot e o migrou para
cn-beijing.10.XX.XX.215.
Configuração avançada
Todos os parâmetros do Koordinator Descheduler são configurados no ConfigMap da Etapa 2.
# koord-descheduler-config.yaml
apiVersion: v1
kind: ConfigMap
metadata:
  name: koord-descheduler-config
  namespace: kube-system
data:
  koord-descheduler-config: |
    # System configuration. Do not modify this section.
    apiVersion: descheduler/v1alpha2
    kind: DeschedulerConfiguration
    leaderElection:
      resourceLock: leases
      resourceName: koord-descheduler
      resourceNamespace: kube-system
    deschedulingInterval: 120s  # Execution interval. Must not exceed detectorCacheTimeout.
    dryRun: false               # Set to true for read-only mode (no evictions).
    # End of system configuration.

    profiles:
    - name: koord-descheduler
      plugins:
        deschedule:
          disabled:
            - name: "*"  # All plugins disabled by default (shown for reference only).
        balance:
          enabled:
            - name: LowNodeLoad
        evict:
          disabled:
            - name: "*"  # All plugins disabled by default (shown for reference only).
          enabled:
            - name: MigrationController

      pluginConfig:
      - name: MigrationController
        args:
          apiVersion: descheduler/v1alpha2
          kind: MigrationControllerArgs
          defaultJobMode: EvictDirectly
          maxMigratingPerNode: 1       # Max Pods migrating simultaneously per node. 0 = unlimited.
          maxMigratingPerNamespace: 1  # Max Pods migrating simultaneously per namespace.
          maxMigratingPerWorkload: 1   # Max Pods migrating simultaneously per workload (e.g., Deployment).
          maxUnavailablePerWorkload: 2 # Max unavailable replicas per workload during migration.
          evictLocalStoragePods: false # Whether to evict Pods using HostPath or emptyDir volumes.
          objectLimiters:
            workload:               # At most 1 replica migrated per workload within 5 minutes.
              duration: 5m
              maxMigrating: 1

      - name: LowNodeLoad
        args:
          apiVersion: descheduler/v1alpha2
          kind: LowNodeLoadArgs

          lowThresholds:
            cpu: 20
            memory: 30
          highThresholds:
            cpu: 50
            memory: 60

          anomalyCondition:
            consecutiveAbnormalities: 5  # Number of consecutive checks above highThresholds
                                          # before a node is classified as a hot spot.
                                          # Counter resets after eviction.

          detectorCacheTimeout: "5m"  # Cache duration for hot spot checks.
                                      # Must be >= deschedulingInterval.

          evictableNamespaces:
            include:
              - default
            # exclude:
            #   - "kube-system"
            #   - "koordinator-system"

          nodeSelector:  # Process only the specified nodes.
            matchLabels:
              alibabacloud.com/nodepool-id: np77f520e1108f47559e63809713ce****

          podSelectors:  # Process only the specified Pods.
          - name: lsPods
            selector:
              matchLabels:
                koordinator.sh/qosClass: "LS"
Configuração do sistema do Koordinator Descheduler
|
Parâmetro |
Tipo |
Valor |
Descrição |
Exemplo |
|
|
boolean |
|
Alternador do modo somente leitura. Quando ativado, o sistema não inicia nenhuma migração de Pod. |
|
|
|
time.Duration |
> 0s |
Intervalo de execução. Não deve exceder |
|
Configuração de controle de evicção e migração
|
Parâmetro |
Tipo |
Valor |
Descrição |
Exemplo |
|
|
int64 |
≥ 0 (padrão: 2) |
Máximo de Pods migrando simultaneamente por nó. |
|
|
|
int64 |
≥ 0 (padrão: ilimitado) |
Máximo de Pods migrando simultaneamente por namespace. |
|
|
|
intOrString |
≥ 0 (padrão: 10%) |
Máximo de Pods migrando ou porcentagem por workload (por exemplo, Deployment). |
|
|
|
intOrString |
≥ 0 (padrão: 10%), menor que o total de réplicas |
Máximo de réplicas indisponíveis ou porcentagem por workload. |
|
|
|
boolean |
|
Define se Pods com volumes HostPath ou emptyDir devem ser evictados. Desativado por padrão para segurança dos dados. |
|
|
|
struct |
Duration > 0s (padrão: |
Limitação de migração no nível do workload. |
|
Configuração do plugin LowNodeLoad
|
Parâmetro |
Tipo |
Valor |
Descrição |
Exemplo |
|
|
map[string]float64 |
[0, 100] (CPU e memória, em porcentagem) |
Limiar de hotspot. Pods em nós acima deste valor são elegíveis para evicção. Se todos os nós excederem |
|
|
|
map[string]float64 |
[0, 100] (CPU e memória, em porcentagem) |
Limiar de ociosidade. Se todos os nós excederem este valor, o sistema considera a carga geral do cluster alta e suspende o desagendamento. |
|
|
|
int64 |
> 0 (padrão: 5) |
Ciclos consecutivos em que um nó deve exceder |
|
|
|
\*metav1.Duration |
Consulte Formato de Duration (padrão: |
Duração do cache para verificações de hotspot. Deve ser ≥ |
|
|
|
include: string / exclude: string |
Namespaces no cluster |
Restringe o desagendamento a namespaces específicos. Deixe em branco para processar todos os Pods. |
|
|
|
metav1.LabelSelector |
Consulte Rótulos e seletores |
Restringe o desagendamento a nós específicos usando um seletor de rótulos. Suporta pool de nós único ( |
|
|
|
list of PodSelector |
Consulte Rótulos e seletores |
Restringe o desagendamento a Pods específicos usando seletores de rótulos. Há suporte para múltiplos grupos de seletores. |
|
Perguntas frequentes
A utilização do nó excede o limiar, mas os Pods não são evictados
A causa mais comum é a configuração do descheduler estar inativa. Verifique os seguintes itens na ordem:
Escopo não configurado: o descheduler processa apenas namespaces e nós explicitamente incluídos (ou não excluídos). Verifique
evictableNamespacesenodeSelector.Descheduler não reiniciado após alteração de configuração: alterações de configuração exigem uma reinicialização. Consulte a Etapa 2 para obter instruções.
Intervalo maior que o tempo limite do cache:
deschedulingInterval(padrão: 2 min) não deve excederdetectorCacheTimeout(padrão: 5 min); caso contrário, a detecção de hotspots falhará. Ajuste e reinicie.Nó não está consistentemente acima do limiar: o descheduler usa uma média suavizada. O sistema classifica um nó como hotspot somente após ele exceder
highThresholdsporconsecutiveAbnormalitiesciclos consecutivos (padrão: 5, ~10 minutos). O comandokubectl top nodereflete apenas o último minuto; monitore por um período mais longo e confirme a utilização sustentada.Capacidade insuficiente do cluster: antes de evictar um Pod, o descheduler verifica se outro nó possui capacidade livre suficiente. Se nenhum tiver, o sistema ignora a evicção. Adicione nós para aumentar a capacidade.
Workload de réplica única: o sistema não evicta Pods de réplica única por padrão. Para substituir isso, adicione a anotação
descheduler.alpha.kubernetes.io/evict: "true"ao Pod ou aospec.template.metadatado workload. Não há suporte nas versões do ack-koordinator v1.3.0-ack1.6 até v1.3.0-ack1.8. Atualize para a versão mais recente para usar este recurso.Pod usa HostPath ou emptyDir: excluídos do desagendamento por padrão. Defina
evictLocalStoragePods: trueno MigrationController para ativar a evicção. Consulte a Configuração de controle de evicção e migração.Muitas réplicas indisponíveis ou em migração: se as réplicas indisponíveis ou em migração atingirem
maxUnavailablePerWorkloadoumaxMigratingPerWorkload, o sistema bloqueia novas evicções. Aguarde a conclusão das evicções em andamento ou aumente esses limites.Contagem de réplicas ≤ limite de migração: se o total de réplicas for ≤
maxMigratingPerWorkloadoumaxUnavailablePerWorkload, o sistema ignora o workload. Diminua esses valores ou use porcentagens.
O descheduler reinicia com frequência
Um ConfigMap inválido ou ausente causa loops de reinicialização. Verifique o formato do ConfigMap em relação à Configuração avançada e, em seguida, reinicie conforme descrito na Etapa 2.
Como o agendamento com base na carga e o desagendamento de hotspots funcionam juntos
Ative ambos os recursos para um balanceamento de carga ideal. O desagendamento evicta Pods de nós sobrecarregados; o agendamento com base na carga coloca os Pods reagendados em nós com menor utilização.
Para isso, defina loadAwareThreshold para corresponder a highThresholds. Consulte Usar o agendamento com base na carga e Políticas de agendamento.
Quais dados de utilização o descheduler usa?
O descheduler calcula uma média suavizada ao longo de múltiplos ciclos. O sistema aciona a evicção apenas quando o uso médio permanece acima de highThresholds pelos ciclos consecutivos configurados (padrão: ~10 minutos).
O descheduler exclui o page cache dos cálculos de memória (recuperável pelo SO). O comando kubectl top node inclui o page cache; use o Managed Service for Prometheus para visualizar a métrica real.