Configure cotas hierárquicas com mínimos garantidos para compartilhar a capacidade ociosa do cluster entre equipes.
O ResourceQuota nativo do Kubernetes impõe limites fixos de recursos e frequentemente deixa recursos ociosos quando as equipes não utilizam totalmente sua cota. O ACK implementa o agendamento de capacidade por meio da extensão do framework de agendamento e substitui esse modelo estático por grupos de cota elástica: recursos ociosos são compartilhados e recuperados quando os proprietários precisam deles. Isso melhora a utilização do cluster sem comprometer as garantias de recursos.
Pré-requisitos
Verifique se você tem:
Um cluster ACK gerenciado Pro executando Kubernetes 1.20 ou posterior
Conceitos principais
ElasticQuotaTree é uma CustomResourceDefinition (CRD) que define uma hierarquia de grupos de cota elástica. Cada nó representa um limite de cota. Os nós folha mapeiam para um ou mais namespaces, e os pods nesses namespaces são agendados dentro dos limites de cota do respectivo nó folha.
Os dois campos principais em cada nó de cota são:
|
Campo |
Significado |
|
|
Recursos garantidos. O agendador garante essa quantidade disponível e recupera recursos emprestados se necessário. |
|
|
Recursos máximos que o nó de cota pode usar, incluindo recursos ociosos emprestados de outros nós. |
O empréstimo e a recuperação de recursos funcionam da seguinte forma:
Um pod é agendado se seus recursos solicitados, somados ao uso atual do nó, permanecerem dentro de
max.Se o uso do nó exceder
min, o excedente é emprestado da capacidade ociosa em outra parte da árvore.Quando outro nó de cota precisa recuperar seus recursos
min, o agendador seleciona pods do nó mutuário para evicção com base em fatores como prioridade do job, disponibilidade e horário de criação.
Recursos
Cotas hierárquicas: Configure cotas elásticas em vários níveis (por exemplo, correspondendo à estrutura da sua organização). Cada nó folha pode mapear para vários namespaces, mas cada namespace pertence a apenas um nó folha.
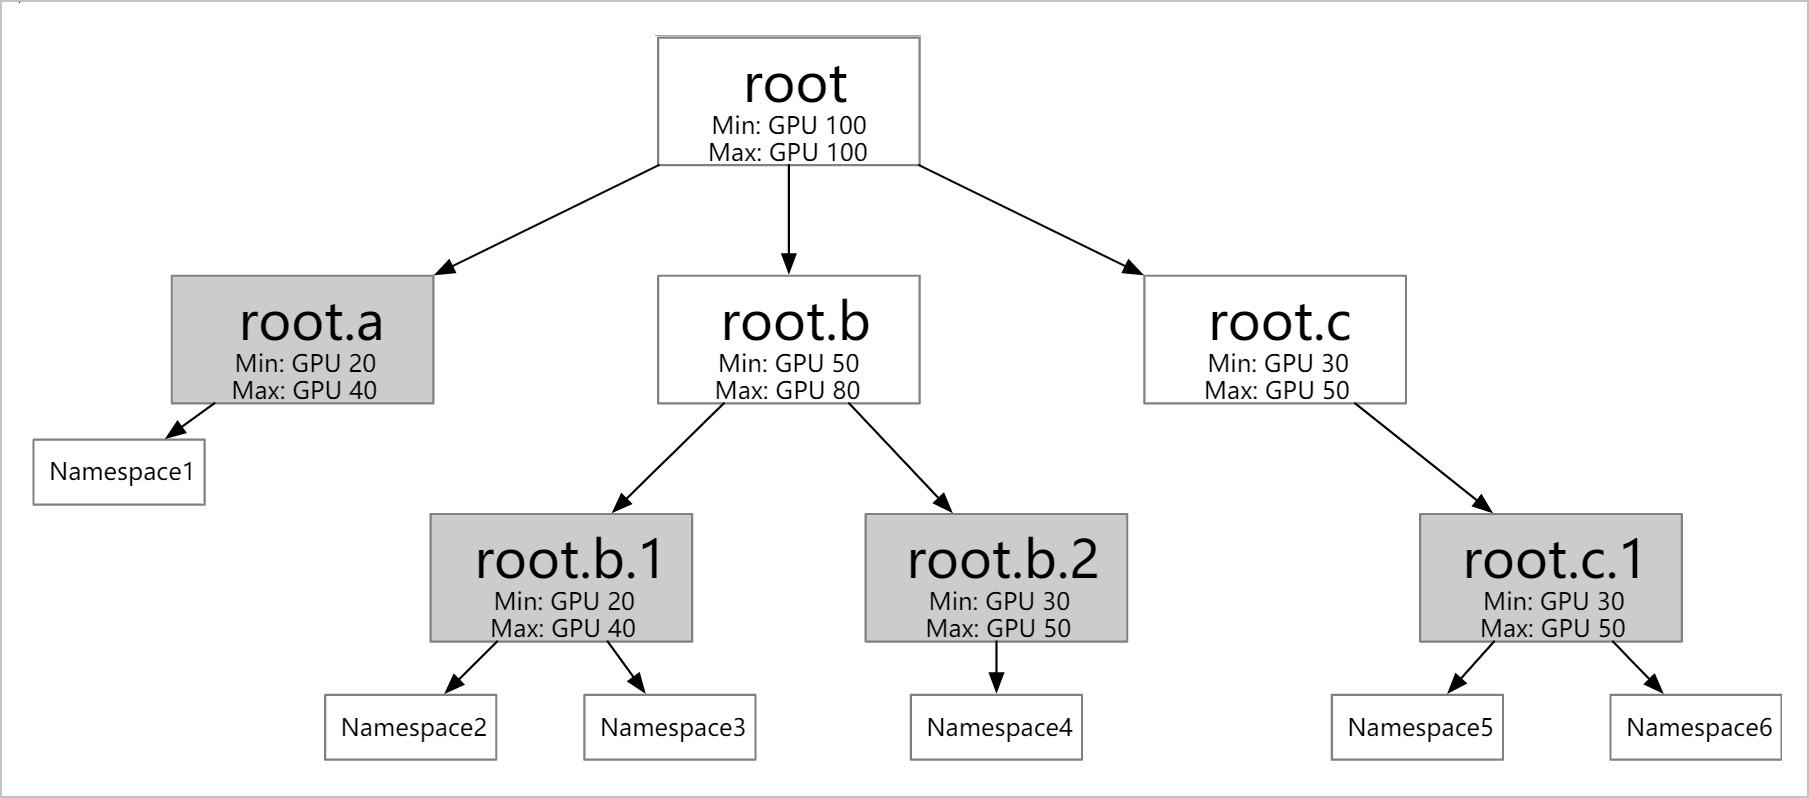
Empréstimo e recuperação de recursos: Outros nós de cota podem emprestar recursos
minociosos. A recuperação dos recursos emprestados ocorre automaticamente quando o proprietário original precisa deles.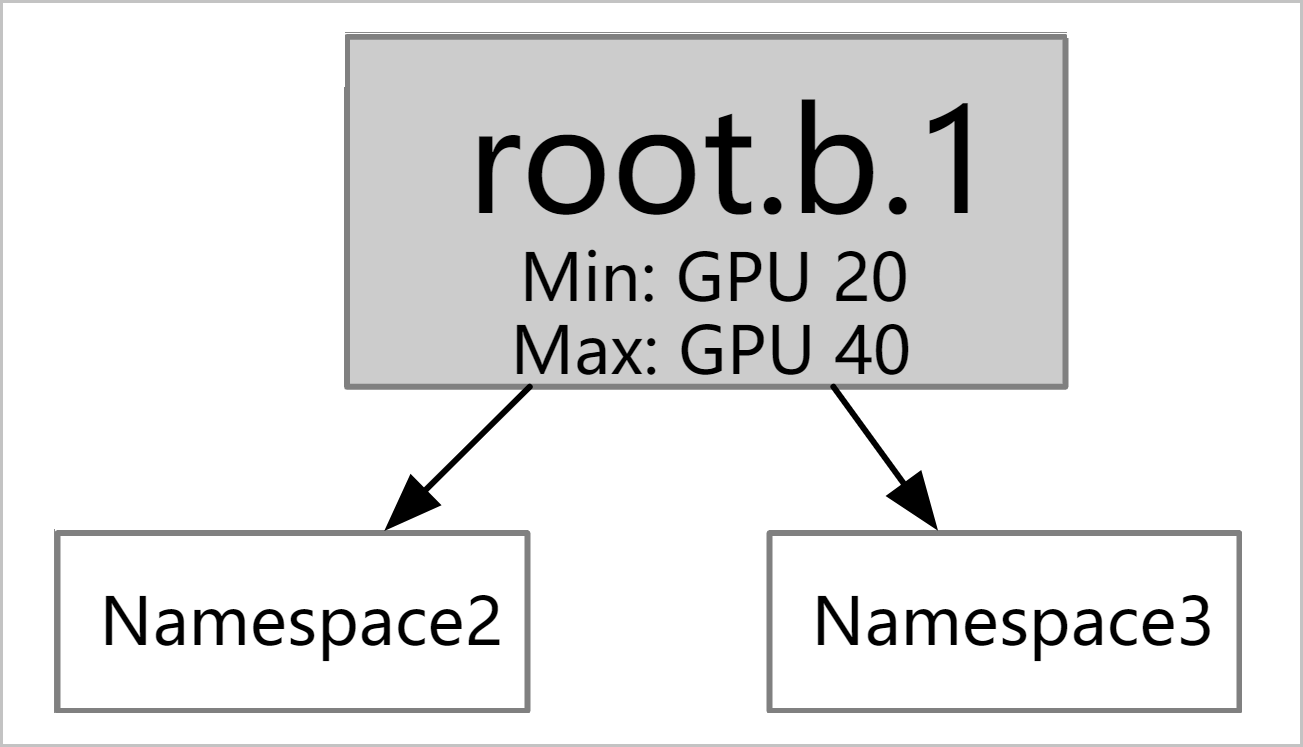
Suporte a recursos estendidos: Além de CPU e memória, o agendamento de capacidade suporta GPU (
nvidia.com/gpu) e outros tipos de recursos suportados pelo Kubernetes.Afinidade de nó com ResourceFlavor: Anexe um ResourceFlavor a um nó de cota para restringir os pods dessa cota a nós específicos. Consulte Configurar ResourceFlavor para afinidade de nó.
Configurar o agendamento de capacidade
Este exemplo utiliza um cluster com um único nó ecs.sn2.13xlarge (56 vCPUs e 224 GiB de memória).
Etapa 1: Crie namespaces
kubectl create ns namespace1
kubectl create ns namespace2
kubectl create ns namespace3
kubectl create ns namespace4
Etapa 2: Crie uma ElasticQuotaTree
Crie a ElasticQuotaTree no namespace kube-system. Este exemplo usa uma hierarquia de dois níveis com quatro nós de cota folha.
A ElasticQuotaTree só entra em vigor quando criada no namespace kube-system.
apiVersion: scheduling.sigs.k8s.io/v1beta1
kind: ElasticQuotaTree
metadata:
  name: elasticquotatree
  namespace: kube-system
spec:
  root:
    name: root
    max:
      cpu: 40
      memory: 40Gi
      nvidia.com/gpu: 4
    min:
      cpu: 40
      memory: 40Gi
      nvidia.com/gpu: 4
    children:
      - name: root.a
        max:
          cpu: 40
          memory: 40Gi
          nvidia.com/gpu: 4
        min:
          cpu: 20
          memory: 20Gi
          nvidia.com/gpu: 2
        children:
          - name: root.a.1
            namespaces:
              - namespace1
            max:
              cpu: 20
              memory: 20Gi
              nvidia.com/gpu: 2
            min:
              cpu: 10
              memory: 10Gi
              nvidia.com/gpu: 1
          - name: root.a.2
            namespaces:
              - namespace2
            max:
              cpu: 20
              memory: 40Gi
              nvidia.com/gpu: 2
            min:
              cpu: 10
              memory: 10Gi
              nvidia.com/gpu: 1
      - name: root.b
        max:
          cpu: 40
          memory: 40Gi
          nvidia.com/gpu: 4
        min:
          cpu: 20
          memory: 20Gi
          nvidia.com/gpu: 2
        children:
          - name: root.b.1
            namespaces:
              - namespace3
            max:
              cpu: 20
              memory: 20Gi
              nvidia.com/gpu: 2
            min:
              cpu: 10
              memory: 10Gi
              nvidia.com/gpu: 1
          - name: root.b.2
            namespaces:
              - namespace4
            max:
              cpu: 20
              memory: 20Gi
              nvidia.com/gpu: 2
            min:
              cpu: 10
              memory: 10Gi
nvidia.com/gpu: 1A ElasticQuotaTree deve satisfazer estas restrições:
Dentro de cada nó de cota:
min≤maxPara cada nó pai: soma dos valores
mindos filhos ≤ valormindo paiPara o nó raiz:
min=max≤ total de recursos do clusterCada namespace pertence exatamente a um nó folha; um nó folha pode conter vários namespaces
Etapa 3: Verifique a ElasticQuotaTree
kubectl get ElasticQuotaTree -n kube-systemSaída esperada:
NAME               AGE
elasticquotatree   68s
Observar o empréstimo e a recuperação de recursos
Estes cenários mostram como o empréstimo e a recuperação funcionam à medida que as cargas de trabalho são implantadas nos quatro namespaces.
Configure ResourceFlavor para afinidade de nó
ResourceFlavor é uma CRD do Kueue que vincula um nó de cota a nós específicos correspondendo aos rótulos dos nós.
Pré-requisitos
Verifique se você tem:
A CRD ResourceFlavor aplicada (não instalada por padrão)
Versão do kube-scheduler superior a 6.9.0 (notas de versão, upgrade)
Apenas o campo nodeLabels tem efeito no ResourceFlavor.
Crie um ResourceFlavor
Este exemplo cria um ResourceFlavor chamado spot que tem como alvo nós rotulados com instance-type: spot.
apiVersion: kueue.x-k8s.io/v1beta1
kind: ResourceFlavor
metadata:
  name: "spot"
spec:
  nodeLabels:
    instance-type: spot
Associar um ResourceFlavor a uma cota elástica
Para vincular um ResourceFlavor a um nó de cota, declare-o na ElasticQuotaTree usando o campo attributes.resourceflavors.
apiVersion: scheduling.sigs.k8s.io/v1beta1
kind: ElasticQuotaTree
metadata:
  name: elasticquotatree
  namespace: kube-system
spec:
  root:
    name: root
    max:
      cpu: 999900
      memory: 400000Gi
      nvidia.com/gpu: 100000
    min:
      cpu: 999900
      memory: 400000Gi
      nvidia.com/gpu: 100000
    children:
    - name: child
      namespaces:
      - default
      attributes:
        resourceflavors: spot
      max:
        cpu: 99
        memory: 40Gi
        nvidia.com/gpu: 10
      min:
        cpu: 99
        memory: 40Gi
        nvidia.com/gpu: 10
Com essa configuração, os pods no nó de cota child (namespace default) são agendados apenas para nós com o rótulo instance-type: spot.
Próximas etapas
Consulte as notas de versão do kube-scheduler.
O kube-scheduler também suporta gang scheduling, que agenda todos os pods de um grupo juntos — se algum pod não puder ser agendado, nenhum será. Ideal para cargas de trabalho de big data, como Spark e Hadoop. Consulte Trabalhar com gang scheduling.