O componente kube-scheduler é o agendador padrão em um cluster Kubernetes e atribui Pods aos nós adequados. Este tópico descreve as métricas de monitoramento do componente kube-scheduler, orienta sobre o uso do painel e explica como resolver anomalias comuns nas métricas.
Antes de começar
Acessar o painel
Consulte Visualizar painéis de monitoramento para componentes do plano de controle.
Lista de métricas
As métricas expõem o status e os parâmetros de um componente. A tabela a seguir lista as métricas do componente kube-scheduler.
Métrica | Tipo | Descrição |
scheduler_scheduler_cache_size | Gauge | Número de nós, Pods e AssumedPods (Pods presumidos como agendados) no cache do agendador. |
scheduler_pending_pods | Gauge | Número de Pods pendentes, categorizados por tipo de fila:
|
scheduler_pod_scheduling_attempts_bucket | Histogram | Número de tentativas necessárias para agendar um Pod. Os limiares dos buckets são |
memory_utilization_byte | Gauge | Uso de memória, em bytes. |
cpu_utilization_core | Gauge | Uso de CPU, em núcleos. |
resource_utilization_level | Gauge | Nível de utilização de recursos.
|
rest_client_requests_total | Counter | Número de requisições HTTP, categorizadas por código de status, método e host. |
rest_client_request_duration_seconds_bucket | Histogram | Latência das requisições HTTP, categorizada por verbo e URL. |
As seguintes métricas de utilização de recursos não estão mais em uso. Remova quaisquer alertas ou regras de monitoramento que dependam destas métricas:
cpu_utilization_ratio: utilização de CPU.
memory_utilization_ratio: utilização de memória.
Painel
O painel exibe as métricas do componente por meio de consultas PromQL. As seções a seguir descrevem as visualizações de dados e suas métricas correspondentes.
Overview
Visualize
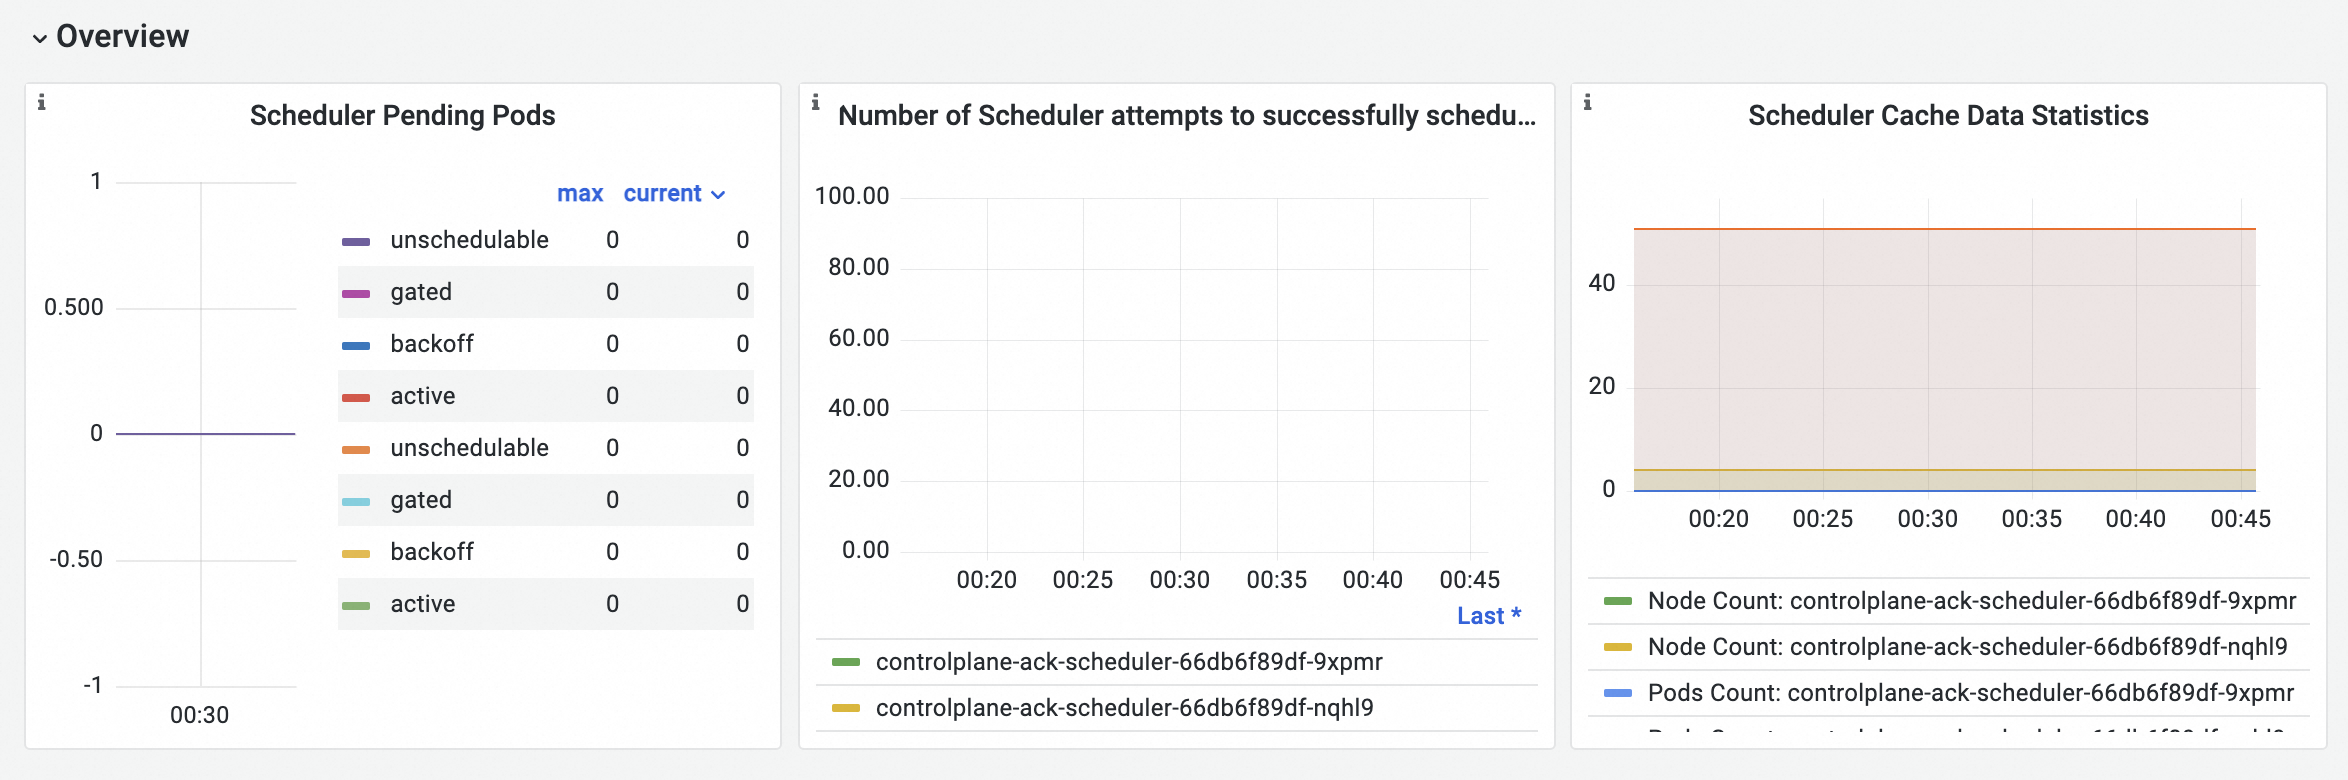
Detalhes das métricas
Métrica | PromQL | Descrição |
Pods pendentes no agendador | scheduler_pending_pods{job="ack-scheduler"} | Número de Pods pendentes, categorizados por tipo de fila:
|
Tentativas de agendamento de Pod pelo agendador | histogram_quantile($quantile, sum(rate(scheduler_pod_scheduling_attempts_bucket{job="ack-scheduler"}[$interval])) by (pod, le)) | Número de tentativas necessárias para agendar um Pod. Os limiares dos buckets são |
Estatísticas do cache do agendador |
| Número de nós, Pods e AssumedPods no cache do agendador. |
Recursos
Visualize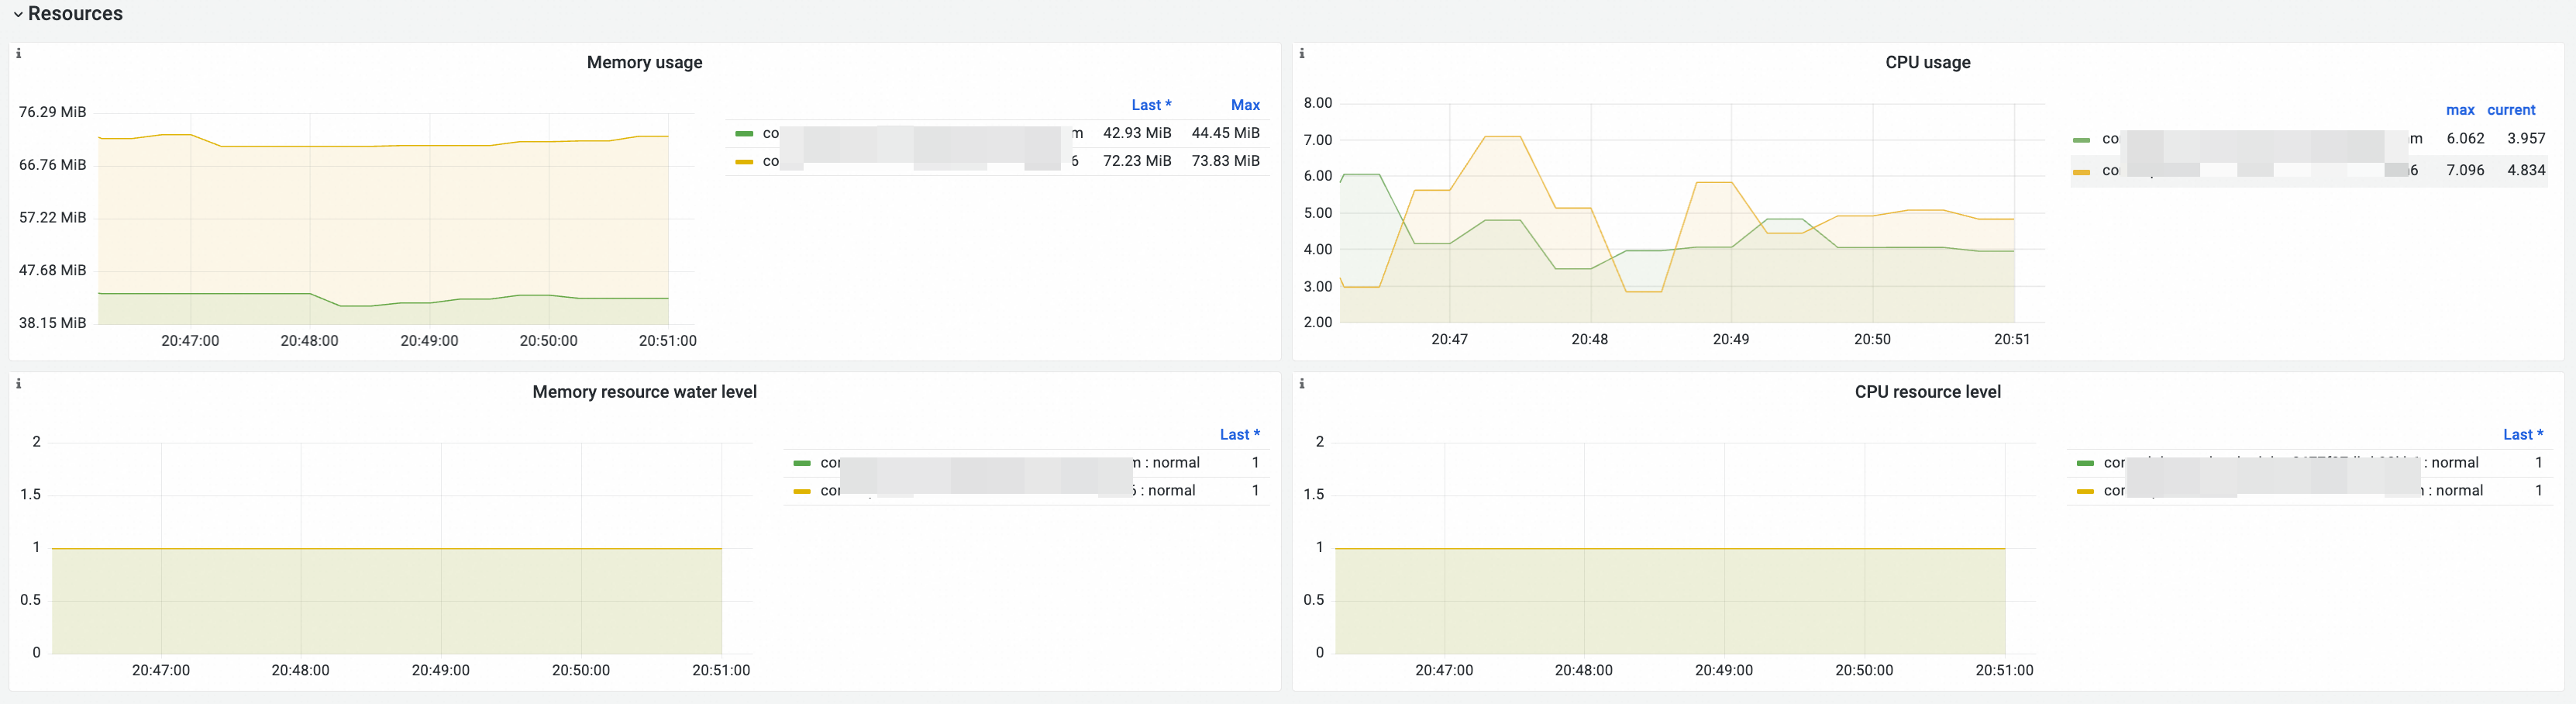
Detalhes das métricas
Métrica | PromQL | Descrição |
Uso de memória | memory_utilization_byte{container="kube-scheduler"} | Uso de memória, em bytes. |
CPU Usage | cpu_utilization_core{container="kube-scheduler"}*1000 | Uso de CPU, em milinúcleos. |
Nível de utilização de recursos de memória |
|
|
Nível de utilização de recursos de CPU |
|
Kube API
Visualize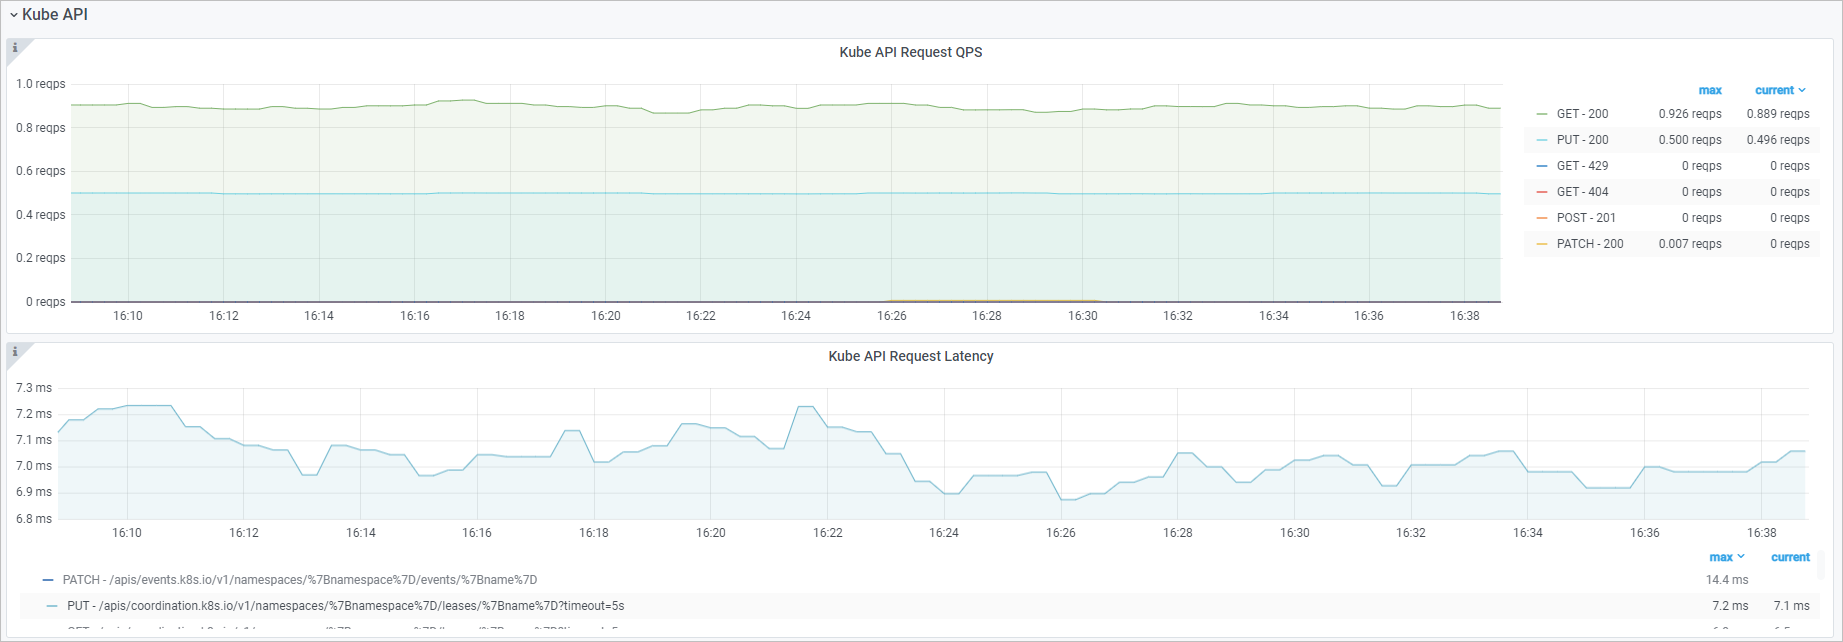
Detalhes das métricas
Métrica | PromQL | Descrição |
QPS de requisições à Kube API |
| Taxa de requisições HTTP do kube-scheduler para o componente kube-apiserver, categorizada por método e código de status. |
Latência de requisições à Kube API | histogram_quantile($quantile, sum(rate(rest_client_request_duration_seconds_bucket{job="ack-scheduler"}[$interval])) by (verb,url,le)) | Latência das requisições HTTP do kube-scheduler para o componente kube-apiserver, categorizada por verbo e URL da requisição. |
Anomalias comuns nas métricas
Caso observe anomalias nas métricas, use as descrições abaixo para verificar se o comportamento é esperado.
Número de Pods ativos do agendador
Condição normal | Condição anormal | Descrição | Recomendação |
O número de Pods ativos do agendador é maior ou igual a 1. | O número de Pods ativos do agendador é 0. | Não há agendadores disponíveis no cluster. |
|
Número de Pods pendentes
Condição normal | Condição anormal | Descrição | Recomendação |
A taxa de agendamento de Pods está estável e o número de Pods pendentes permanece baixo. |
| As solicitações de recursos dos Pods no cluster são inadequadas ou os recursos dos nós são insuficientes. |
|
Tentativas de agendamento de Pod
Condição normal | Condição anormal | Descrição | Recomendação |
Um Pod é agendado em um nó após algumas tentativas. | Um Pod continua sem conseguir ser agendado após múltiplas tentativas. | As solicitações de recursos dos Pods no cluster são inadequadas ou os recursos dos nós são insuficientes. |
|
Tópicos relacionados
Para conhecer as métricas, painéis e anomalias comuns de outros componentes do plano de controle, consulte os seguintes tópicos: Métricas de monitoramento do componente kube-apiserver, Métricas de monitoramento do componente etcd, Métricas de monitoramento do componente kube-controller-manager e Métricas de monitoramento do componente cloud-controller-manager.