Monitore a integridade do kube-apiserver em clusters ACK. Esse componente fornece a API RESTful do Kubernetes e permite que clientes externos e outros componentes internos interajam com o cluster. Use a lista de métricas, as orientações sobre painéis e a análise de anomalias deste tópico para diagnosticar problemas.
Observações de uso
Acesso ao painel
Consulte View control plane component dashboards.
Métricas
As métricas são uma das formas pelas quais um componente expõe seu status e parâmetros. A tabela a seguir lista as métricas do kube-apiserver.
|
Métrica |
Tipo |
Descrição |
|
apiserver_request_duration_seconds_bucket |
Histogram |
Distribuição de latência das requisições de clientes para o API Server. Dimensões:
Limiares de bucket para o histograma do API Server: |
|
apiserver_request_total |
Counter |
Total de requisições do API Server, detalhado por Verb, Group, Version, Resource, Scope, Component, contentType HTTP, código HTTP (código de status de resposta) e Client. |
|
apiserver_request_no_resourceversion_list_total |
Counter |
Requisições LIST para o API Server sem o parâmetro |
|
apiserver_current_inflight_requests |
Gauge |
Requisições que o API Server processa atualmente. Estas se dividem em dois tipos:
|
|
apiserver_dropped_requests_total |
Counter |
Requisições descartadas pelo API Server durante o throttling, retornando um código de status HTTP |
|
etcd_request_duration_seconds_bucket |
Histogram |
Distribuição de latência de requisições do API Server para o etcd. Detalhado por operação e tipo de objeto. Limiares de bucket: |
|
apiserver_storage_db_size_in_use_quota_bytes |
Gauge |
Cota de armazenamento configurada para o banco de dados etcd. Requisições de escrita são rejeitadas quando esse limite é atingido. Unidade: bytes. |
|
apiserver_storage_db_size_in_use_bytes |
Gauge |
Quantidade de armazenamento de dados que o etcd utiliza atualmente. Unidade: bytes. |
|
apiserver_flowcontrol_request_concurrency_limit |
Gauge |
Número máximo teórico de requisições que uma fila de prioridade pode processar simultaneamente sob o throttling de API Priority and Fairness (APF). Mostra como o API Server usa políticas de controle de tráfego para alocar capacidade entre filas de prioridade, garantindo que requisições de alta prioridade sejam processadas sem atraso. Descontinuado no Kubernetes 1.30 e removido na versão 1.31. Para clusters executando Kubernetes 1.31 ou posterior, utilize a métrica apiserver_flowcontrol_nominal_limit_seats. |
|
apiserver_flowcontrol_current_executing_requests |
Gauge |
Requisições em execução em uma fila de prioridade, representando a carga simultânea real. Monitore juntamente com o limite de concorrência para determinar se o API Server está próximo da saturação. |
|
apiserver_flowcontrol_current_inqueue_requests |
Gauge |
Requisições aguardando em uma fila de prioridade. Um acúmulo crescente indica pressão de tráfego no API Server e possível sobrecarga da fila. |
|
apiserver_flowcontrol_nominal_limit_seats |
Gauge |
Máximo nominal de assentos simultâneos no API Server sob APF, mostrando como as políticas de controle de tráfego alocam capacidade entre filas de prioridade. Unidade: assentos. |
|
apiserver_flowcontrol_current_limit_seats |
Gauge |
Limite atual de concorrência APF em assentos para uma fila de prioridade — o máximo de assentos simultâneos permitidos após ajustes dinâmicos. Este valor reflete a capacidade real de concorrência da fila e pode mudar dinamicamente devido à carga do sistema ou outros fatores. Diferente de |
|
apiserver_flowcontrol_current_executing_seats |
Gauge |
Assentos consumidos por requisições em execução em uma fila de prioridade, refletindo a carga real. Se Para otimizar a configuração, aumente os valores de maxMutatingRequestsInflight e maxRequestsInflight para o API Server. Consulte Customize the parameters of control plane components in ACK Pro clusters. |
|
apiserver_flowcontrol_current_inqueue_seats |
Gauge |
Assentos ocupados por requisições aguardando em uma fila de prioridade, representando o backlog pendente. |
|
apiserver_flowcontrol_request_execution_seconds_bucket |
Histogram |
Tempo de execução de uma requisição, do início à conclusão. Os limiares de bucket são {0, 0.005, 0.02, 0.05, 0.1, 0.2, 0.5, 1, 2, 5, 10, 15, 30}. Unidade: segundos. |
|
apiserver_flowcontrol_request_wait_duration_seconds_bucket |
Histogram |
Tempo que uma requisição aguarda na fila antes do início da execução. Os limiares de bucket são {0, 0.005, 0.02, 0.05, 0.1, 0.2, 0.5, 1, 2, 5, 10, 15, 30}. Unidade: segundos. |
|
apiserver_flowcontrol_dispatched_requests_total |
Counter |
Total de requisições despachadas com sucesso pelo API Server sob APF. |
|
apiserver_flowcontrol_rejected_requests_total |
Counter |
Requisições rejeitadas por excederem o limite de concorrência ou a capacidade da fila. |
|
apiserver_admission_controller_admission_duration_seconds_bucket |
Histogram |
Latência de processamento de um controlador de admissão. Rótulos: nome do controlador, operação (como CREATE, UPDATE, CONNECT), recurso de API, tipo de operação e status de rejeição (verdadeiro ou falso). O tipo de operação é validate, que verifica se a requisição é válida, ou admit, que decide se permite uma requisição válida. Limiares de bucket: |
|
apiserver_admission_webhook_admission_duration_seconds_bucket |
Histogram |
Latência de processamento de um webhook de admissão. Rótulos: nome do webhook, operação (como CREATE, UPDATE, CONNECT), recurso de API, tipo de operação (admit ou validating) e status de rejeição (verdadeiro ou falso). Limiares de bucket: |
|
apiserver_admission_webhook_admission_duration_seconds_count |
Counter |
Requisições processadas por um webhook de admissão. Rótulos: nome do webhook, operação (como CREATE, UPDATE, CONNECT), recurso de API, tipo de operação (admit ou validating) e status de rejeição (verdadeiro ou falso). |
|
cpu_utilization_core |
Gauge |
Número de núcleos de CPU em uso. Unidade: núcleo. |
|
memory_utilization_byte |
Gauge |
Quantidade de memória em uso. Unidade: byte. |
|
resource_utilization_level |
Gauge |
Nível de utilização de recursos.
|
|
up |
Gauge |
Indica se o service está disponível.
|
As seguintes métricas de utilização de recursos não estão mais em uso. Remova quaisquer alertas ou regras de monitoramento que dependam dessas métricas:
cpu_utilization_ratio: Utilização de CPU.
memory_utilization_ratio: Utilização de memória.
Painel
O painel é construído a partir de métricas de componentes e consultas PromQL relacionadas.
Painéis organizados na ordem de uso mais comum:
Key metrics: Obtenha uma visão geral rápida das principais métricas do cluster.
Overview: Analise a latência de resposta do API Server, o número de requisições em andamento e quaisquer eventos de throttling.
Resource analysis: Revise os níveis de utilização de recursos dos componentes gerenciados.
QPS and latency: Realize uma análise detalhada e multidimensional de consultas por segundo (QPS) e tempo de resposta (RT).
APF throttling: Use métricas do APF para analisar a distribuição de tráfego de requisições do API Server, seu status de throttling e gargalos de desempenho do sistema.
Admission controllers and webhooks: Analise o QPS e RT de controladores de admissão e webhooks.
Client analysis: Execute uma análise multidimensional de QPS por cliente.
Filtros
Use os filtros acima do painel para configure Verb, Resource e Quantile para requisições do API Server, bem como o Interval de amostragem do PromQL usado pelos painéis.
Um quantil de 0.9 (P90) mostra o valor no qual ou abaixo do qual 90% das amostras do histograma caem, filtrando outliers de cauda longa. Um quantil de 0.99 (P99) inclui amostras de cauda longa.
Use os filtros a seguir para selecione o intervalo de tempo e a taxa de atualização. 
Métricas principais
Visualize do painel 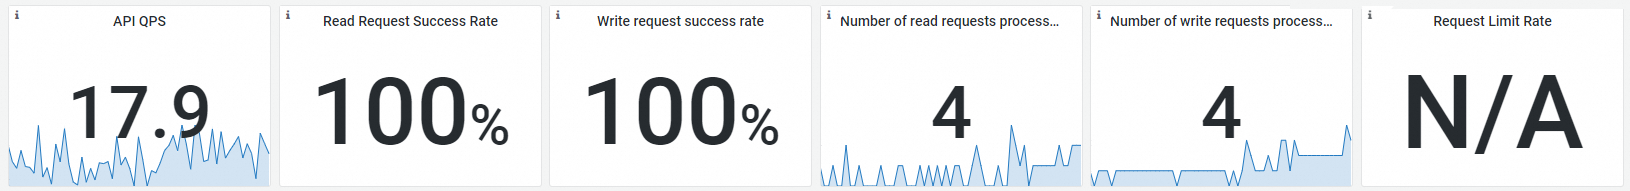
Detalhes das métricas
|
Nome |
PromQL |
Descrição |
||||||
|
API QPS |
sum(irate(apiserver_request_total[$interval])) |
QPS total para o API Server. |
||||||
|
Read request success rate |
sum(irate(apiserver_request_total{code=~"20.*",verb=~"GET |
LIST"}[$interval]))/sum(irate(apiserver_request_total{verb=~"GET |
LIST"}[$interval])) |
Taxa de sucesso de requisições de leitura para o API Server. |
||||
|
Write request success rate |
sum(irate(apiserver_request_total{code=~"20.*",verb!~"GET |
LIST |
WATCH |
CONNECT"}[$interval]))/sum(irate(apiserver_request_total{verb!~"GET |
LIST |
WATCH |
CONNECT"}[$interval])) |
Taxa de sucesso de requisições de escrita para o API Server. |
|
Number of read requests processed |
sum(apiserver_current_inflight_requests{requestKind="readOnly"}) |
Requisições de leitura atualmente em andamento. |
||||||
|
Number of write requests processed |
sum(apiserver_current_inflight_requests{requestKind="mutating"}) |
Requisições de escrita atualmente em andamento. |
||||||
|
Request limit rate |
sum(irate(apiserver_dropped_requests_total[$interval])) |
Porcentagem do total de requisições descartadas pela política de throttling do API server. |
Visão geral
Visualize do painel 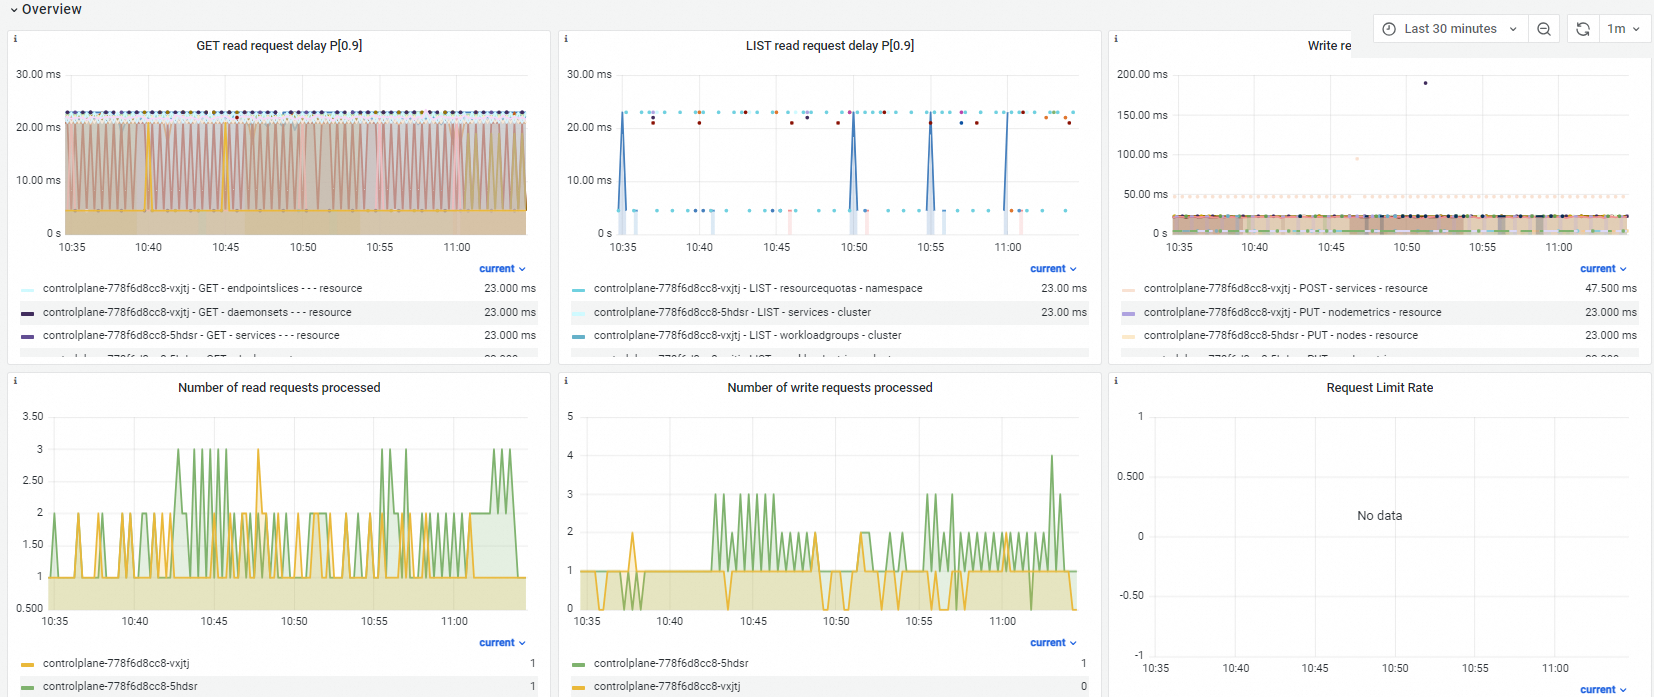
Detalhes das métricas
|
Nome |
PromQL |
Descrição |
|
GET read request latency |
histogram_quantile($quantile, sum(irate(apiserver_request_duration_seconds_bucket{verb="GET",resource!="",subresource!~"log|proxy"}[$interval])) by (pod, verb, resource, subresource, scope, le)) |
Tempo de resposta de requisições GET, detalhado por pod do API Server, recurso e escopo. |
|
LIST read request latency |
histogram_quantile($quantile, sum(irate(apiserver_request_duration_seconds_bucket{verb="LIST"}[$interval])) by (pod_name, verb, resource, scope, le)) |
Tempo de resposta de requisições LIST, detalhado por pod do API Server, recurso e escopo. |
|
Write request latency |
histogram_quantile($quantile, sum(irate(apiserver_request_duration_seconds_bucket{verb!~"GET|WATCH|LIST|CONNECT"}[$interval])) by (cluster, pod_name, verb, resource, scope, le)) |
Tempo de resposta de requisições mutáveis, detalhado por pod do API Server, verbo (excluindo GET, WATCH, LIST, CONNECT), recurso e escopo. |
|
Number of read requests processed |
apiserver_current_inflight_requests{request_kind="readOnly"} |
Requisições de leitura que o API Server processa atualmente. |
|
Number of write requests processed |
apiserver_current_inflight_requests{request_kind="mutating"} |
Requisições de escrita que o API Server processa atualmente. |
|
Request limit rate |
sum(irate(apiserver_dropped_requests_total{request_kind="readOnly"}[$interval])) by (name) sum(irate(apiserver_dropped_requests_total{request_kind="mutating"}[$interval])) by (name)
|
Taxa de limite de requisições para o API Server. |
Análise de recursos
Visualize do painel
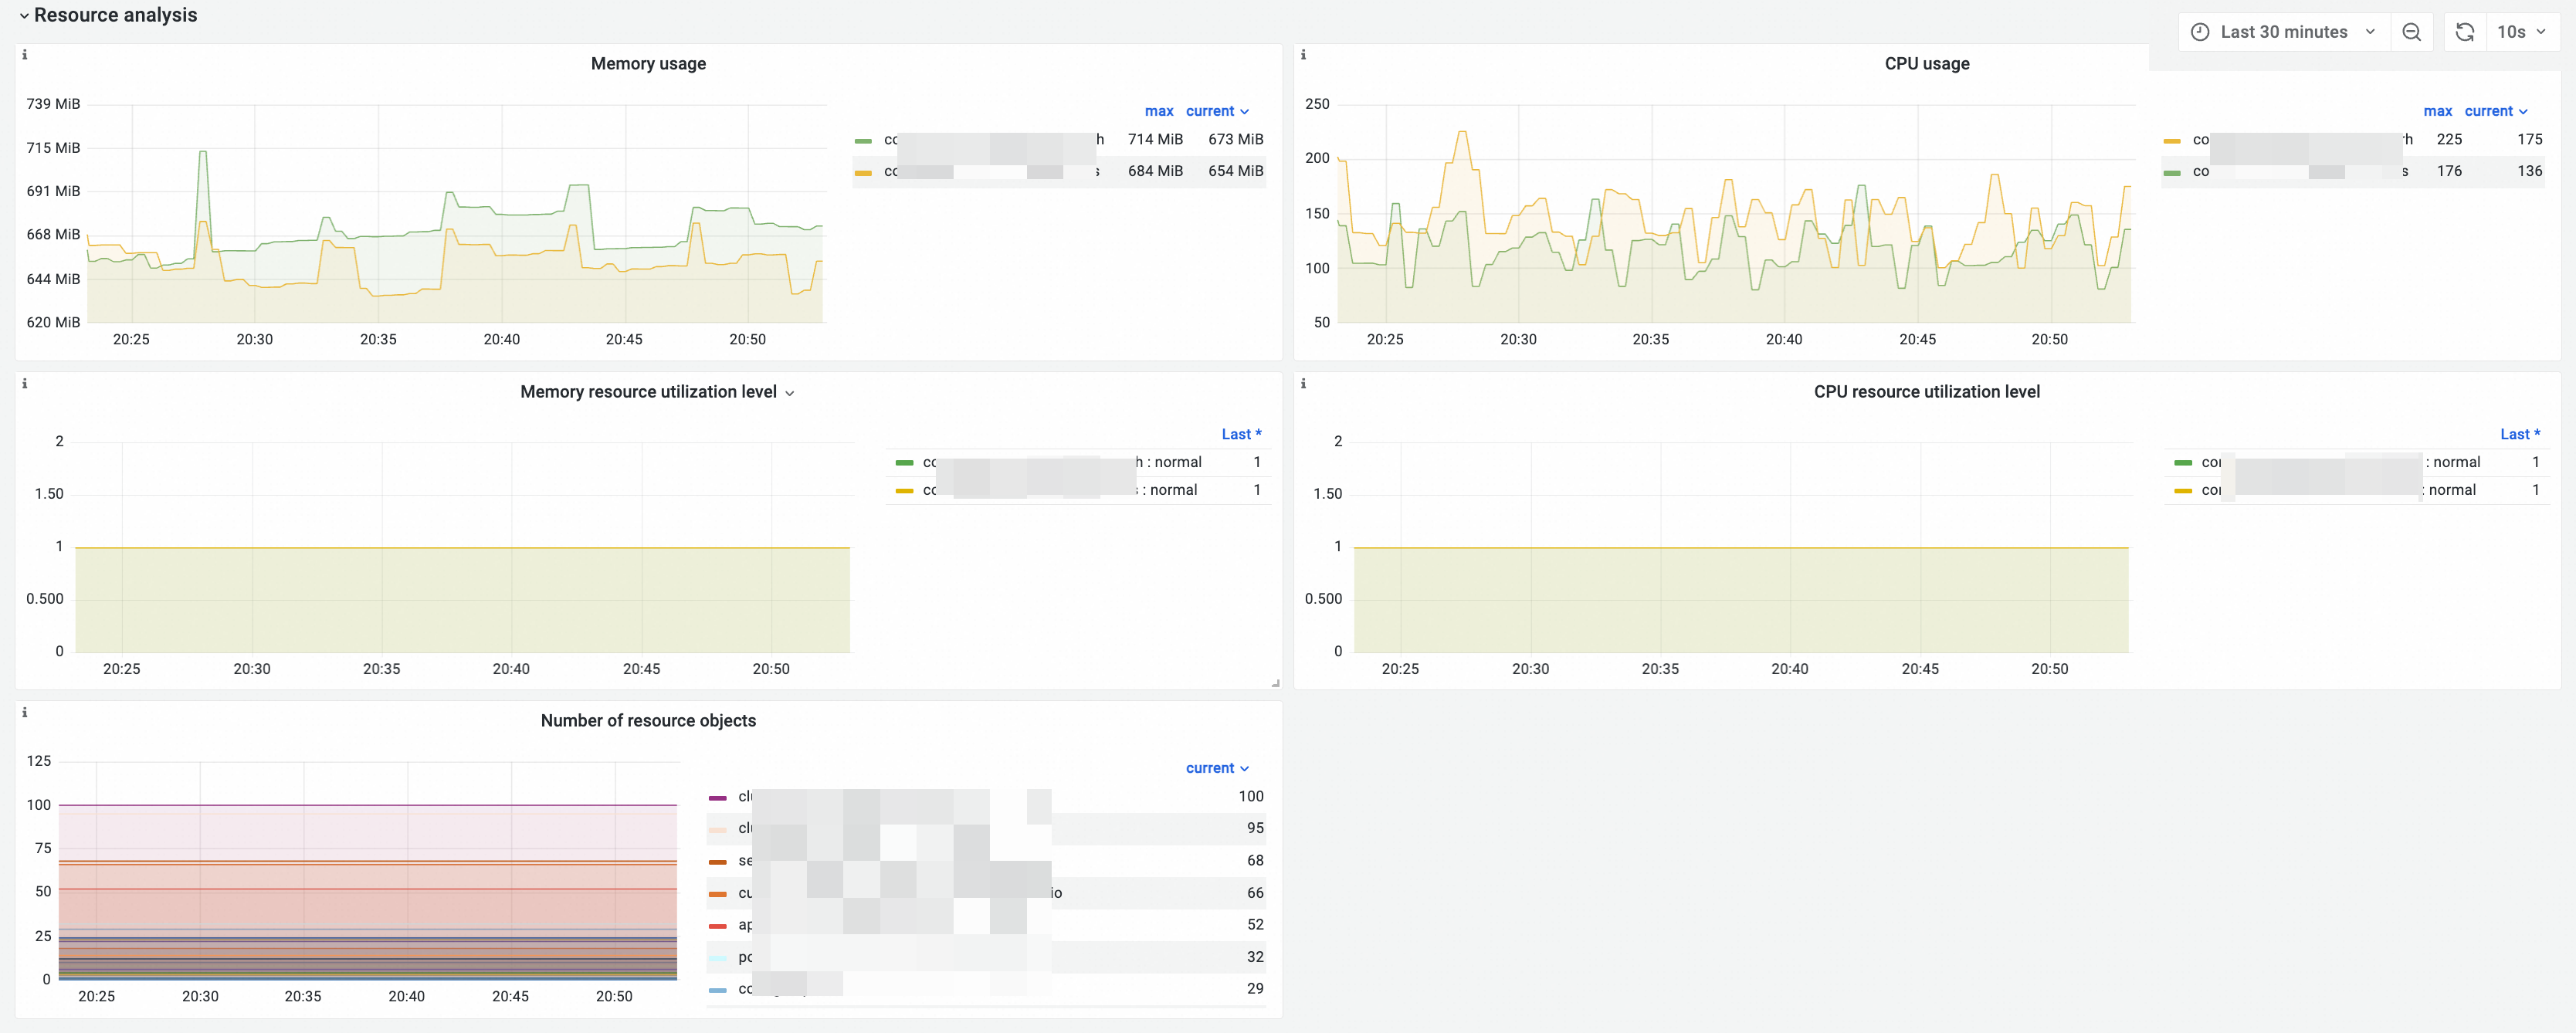
Detalhes das métricas
|
Nome |
PromQL |
Descrição |
|
Memory usage |
memory_utilization_byte{container="kube-apiserver"} |
Uso de memória do API Server. Unidade: bytes. |
|
CPU usage |
cpu_utilization_core{container="kube-apiserver"}*1000 |
Uso de CPU do API Server. Unidade: milinúcleos. |
|
Resource object count |
|
|
|
Nível de utilização de memória |
|
|
|
Nível de utilização de CPU |
|
QPS e latência
Visualize do painel 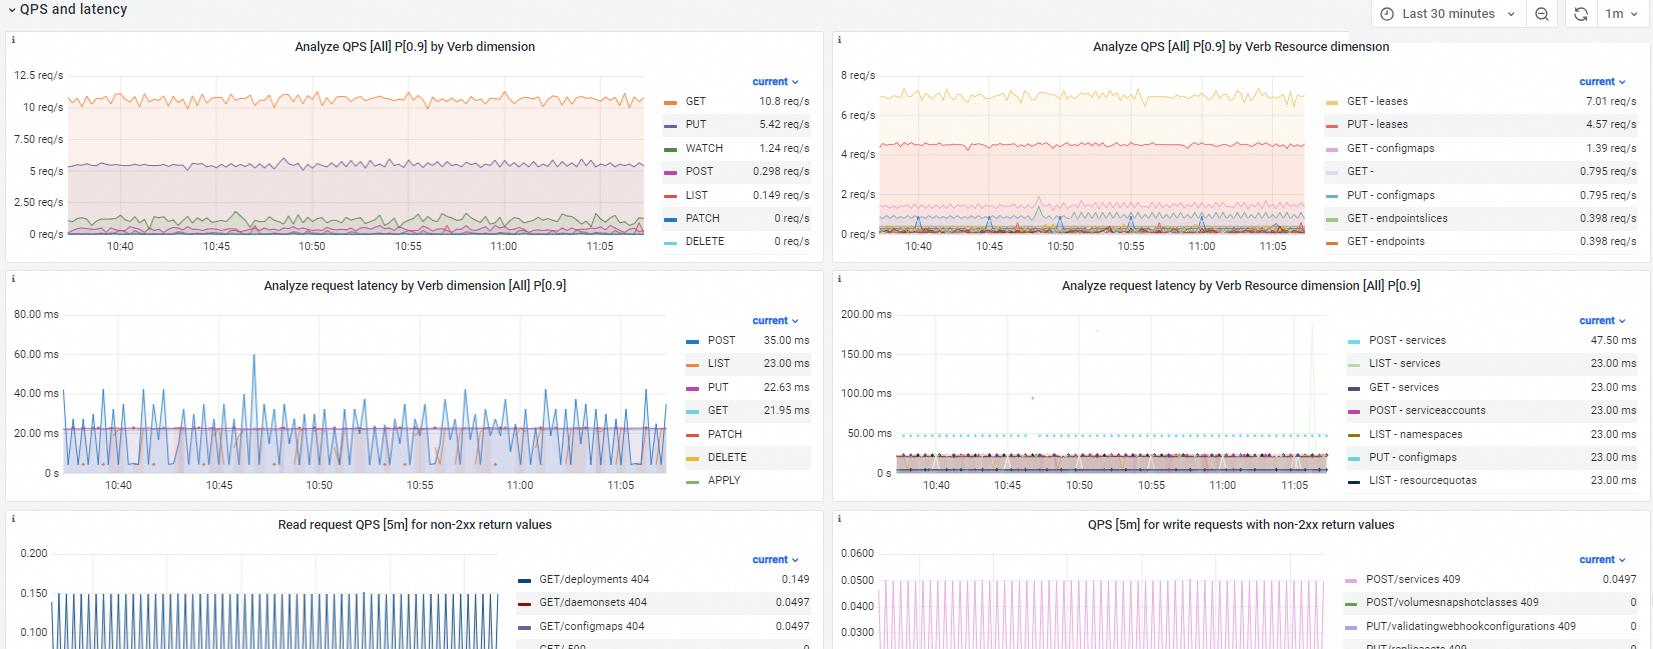
Detalhes das métricas
|
Nome |
PromQL |
Descrição |
||
|
QPS analysis by verb |
sum(irate(apiserver_request_total{verb=~"$verb"}[$interval]))by(verb) |
QPS de requisições, detalhado por verbo. |
||
|
QPS analysis by verb and resource |
sum(irate(apiserver_request_total{verb=~"$verb",resource=~"$resource"}[$interval]))by(verb,resource) |
QPS de requisições, detalhado por verbo e recurso. |
||
|
Request latency analysis by verb |
histogram_quantile($quantile, sum(irate(apiserver_request_duration_seconds_bucket{verb=~"$verb", verb!~"WATCH |
CONNECT",resource!=""}[$interval])) by (le,verb)) |
Latência de requisições, detalhada por verbo. |
|
|
Request latency analysis by verb and resource |
histogram_quantile($quantile, sum(irate(apiserver_request_duration_seconds_bucket{verb=~"$verb", verb!~"WATCH |
CONNECT", resource=~"$resource",resource!=""}[$interval])) by (le,verb,resource)) |
Latência de requisições, detalhada por verbo e recurso. |
|
|
QPS of read requests with non-2xx responses |
sum(irate(apiserver_request_total{verb=~"GET |
LIST",resource=~"$resource",code!~"2.*"}[$interval])) by (verb,resource,code) |
QPS de requisições de leitura que retornaram um código de status não-2xx, como 4xx ou 5xx. |
|
|
QPS of write requests with non-2xx responses |
sum(irate(apiserver_request_total{verb!~"GET |
LIST |
WATCH",verb=~"$verb",resource=~"$resource",code!~"2.*"}[$interval])) by (verb,resource,code) |
QPS de requisições de escrita que retornaram um código de status não-2xx, como 4xx ou 5xx. |
|
API Server to etcd request latency |
histogram_quantile($quantile, sum(irate(etcd_request_duration_seconds_bucket[$interval])) by (le,operation,type,instance)) |
Latência de requisições do API Server para o etcd. |
Throttling APF
O monitoramento de métricas de throttling APF está em lançamento canário.
Métricas relacionadas ao APF estão disponíveis apenas para clusters ACK executando Kubernetes 1.20 ou posterior. Para atualize seu cluster, consulte Manually upgrade an ACK cluster.
-
o painel de métricas APF também exige a atualização dos seguintes add-ons:
Add-on de monitoramento de cluster de containers: 0.06 ou posterior.
Add-on ack-arms-prometheus: v1.1.31 ou posterior.
Add-on de sonda gerenciada: v1.1.31 ou posterior.
Para atualize esses add-ons, consulte Upgrade monitoring components.
Visualize do painel
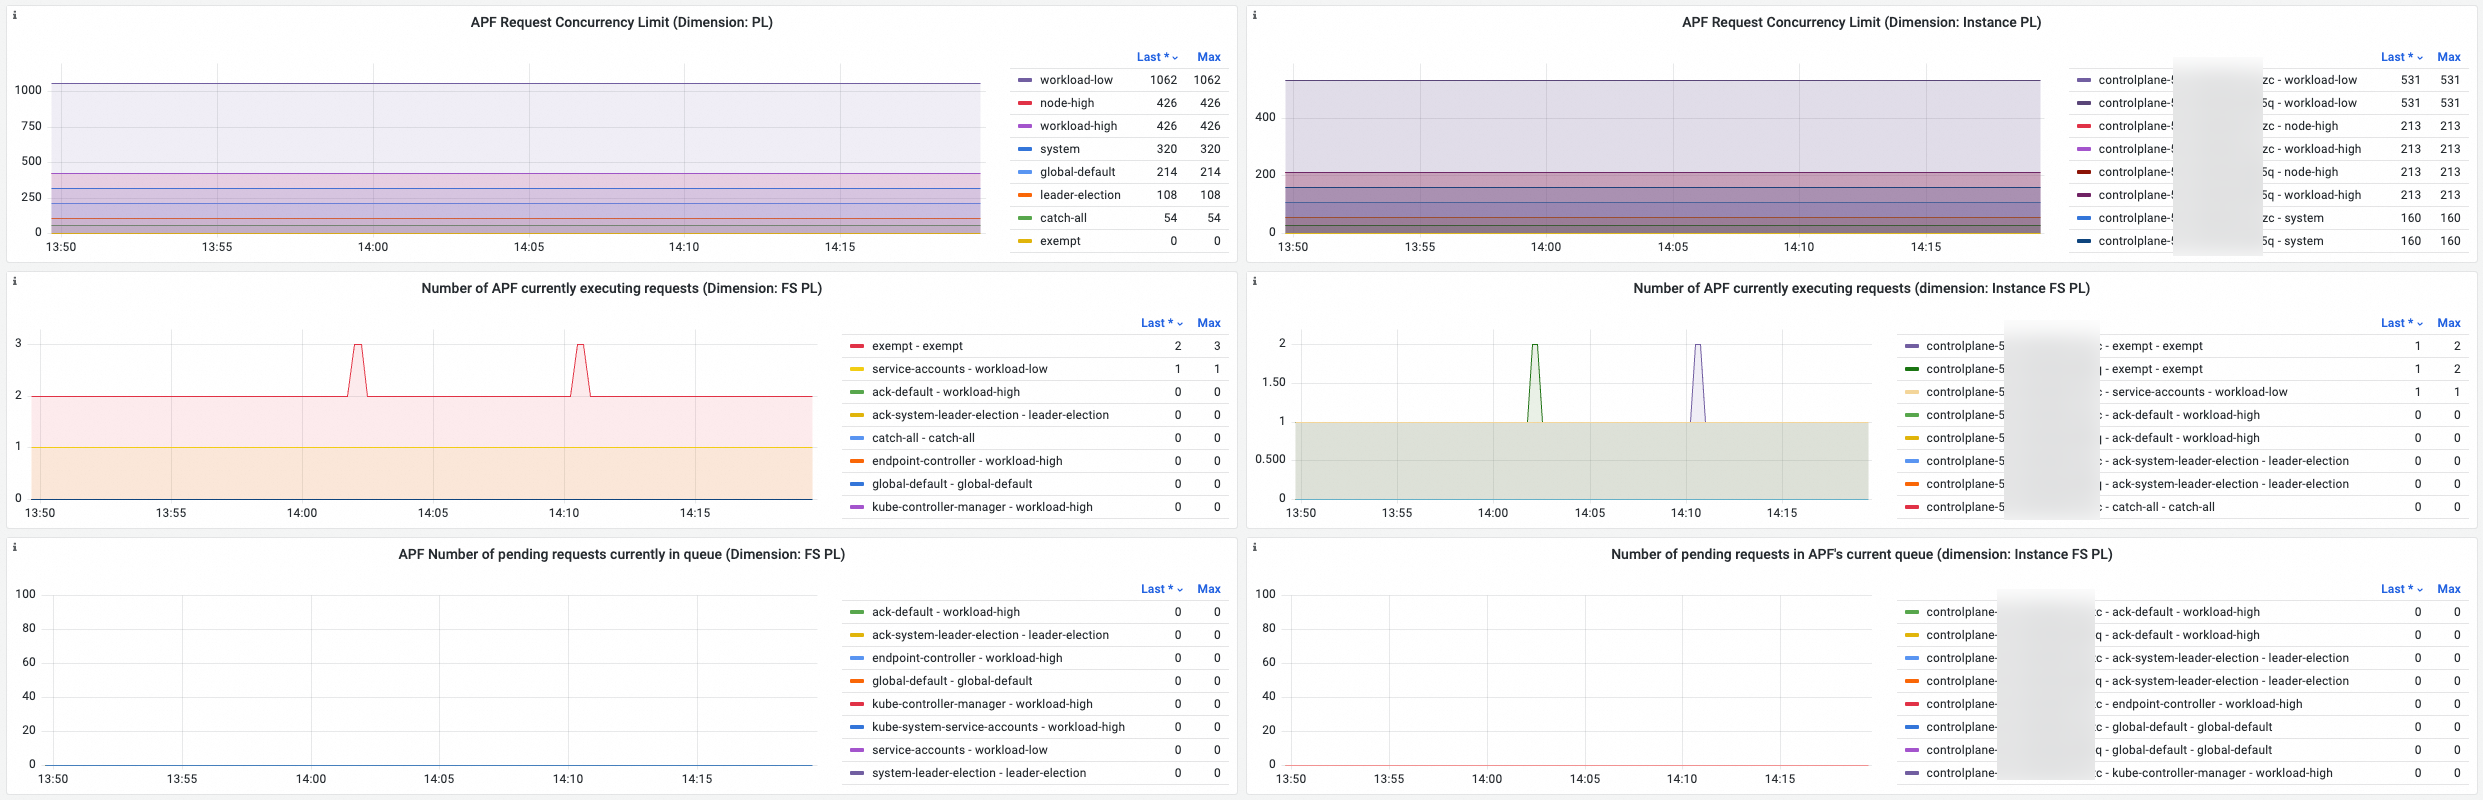

Detalhes das métricas
Algumas métricas na tabela a seguir são detalhadas por PL, Instance e FS.
PL: Dimensão de Nível de Prioridade, que detalha métricas por nível de prioridade.
Instance: Instância do servidor de API.
FS: Dimensão de Esquema de Fluxo, que detalha métricas por classificação de requisição.
Para detalhes sobre APF e dimensões, consulte a documentação do Kubernetes sobre API Priority and Fairness.
|
Nome |
PromQL |
Descrição |
|
APF request concurrency limit (by PL) |
sum by(priority_level) (apiserver_flowcontrol_request_concurrency_limit) |
Limite de concorrência de requisições APF, detalhado por PL ou Instance + PL. Representa o número máximo teórico de requisições simultâneas por fila de prioridade.
|
|
APF request concurrency limit (by Instance + PL) |
sum by(instance,priority_level) (apiserver_flowcontrol_request_concurrency_limit) |
|
|
Number of current APF executing requests (by FS + PL) |
sum by(flow_schema,priority_level) (apiserver_flowcontrol_current_executing_requests) |
Requisições em execução sob APF, detalhadas por FS + PL ou Instance + FS + PL. |
|
Number of current APF executing requests (by Instance + FS + PL) |
sum by(instance,flow_schema,priority_level)(apiserver_flowcontrol_current_executing_requests) |
|
|
Number of current APF in-queue requests (by FS + PL) |
sum by(flow_schema,priority_level) (apiserver_flowcontrol_current_inqueue_requests) |
Requisições aguardando na fila, detalhadas por FS + PL ou Instance + FS + PL. |
|
Number of current APF in-queue requests (by Instance + FS + PL) |
sum by(instance,flow_schema,priority_level) (apiserver_flowcontrol_current_inqueue_requests) |
|
|
APF nominal limit seats |
sum by(instance,priority_level) (apiserver_flowcontrol_nominal_limit_seats) |
Métricas de assentos APF por Instance + PL:
|
|
APF current limit seats |
sum by(instance,priority_level) (apiserver_flowcontrol_current_limit_seats) |
|
|
APF current executing seats |
sum by(instance,priority_level) (apiserver_flowcontrol_current_executing_seats) |
|
|
APF current in-queue seats |
sum by(instance,priority_level) (apiserver_flowcontrol_current_inqueue_seats) |
|
|
APF request execution time |
histogram_quantile($quantile, sum(irate(apiserver_flowcontrol_request_execution_seconds_bucket[$interval])) by (le,instance, flow_schema,priority_level)) |
Tempo desde o início da execução da requisição até a conclusão. |
|
APF request wait time |
histogram_quantile($quantile, sum(irate(apiserver_flowcontrol_request_wait_duration_seconds_bucket[$interval])) by (le,instance, flow_schema,priority_level)) |
Tempo que uma requisição aguarda na fila antes da execução. |
|
QPS of successfully dispatched APF requests |
sum(irate(apiserver_flowcontrol_dispatched_requests_total[$interval]))by(instance,flow_schema,priority_level) |
QPS de requisições despachadas com sucesso. |
|
QPS of rejected APF requests |
sum(irate(apiserver_flowcontrol_rejected_requests_total[$interval]))by(instance,flow_schema,priority_level) |
QPS de requisições rejeitadas por excederem o limite de concorrência ou a capacidade da fila. |
Controladores de admissão e webhooks
Visualize do painel 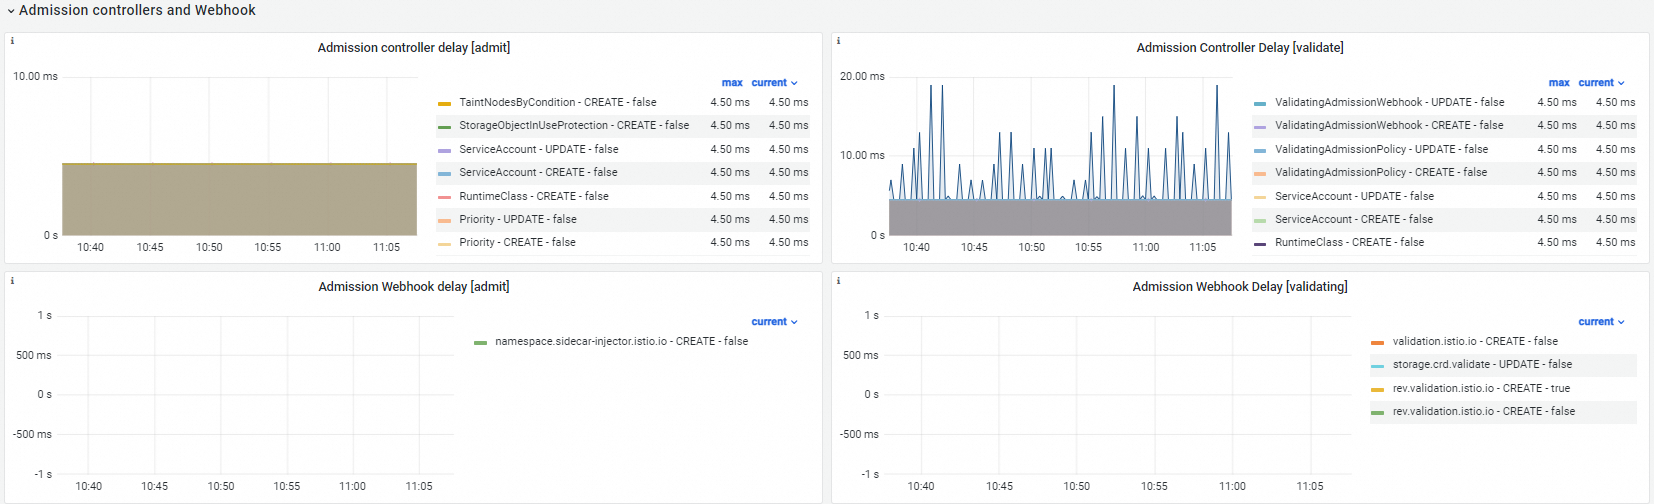
Detalhes das métricas
|
Nome |
PromQL |
Descrição |
|
Admission controller latency [admit] |
histogram_quantile($quantile, sum by(operation, name, le, type, rejected) (irate(apiserver_admission_controller_admission_duration_seconds_bucket{type="admit"}[$interval])) ) |
Nome, operação, status de rejeição e tempo de execução de controladores de admissão do tipo Buckets do histograma: |
|
Admission controller latency [validate] |
histogram_quantile($quantile, sum by(operation, name, le, type, rejected) (irate(apiserver_admission_controller_admission_duration_seconds_bucket{type="validate"}[$interval])) ) |
Nome, operação, status de rejeição e tempo de execução de controladores de admissão do tipo Buckets do histograma: |
|
Admission webhook latency [admit] |
histogram_quantile($quantile, sum by(operation, name, le, type, rejected) (irate(apiserver_admission_webhook_admission_duration_seconds_bucket{type="admit"}[$interval])) ) |
Nome, operação, status de rejeição e tempo de execução de webhooks do tipo Buckets do histograma: |
|
Admission webhook latency [validating] |
histogram_quantile($quantile, sum by(operation, name, le, type, rejected) (irate(apiserver_admission_webhook_admission_duration_seconds_bucket{type="validating"}[$interval])) ) |
Nome, operação, status de rejeição e tempo de execução de webhooks do tipo Buckets do histograma: |
|
Admission webhook request QPS |
sum(irate(apiserver_admission_webhook_admission_duration_seconds_count[$interval]))by(name,operation,type,rejected) |
QPS de requisições de webhooks de admissão. |
Análise de clientes
Visualize do painel 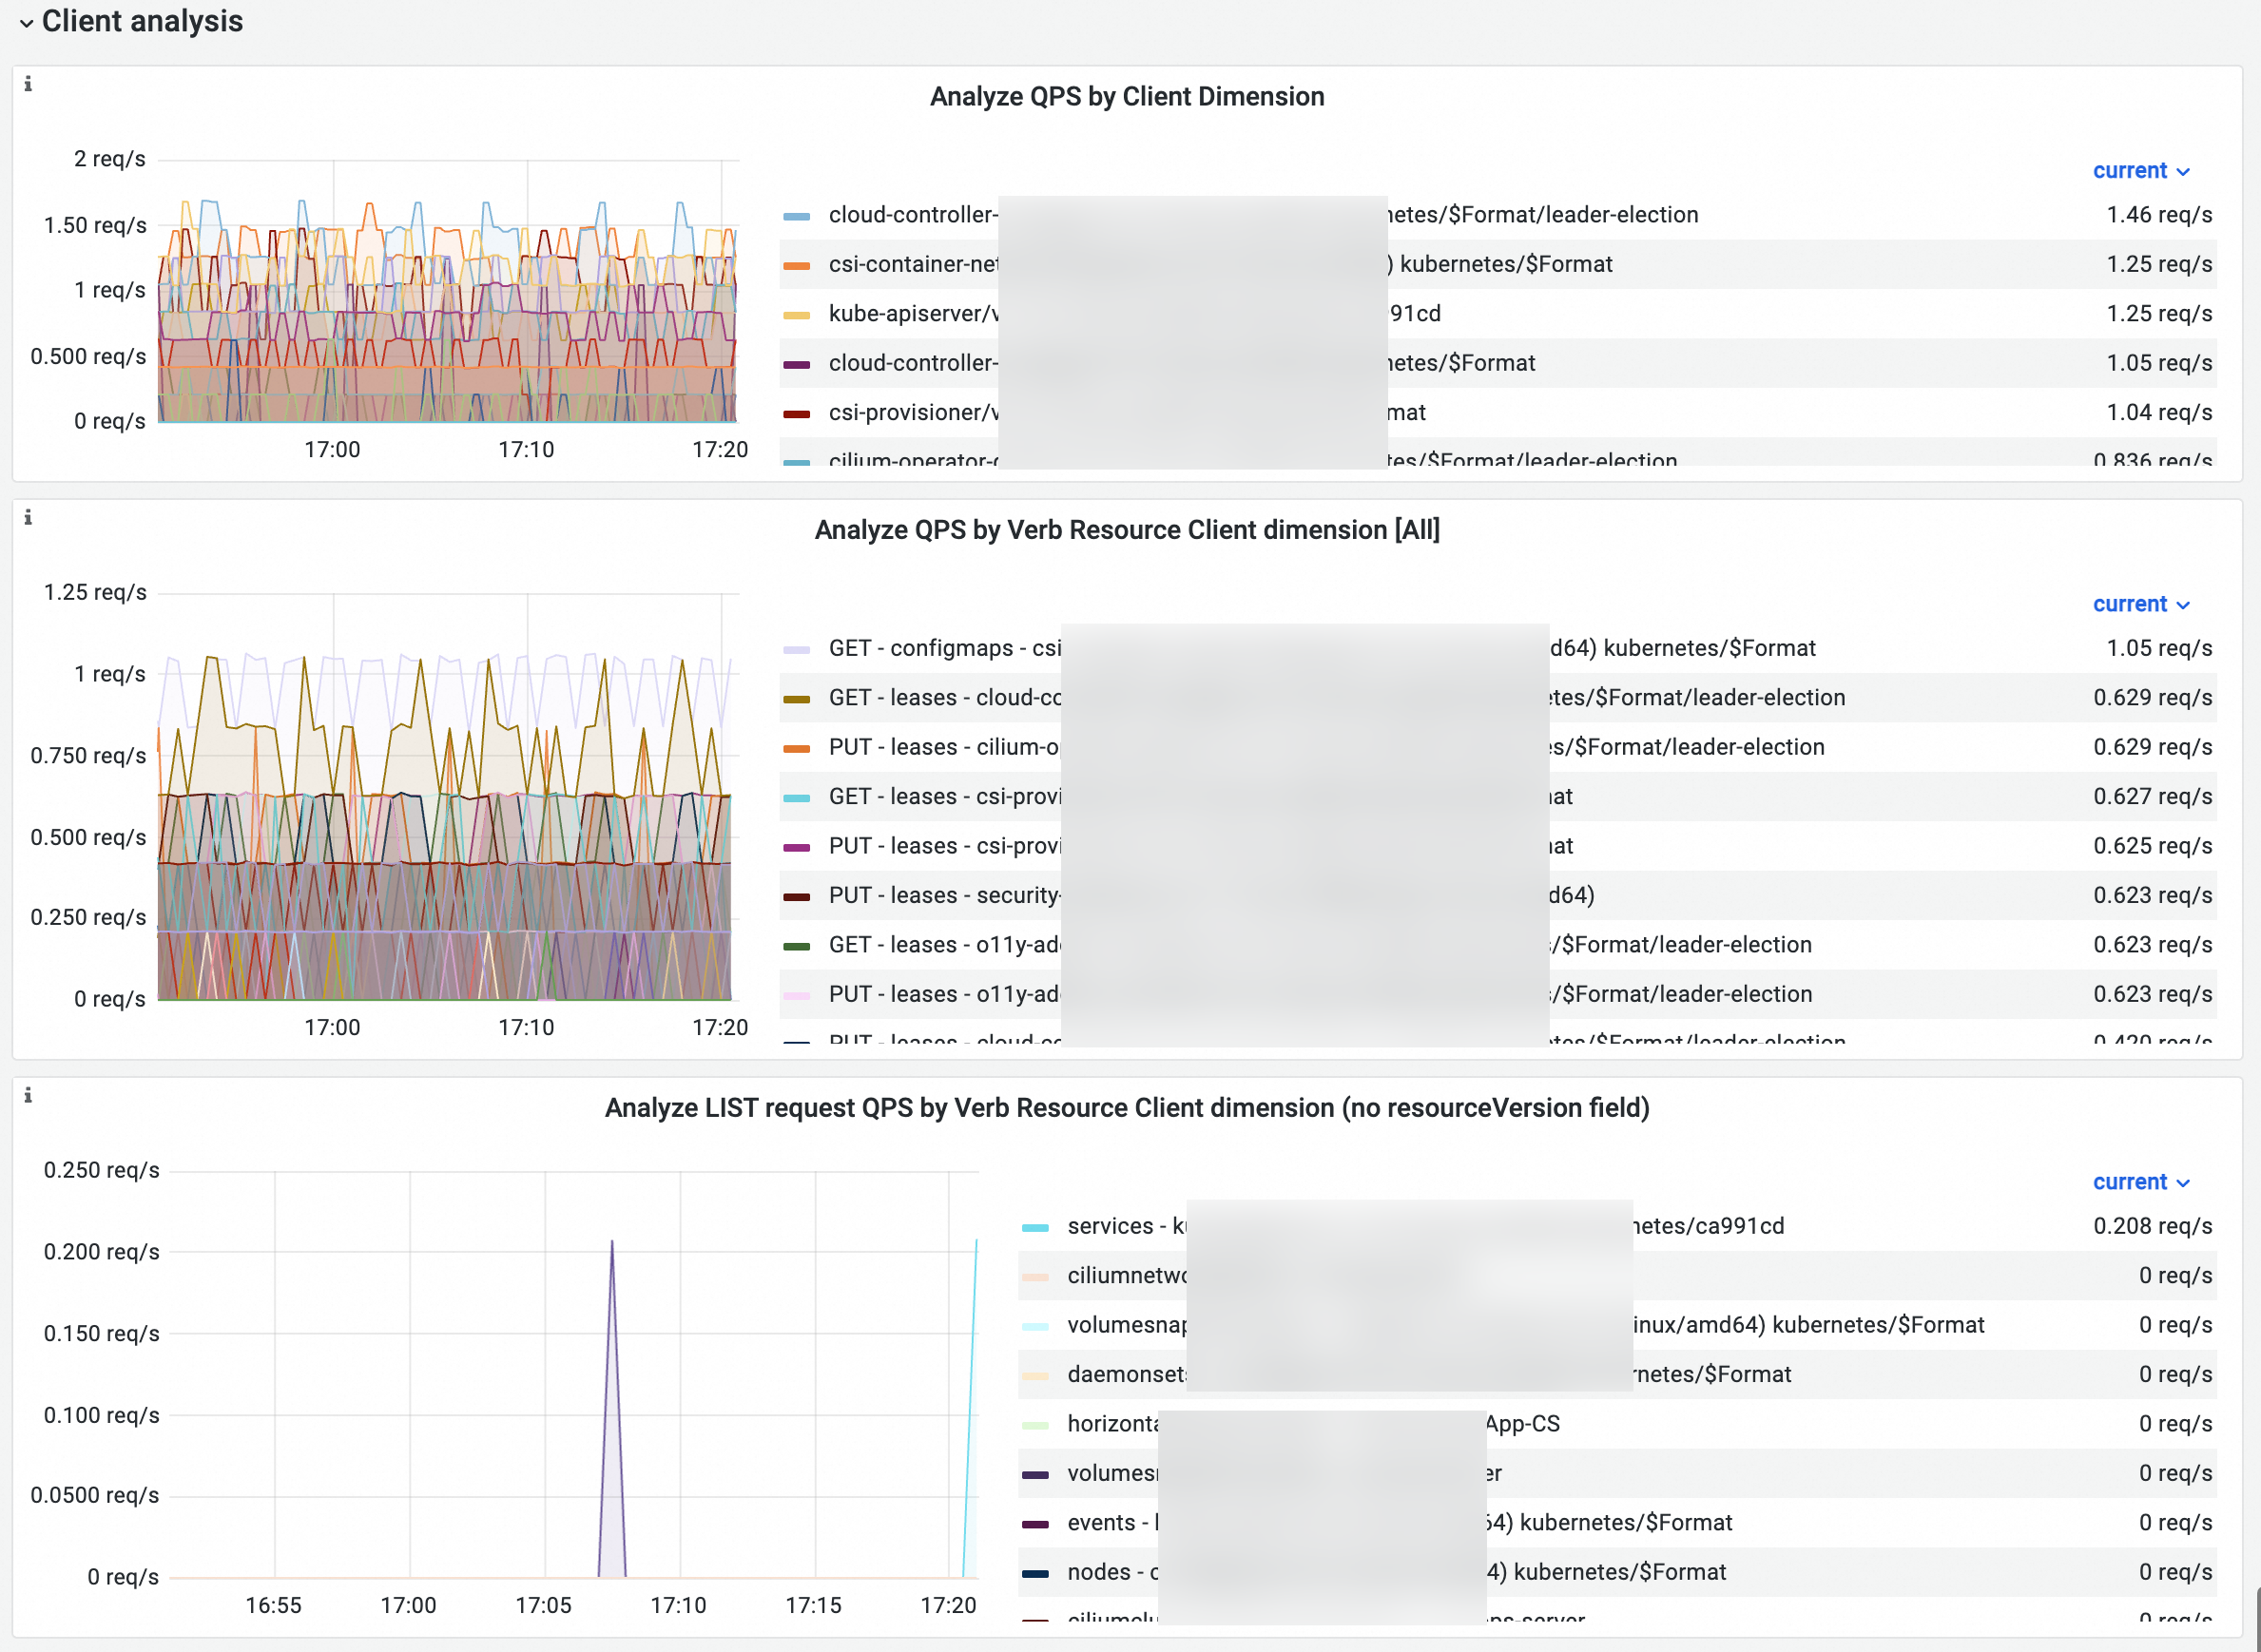
Detalhes das métricas
|
Nome |
PromQL |
Descrição |
|
QPS analysis by client |
sum(irate(apiserver_request_total{client!=""}[$interval])) by (client) |
QPS por cliente, mostrando quais clientes acessam o API Server. |
|
QPS analysis by verb, resource, and client |
sum(irate(apiserver_request_total{client!="",verb=~"$verb", resource=~"$resource"}[$interval]))by(verb,resource,client) |
QPS de requisições do servidor de API, detalhado por verbo, recurso e cliente. |
|
QPS of LIST requests without resourceVersion |
sum(irate(apiserver_request_no_resourceversion_list_total[$interval]))by(resource,client) |
|
Anomalias comuns de métricas
Use as seções a seguir para determinar se as anomalias nas métricas são esperadas.
Read/write request success rate
Descrição
|
Normal |
Anormal |
Descrição |
|
A Read request success rate e a Write request success rate devem estar próximas de 100%. |
A Read request success rate e a Write request success rate permanecem em uma porcentagem baixa, por exemplo, menos de 90%. |
Muitas requisições retornam códigos de status não-2xx. |
Solução recomendada
Verifique os painéis QPS of read requests with non-2xx responses e QPS of write requests with non-2xx responses para identificar tipos de requisição e recursos que causam respostas não-2xx. Por exemplo, GET/deployment 404 significa que requisições GET Deployment retornam 404, reduzindo a Read request success rate. Determine se esse comportamento é esperado e tome medidas para otimizar as requisições.
GET/LIST read and write request latency
Descrição
|
Normal |
Anormal |
Descrição |
|
A GET read request latency, a LIST read request latency e a Write request latency correlacionam-se com o tamanho do cluster e o número de recursos acessados. Não há um limiar fixo — a latência é aceitável se não afetar suas aplicações. Por exemplo, quanto maior o volume de um recurso acessado pelos clientes, mais tempo as requisições LIST levam. Normalmente, GET read request latency e Write request latency abaixo de 1s, e LIST read request latency abaixo de 5s são consideradas normais. |
|
Se a latência da requisição estiver alta, verifique se fatores como grande quantidade de recursos no cluster ou chamadas lentas de webhook estão contribuindo. |
Solução recomendada
-
Revise o painel para identificar tipos de requisição e recursos com alta latência. Verifique as métricas GET read request latency, LIST read request latency e Write request latency e tome as medidas corretivas necessárias.
A métrica
apiserver_request_duration_seconds_buckettem limite de 60s — requisições que excedem 60s são registradas como 60s. Requisições de conexão persistente, comoPOST pod/execou leituras de log, normalmente excedem esse limiar e podem ser ignoradas durante a solução de problemas.
Verifique admission webhook latency para determinar se webhooks lentos estão causando alta latência nas requisições do API server.
Read/write requests processed and request limit rate
Descrição
|
Normal |
Anormal |
Descrição |
|
Normalmente, Number of read requests processed e Number of write requests processed ficam abaixo de 100, e Request limit rate é 0. |
|
Se a fila de requisições tiver um backlog, descarte fatores como pico repentino de requisições ou webhooks lentos. Se a capacidade da fila for excedida, o API server aplica throttling nas requisições, fazendo com que a Request limit rate suba acima de 0 e afetando a estabilidade do cluster. |
Solução recomendada
Revise o painel QPS and latency e o painel Client analysis para identificar as principais requisições por volume e avalie se são esperadas. Se as requisições vierem de suas aplicações, determine se é possível reduzir o volume delas.
Verifique admission webhook latency para determinar se webhooks lentos estão causando processamento lento de requisições no API server.
Latência de webhook de admissão
Descrição
|
Normal |
Anormal |
Descrição |
|
A Admission webhook latency deve ser inferior a 0,5s. |
A Admission webhook latency excede persistentemente 0,5s. |
Respostas lentas de webhook afetam a latência de resposta do API server. |
Solução recomendada
Revise os logs do webhook para determinar se o comportamento é esperado. Desinstale webhooks que não são mais necessários.
Referências
-
Métricas, painéis e solução de problemas de anomalias para outros componentes do plano de controle:
Para consultar dados de monitoramento do Prometheus com o console ou uma api, consulte Query Prometheus Monitoring Data by Using PromQL.
Para crie regras de alerta com PromQL personalizado no Managed Service for Prometheus, consulte Create a Prometheus Alerting Rule.