Simple Log Service (SLS) における JSON ログのクエリと分析に関する一般的な質問と解決策をまとめています。これには、インデックス設定、JSON 関数、JSON 配列の取り扱いなどが含まれます。
サンプルログ
このトピックの例では、注文処理システムの JSON ログを使用します。
{
    "request":{
        "clientIp":"20xxx30",
        "http.path":"/order/buy",
        "param":{
            "userId": "186453",
            "orders":[
                {
                    "commodity":["bread","milk","meat"],
                    "payment":132
                },
                {
                    "commodity":["milk","beer"],
                    "payment":49
                }
            ]
        }
    },
    "response":"{\"errcode\":400,\"msg\":\"insufficient\"}"
}requestフィールドには、JSON 形式の注文リクエスト情報が含まれます。1 つのリクエストには、ユーザーの複数の注文を含めることができ、各注文には購入した商品と支払い総額が含まれます。-
responseフィールドには、注文処理結果が含まれます。成功した場合、
responseフィールドの値はSUCCESSです。失敗した場合、
responseフィールドの値は、errcodeとmsgを含む JSON コンテンツの文字列です。
Logtail を使用して、JSON モードでログを収集し、SLS に取り込んでクエリと分析を行います。
インデックスの設定
ログデータをクエリまたは分析する前に、インデックスを設定します。JSON ログのインデックスを設定する際は、次の点に注意してください。
インデックスタイプの選択
SLS は、フルテキストインデックスとフィールドインデックスをサポートしています。ユースケースに基づいてインデックスタイプを選択し、インデックスを作成します。
すべてのフィールドをクエリする場合は、フルテキストインデックスを作成します。特定のフィールドのみをクエリする場合は、該当フィールドにフィールドインデックスを作成してコストを削減します。
フィールドに対して SQL 分析を実行する場合は、そのフィールドにフィールドインデックスを作成し、統計を有効にします。
フルテキストインデックスとフィールドインデックスの両方を設定している場合、フィールドインデックスが設定されているフィールドでは、そのインデックスが優先されます。
たとえば、request フィールドと response フィールドを分析する場合は、それぞれにフィールドインデックスを作成し、統計を有効にします。
インデックス設定におけるフィールドのデータ型の選択
インデックスを設定する際、フィールドのデータ型を text、long、double、または JSON に設定します。詳細については、「データ型」をご参照ください。
JSON フィールドのデータ型を設定する際は、次の点に注意してください。
-
フィールド値が標準の JSON 形式ではないものの JSON コンテンツを含む場合は、データ型を text に設定します。値が標準の JSON 形式である場合は、JSON に設定します。
説明完全には有効でない JSON ログの場合でも、SLS は有効な部分を解析できます。
データ型を JSON に設定した後、クエリを高速化するために、JSON オブジェクト内のリーフノードにインデックスを作成します。この場合、追加のインデックス料金が発生します。
SLS は、JSON オブジェクト内のリーフノードに対するインデックスをサポートしていますが、リーフノードを含む子ノードに対するインデックスはサポートしていません。
SLS は、値が JSON 配列であるフィールド、または JSON 配列内のフィールドに対するインデックスをサポートしていません。これらのフィールドでは、代わりに JSON 関数を使用してリアルタイム分析を行ってください。
サンプルログに基づき、次のインデックスを作成します。
-
requestフィールドrequest:値は JSON 形式です。データ型を JSON に設定し、統計を有効にします。request.clientIp:頻繁に分析するため、個別にインデックスを作成し、データ型を text に設定して、統計を有効にします。request.http.path:分析することはまれなため、個別のインデックスは作成せず、必要に応じて JSON 関数で解析します。request.param:リーフノードを含む子ノードです。インデックス作成はサポートされていません。request.param.userId:頻繁に分析するため、個別にインデックスを作成し、データ型を text に設定して、統計を有効にします。request.param.orders:値は JSON 配列です。インデックス作成はサポートされていません。
-
responseフィールドresponseフィールドの値は、常に JSON 形式とは限りません。データ型を text に設定し、統計を有効にします。
インデックスを作成すると、新たに収集されたログはインデックス設定に基づいて表示されます。
エイリアスの設定
JSON のリーフノードのパスが長い場合は、エイリアスを設定します。詳細については、「列エイリアス」をご参照ください。
インデックス設定では、JSON 型フィールドのリーフノードに対してエイリアスを設定できます。たとえば、request.clientIp のエイリアスを ip に設定し、request.param.userId のエイリアスを id に設定します。
フィールド名とエイリアスは、インデックス設定内のすべてのフィールドで一意である必要があります。
JSON 型フィールドの場合、一意性はリーフノードのフルパスで判定されます。たとえば、
responseフィールドのエイリアスをclientIpに設定しても、フィールド名request.clientIpとは競合しません。
インデックス化された JSON フィールドのクエリと分析
クエリと分析の文は、クエリ文 | 分析文 の形式に従います。分析文では、フィールド名を二重引用符 ("") で囲み、文字列を単一引用符 ('') で囲みます。ネストされたフィールドにはフルパスを指定します。例:Key1.Key2.Key3、request.clientIp、request.param.userId。詳細については、「JSON ログのクエリと分析」をご参照ください。
たとえば、ユーザー 186499 のクライアント IP アドレスを検索するには、次のクエリを実行します。
*
and request.param.userId: 186499 |
SELECT
  distinct("request.clientIp")
JSON 関数を使用するタイミング
大量のデータで JSON 構造が複雑かつ固定で、クエリ性能が重要な場合は、JSON のリーフノードにフィールドインデックスを作成します。データ量が少ない場合やアドホック分析の場合は、フィールドインデックスを作成せずに JSON 関数を使用してコストを削減できます。JSON 関数を使用すると、JSON コンテンツを動的に処理して分析できます。状況によっては、JSON 関数が唯一の選択肢となります。
-
フィールド値が常に JSON 形式ではない、または前処理が必要な場合。
たとえば、
responseフィールドは、リクエストが失敗した場合にのみerrcodeフィールドを含む JSON となります。errcodeの分布を分析するには、失敗したリクエストに絞り込んで、JSON 関数でerrcodeを抽出します。* not response :SUCCESS | SELECT json_extract_scalar(response, '$.errcode') AS errcode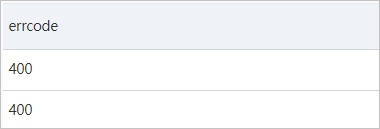
フィールドをインデックス化できない場合。
request.paramやrequest.param.ordersなど、インデックス作成をサポートしていない JSON ノードでは、JSON 関数がリアルタイム分析を行う唯一の方法です。
json_extract と json_extract_scalar の選び方
json_extract と json_extract_scalar は、どちらも JSON オブジェクトまたは配列からコンテンツを抽出します。主な違いは戻り値の型です。
-
json_extractは JSON 型を返し、json_extract_scalarは VARCHAR 型を返します。説明これは SQL のデータ型 (varchar、bigint、boolean、JSON、array、date) を指し、SLS のインデックスのデータ型とは異なります。SQL オブジェクトのデータ型を確認するには、
typeof関数を使用します。詳細については、「typeof 関数」をご参照ください。 json_extractは JSON オブジェクトの任意のサブ構造を解析できます。json_extract_scalarはスカラーのリーフノード (文字列、ブール値、数値) のみを解析し、対応する文字列を返します。
どちらの関数でも、request フィールドから clientIp フィールドを抽出できます。
-
json_extractを使用する場合:* | SELECT json_extract(request, '$.clientIp')クエリと分析の結果では、エイリアスが設定されていないため、列名はデフォルトの
_col0として表示され、json_extractにより抽出されたclientIpの値が含まれます。 -
json_extract_scalarを使用する場合:* | SELECT json_extract_scalar(request, '$.clientIp')上記のクエリ文を実行すると、クエリ結果には抽出したフィールド値が 1 つの列
_col0に表示されます。
clientIp の値の第 1 オクテットを抽出するには、json_extract_scalar で clientIp を抽出してから、split_part で最初の数値を抽出します。json_extract は、split_part が VARCHAR 入力を必要とするため、この場合使用できません。
* |
SELECT
  split_part(
    json_extract_scalar(request, '$.clientIp'),
    '.',
    1
  ) AS segment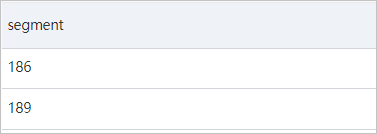
ほとんどの場合は json_extract_scalar を使用します。戻り値が VARCHAR 型のため、他の SQL 関数と自然に組み合わせられます。JSON 構造そのものを扱う必要がある場合は json_extract を使用します。たとえば、リクエスト内の注文数 (request.param.orders 配列の長さ) をカウントするには、次のクエリを実行します。
* |
SELECT
json_array_length((json_extract(request, '$.param.orders')))クエリと分析の結果では、_col0 列に各リクエストの JSON 配列の長さ (つまり注文数) が返されます。サンプル値は 2 です。
json_extract_scalar は VARCHAR 型を返します。たとえば、前述の結果の数値 2 は VARCHAR です。合計などの計算を行うには、まず CAST を使用して bigint にキャストします。詳細については、「型変換関数」をご参照ください。
JSON パスの設定
json_extract などの関数を使用する場合は、抽出対象の JSON オブジェクトの部分を指定するために JSON パスを指定します。形式は $.a.b です。ここで、$ はルートノードを表し、ピリオド (.) は子ノードを参照します。
http.path、http path、http-path など、特殊文字を含む JSON フィールド名の場合は、ピリオドの代わりに角括弧 [] を使用し、フィールド名を二重引用符で囲みます。例: * |SELECT json_extract_scalar(request, '$["http.path"]')。
SDK 経由でクエリする場合は、二重引用符をエスケープします。例: * | select json_extract_scalar(request, '$[\"http.path\"]')。
JSON 配列から要素を抽出するには、角括弧 [] と 0 から始まるインデックスを使用します。
-
ユーザーの 1 件目の注文の支払い額を表示するには、次のクエリを実行します。
* |
SELECT
  json_extract_scalar(request, '$.param.orders[0].payment')
クエリ結果テーブルでは、
_col0列に 2 行が表示され、どちらも値は132です。 -
ユーザーの 1 件目の注文で購入した 2 番目の商品を表示するには、次のクエリを実行します。
* | SELECT json_extract_scalar(request, '$.param.orders[0].commodity[1]')_col0列には 2 件のレコードが返され、どちらも値はmilkです。
JSON 配列の分析
JSON 配列を分析するには、CAST と UNNEST 句を組み合わせて配列を展開し、その後に結果を集計します。
例 1
成功したすべての注文の支払い総額を算出するには、次の手順に従います。
-
成功したリクエストに絞り込んで、
json_extractを使用してordersフィールドを抽出します。* and response: SUCCESS | SELECT json_extract(request, '$.param.orders')_col0 [{"commodity":["bread","milk","meat"],"payment":132},{"commodity":["milk","beer"],"payment":49}] [{"commodity":["bread","milk","meat"],"payment":132},{"commodity":["milk","beer"],"payment":49}] -
JSON 配列を array 型に変換します。
*
and response: SUCCESS |
SELECT
  cast(
    json_extract(request, '$.param.orders') AS array(json)
  )
_col0 ["{"commodity":["bread","milk","meat"],"payment":132}","{"commodity":["milk","beer"],"payment":49}"] ["{"commodity":["bread","milk","meat"],"payment":132}","{"commodity":["milk","beer"],"payment":49}"] -
UNNESTを使用して、配列を個々の行に展開します。* and response: SUCCESS | SELECT orderinfo FROM log, unnest( cast( json_extract(request, '$.param.orders') AS array(json) ) ) AS t(orderinfo)クエリと分析の結果:
orderinfo {"commodity":["milk","beer"],"payment":49} {"commodity":["milk","beer"],"payment":49} -
json_extract_scalarを使用してpaymentの値を抽出し、bigint にキャストして合計します。* and response: SUCCESS | SELECT sum( cast( json_extract_scalar(orderinfo, '$.payment') AS bigint ) ) FROM log, unnest( cast( json_extract(request, '$.param.orders') AS array(json) ) ) AS t(orderinfo)戻り値は
10860です。
例 2
成功したすべてのリクエストにおける各商品の購入数量をカウントするには、orders フィールドを抽出し、array(json) にキャストして、UNNEST で展開します。各行が 1 件の注文になります。次に、commodity フィールドを抽出し、キャストして再度展開します。各行が 1 つの商品になります。最後に、グループ化してカウントします。
*
and response: SUCCESS |
SELECT
  item,
  count(1) AS cnt
FROM  (
    SELECT
      orderinfo
    FROM      log,
      unnest(
        cast(
          json_extract(request, '$.param.orders') AS array(json)
        )
      ) AS t(orderinfo)
  ),
  unnest(
    cast(
      json_extract(orderinfo, '$.commodity') AS array(json)
    )
  ) AS t(item)
GROUP  BY
  item
ORDER BY
cnt DESCクエリ結果には、item と cnt の 2 列が含まれます。各商品の購入回数の統計は次のとおりです。
"milk": 120
"bread": 60
"rice": 60
"beer": 60
"meat": 60