Database Autonomy Service (DAS) は、ApsaraDB RDS for MySQL インスタンスを監視し、トラフィックスパイク時に CPU とメモリを自動的にスケールアップし、負荷が低下するとスケールダウンします。これにより、手動での介入なしにパフォーマンスを安定させることができます。
利用シーン
性能自動スケーリングは、次のような場合に効果的です。
-
トラフィックが予測不能な場合。 ワークロードに突然のバースト (タイムセール、バッチジョブ、ピーク営業時間など) が発生し、事前の計画なしにデータベースを対応させたい場合。
-
過剰プロビジョニングを避けたい場合。 ピーク時間後にスケールダウンすることで、リソースコストを実際の需要に合わせることができます。
-
汎用インスタンスまたは専用型インスタンスを実行している場合。 両方のインスタンスファミリーがサポートされていますが、スケーリングの動作は異なります (「仕組み」をご参照ください)。
トラフィックのピークが固定のスケジュールで発生する場合は、代わりにスケジュールされた自動スケーリング機能を使用してください。
前提条件
-
お使いの RDS インスタンスが廃止予定のインスタンスタイプを使用していないこと。使用している場合は、まずインスタンスタイプを変更してください。
-
Alibaba Cloud アカウントの残高が十分であること。
-
DAS のサービスリンクロールが存在すること。DAS は、この機能を初めて有効にするときに AliyunServiceRoleForDAS ロールを自動的に作成するため、ロールが削除されていない限り、手動での設定は不要です。
仕組み
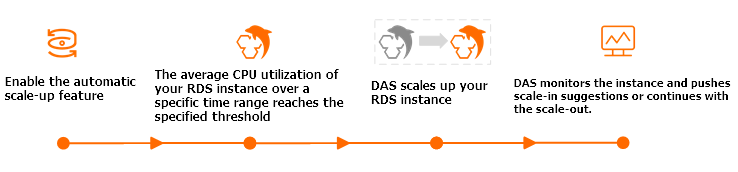
すべてのスケーリングの決定は、観測ウィンドウ内の平均 CPU 使用率に基づいています。
スケールアップ
CPU 使用率が観測ウィンドウの持続時間中、設定されたしきい値に達すると、DAS はスケールアップをトリガーします。具体的な動作はインスタンスタイプによって異なります。
クラウドディスク + 専用型インスタンスタイプ (RDS High-availability Edition)
DAS は、設定された範囲内で次の仕様セットを選択し、インスタンスをスケールアップします。スケールアップ後、DAS は監視を継続します。次の観測ウィンドウで CPU 使用率が再びしきい値を超えた場合、DAS は再度スケールアップします。このプロセスは、インスタンスが設定した最大仕様に達するまで繰り返されます。
プレミアムローカル SSD + 汎用インスタンスタイプ (RDS High-availability Edition または RDS Enterprise Edition)
DAS は CPU コア数を 2 倍にします。たとえば、4 コアはスケールアップ後に 8 コアになります。IOPS は、追加された CPU コアごとに 1,000 増加します。
次の 2 つの制約が適用されます。
-
CPU コアの倍増は一度しかできません。インスタンスが 8 コアに達した後、16 コアにスケーリングすることはできません。
-
ホストの CPU リソースが不足している場合、スケールアップはスキップされます。
スケールダウン
システムが元の仕様にロールバックするのは、最初のスケールアップが自動スケールダウンを有効にした*後*に発生した場合のみです。スケールダウンを有効にする前にスケールアップが発生した場合、スケールダウンを有効にしても、インスタンスはスケールアップ後の仕様のままになります。
クラウドディスクインスタンス (RDS High-availability Edition)
クールダウン期間が終了した後、スケールダウン観測ウィンドウの 99% を超える時間、CPU 使用率が 30% 未満で推移した場合、DAS はスケールダウンをトリガーします。仕様は元の値に段階的に戻されます。
スケールダウン観測ウィンドウは、[観測ウィンドウ] の持続時間に 10 分を加えたものと同じです。たとえば、30 分の観測ウィンドウの場合、スケールダウンウィンドウは 40 分になります。
自動スケールダウン機能には、新しい RDS アーキテクチャ (kindCode = 18) が必要です。 インスタンスのアーキテクチャを確認するには、DescribeDBInstanceAttribute を呼び出します。
プレミアムローカル SSD + 汎用インスタンスタイプ (RDS High-availability Edition または RDS Enterprise Edition)
設定されたスケールダウン観測ウィンドウの 99% を超える時間、CPU 使用率が 30% 未満で推移した場合、DAS は IOPS と CPU コアを元の仕様にスケールダウンします。
課金
| インスタンスタイプ | 課金方法 | 詳細 |
|---|---|---|
| プレミアムローカル SSD + 汎用 (RDS High-availability Edition または RDS Enterprise Edition) | 従量課金、時間単位で請求 | 計算式:(CPU コアあたりの料金 × 追加された CPU コア数) × スケールアップ時間 (分) |
| クラウドディスク (RDS High-availability Edition) | スケールアップ後のインスタンスレートで課金 | 料金はリージョンと仕様によって異なります。最新の料金については、ApsaraDB RDS 購入ページをご参照ください。 |
潜在的な影響
-
インスタンススイッチオーバー (クラウドディスクインスタンスのみ)。 仕様変更により、インスタンススイッチオーバーがトリガーされる場合があります。 アプリケーションが自動的に再接続するように設定してください。 影響の詳細については、「インスタンススイッチオーバーの影響」をご参照ください。
-
マイナーエンジンバージョンの更新。 インスタンスが最新のマイナーエンジンバージョンを実行していない場合、パフォーマンスと安定性を確保するために、仕様変更中にシステムが更新します。
-
スケーリングはプライマリインスタンスにのみ適用されます。 スケールアップ後にプライマリ/セカンダリ スイッチオーバーが発生した場合:
-
新しいプライマリ (元のセカンダリ) は、スケーリング条件を満たしたときに DAS によってスケールアップまたはスケールダウンされます。
-
新しいセカンダリ (元のプライマリ) は、スケールダウン条件を満たした場合、元の仕様にスケールダウンされます。
-
性能自動スケーリングの有効化
-
[インスタンス] ページに移動します。上部のナビゲーションバーで、RDS インスタンスが存在するリージョンを選択します。対象のインスタンスを見つけ、その ID をクリックします。
-
次のいずれかのパスを使用して、[自律型機能管理] パネルを開きます。
-
Autonomy サービス > 診断 > Autonomy センター タブ > Autonomy サービス設定
-
自律サービス > ダッシュボード > 自律サービス設定項目
-
-
[自律型機能設定] タブで、自律サービスを有効にします。
-
[最適化とスロットリング] タブで、インスタンスタイプに適した機能を選択します。
-
クラウドディスクインスタンス:[性能自動スケーリング] を選択します
-
プレミアムローカル SSD + 汎用インスタンス:[自動リソース弾性] を選択します
-
-
インスタンスタイプのパラメーターを設定します。
クラウドディスク + 専用型インスタンスタイプ
パラメーター 説明 観測ウィンドウ DAS が平均 CPU 使用率を評価するために使用するモニタリング期間です。この期間中に平均 CPU 使用率がしきい値に達すると、スケールアップがトリガーされます。スケールダウンウィンドウは、この値に 10 分を加えた期間となります。 最大仕様 スケールアップの上限です。DAS は、インスタンスがこの上限に達するまで段階的にスケールアップします。 自動スケールダウン 選択すると、スケールダウン観測ウィンドウの 99% を超える期間、CPU 使用率が 30% 未満であった場合に、クールダウン期間の後にスケールダウンがトリガーされます。仕様は、元の値まで少しずつ引き下げられます。 静止期間 連続する 2 つのスケーリング操作の間の最小間隔 (クールダウン期間) です。DAS はこの期間中も CPU 使用率をモニターしますが、条件が満たされてもスケーリングはトリガーしません。クールダウン期間と観測ウィンドウが同時に終了し、かつ条件が満たされた場合、DAS は直ちにスケーリングをトリガーします。 プレミアムローカル SSD + 汎用インスタンスタイプ
パラメーター 説明 [スケールアップ観測ウィンドウ] スケールアップのために CPU 使用率を評価するために使用される監視期間。平均 CPU 使用率がしきい値に達すると、スケールアップがトリガーされます。 スケールダウン監視ウィンドウ スケールダウンのために CPU 使用率を評価するために使用される監視期間。このウィンドウの 99% を超える時間、CPU 使用率が 30% 未満で推移した場合にスケールダウンがトリガーされます。 -
[OK] をクリックします。
-
(オプション) [アラート設定] セクションで、アラートテンプレートを設定して、スケーリングイベントに関する通知を受け取ります。システムは、自律イベント用に事前設定されたルールを持つアラートテンプレートを提案します。設定するには:
-
[アラートグループの選択] ステップでは、アラートグループを選択します。詳細については、「アラート連絡先の管理」をご参照ください。
-
個別の連絡先を追加するには、[連絡先の追加] をクリックします。
-
新しいグループを作成するには、[連絡先グループの作成] をクリックします。
-
既存の連絡先を管理するには、[操作] 列の [編集] または [削除] を使用します。
-
-
[リソースとの関連付け] ステップで、関連付けられたリソースを確認します。
-
[設定の送信] をクリックし、ダイアログボックスで確認します。
説明インスタンスにアラートテンプレートが既に存在する場合、新しいテンプレートを作成するのではなく、必須の自律イベントルールをそのテンプレートに追加してください。テンプレートをゼロから設定するには、「アラートテンプレートを設定する」および「アラートルールを設定する」をご参照ください。
-
よくある質問
インスタンスが最大仕様に達しました。どのような選択肢がありますか?
より上位の RDS エディションを実行するインスタンスを購入します。たとえば、専用型インスタンスタイプを持つ RDS High-availability Edition インスタンスは、最大 104 CPU コアと 768 GB のメモリをサポートします。その後、新しいインスタンスにデータを移行します。
利用可能なインスタンスタイプと移行オプションの詳細については、「仕様」および「ApsaraDB RDS for MySQL インスタンス間でデータを移行する」をご参照ください。
次のステップ
-
スケジュールされた自動スケーリング: 固定のスケジュールでスケーリングポリシーを設定し、各期間の終了後に仕様を自動的に復元します。詳細については、「スケジュールされた自動スケーリング機能を使用する」をご参照ください。
-
手動での仕様変更: 性能自動スケーリングに対応していないインスタンスでは、手動でインスタンスの仕様を変更します。 詳細については、「インスタンスの仕様を変更する」をご参照ください。