ARMS Prometheus の最新リリースは Helm v1.1.17 で、エージェント v4.0.0 に対応しています。このバージョンには、収集の安定性を向上させ、既知のバグを修正し、リソース消費を最適化するための複数の機能強化が含まれています。
クラスターで v3.x.x シリーズの ARMS Prometheus エージェントを実行している場合は、最新バージョンへのアップグレードを強く推奨します。古いバージョンには、最適化されていないコンポーネントが含まれている可能性があり、データが途切れるリスクがあります。
v4.0.0 の新機能
|
変更タイプ |
説明 |
|
新機能 |
Kubernetes Deployment ダッシュボードをサポートするために、クラスターイベントの収集ジョブを追加しました。 |
|
新機能 |
SLA 安定性ダッシュボードにデータを提供するため、Service Level Agreements (SLA) に基づく自己監視メトリクスを追加しました。 |
|
新機能 |
ServiceMonitor での BasicAuth 認証のサポートを追加しました。Secret は ServiceMonitor と同じ名前空間に配置する必要があります。 |
|
新機能 |
特定のメトリクスの意味を表示するメトリクスメタデータ機能を追加しました。 |
|
新機能 |
エージェントがチャートバージョンをサーバーに送信できるようになりました。サーバーはバージョン番号を使用してダッシュボードを初期化またはアップグレードします。 |
|
新機能 |
各データバッチの送信所要時間を追跡するための RemoteWrite 自己監視メトリクスを追加しました。 |
|
新機能 |
基本的なメトリクス収集のエラーとレイテンシを監視する自己監視メトリクスを追加しました。 |
|
新機能 |
ビジネスメトリクス収集のエラーとレイテンシを監視する自己監視メトリクスを追加しました。 |
|
改善 |
大規模クラスターのスケーラビリティを向上させるため、デフォルトの RemoteWrite |
|
改善 |
CSI 収集ジョブのサービスディスカバリ方式を改善しました。主に PersistentVolume (PV) の収集に使用されます。 |
|
改善 |
|
|
改善 |
一部のログエントリを簡素化し、スクレイピングパイプラインのより詳細なタイミング情報を提供できるよう強化しました。 |
|
改善 |
基本的なメトリクス収集ジョブを改善し、固定のスクレイプ間隔とタイムアウトを使用するようにしました。グローバル設定から切り離すことで、干渉を削減します。 |
|
改善 |
マスター・スレーブ型マルチレプリカモードでの相互作用ロジックを最適化しました。マスターとワーカーのレプリカが互いに干渉しなくなり、全体的な安定性が向上しました。 |
|
改善 |
マスターレプリカからのターゲット配信戦略を改善し、CPU 使用率を約 30%、メモリ消費を 40% 削減し、収集パフォーマンスを向上させました。 |
|
改善 |
|
|
改善 |
マルチテナントシナリオ向けに Informer リスナーロジックを最適化し、CPU 使用率を約 20% 削減しました。 |
|
改善 |
断続的な CoreDNS 解決失敗の処理を改善しました。エージェントはキャッシュされた IP アドレスにフォールバックするようになり、リアルタイム DNS 解決への依存を減らし、データ送信の安定性が向上します。 |
|
改善 |
|
|
改善 |
マスターレプリカでのプリスクレイピング戦略を最適化し、リソース消費を削減し、サービスディスカバリとターゲットスケジューリング機能を強化しました。 |
|
改善 |
1 MB を超える単一データバッチの適応型処理を追加し、バックエンドの制限によるデータ損失を削減しました。 |
|
修正 |
|
|
修正 |
マルチテナントシナリオで、Pod ラベルキャッシュの更新遅延により、単一の時系列が 2 つに分割される問題を修正しました。 |
|
修正 |
マスターレプリカが、再起動またはメモリ不足 (OOM) エラーが発生したレプリカにターゲットを配信できなくなり、スクレイプターゲットが欠落する場合がある問題を修正しました。 |
|
修正 |
RemoteWrite での Secret タイプの解析とヘッダー送信に関する問題を修正しました。 |
|
修正 |
|
|
修正 |
グローバルデフォルトパラメータと |
アップグレードのリスク
-
アップグレードのリスク:Helm v1.1.17/エージェント v4.0.0 へのアップグレードは破壊的アップグレードです。クラスターのメトリクス収集負荷 (ターゲット数と時系列数) によっては、短時間データが中断する可能性があります。中断時間は 0~5 分程度と予想されますが、クラスターによって異なる場合があります。
-
アップグレード前:クラスターの監視データへの影響を最小限に抑えるため、ステップ 1:アップグレード前のチェック (必須) の説明に従って、アップグレード前のチェックを実行する必要があります。
-
アップグレード後:データに問題がある場合は、ステップ 3:アップグレード後のチェック (オプション) の手順に従ってください。問題が解決しない場合は、アップグレード後の FAQ をご参照ください。さらにサポートが必要な場合は、DingTalk (ID: aliprometheus) の技術専門家までお問い合わせください。
アップグレード手順
ステップ 1:アップグレード前のチェック (必須)
1.1.16 より前の Helm バージョンからバージョン 1.1.17 にアップグレードする場合、アップグレード時にカスタムパラメータ設定は保持されません。アップグレード前にカスタム設定を確認する必要があります。これらの設定を保持する場合は、アップグレード完了後に手動で再適用する必要があります。
Helm バージョン 1.1.16 以降からのアップグレードでは、カスタムパラメータが自動的に継承されるため、以降のアップグレードで再適用する必要はありません。アップグレード前に次の手順に従ってパラメータを確認してください。
-
対象クラスターの名前をクリックします。左側のナビゲーションペインで、Workload > ステータスなし を選択します。
arms-prom名前空間を選択します。arms-prometheus-ack-arms-prometheusワークロードを見つけ、Operation 列で その他 > YAML の表示 を選択して、完全な YAML 設定を表示します。 -
次のパラメータを確認し、保持するカスタム値を記録します。
-
spec.replicas:アップグレード後のデフォルト値は 1 です。現在の値が異なる場合は記録してください。 -
spec.containers.args:これらはマルチテナントモードのエージェント起動パラメータです。マルチテナントモードが有効になっていない場合、このフィールドは存在しない可能性があります。これらのパラメータをカスタマイズしている場合は、その値を記録してください。-
tenant_userid -
tenant_clusterid -
tenant_token
-
-
spec.containers.resources:デフォルトの制限は 3 コアと 4 GiB のメモリです。デフォルトのリクエストは 1 コアと 1 GiB のメモリです。設定が異なる場合は、アップグレード後に再適用できるように値を記録してください。

アップグレード後、同じ方法で YAML 設定を表示し、ファイルを編集してカスタム値を再適用してから、更新 をクリックして変更を保存します。

-
ステップ 2:アップグレード手順
ACK コンソールを使用して ARMS Prometheus コンポーネントの Helm バージョンをアップグレードすることを推奨します。次の手順に従います。
-
対象のクラスターの名前をクリックします。 左側のナビゲーションペインで、操作 > コンポーネントの管理 を選択します。 ログとモニタリング タブをクリックし、ack-arms-prometheus カードを見つけ、アップグレード をクリックします。
-
アップグレードが完了したら、左側のナビゲーションペインで 操作 > Prometheus モニタリング を選択します。右上隅にある ARMS Prometheus に移動 をクリックします。Prometheus 向けマネージドサービスコンソールの Prometheus インスタンスリストページにリダイレクトされ、そこでエージェントのステータスとメトリクス収集の詳細を表示できます。
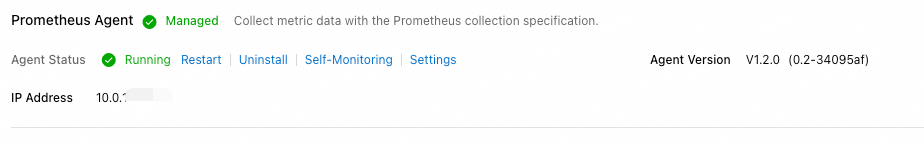
アップグレードを検証するには、左側のナビゲーションペインでSettingsをクリックし、Settings タブでコンポーネントのバージョンを確認することもできます。
ステップ 3:アップグレード後のチェック (オプション)
にログインします。 Prometheusコンソールのマネージドサービス。
左側のナビゲーションウィンドウで、[インスタンス] をクリックします。
-
対象の Prometheus インスタンスの名前をクリックします。 左側のナビゲーションペインで、サービスディスカバリー をクリックします。 [ターゲット] タブをクリックして、収集ジョブのステータスを確認します。
-
左側のナビゲーションペインで、Settings をクリックします。 セルフモニタリング タブで、右上隅にある Grafana に移動してダッシュボードを表示する をクリックします。 アップグレード後、エージェントの動作ステータスを監視します。 レプリカ数が正しいこと、およびデータ送信レート、リソース消費量、またはエラー数に異常がないことを確認します。
-
セルフモニタリング ページで エージェントのセルフモニタリング タブをクリックし、Prometheus エージェント自己監視ダッシュボードを表示します。
アップグレード後、4 つの基本的なメトリクス収集ジョブ (
_arms/kubelet/cadvisor、_arms/kubelet/metric、_kube-state-metrics、node-exporter) を確認し、右上隅の時間範囲セレクターを使用してアップグレード前後のデータを比較し、収集の問題がないか確認してください。
アップグレード後の FAQ
アップグレード後のレプリカ数の不一致
いずれかのエージェントレプリカが Pending 状態であるか確認してください。ARMS Prometheus エージェントが正常に機能するには、すべてのレプリカが Running 状態である必要があります。すべてのレプリカのステータスは、ACK コンソールのターゲットクラスターにある arms-prom 名前空間の Workload > ステータスなし ページで確認できます。
アップグレード後のリソース消費の増加
データ送信エラーを確認します。このようなエラーは、エージェントのメモリにデータが蓄積され、リソース消費の増加につながる可能性があります。ACK コンソールで Prometheus エージェントのメモリおよび CPU 使用率を確認できます。ターゲットクラスターの 操作 > Prometheus モニタリング ページに移動し、その他 タブをクリックして、[Prometheus エージェント] セクションでリソース使用率を表示します。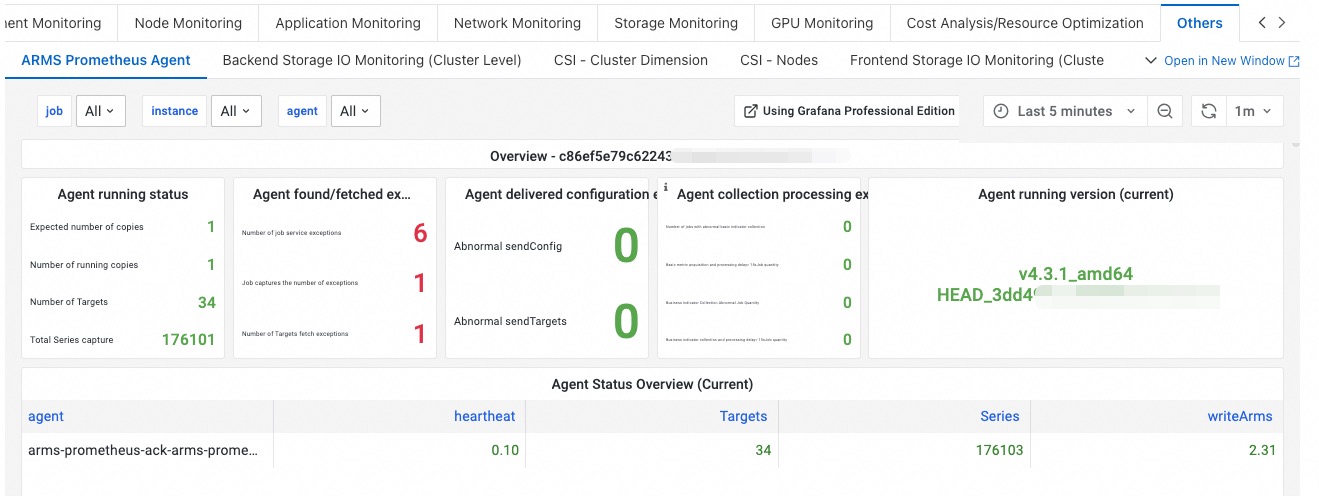
基本メトリクスの欠落または不連続
node_*** (アイコン①)、container_*** (アイコン②)、kubelet_*** (アイコン③)、または kube_*** (アイコン④) などの基本メトリクスに問題がある場合は、対応する収集ジョブがエラーを報告しているかどうかを確認してください。これらのジョブのステータスは、Prometheus マネージドサービスのコンソールの サービスディスカバリー > [ターゲット] タブで確認できます。エラーが見つかった場合は、DingTalk (ID: aliprometheus) で当社のテクニカルエキスパートにお問い合わせください。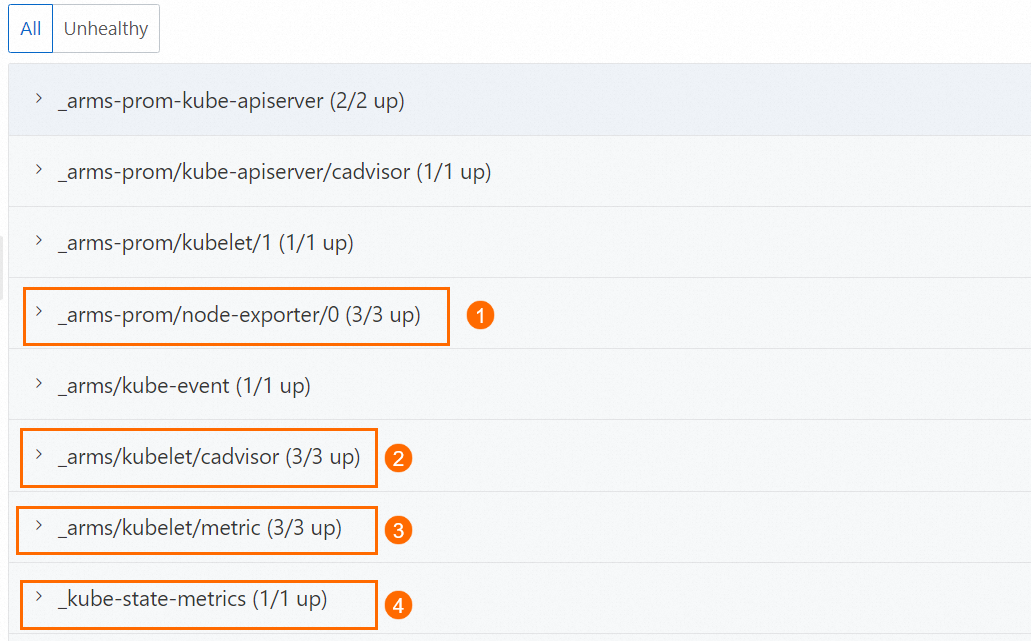
RemoteWrite トラフィックの低下またはデータ損失
-
RemoteWrite を設定していない場合は、この問題を無視できます。
-
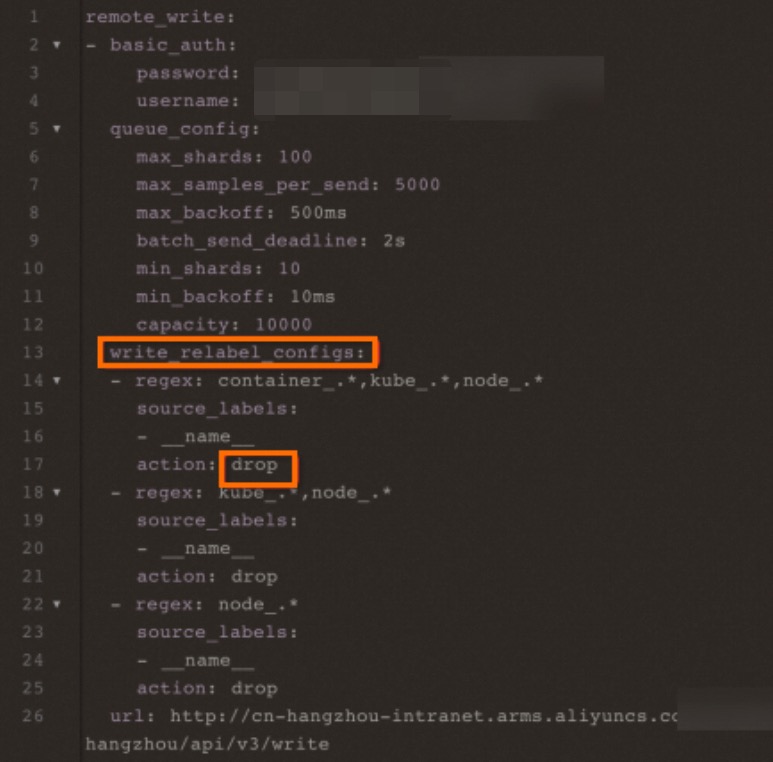
RemoteWrite を設定している場合、agent v4.0.0 では、以前のバージョンとは異なり、
write_relabel_configs設定がデフォルトで有効になっている点にご注意ください。設定にdropやkeepなどのアクションが含まれている場合、トラフィックの低下が見られることがあります。この設定は必要に応じて調整できます。調整するには、Managed Service for Prometheus コンソールの Settings ページに移動し、Settings タブで Prometheus.yaml の編集 をクリックして設定を変更します。