事前学習済みの ViT モデルをデプロイして画像分類を行うか、独自のデータセットでファインチューニングを行い、画像をカスタムカテゴリに分類します。
前提条件
OSS バケットを作成します。 詳細については、「バケットの作成」をご参照ください。
ステップ1:モデル詳細ページを開く
-
モデルギャラリーページに移動します。
-
PAI コンソールにログオンします。
-
上部メニューの左上隅でリージョンを選択します。
-
左側メニューで ワークスペースリスト をクリックし、開きたいワークスペースの名前をクリックします。
-
左側メニューで、クイックスタート > [Model Gallery] を選択します。
-
-
モデルギャラリーページの コンピュータビジョン セクションで 画像分類 をクリックします。 次に、[ViT Image Classification-General] モデルカードをクリックして、モデル詳細ページを開きます。
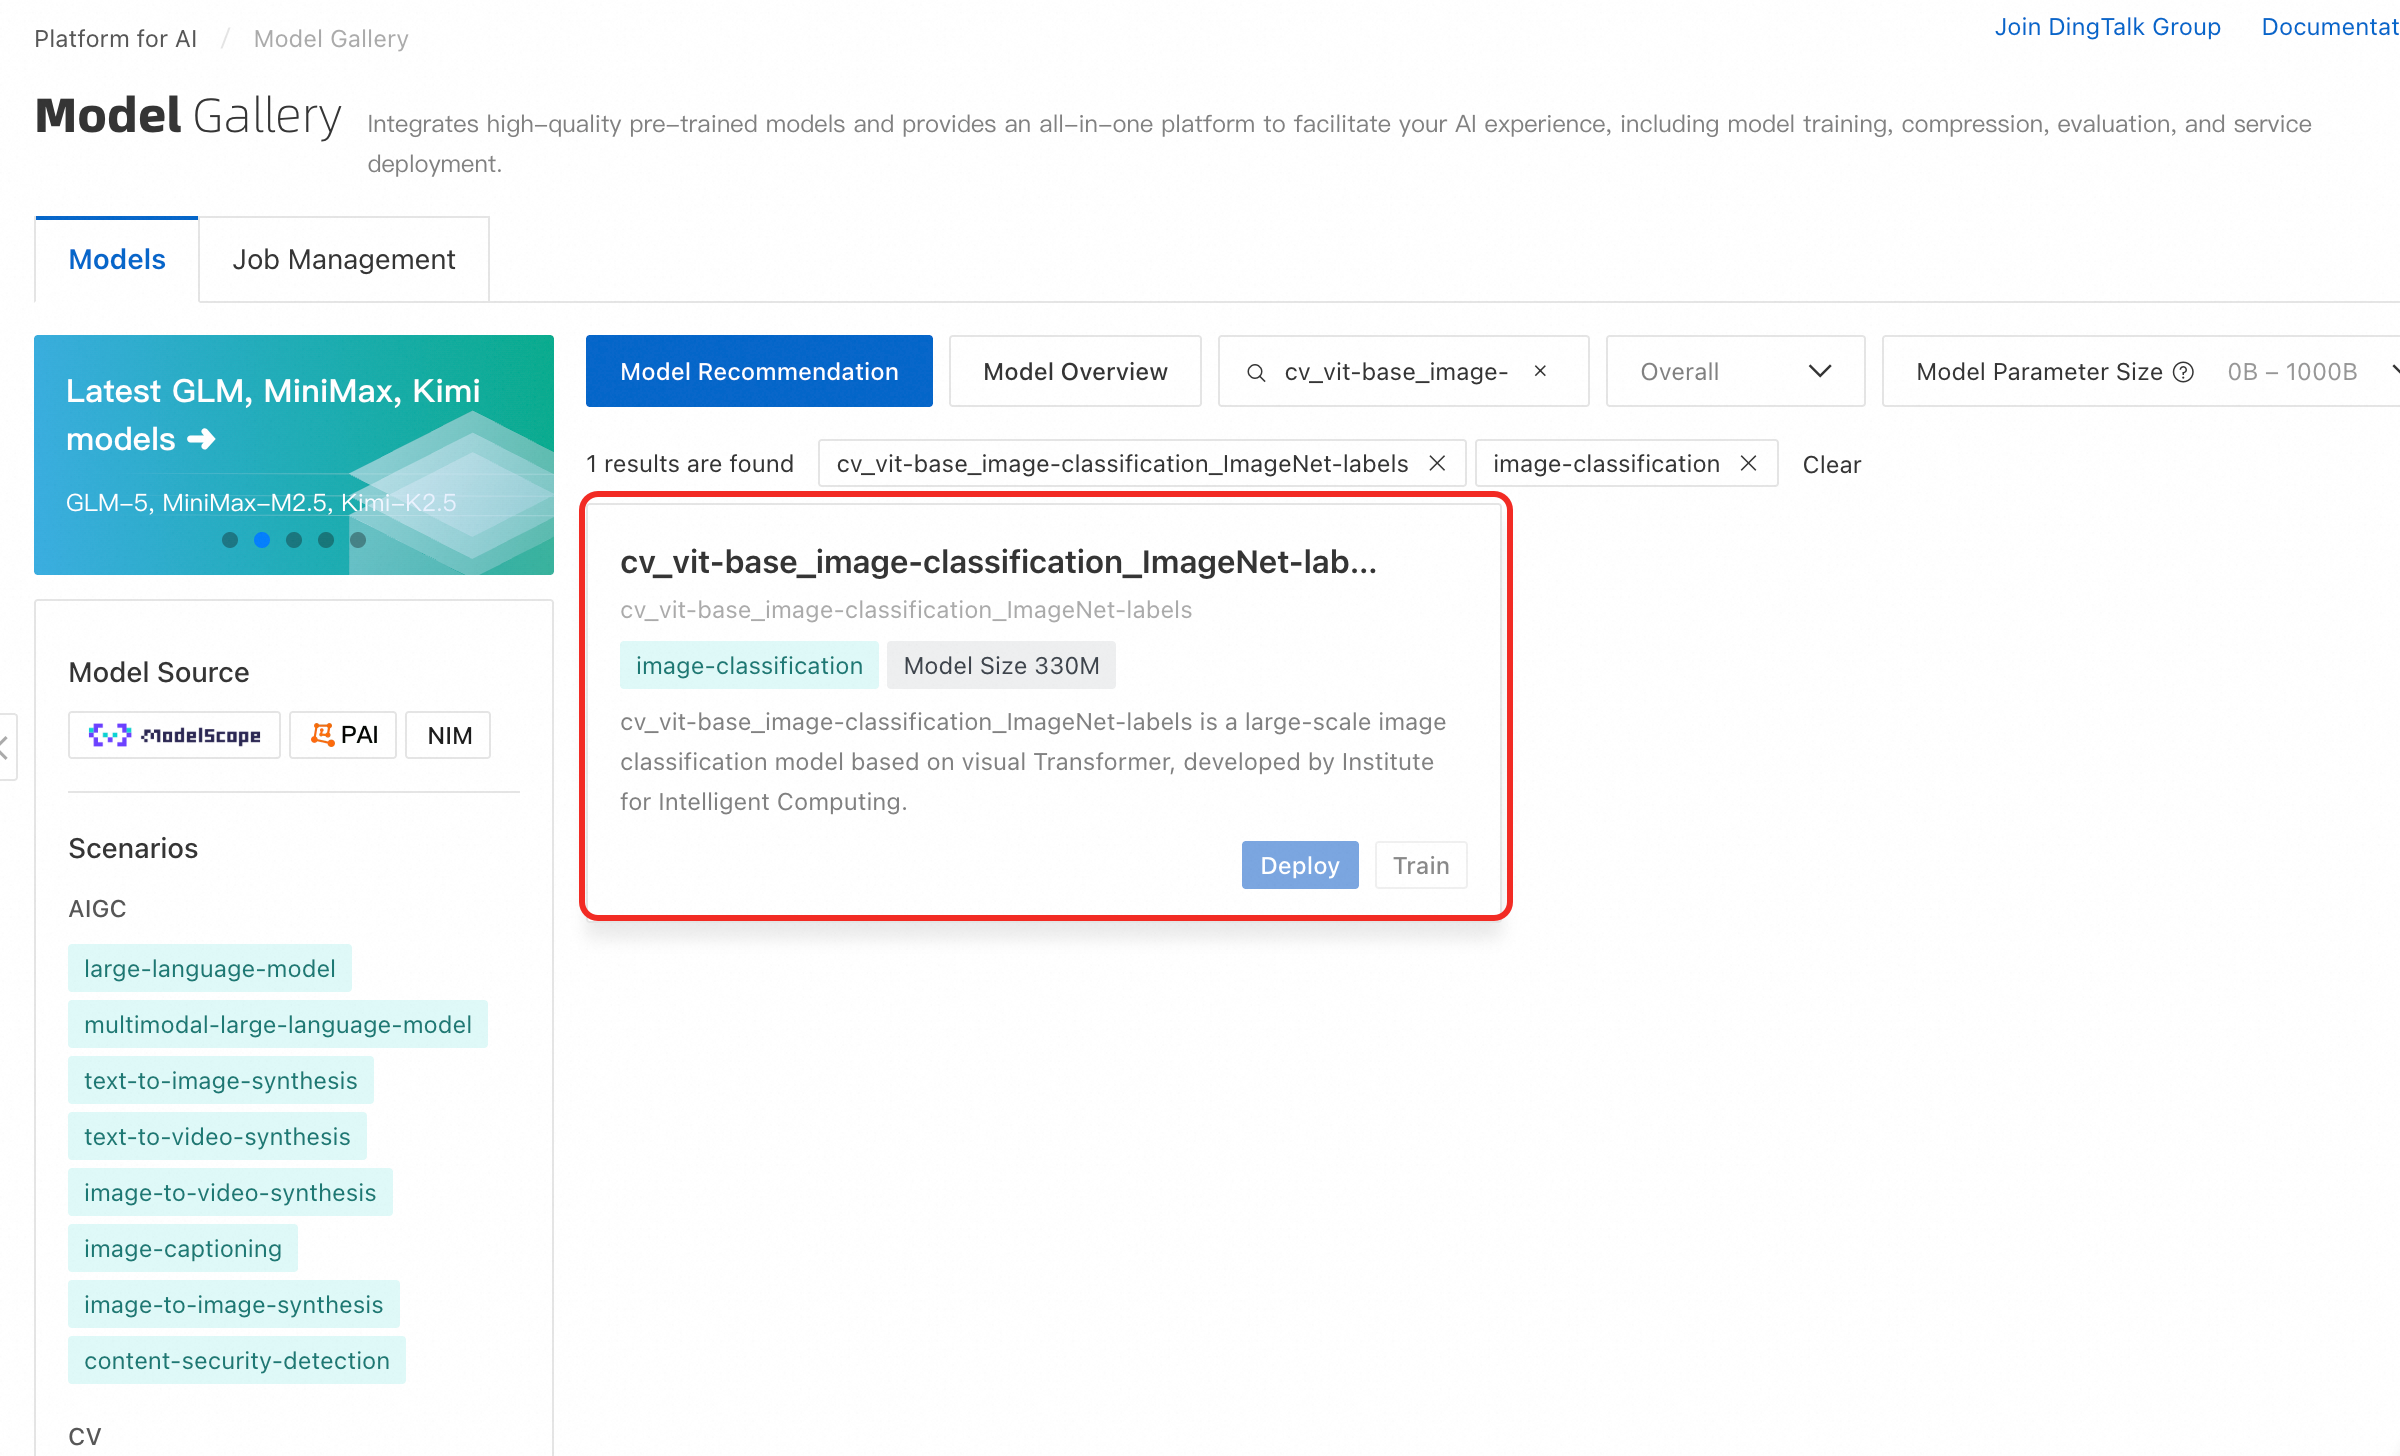
モデルリストページでは、さまざまなオープンソースコミュニティの複数のモデルが利用可能です。 要件に合ったモデルを選択してください。
-
パラメーター数が多いモデルはパフォーマンスが向上しますが、ファインチューニングにはより多くのデータが必要となり、サービングコストも高くなります。
-
事前学習済みのデータセットがユースケースに近いほど、モデルのパフォーマンスは向上します。 事前学習済みのデータセット情報については、モデル詳細ページでご確認ください。
-
ステップ2:モデルを直接デプロイする
cv_vit-base_image-classification_ImageNet-labels モデルは、ModelScope コミュニティの ViT Image Classification-General モデルです。 このモデルは Transformer ViT Base アーキテクチャに基づいており、ImageNet-1K データセットでトレーニングされています。 ImageNet-1K のラベルに対応する分類タスクをサポートしています。 モデルギャラリーは、このモデルを Elastic Algorithm Service (EAS) にデプロイして推論サービスを作成します。 手順は次のとおりです。
-
サービスのデプロイ
-
モデル詳細ページで、モデルデプロイ をクリックします。
-
モデルサービス情報 と リソースデプロイメント情報 を確認してください。
モデルギャラリーは、モデルの特性に基づいてコンピューティングリソースとサービス名を事前に設定します。 この例ではデフォルト設定を使用しますが、カスタマイズすることも可能です。 詳細については、「モデルのデプロイとデバッグ」をご参照ください。
-
デプロイメント をクリックします。 課金通知 ダイアログボックスで、OK をクリックします。
ページは サービスの詳細 ページにリダイレクトされます。 基本情報 セクションで、ステータス が 実行中 に変わるまで待ちます。
-
-
モデルサービスの呼び出し
デプロイ後、モデルサービスの HTTP API に予測リクエストを送信します。 このサービスは、Base64 エンコードされた画像を受け取り、JSON 形式で結果を返します。
-
サービスの詳細 ページの リソース情報 セクションで、エンドポイント情報の表示 をクリックします。

-
呼び出し情報 ダイアログボックスの Shared Gateway - インターネットエンドポイント タブで、エンドポイント と [Token] を保存します。
-
Python の Requests ライブラリを使用してモデルサービスを呼び出します。 例:
import requests import base64 image_path = "<PathToLocalImage>" url = "<PredictionServiceURL>" token = "<PredictionServiceAccessToken>" def encode_file_to_base64(f): with open(f, "rb") as file: encoded_string = base64.b64encode(file.read()) base64_str = str(encoded_string, "utf-8") return base64_str base64_string = encode_file_to_base64(image_path) request_body = { "image": base64_string } headers = {"Authorization": token} resp = requests.post(url=url, headers=headers, json=request_body) print(resp.content.decode()) print("status code:", resp.status_code)urlを前の手順の [Endpoint] に、tokenを [Token] に、image_path をローカル画像ファイル (.png または .jpg) のパスに置き換えます。呼び出しが成功すると、最も可能性の高いラベル上位 5 件とそのスコアが返されます。 出力例:
{
  "scores": [
    0.4078965485095978,
    0.24673610925674438,
    0.1930493414402008,
    0.0026617543771862984,
    0.0009246605914086103
  ],
  "labels": [
    "tiger cat",
    "tabby, tabby cat",
    "Egyptian cat",
    "lynx, catamount",
    "tiger, Panthera tigris"
  ]
}
-
ステップ3:モデルをファインチューニングする
cv_vit-base_image-classification_ImageNet-labels モデルは、ImageNet-1K のラベルに対応する分類タスクをサポートしています。 目的のドメインが含まれていない場合は、そのドメイン用にラベル付けされた少数の画像を使用してモデルをファインチューニングします。
-
データの準備
-
次のディレクトリ構造に従ってデータセットを準備します。
モデルは、OSS バケットの画像データでトレーニングされます。 データセットは、カテゴリごとに 1 つのサブディレクトリを持つルートディレクトリに配置します。 各サブディレクトリ名はカテゴリ ラベルとして機能します。 たとえば、トレーニングデータセットが
oss://{YourOssBucket}.{OssEndpoint}/{PathToTrainData}/にある場合、構造は次のようになっている必要があります。├── category-1 │ ├── image1.jpeg │ └── image2.jpeg ├── category-2 │ ├── image3.jpeg │ └── image4.jpeg |... |... └── category-n ├── imagexxx.jpeg └── imageyyy.jpegパフォーマンスを向上させるために、同じディレクトリ構造で検証データセットを準備し、モデルを評価してハイパーパラメータを調整します。
-
上記のディレクトリ構造で、データセットを OSS バケットにアップロードします。 詳細については、「ファイルのアップロード」をご参照ください。
-
-
トレーニングタスクの送信
-
モデルの詳細 ページで トレーニング をクリックします。 設定ページで、訓練データセット、データセットの検証、出力パス を指定します。
モデルギャラリーは、[Computing Resources] と [Hyperparameters] を事前に設定します。 デフォルト設定を使用するか、必要に応じてカスタマイズします。 詳細については、「モデルのデプロイとトレーニング」をご参照ください。
説明デフォルトでは、モデルはファインチューニングに MiniImageNet-100 データセットを使用するため、独自のデータを準備しなくてもトレーニングプロセスをテストできます。
-
トレーニング をクリックします。

ページは タスク詳細 ページにリダイレクトされ、そこで進行状況、ログ、評価結果を監視できます。 トレーニングが完了すると、モデルは指定した 出力パス に保存されます。

-
-
ファインチューニング済みモデルのデプロイ
PAI は、トレーニング済みのモデルを AI Assets - Model Management に自動的に登録し、表示およびデプロイできるようにします。 詳細については、「モデルの登録と管理」をご参照ください。