スコアカードトレーニングは、信用リスクアセスメントのための機械学習メソッドです。ビニングによって元の変数を離散化し、ロジスティック回帰や線形回帰などの線形モデルをトレーニングします。このメソッドには、特徴選択とスコア変換機能が含まれており、トレーニング中に変数に制約を適用して、モデルの解釈可能性とパフォーマンスを向上させることができます。ビニングを行わない場合、スコアカードトレーニングは標準のロジスティック回帰または線形回帰と同じです。
制限事項
Scorecard Training コンポーネントによって生成された一時モデルは、MaxCompute の一時テーブルとしてのみ保存できます。Machine Learning Studio では、これらの一時テーブルのデフォルトのライフサイクルは 369 日です。Machine Learning Designer では、ライフサイクルは現在のワークスペースに構成されている一時テーブルの保持期間によって決まります。この設定の詳細については、「ワークスペースの管理」をご参照ください。一時モデルを長期間使用するには、Write Table コンポーネントを使用して永続化します。手順については、「アルゴリズムコンポーネントのよくある質問」をご参照ください。
基本概念
スコアカードトレーニングには、次の概念が含まれます。
-
特徴量エンジニアリング
スコアカードモデルと標準線形モデルの主な違いは、トレーニング前にデータに適用される特徴量エンジニアリングのプロセスです。Scorecard Training コンポーネントは、2 つの特徴量エンジニアリングメソッドを提供します。
-
Binning コンポーネントを使用して特徴を離散化します。次に、ビニング結果に基づいて各変数に One-Hot エンコーディングを適用し、N 個のダミー変数を生成します。ここで、N は変数のビンの数です。
説明ダミー変数変換を使用する場合、各元の変数のダミー変数間に制約を設定できます。詳細については、「ビニング」をご参照ください。
-
Binning コンポーネントを使用して特徴を離散化し、Weight of Evidence (WOE) 変換を実行します。これにより、変数の元の値が、その変数が分類されるビンの WOE 値に置き換えられます。
-
-
スコア変換
信用スコアリングでは、線形変換によって予測されたサンプルのオッズがスコアに変換されます。この変換では、通常、次の数式が使用されます。
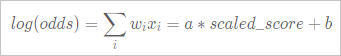 次の 3 つのパラメーターを使用して線形変換を指定できます。
-
scaledValue:ベースラインスコア。
-
odds:指定されたベースラインスコアでのオッズ値。
-
pdo (Points to Double Odds):odds 値を 2 倍にするためにスコアを増加させる必要のあるポイント数。
たとえば、scaledValue=800、odds=50、pdo=25 の場合、線上の 2 つのポイントは次のように定義されます。
log(50)=a×800+b
log(100)=a×825+b
a と b を解くことで、線形変換をモデルのスコアに適用して、最終的な変数スコアを取得できます。
次の例に示すように、
-Dscaleパラメーターを使用して、スケーリング情報を JSON 形式で指定します。{"scaledValue":800,"odds":50,"pdo":25}-Dscaleパラメーターが空でない場合は、scaledValue、odds、および pdo の値を指定する必要があります。 -
-
トレーニング制約
スコアカードトレーニングは、変数への制約の追加をサポートしています。たとえば、特定のビンのスコアを固定値に設定したり、2 つのビンのスコア間に比例関係を強制したり、ビン間のスコアの範囲を制限したり、ビンのスコアを WOE 値に従って順序付けたりすることができます。基礎となる制約付き最適化アルゴリズムがこれらの制約を実装します。Binning コンポーネントで制約を視覚的に構成すると、JSON 形式の条件が生成され、ダウンストリームのトレーニングコンポーネントに自動的に渡されます。スコアカード実験の Binning ノードのパラメーター設定パネルで、[特徴列] (STRING、BIGINT、DOUBLE 型をサポート)、[ラベル列] (値はクラス)、および [正例ラベル] を 1 に設定します。次に、[ビニング用のカスタム JSON ファイル] オプションを選択し、制約ファイル (例:binning.txt) をアップロードします。制約 JSON は、単一行、単一列のテーブルに文字列として格納されます。システムは、次の 6 種類の JSON 制約をサポートしています。
-
"<": 変数の重みが昇順になるように強制します。
-
">": 変数の重みが降順になるように強制します。
-
"=": 変数の重みを固定値に設定します。
-
"%": 変数の重み間に比例関係を強制します。
-
"UP": 変数の重みの上限を設定します。たとえば、値が 0.5 の場合、トレーニングされた重みは 0.5 を超えることはできません。
-
"LO": 変数の重みの下限を設定します。たとえば、値が 0.5 の場合、トレーニングされた重みは 0.5 以上である必要があります。
このテーブルには、STRING 型の単一の列が含まれている必要があります。次のコードは、JSON 文字列のサンプルを示しています。
{ "name": "feature0", "<": [ [0,1,2,3] ], ">": [ [4,5,6] ], "=": [ "3:0","4:0.25" ], "%": [ ["6:1.0","7:1.0"] ] } -
-
組み込みの制約
各元の変数には、指定する必要のない暗黙的な制約があります。母集団全体における単一変数の平均スコアはゼロであるという制約です。この制約により、モデルの切片の scaled_weight は、母集団全体の平均スコアを表します。
-
最適化アルゴリズム
詳細オプションで最適化アルゴリズムを構成できます。システムは、次の 4 つの最適化アルゴリズムをサポートしています。
-
L-BFGS:大規模な特徴データセットをサポートする一次最適化アルゴリズムです。これは制約なしの最適化アルゴリズムであり、指定された制約を自動的に無視します。
-
ニュートン法:高速な収束と高い精度で知られる古典的な二次アルゴリズムです。ただし、二次ヘッセ行列を計算する必要があるため、大規模な特徴には適していません。これも制約なしの最適化アルゴリズムであり、指定された制約を無視します。
-
バリア法:二次最適化アルゴリズムです。制約がない場合、ニュートン法と同じです。その計算性能と精度は SQP に似ています。
-
SQP
SQP は、制約をサポートする二次最適化アルゴリズムです。制約がない場合、ニュートン法と同じです。一般的に、パフォーマンスがバリア法に似ているため、SQP の使用を推奨します。
説明-
L-BFGS とニュートン法は、制約なしの最適化アルゴリズムです。バリア法と SQP は、制約付きの最適化アルゴリズムです。
-
最適化アルゴリズムに詳しくない場合は、最適化アルゴリズムを [自動選択] に設定することを推奨します。システムは、データサイズと制約に基づいて最適なアルゴリズムを自動的に選択します。
-
-
特徴選択
トレーニングコンポーネントは、ステップワイズ特徴選択をサポートしています。このメソッドは、フォワードセレクションとバックワードエリミネーションを組み合わせたものです。フォワードセレクションによって新しい変数がモデルに追加されるたびに、システムはモデルに既にあるすべての変数に対してバックワードエリミネーションステップを実行し、有意性の要件を満たさなくなった変数を削除します。複数の目的関数と特徴変換メソッドをサポートしているため、ステップワイズプロセスは次の選択基準をサポートしています。
-
限界貢献度:すべての目的関数と特徴量エンジニアリングメソッドに適用できます。
変数 X の限界貢献度は、収束時の 2 つのモデルの目的関数の値の差です。モデル A (X を含まない) とモデル B (A のすべての変数に X を加えたもの) です。ダミー変数変換を使用する場合、元の変数 X の限界貢献度は、2 つのモデル間の目的関数の差として定義されます。1 つは X のすべてのダミー変数を含むモデル、もう 1 つは含まないモデルです。したがって、特徴選択に限界貢献度を使用することは、すべての特徴量エンジニアリングメソッドと互換性があります。
このメソッドの利点は、その柔軟性です。特定のモデルタイプに限定されず、目的関数を改善する変数を直接選択します。欠点は、p 値 0.05 が一般的なしきい値である統計的有意性とは異なり、限界貢献度には一般的に受け入れられているしきい値がないことです。新規ユーザーの場合、しきい値は 10E-5 から始めることを推奨します。
-
スコア検定:WOE 変換を伴う、または特徴量エンジニアリングなしのロジスティック回帰のみをサポートします。
フォワードセレクションプロセスでは、まず切片のみのモデルがトレーニングされます。後続の各ステップで、まだモデルに含まれていない各変数のスコアカイ二乗統計量を計算します。スコアカイ二乗が最大の変数がモデルに追加されます。次に、この統計量に対応する p 値をカイ二乗分布に基づいて計算します。最良の変数の p 値が指定された参入しきい値 (slentry) よりも大きい場合、変数は追加されず、選択プロセスは停止します。
フォワードセレクションのラウンドの後、モデルに既にある変数に対してバックワードエリミネーションのラウンドが実行されます。バックワードエリミネーション中、プロセスはモデル内の各変数の Wald カイ二乗統計量とそれに対応する p 値を計算します。変数の p 値が指定された除去しきい値 (slstay) を超える場合、その変数はモデルから削除され、プロセスは次の反復に進みます。
-
F 検定:WOE 変換を伴う、または特徴量エンジニアリングなしの線形回帰のみをサポートします。
フォワードセレクションプロセスでは、まず切片のみのモデルがトレーニングされます。後続の各ステップで、まだモデルに含まれていない各変数の F 値が計算されます。F 値の計算は、2 つのモデルをトレーニングする必要があるため、限界貢献度の計算に似ています。F 値は F 分布に従い、対応する p 値はその確率密度関数から導出できます。変数の p 値が指定された参入しきい値 (slentry) を超える場合、その変数はモデルに追加されず、選択プロセスは停止します。
バックワードエリミネーションプロセスも、スコア検定と同様に、F 値を使用して有意性を計算します。
-
-
強制投入変数
特徴選択が始まる前に、特定の変数をモデルに強制的に投入できます。これらの変数は、フォワードセレクションおよびバックワードエリミネーションプロセスから除外され、その有意性に関係なく最終モデルに含まれます。コマンドラインで -Dselected パラメーターを使用して、反復回数と有意性のしきい値を JSON 形式で指定できます。次のコードは例です。
{"max_step":2, "slentry": 0.0001, "slstay": 0.0001}-Dselected パラメーターが空であるか、max_step が 0 の場合、トレーニングプロセスは特徴選択なしで進行します。
コンポーネントの構成
Scorecard Training コンポーネントは、Machine Learning Designer のビジュアルインターフェイスを使用するか 、PAI コマンドを実行して構成できます。次のコードは、PAI コマンドの例を示しています。
pai -name=linear_model -project=algo_public
    -DinputTableName=input_data_table
    -DinputBinTableName=input_bin_table
    -DinputConstraintTableName=input_constraint_table
    -DoutputTableName=output_model_table
    -DlabelColName=label
    -DfeatureColNames=feaname1,feaname2
    -Doptimization=barrier_method
    -Dloss=logistic_regression
-Dlifecycle=8|
パラメーター |
必須 |
デフォルト |
説明 |
|
inputTableName |
はい |
N/A |
入力特徴データテーブル。 |
|
inputTablePartitions |
いいえ |
テーブル全体 |
入力特徴テーブルから選択されたパーティション。 |
|
inputBinTableName |
いいえ |
N/A |
入力ビニング結果テーブル。このテーブルが指定されている場合、システムはトレーニングの前に、このテーブルのビニングルールに基づいて元の特徴を離散化します。 |
|
featureColNames |
いいえ |
ラベル列を除くすべての列が選択されます。 |
入力テーブルから使用する特徴列。 |
|
labelColName |
はい |
N/A |
ラベル列。 |
|
outputTableName |
はい |
N/A |
出力モデルテーブル。 |
|
inputConstraintTableName |
いいえ |
N/A |
単一のセルに格納された JSON 形式の制約を含む入力テーブル。 |
|
optimization |
いいえ |
auto |
最適化アルゴリズム。有効な値:
sqp と barrier_method のみが制約をサポートします。auto は、データとパラメーターに基づいて最適な最適化アルゴリズムを自動的に選択します。最適化アルゴリズムに詳しくない場合は、auto を使用することを推奨します。 |
|
loss |
いいえ |
logistic_regression |
損失関数のタイプ。有効な値は logistic_regression と least_square です。 |
|
iterations |
いいえ |
100 |
最適化の最大反復回数。 |
|
l1Weight |
いいえ |
0 |
L1 正則化の重み。このパラメーターは、lbfgs 最適化アルゴリズムでのみ有効です。 |
|
l2Weight |
いいえ |
0 |
L2 正則化の重み。 |
|
m |
いいえ |
10 |
lbfgs 最適化プロセスの履歴の長さ。これは lbfgs 最適化アルゴリズムにのみ適用されます。 |
|
scale |
いいえ |
空 |
スコアカードの重みをスケーリングするために使用される情報。 |
|
selected |
いいえ |
空 |
スコアカードの特徴選択設定。 |
|
convergenceTolerance |
いいえ |
1e-6 |
収束許容度。 |
|
positiveLabel |
いいえ |
1 |
正例のラベル。 |
|
lifecycle |
いいえ |
N/A |
出力テーブルのライフサイクル。 |
|
coreNum |
いいえ |
システムによって決定 |
コア数。 |
|
memSizePerCore |
いいえ |
システムによって決定 |
コアあたりのメモリサイズ (MB)。 |
コンポーネントの出力
Scorecard Training コンポーネントは、ビニング情報、ビン制約、および WOE や限界貢献度などの主要な統計情報を含むモデルレポートを出力します。次の表に、PAI Web コンソールに表示されるモデル評価レポートの列を示します。
|
列 |
タイプ |
説明 |
|
feaname |
STRING |
特徴名。 |
|
binid |
BIGINT |
ビン ID。 |
|
bin |
STRING |
ビンの説明。ビンの値の範囲を示します。 |
|
constraint |
STRING |
トレーニング中にこのビンに適用された制約。 |
|
weight |
DOUBLE |
トレーニング後のビニングされた変数の重み。ビニング入力が指定されていない非スコアカードモデルの場合、これはモデル変数の重みです。 |
|
scaled_weight |
DOUBLE |
モデルトレーニング中にビニングされた変数の重みに指定されたスコア変換を適用した結果のスコア値。 |
|
woe |
DOUBLE |
トレーニングセットにおけるこのビンの WOE 値。 |
|
contribution |
DOUBLE |
トレーニングセットにおけるこのビンの限界貢献度。 |
|
total |
BIGINT |
トレーニングセットにおけるこのビンのサンプル総数。 |
|
positive |
BIGINT |
トレーニングセットにおけるこのビンの正例の数。 |
|
negative |
BIGINT |
トレーニングセットにおけるこのビンの負のサンプルの数。 |
|
percentage_pos |
DOUBLE |
このビンの正例の数とトレーニングセットの正例の総数との比率。 |
|
percentage_neg |
DOUBLE |
このビンの負のサンプルの数とトレーニングセットの負のサンプルの総数との比率。 |
|
test_woe |
DOUBLE |
テストセットにおけるこのビンの WOE 値。 |
|
test_contribution |
DOUBLE |
テストセットにおけるこのビンの限界貢献度。 |
|
test_total |
BIGINT |
テストセットにおけるこのビンのサンプル総数。 |
|
test_positive |
BIGINT |
テストセットにおけるこのビンの正例の数。 |
|
test_negative |
BIGINT |
テストセットにおけるこのビンの負のサンプルの数。 |
|
test_percentage_pos |
DOUBLE |
このビンの正例の数とテストセットの正例の総数との比率。 |
|
test_percentage_neg |
DOUBLE |
このビンの負のサンプルの数とテストセットの負のサンプルの総数との比率。 |