姿勢検出コンポーネントは、HRNet または Lite-HRNet バックボーンを使用して、トップダウンの姿勢推定モデルをトレーニングします。ビジュアルモデリングのパイプラインでこのコンポーネントを使用して、画像から人体のキーポイントを検出します。
前提条件
開始する前に、以下をご確認ください。
Object Storage Service (OSS) バケットが有効化されていること
Machine Learning Platform for AI (PAI) に OSS へのアクセスが許可されていること。詳細については、「OSS の有効化」および「ビジュアルモデリングの使用に必要な権限の付与」をご参照ください。
制限事項
このコンポーネントは、Machine Learning Platform for AI (PAI) のビジュアルモデリングでのみ利用できます。
Deep Learning Containers (DLC) のコンピューティングリソースが必要です。
サポートされているアルゴリズムは トップダウン のみです。トップダウンでは、まずオブジェクト検出器で人物を検出し、次に検出された各人物のキーポイントを推定します。このアプローチはより正確ですが、画像内の人数が増えるにつれて速度が低下するため、人数が少なく固定されたシーンに最適です。人体の検出は姿勢検出の前に行う必要があるため、上流に オブジェクト検出 コンポーネントを接続するか、画像予測 コンポーネントで検出モデルのパスを手動で設定する必要があります。
仕組み
コンポーネントライブラリの [ビデオアルゴリズム] > [オフライン トレーニング] 配下でコンポーネントを検索します。
このコンポーネントは、5 つの入力ポートを介してトレーニングデータ、アノテーションファイル、評価データ、およびデータセット情報ファイルを受け取ります。トップダウンの姿勢モデルをトレーニングし、トレーニング済みのモデルを OSS ディレクトリに出力します。後続の 画像予測 コンポーネントは、このディレクトリをオフライン推論に使用します。
コンポーネントの設定
入力ポート
各ポートに ファイルデータの読み込み コンポーネントを接続します。すべてのポートはオプションです。ポートを未接続のままにする場合は、代わりに対応する OSS パスのパラメーターを設定します。
| ポート (左から右) | データ型 | 必須 |
|---|---|---|
| トレーニングデータ | OSS | いいえ |
| トレーニングデータのアノテーションファイルパス | OSS | いいえ |
| 評価データ | OSS | いいえ |
| 評価データのアノテーションファイルパス | OSS | いいえ |
| キーポイント情報ファイルパス | OSS | いいえ |
入力ポートとそれに対応するパラメーターの両方が設定されている場合、入力ポートの値が優先されます。
フィールド設定
| パラメーター | 必須 | デフォルト | 説明 |
|---|---|---|---|
| [model type] | はい | TopDown | [TopDown]アルゴリズムのタイプ。 のみサポートされます。 |
| [oss dir to save model] | いいえ | None | トレーニング済みモデルを保存する OSS ディレクトリ。例: oss://examplebucket/output_dir/ckpt/ |
| [oss data path to training] | いいえ | None | トレーニング画像への OSS パス。トレーニングデータの入力ポートが接続されていない場合に必須です。例: oss://examplebucket/data/train_images/ |
| [oss annotation path for training data] | いいえ | None | トレーニングデータのアノテーションファイルへの OSS パス。トレーニングデータのアノテーション用ポートが接続されていない場合に必須です。例: oss://examplebucket/data/annotations/train.json |
| [oss data path to evaluation] | いいえ | None | 評価画像への OSS パス。評価データの入力ポートが接続されていない場合に必須です。例: oss://examplebucket/data/val_images/ |
| [oss annotation path for evaluation data] | いいえ | None | 評価データのアノテーションファイルへの OSS パス。評価データのアノテーション用ポートが接続されていない場合に必須です。例: oss://examplebucket/data/annotations/val.json |
| [oss path to dataset info file] | いいえ | None | データセット情報ファイルへの OSS パス。データセット情報用のポートが接続されていない場合に必須です。例: oss://examplebucket/data/annotations/dataset_info.py |
| [Data Source Type] | はい | DetSourceCOCO | 入力データの形式。 DetSourceCOCO のみサポートされます。 |
| [oss path to pretrained model] | いいえ | None | カスタムの事前学習済みモデルへの OSS パス。空欄の場合、PAI はデフォルトの事前学習済みモデルを使用します。 |
パラメーター設定
| パラメーター | 必須 | デフォルト | 説明 |
|---|---|---|---|
| [backbone] | はい | hrnet | バックボーンモデル。有効な値: hrnet、lite_hrnet。 |
| [num keypoints] | はい | None | データセットのキーポイントカテゴリ数。 |
| [image size after resizing] | はい | 192,256 | リサイズ後の固定入力画像サイズ (幅、高さ)。値はカンマで区切ります。 |
| [initial learning rate] | はい | 0.01 | トレーニングの初期学習率。 |
| [learning rate policy] | はい | step | 学習率のスケジュール。 step のみサポートされています。学習率は、lr step で指定されたエポックで減衰します。 |
| [lr step] | はい | 170,200 | 学習率が 90% 減衰するエポック。複数の値はカンマで区切ります。たとえば、初期学習率が 0.1 で lr step が 5,10 に設定されている場合、エポック 1〜5 では 0.1、エポック 6 からは 0.01、エポック 11 からは 0.001 が使用されます。 |
| [train batch size] | はい | 32 | トレーニングのイテレーションあたりのサンプル数。 |
| [eval batch size] | はい | 32 | 評価のイテレーションあたりのサンプル数。 |
| [total train epochs] | はい | 200 | トレーニングデータを走査する総パス数。 |
| [save checkpoint epoch] | いいえ | 1 | チェックポイントを保存する頻度 (エポック単位)。 1 は、エポックごとにチェックポイントを保存することを意味します。 |
チューニング
| パラメーター | 必須 | デフォルト | 説明 |
|---|---|---|---|
| [optimizer] | はい | SGD | モデルトレーニングのオプティマイザ。有効な値: SGD、Adam。 |
| [number process of reading data per gpu] | いいえ | 2 | GPU あたりのデータ読み込みスレッド数。 |
| [evtorch model with fp16] | いいえ | None | FP16 混合精度を有効にして、GPU メモリの使用量を削減します。 |
| [single worker or distributed on DLC] | はい | single_on_dlc | 計算モード。有効な値: single_on_dlc、distribute_on_dlc。 |
| [number of worker] | いいえ | 1 | ワーカーノード数。 distribute_on_dlc を選択した場合に必須です。 |
| [cpu machine type] | いいえ | 16vCPU+64GB Mem-ecs.g6.4xlarge | [distribute_on_dlc]CPU インスタンスタイプ。 を選択した場合に必須です。 |
| [gpu machine type] | はい | 8vCPU+60GB Mem+1xp100-ecs.gn5-c8g1.2xlarge | GPU インスタンスタイプ。 |
出力ポート
| ポート | データ型 | 後続コンポーネント |
|---|---|---|
| 出力モデル | OSS ディレクトリ (oss dir to save model と同じ) | 画像予測 |
姿勢検出パイプラインの構築
以下の手順では、完全なトレーニングと推論のパイプラインについて説明します。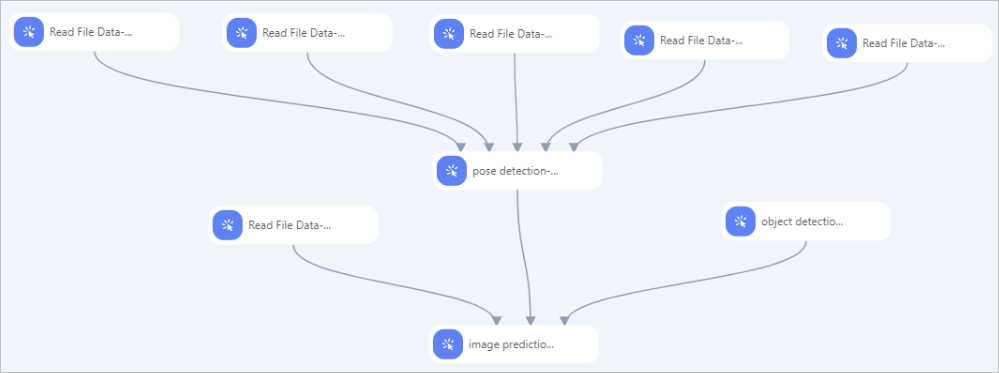
データのラベリング: iTAG を使用して画像にアノテーションを行います。詳細については、「iTAGiTAG」をご参照ください。
データのロード 5 つの [ファイルデータの読み込み] コンポーネント (Read File Data-1 から Read File Data-5) を追加します。各コンポーネントの [OSS データパス] パラメーターを、トレーニング画像、トレーニングアノテーション、評価画像、評価アノテーション、データセット情報ファイルの順に、対応するパスに設定します。
接続と設定: 5 つの ファイルデータの読み込み コンポーネントすべてを 姿勢検出 コンポーネントに接続します。「コンポーネントの設定」セクションの説明に従ってパラメーターを設定します。
推論の追加: 姿勢検出 コンポーネントの出力を 画像予測 コンポーネントに接続します。 画像予測 コンポーネントで次のパラメーターを設定します。
パラメーター 値 [model type] pose_predictor[oss path for model] 姿勢検出 コンポーネントの [oss dir to save model] で設定したパスと同じパス [oss path of detection model for pose] オブジェクト検出モデルへの OSS パス。上流に オブジェクト検出 コンポーネントがすでに接続されている場合を除き、必須です。その場合、検出モデルは自動的に継承されます。 [detection model type for pose] yolox_predictor(必須)