モデル圧縮は、量子化などの技術を使用して、予測パフォーマンスを維持しながらモデルサイズと計算量を削減します。GPU メモリが限られている場合や、デプロイコストを削減する場合に有効です。
概要
PAI-モデルギャラリーは、重みのみの量子化テクノロジーに基づくモデル量子化をサポートしています。MinMax-8Bit または MinMax-4Bit 戦略を使用して、浮動小数点パラメーターを 8 ビットまたは 4 ビットの整数表現に量子化します。これにより、優れたパフォーマンスを維持しながら、モデルサイズと GPU メモリ使用量を削減できます。
モデルの圧縮
-
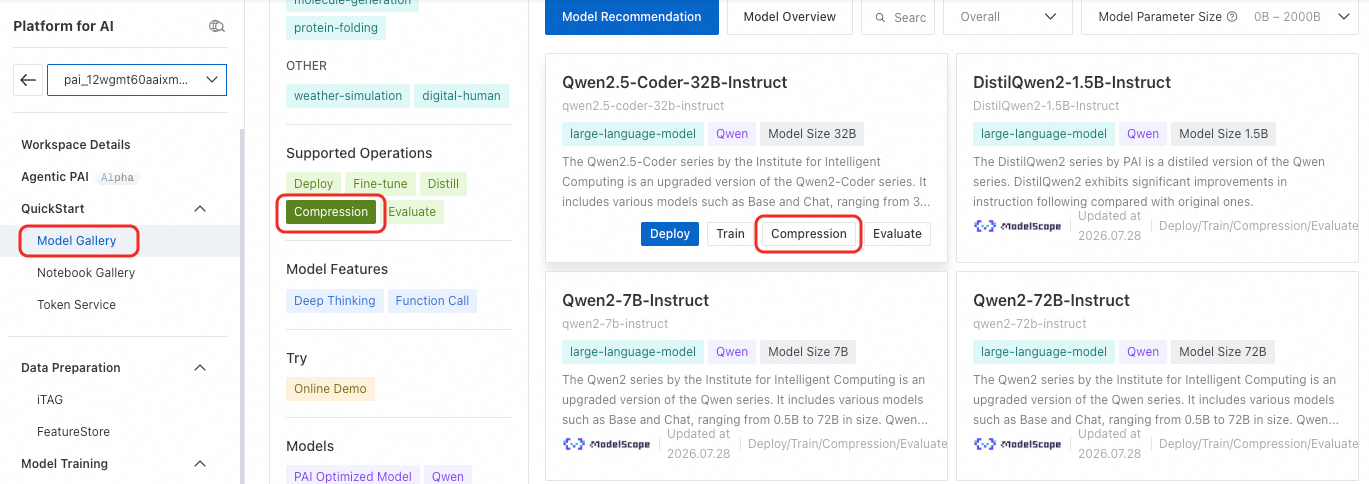
圧縮可能なモデルをフィルタリングします。[モデルギャラリー] ページで、左側の [サポートされる操作] フィルターから [Compression] を選択すると、圧縮可能なモデルのみが表示されます。
-
対象のモデルカードで [Compression] をクリックして、圧縮タスクを設定します。主要なパラメーターについては、以下をご参照ください。その他のパラメーターは、必要に応じて設定してください。
パラメーター
説明
圧縮方法
現在、重みのみの量子化テクノロジーに基づく モデル量子化 方法のみがサポートされています。この方法は、モデルの重みパラメーターをより低いビット幅に変換し、推論時の GPU メモリ使用量を削減します。
圧縮戦略
-
MinMax-8Bit:Min-Max スケーリング法を使用して、モデルを 8 ビットの整数表現に量子化します。
-
MinMax-4Bit:Min-Max スケーリング法を使用して、モデルを 4 ビットの整数表現に量子化します。
-
-
設定完了後、圧縮 をクリックします。ページが タスク詳細 ページにリダイレクトされ、圧縮ジョブの基本情報、リアルタイムステータス、およびジョブログを表示できます。
圧縮ジョブは、PAI-Model Gallery > タスク管理 > 圧縮タスク でも利用可能です。
モデルのデプロイ
圧縮ジョブが成功すると、モデル詳細ページの右上隅にあるデプロイメントをクリックして、圧縮されたモデルをデプロイします。 サービスの呼び出しについては、「共有ゲートウェイ (パブリック/VPC) 経由でサービスを呼び出す」をご参照ください。
モデルの評価
モデルのデプロイ後、圧縮の効果を確認するために評価を実施します。詳細については、「モデル評価 (ModelEval)」をご参照ください。