LangStudio のナレッジベースは、OSS ドキュメントを検索拡張生成 (RAG) 用のベクターインデックスに変換します。一度作成すれば、複数のアプリケーションフローで再利用できます。
仕組み
ナレッジベースは、次の 3 つの手順で、OSS のファイルを LLM で検索可能なコンテンツに変換します:
-
データの読み取りとチャンキング:OSS からソースファイルを読み取り、処理可能な単位に分割します。
-
非構造化ドキュメントを解析し、意味的に完結した小さなテキストブロック (チャンク) に分割します。
-
構造化データは行単位でチャンキングします。
-
画像はチャンキングせず、全体を 1 つの単位として処理します。
-
-
ベクトル化:埋め込みモデルを呼び出し、各チャンクまたは画像をその意味を表す数値ベクトルに変換します。
-
保存とインデックス作成:ベクトルデータをベクトルデータベースに保存し、検索用のインデックスを作成します。
クイックスタート
ドキュメントタイプのナレッジベースを作成し、アプリケーションフローで使用します。
-
ナレッジベースの作成。 LangStudio に移動し、ワークスペースを選択します。 ナレッジベース タブで、ナレッジベースの作成 をクリックします。 これらのパラメーターを設定し、[OK] をクリックします。
パラメータ
説明
[基本設定]
[ナレッジベース名]
ナレッジベースのカスタム名を入力します。例:
test_kg[データソース OSS パス]
ソースファイルが保存されている場所を指定します。例:
oss://examplebucket.oss-cn-hangzhou-internal.aliyuncs.com/test/original/[出力 OSS パス]
中間的な解析結果とインデックスデータを保存します。最終的な出力は、選択したベクトルデータベースタイプによって異なります。例:
oss://examplebucket.oss-cn-hangzhou-internal.aliyuncs.com/test/output/重要ランタイムの [インスタンス RAM ロール] が PAI デフォルトロールである場合は、このパラメーターを、現在のワークスペースのデフォルトストレージパス の OSS バケット内のディレクトリに設定してください。
[データ型]
[ドキュメント] を選択します。
[埋め込みモデルとデータベース]
[Embedding タイプ]
Model Studio 大規模言語モデル (LLM) サービス接続 を選択し(まず接続を作成します。作成方法については、「接続設定」をご参照ください)、次に接続とモデルを選択します。
[ベクトルデータベースタイプ]
クイックテスト用に [FAISS] を選択します。
-
ファイルをアップロードします。
-
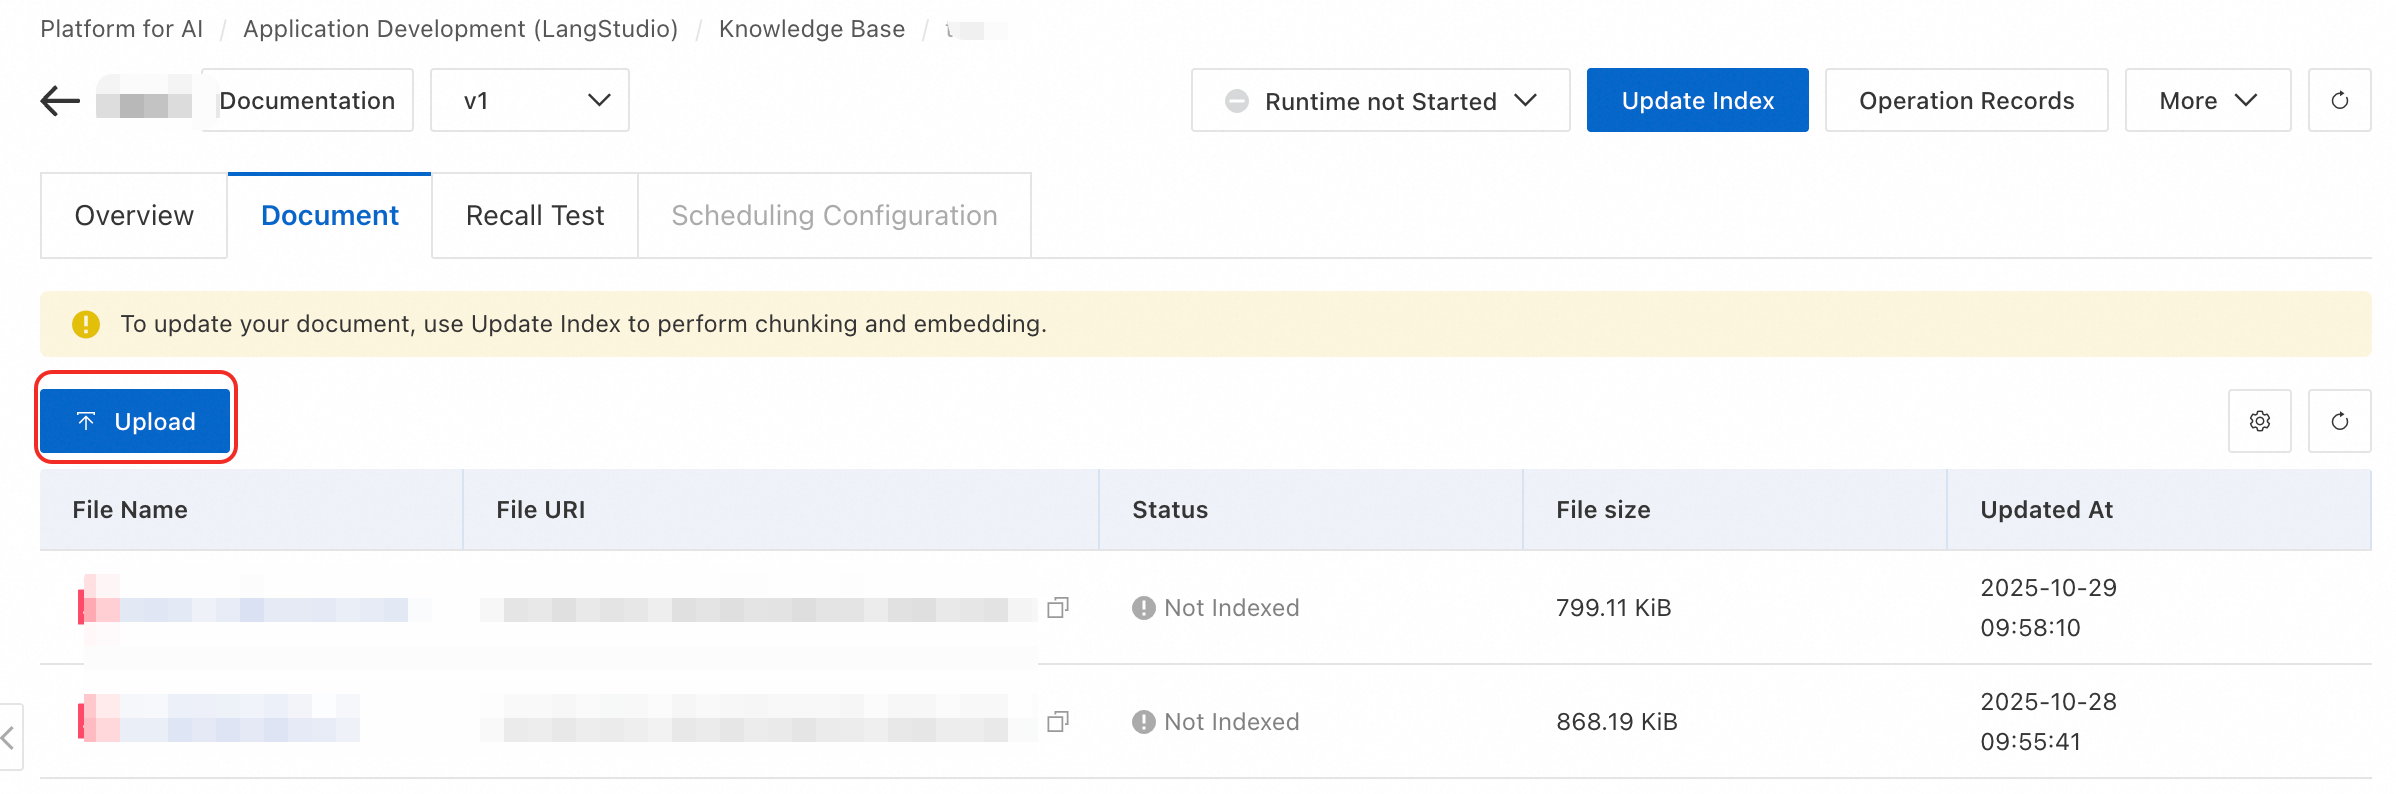
ナレッジベース タブで、ナレッジベースをクリックします。概要 ページで、[ドキュメント] タブに切り替えます。このタブには、設定された OSS データソースのドキュメントが表示されます。
-
アップロード ボタンを使用してファイルを追加または更新するか、OSS データソースにファイルを直接アップロードします。 たとえば、ページから rag_test_doc.txt をアップロードします。 サポートされているファイル形式については、「ナレッジベースのタイプ」をご参照ください。
-
-
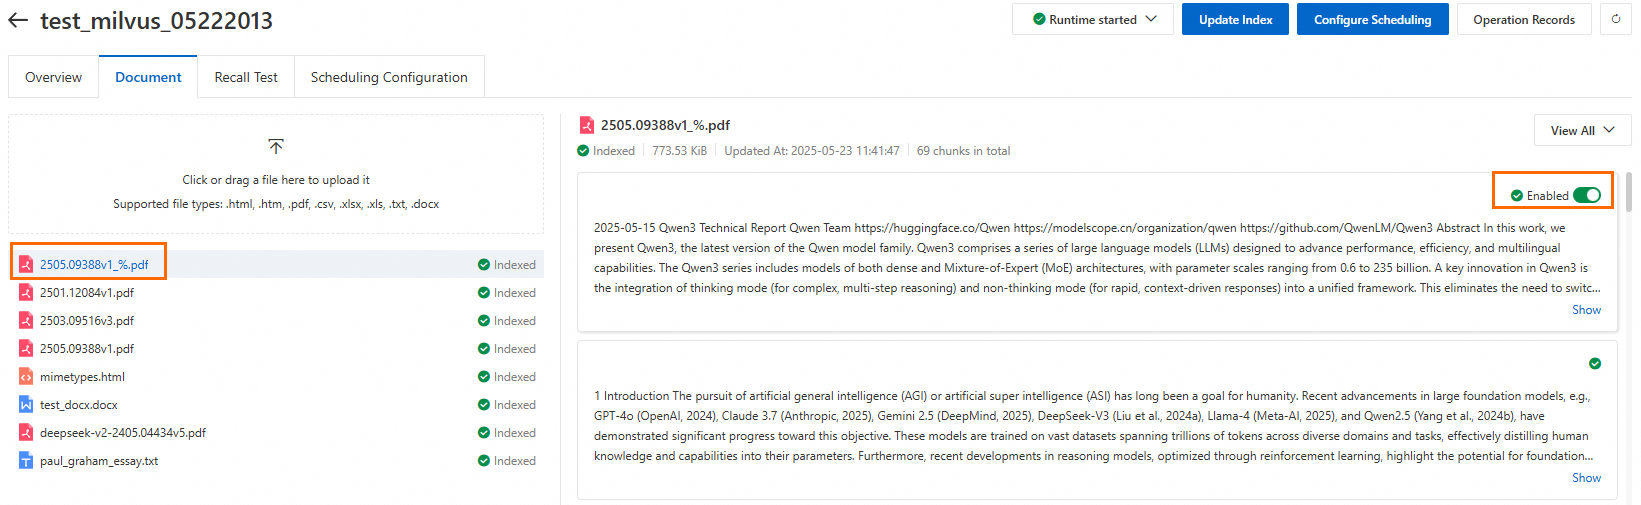
インデックスの更新。ファイルをアップロードした後、右上隅にあるインデックスの更新をクリックします。ダイアログボックスで、コンピューティングリソースとネットワークを設定します。タスクが成功すると、ファイルステータスがインデックス済みに変わります。ファイルをクリックすると、そのチャンクをプレビューできます。画像ナレッジベースの場合、システムは画像リストを返します。
説明Milvus に保存されているドキュメントチャンクについては、それぞれのステータスを [Enabled] または [Disabled] に設定できます。無効化されたチャンクは、検索時に取得されません。
-
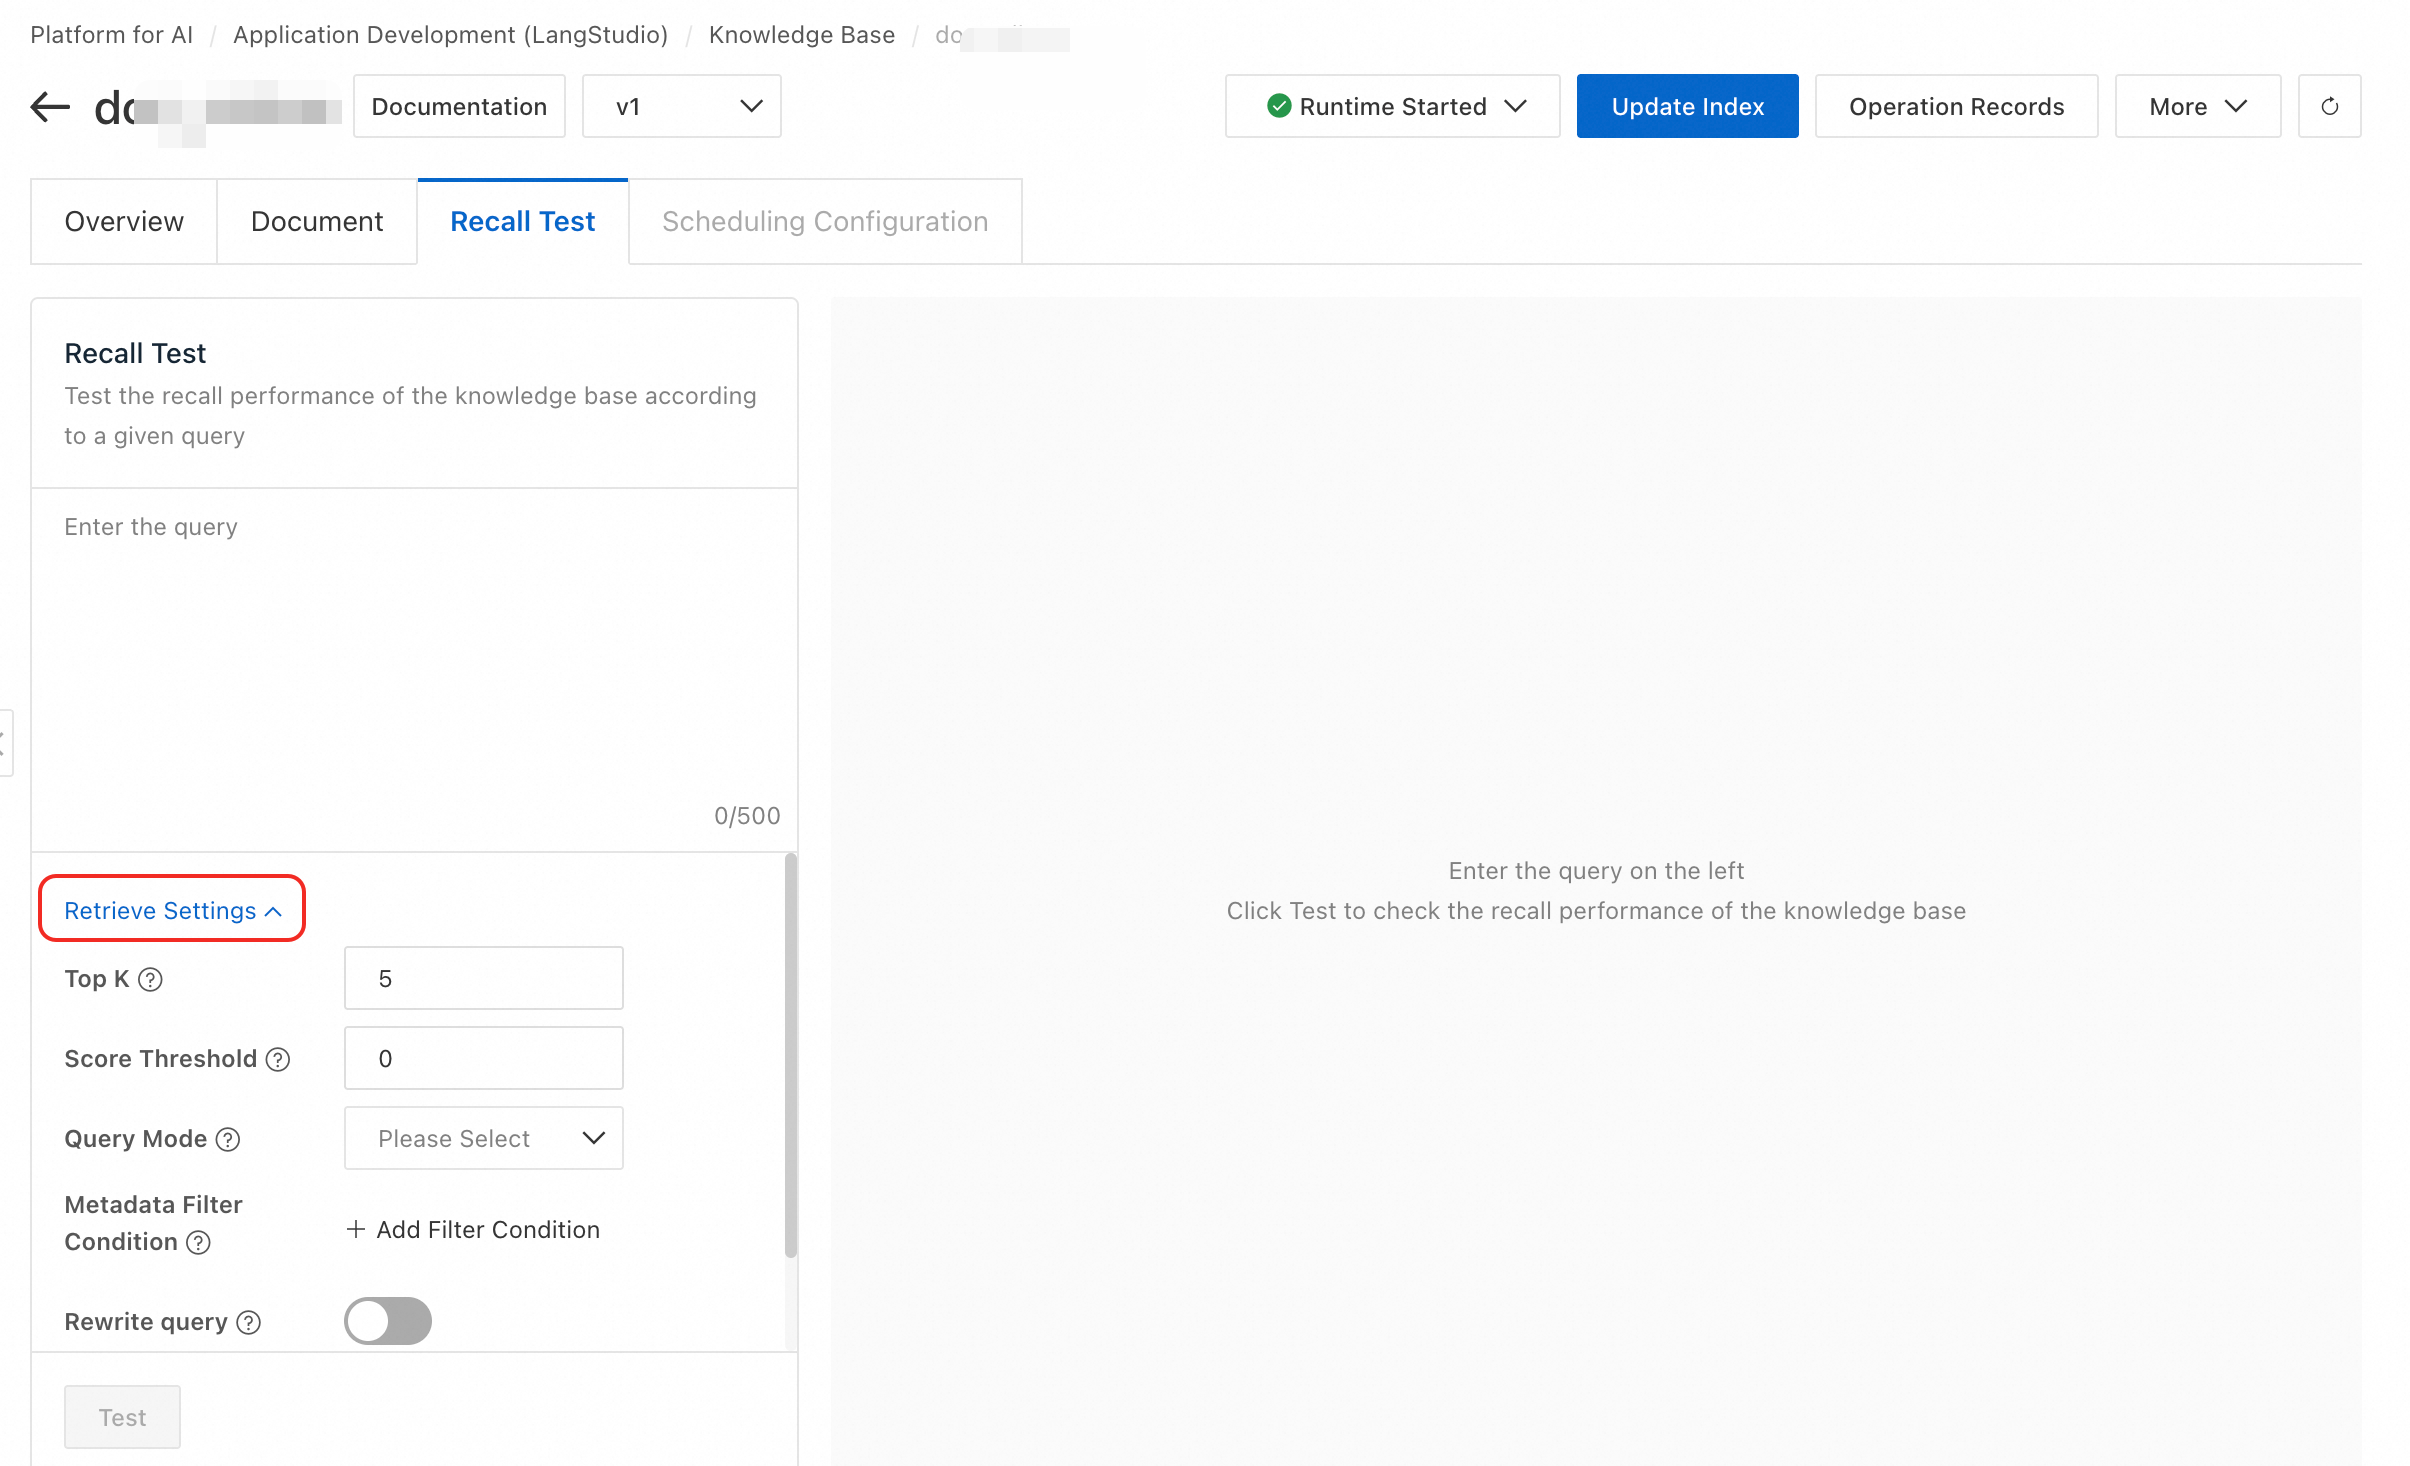
検索テストの実行。インデックスを更新した後、リコールテスト タブに切り替えます。クエリを入力し、検索パラメーターを調整してパフォーマンスをテストします。
-
アプリケーションフローでナレッジベースを使用します。テスト後、アプリケーションフローでナレッジベースから情報を検索します。ナレッジベースノードで、クエリ書き換えと結果の再ランキング機能を有効にし、実行トレースで書き換えられたクエリを確認します。

結果は
List[Dict]です。各Dictにはcontentとscoreのキーがあり、それぞれ取得されたチャンクとクエリとの類似度スコアを表します。[ { "score": 0.8057173490524292, "content": "Due to the uncertainty caused by the pandemic, XX Bank proactively increased provisions for impairment losses on loans, advances, and non-credit assets based on economic trends and forecasts for China or the Chinese mainland. The bank also increased the write-off and disposal of non-performing assets to improve the provision coverage ratio. In 2020, the net profit reached 28.928 billion CNY, a year-on-year increase of 2.6%, and profitability gradually improved.\n(CNY in millions) 2020 2019 Change (%)\nOperating Results and Profitability\nOperating Income 153,542 137,958 11.3\nOperating Profit Before Impairment Losses 107,327 95,816 12.0\nNet Profit 28,928 28,195 2.6\nCost-to-Income Ratio(1)(%) 29.11 29.61 down 0.50 percentage points\nAverage Return on Total Assets (%) 0.69 0.77 down 0.08 percentage points\nWeighted Average Return on Equity (%) 9.58 11.30 down 1.72 percentage points\nNet Interest Margin(2)(%) 2.53 2.62 down 0.09 percentage points\nNote: (1) Cost-to-Income Ratio = Business and management fees / Operating income.", "id": "49f04c4cb1d48cbad130647bd0d75f***1cf07c4aeb7a5d9a1f3bda950a6b86e", "metadata": { "page_label": "40", "file_name": "2021-02-04_XX_Insurance_Group_Co_Ltd_XX_China_XX_2020_Annual_Report.pdf", "file_path": "oss://my-bucket-name/datasets/chatglm-fintech/2021-02-04__XX_Insurance_Group_Co_Ltd__601318__China_XX__2020_Annual_Report.pdf", "file_type": "application/pdf", "file_size": 7982999, "creation_date": "2024-10-10", "last_modified_date": "2024-10-10" } }, { "score": 0.7708036303520203, "content": "7.2 billion CNY, a year-on-year increase of 5.2%.\n2020\n(CNY in millions) Life and Health Insurance Business, Property and Casualty Insurance Business, Banking Business, Trust Business, Securities Business, Other Asset Management Business, Technology Business, Other Business and Consolidation Elimination, Group Consolidated\nNet profit attributable to shareholders of the parent company 95,018 16,083 16,766 2,476 2,959 5,737 7,936 (3,876) 143,099\nMinority interest 1,054 76 12,162 3 143 974 1,567 281 16,260\nNet profit (A) 96,072 16,159 28,928 2,479 3,102 6,711 9,503 (3,595) 159,359\nItems excluded:\n Short-term investment fluctuation(1)(B) 10,308 – – – – – – – 10,308\n Impact of discount rate change (C) (7,902) – – – – – – – (7,902)\n One-time significant items and others excluded by management as not part of daily operating income and expenditure (D) – – – – – – 1,282 – 1,282\nOperating profit (E=A-B-C-D) 93,666 16,159 28,928 2,479 3,102 6,711 8,221 (3,595) 155,670\nOperating profit attributable to shareholders of the parent company 92,672 16,", "id": "8066c16048bd722d030a85ee8b1***36d5f31624b28f1c0c15943855c5ae5c9f", "metadata": { "page_label": "19", "file_name": "2021-02-04_XX_Insurance_Group_Co_Ltd_XXX_China_XX_2020_Annual_Report.pdf", "file_path": "oss://my-bucket-name/datasets/chatglm-fintech/2021-02-04__XX_Insurance_Group_Co_Ltd__601318__China_XX__2020_Annual_Report.pdf", "file_type": "application/pdf", "file_size": 7982999, "creation_date": "2024-10-10", "last_modified_date": "2024-10-10" } } ]
機能
ナレッジベースのタイプ
ファイルに合わせてナレッジベースのタイプを選択します:
-
ドキュメント:
.html、.htm、.pdf、.txt、.docx、.md、.pptxをサポートしています。 -
構造化データ:
.jsonl、.csv、.xlsx、.xlsをサポートしています。 -
画像:
.jpg、.jpeg、.png、.bmpをサポートしています。
特別な設定:
-
ドキュメントタイプのナレッジベースの場合は、[ドキュメント解析のチャンキング設定] を設定します。 これらのフィールドは必須です。 チャンキングパラメーターの設定に関するガイダンスについては、「チャンキングパラメーターのチューニング」をご参照ください。
-
[テキストチャンクサイズ]: テキストチャンクあたりの最大文字数。 デフォルト値は 1024文字です。
-
[テキストチャンクの重複サイズ]: 文脈の連続性を確保するための、隣接するチャンク間の重複文字数。 デフォルト値は 200文字です。
-
-
構造化データタイプのナレッジベースの場合は、[構造化データフィールド設定] を設定します。 ファイル (例えば animal.csv) をアップロードするか、手動でフィールドを追加して、どのデータフィールドをインデックス作成と検索に使用するかを指定します。
ベクトルデータベースの選択
-
本番環境: 大規模なベクトルデータ処理をサポートする Milvus または Elasticsearch を使用します。
-
テスト環境: 追加のデータベースを必要としない FAISS を使用します。 ナレッジベースファイルと生成されたインデックスファイルは、[出力 OSS パス] に保存されます。 FAISS は、機能テストや小規模なデータセットには適していますが、データ量が大きいとパフォーマンスが低下する可能性があります。
説明画像タイプのナレッジベースは FAISS をサポートしていません。
インデックスの更新戦略
|
更新方法 |
説明 |
注意事項 |
|
手動更新 |
コンソールで インデックスの更新 をクリックします。 ファイルの変更頻度が低い場合に最適です。 |
ファイルを完全または増分的に処理します。 |
|
自動更新 |
OSS ファイルが変更されたときにインデックス作成をトリガーする EventBridge ルールを作成します。 |
重要
自動更新中にメッセージ料金が発生します。
|
|
定期更新 |
DataWorks の定期タスクを使用して、スケジュール (たとえば、毎日) に従ってインデックスを更新します。 |
DataWorks に依存します。 定期タスクは T+1 ベース (今日行われた設定は明日実行されます) で有効になります。 |
設定方法:
手動更新
インデックスの更新 をクリックします。 システムは PAI ワークフロータスクを送信して、ファイルのプリプロセス、チャンク化、ベクトル化、およびインデックス作成を行います。 タスクパラメーター:
|
パラメーター |
説明 |
|
コンピューティングリソース |
ワークフローノードのコンピューティングリソース。 パブリックリソースを使用するか、リソースクォータを通じて Lingjun リソース と汎用コンピューティングリソースを使用します。
|
|
VPC 設定 |
内部ネットワーク経由でベクトルデータベースまたはエンベディングサービスにアクセスする場合、選択した VPC がそれらのサービスの VPC と同じであるか、通信できることを確認してください。 |
|
エンベディング設定 |
|
自動更新
-
EventBridge コンソール に移動し、EventBridge を有効化します。
-
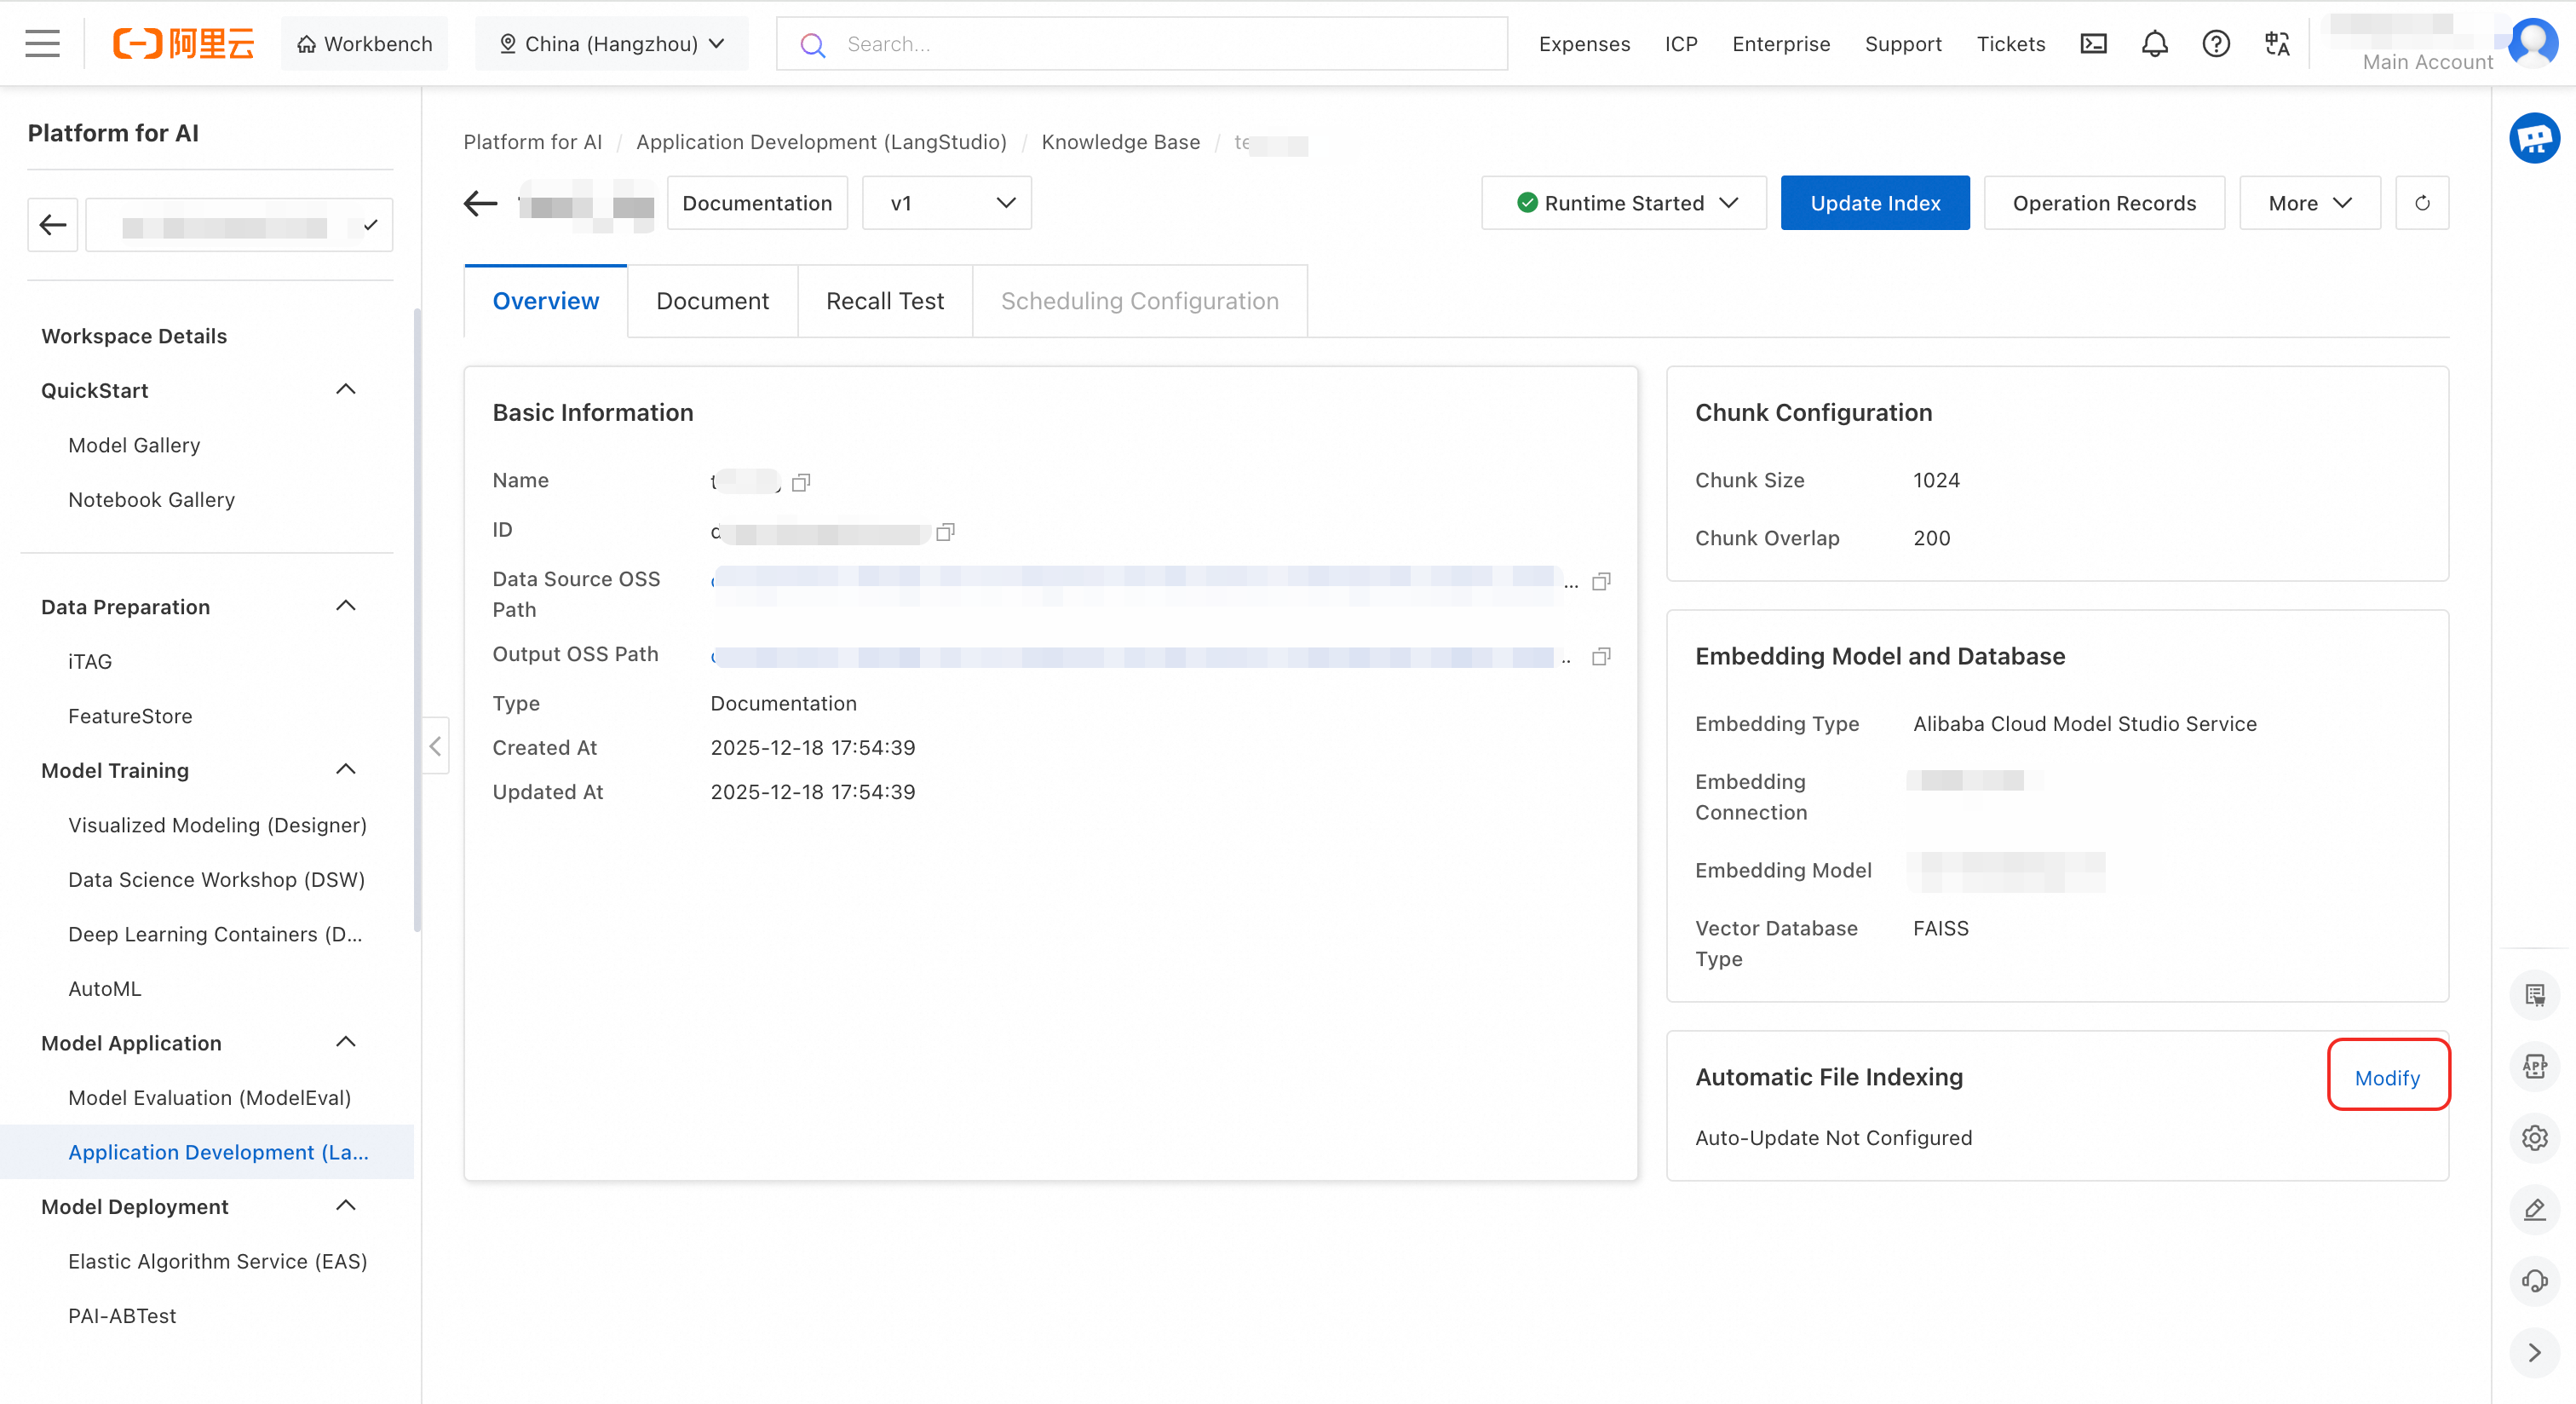
自動インデックス更新を設定します。 ナレッジベースの詳細ページに移動します。 概要 タブの右下隅にある ファイルインデックスの自動更新 セクションで、[Modify] をクリックします。
-
コンピューティングリソースと VPC を設定し、[OK] をクリックします。 この後、ファイルの変更により、手動での操作なしにインデックス作成タスクが自動的にトリガーされます。
重要ここで設定したコンピューティングリソースは、ファイルが更新された場合にのみ使用されます。 ファイルが変更されない場合、リソース料金は発生しません。
-
OSS ファイルに変更を加えます。
-
自動ファイル更新を設定した後、ルールが有効になるまで数分の遅延があります。 ファイルに対する操作を行う前に、少なくとも 3 分間待ってください。
-
OSS API を使用してファイルを削除するには、バージョンを指定して変更イベントをトリガーします。
-
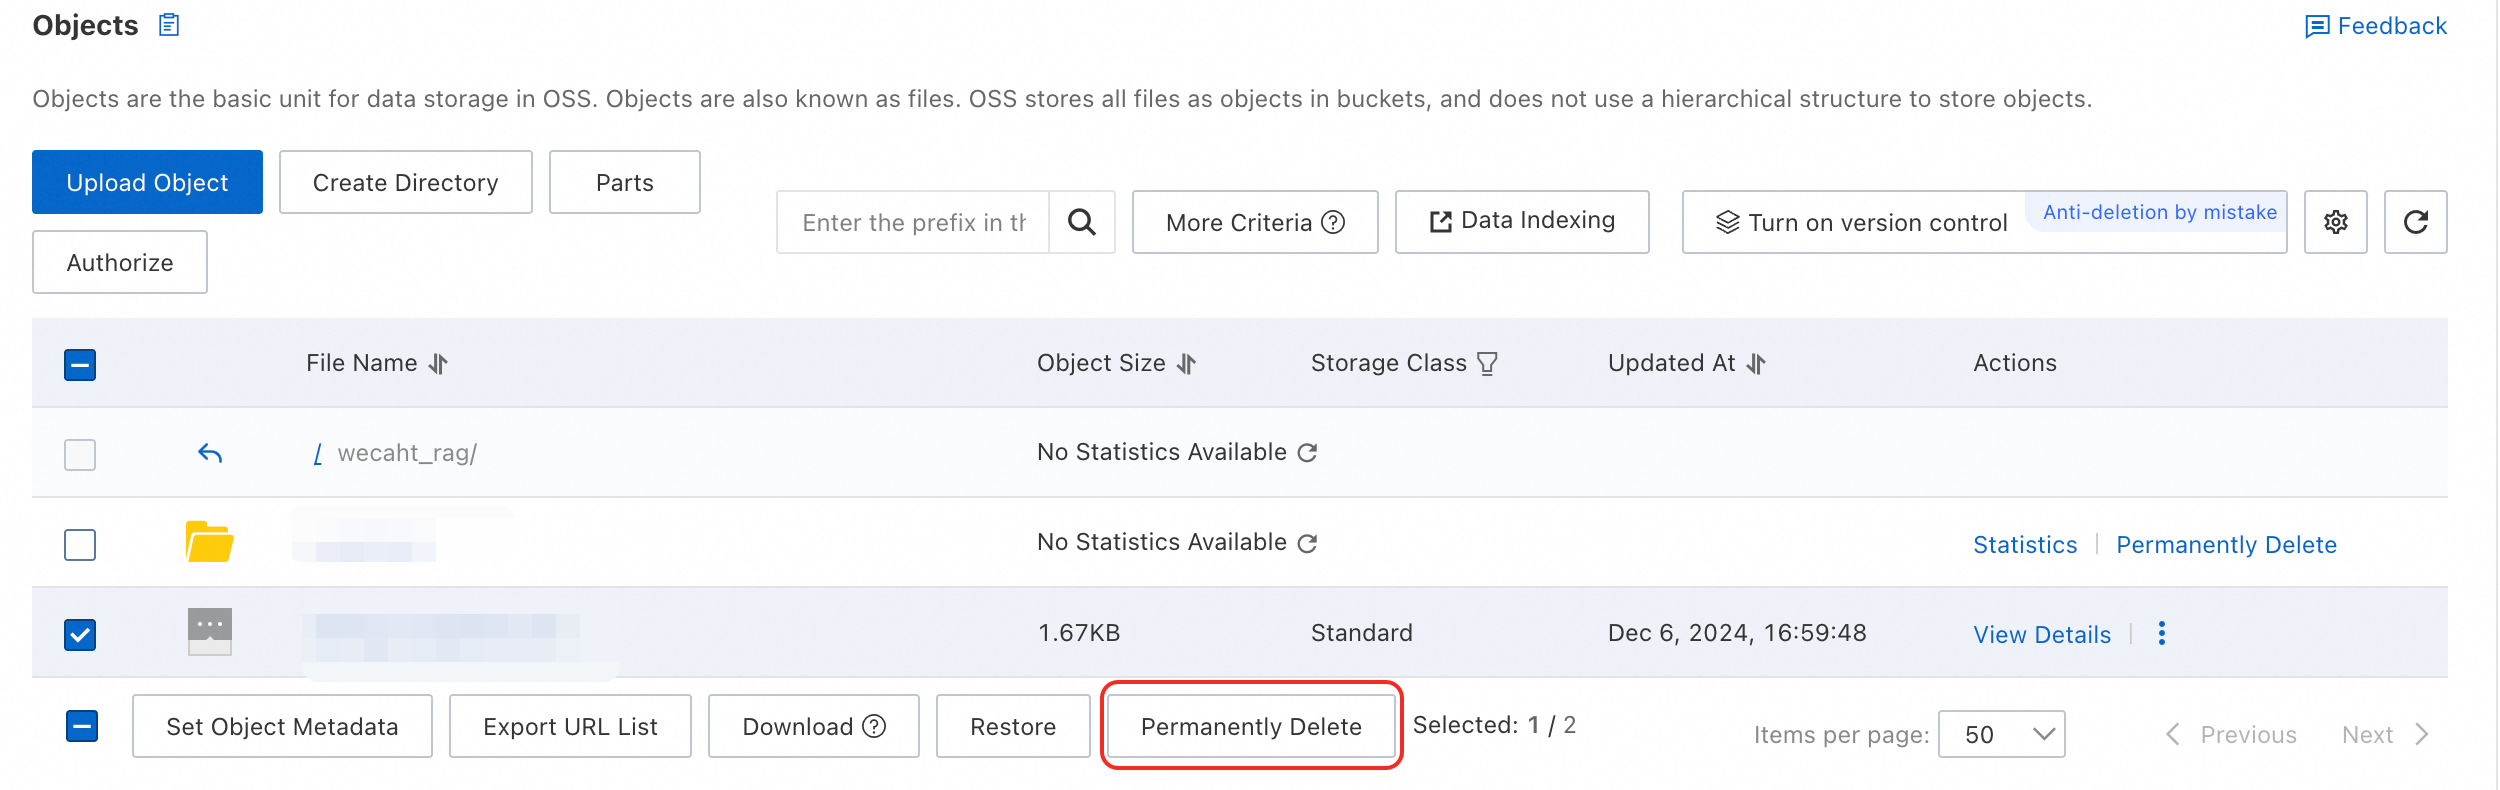
コンソールでファイルを削除するには、ファイルを選択し、下部にある [Permanently Delete] をクリックします。
-
-
インデックス作成タスクの確認:ファイルが変更された後、約 3 分間待つと、自動的にトリガーされたインデックス構築タスクが操作記録リストに表示されます。
定期更新
定期更新機能は DataWorks に依存します。 このサービスを有効化していることを確認してください。 有効化していない場合は、「購入ガイド」をご参照ください。
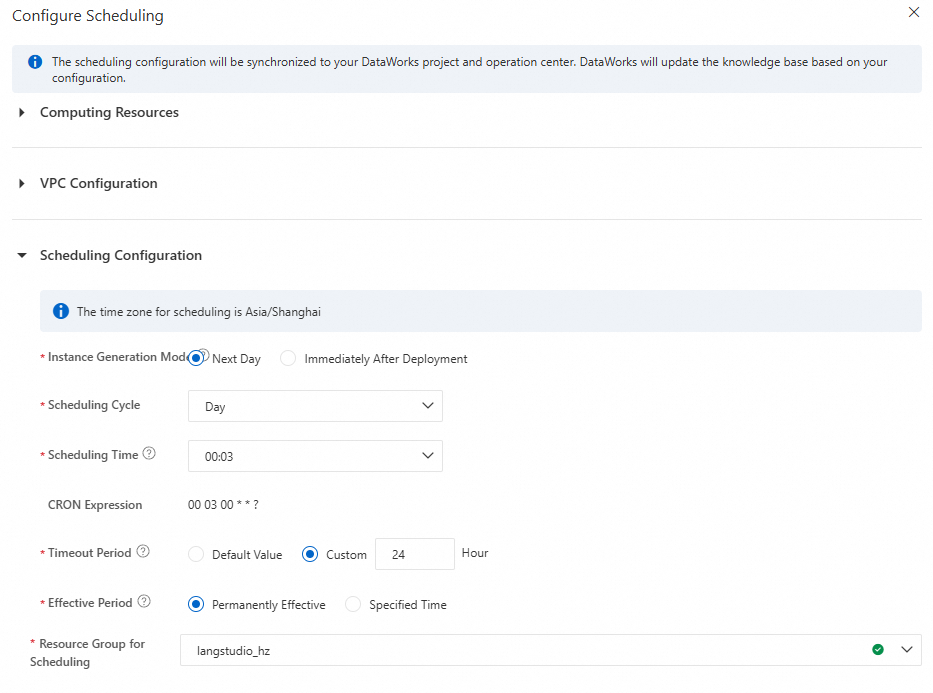
ナレッジベースの詳細ページで、右上隅にある をクリックし、設定を完了して送信します。
-
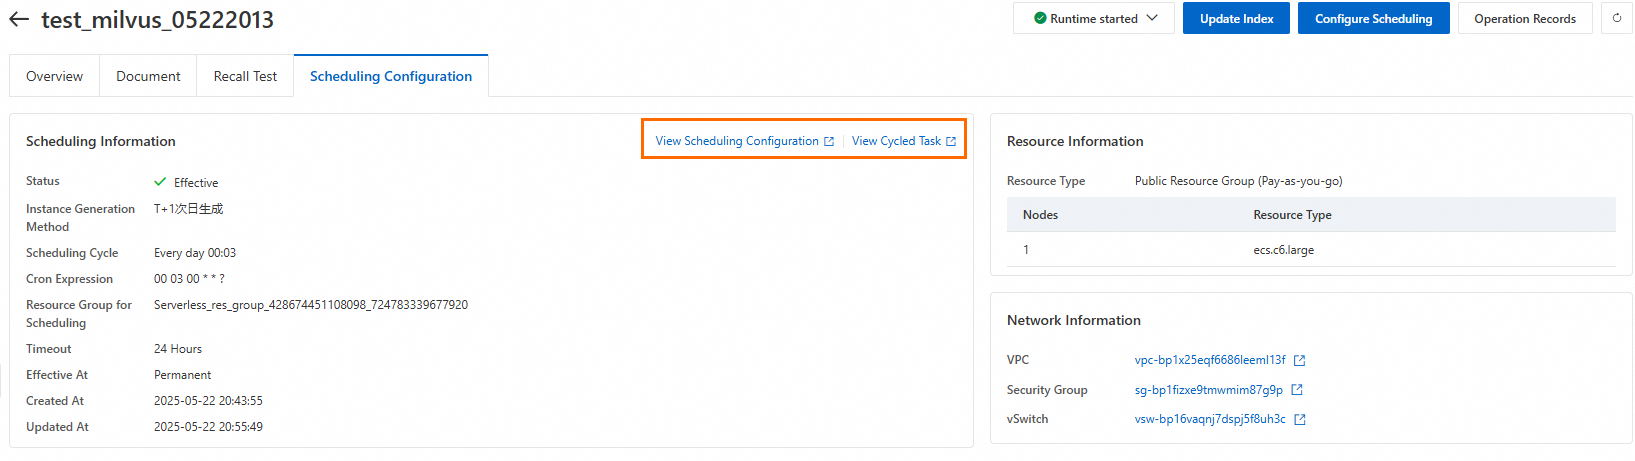
スケジューリング設定と定期タスクの表示
システムは DataWorks DataStudio でワークフローを作成し、DataWorks Operation Center で定期タスクとして公開します。 定期タスクは T+1 ベースで有効になります。 スケジューリング設定は、ナレッジベースのスケジューリング設定ページで確認できます。
-
スケジューリング設定パラメーターの説明:
-
スケジューリングサイクル: ノードが本番環境で実行される頻度 (生成されるサイクルインスタンスの数と実行されるタイミング)。
-
スケジュール時刻: ノードが実行される特定の時刻。
-
タイムアウト定義: 実行中のノードが失敗して終了するまでの期間。
-
有効日: ノードが自動スケジュールで実行される期間。 この範囲外では、ノードは自動的にスケジュールされなくなります。
-
スケジューリングリソースグループ: DataWorks の定期更新に使用されます。 まだ DataWorks リソースグループを作成していない場合は、ドロップダウンリストの [Create Now] をクリックして作成ページに移動します。 作成後、リソースグループを現在のワークスペースにバインドします。

スケジューリングパラメーターの詳細については、「時間プロパティ設定の説明」をご参照ください。
-
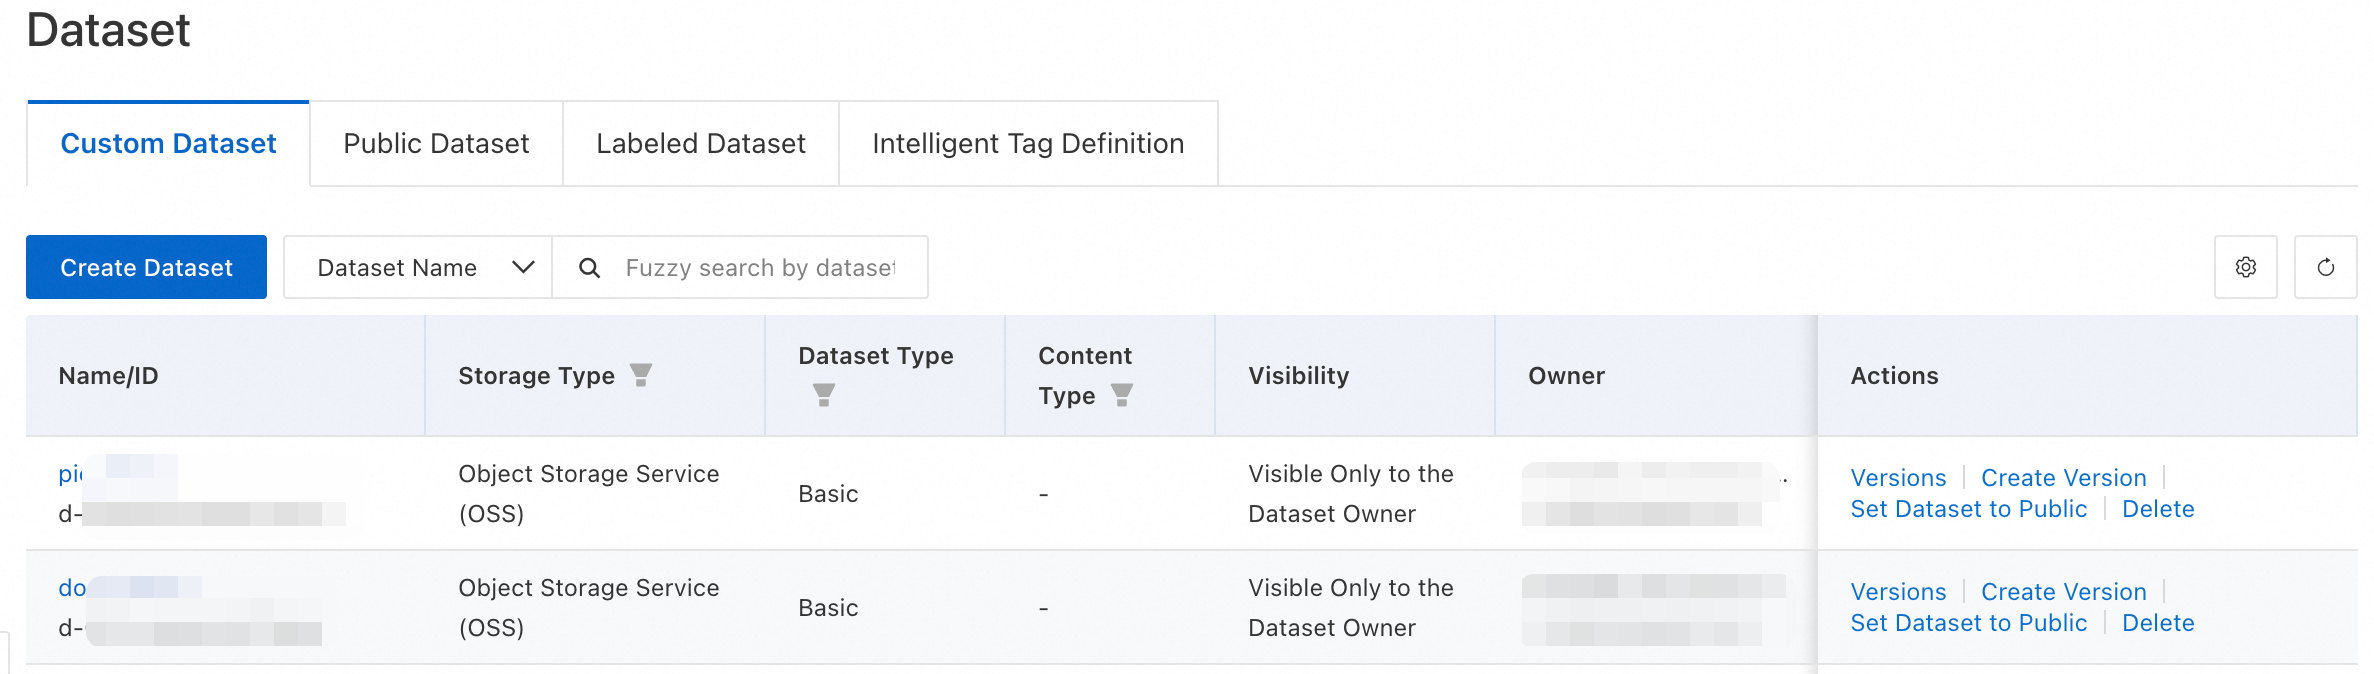
データセットの表示
インデックスの更新が成功すると、システムは [出力 OSS パス] をデータセットとして登録します。 AI アセット管理 - データセット で表示できます。 データセットにはナレッジベース名が使用され、インデックス構築の出力を記録します。
ランタイムの設定
チャンクのプレビューと検索テストを実行するためにランタイムを選択します。 これらの操作は、ベクトルデータベースとエンベディングサービスにアクセスします。
ランタイムの要件:
-
内部ネットワークアドレス経由でベクトルデータベースまたはエンベディングサービスにアクセスする場合、ランタイムの VPC がそれらの VPC と同じであるか、通信できることを確認してください。
-
インスタンス RAM ロール にカスタムロールを選択する場合は、そのロールに OSS アクセス権限を付与します (
AliyunOSSFullAccessを推奨します)。「RAM ロールへの権限付与」をご参照ください。
ランタイムのバージョンが古い (2.1.4 より前) 場合、ドロップダウンリストに表示されないことがあります。 新しいランタイムを作成してください。
複数バージョンの管理
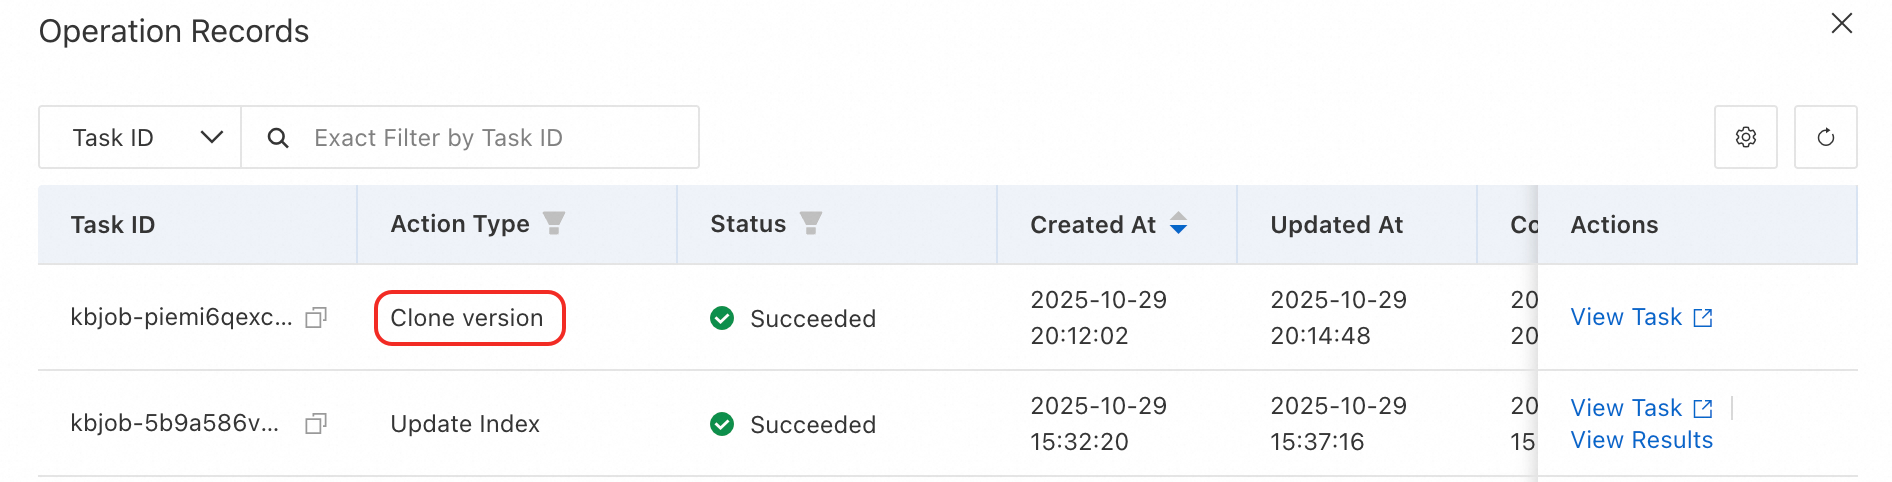
テスト済みのナレッジベースバージョンを新しい公式バージョンとしてクローン作成し、開発環境と本番環境を分離します。
ナレッジベースの詳細ページで、タイプの横にあるドロップダウンを使用してバージョンを切り替えます。 アプリケーションフローのナレッジベースノードで目的のバージョンを選択します。

クローンを作成すると、ワークフロータスクが送信され、操作記録に表示されます。
取得パラメーターの設定
-
Top K:取得する関連性の高いチャンクの最大数です。範囲:1~100。
-
スコアのしきい値:類似度スコアのしきい値 (0~1) です。この値を超えるスコアのチャンクのみを返します。
-
取得パターン:デフォルトはデンス (ベクトル) です。ハイブリッド検索 (ベクトル + キーワード) には、Milvus 2.4.x 以降または Elasticsearch が必要です。取得モードの選択。
-
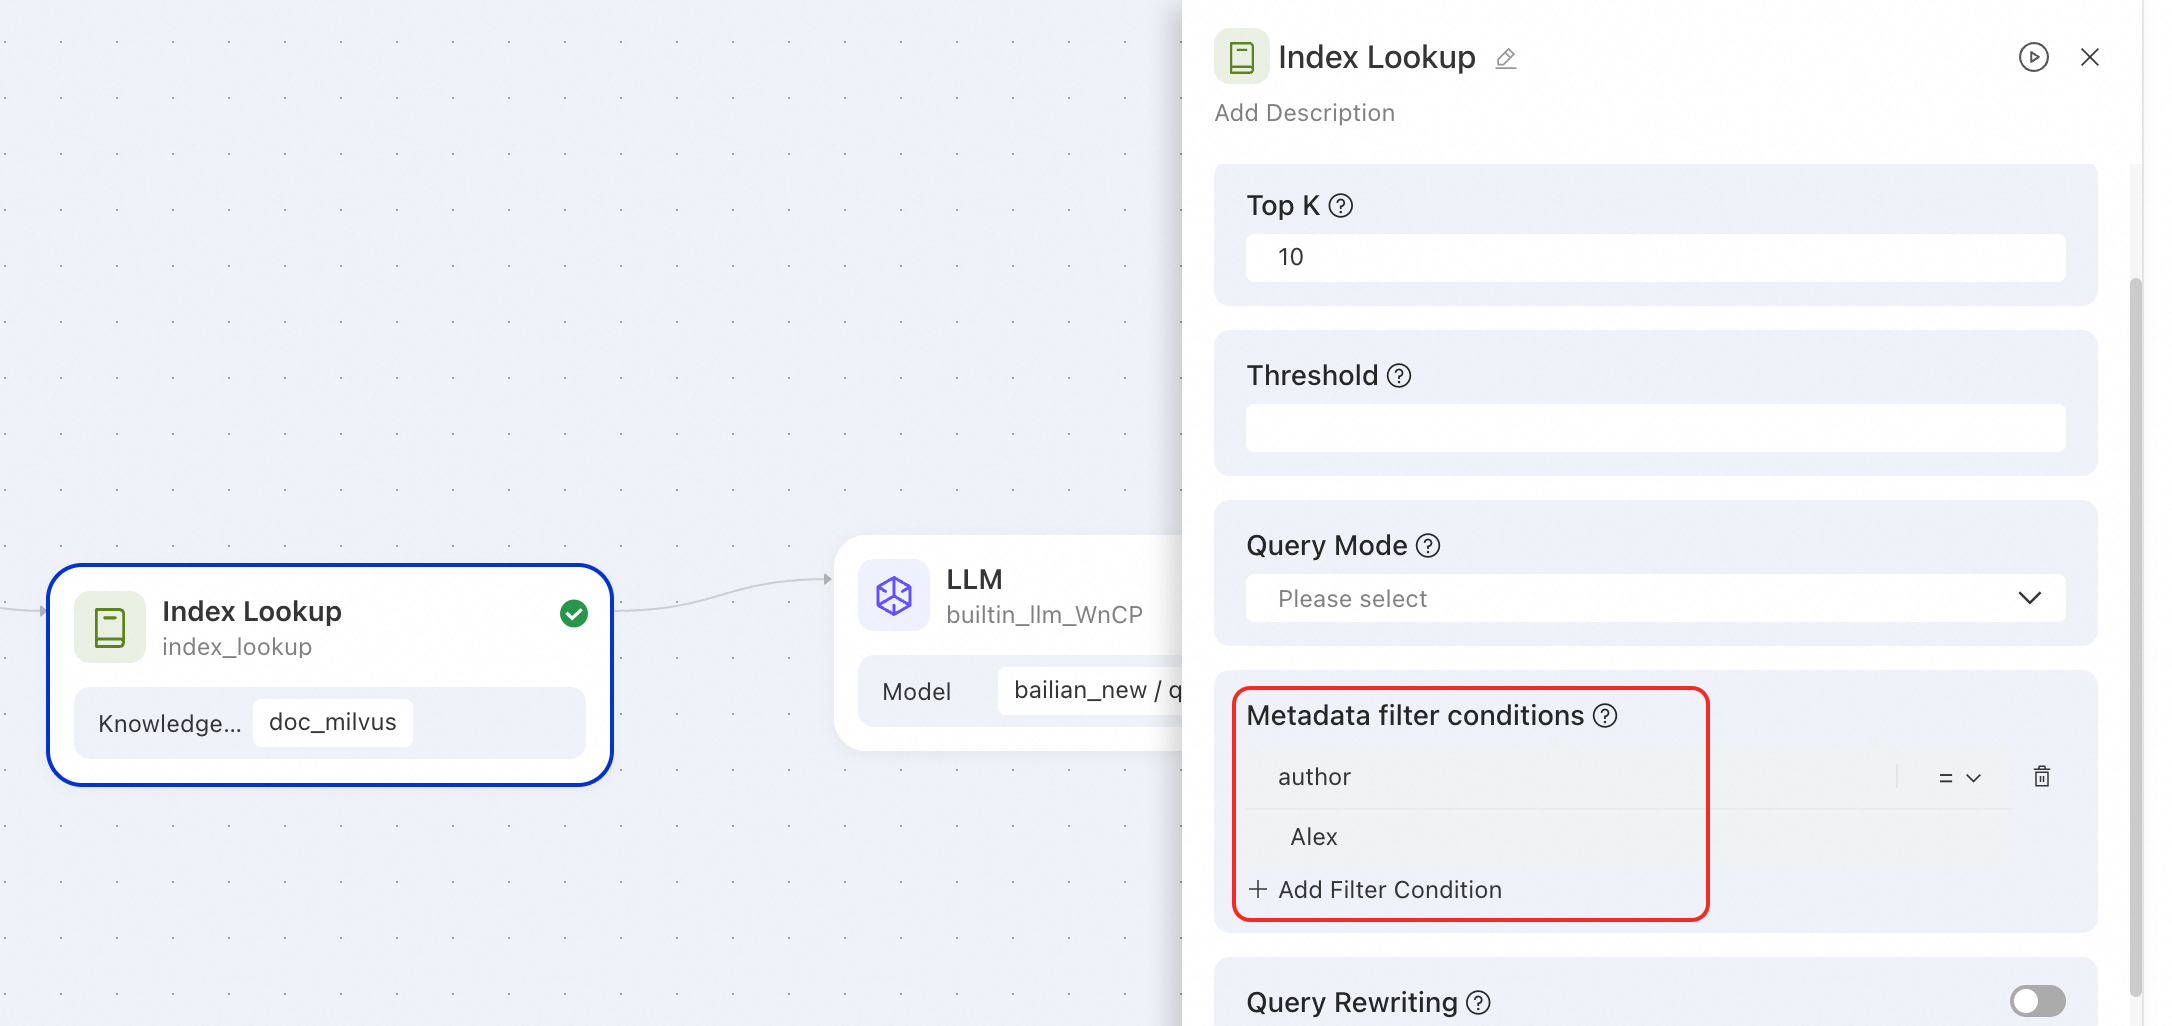
メタデータフィルター条件:メタデータを使用して検索範囲を絞り込みます。メタデータの使用。
-
クエリリライト:LLM を使用して、曖昧なクエリや文脈に依存するクエリを明確にし、取得精度を向上させます。クエリリライト。
-
結果の再ランキング:再ランキングモデルを使用して結果を並べ替え、最も関連性の高いものを先頭に配置します。結果の再ランキング。
説明再ランキングモデルが必要です。対応接続タイプ: Model Studio、AI Search Open Platform Model Service、および General Reranker Model Service。
検索パフォーマンスの最適化
チャンキングパラメーターの調整
指針
-
モデルのコンテキスト上限: チャンクサイズは、埋め込みモデルのトークン上限を超えないようにする必要があります。
-
情報の完全性: チャンクには、過剰なノイズを含めず、意味的に完結した内容を含める必要があります。構造が明確なテキストでは、段落単位のチャンキングを検討してください。
-
連続性の維持: 境界でコンテキストが欠落しないよう、オーバーラップはチャンクサイズの 10% ~ 20% に設定します。
-
反復による干渉の回避: オーバーラップが大きすぎると冗長性が増え、検索効率が低下します。
デバッグの提案
-
反復的な最適化: 初期値 (例:チャンクサイズ 300、オーバーラップ 50) から開始し、検索結果と Q&A の結果に基づいて調整を繰り返し、データに最適な設定を見つけます。
-
自然言語の境界: テキストに明確な構造 (例:章や段落で区切られている) がある場合は、その自然な境界に沿って分割し、意味の完全性を維持することを検討してください。
クイック最適化ガイド
|
問題 |
最適化の提案 |
|
検索結果の関連性が低い |
チャンクサイズを増やし、チャンクのオーバーラップを減らしてください。 |
|
結果のコンテキストに一貫性がない |
チャンクのオーバーラップを増やしてください。 |
|
適切な一致が見つからない (再現率が低い) |
チャンクサイズを適度に増やしてください。 |
|
計算コストまたはストレージコストが高い |
チャンクサイズを減らし、チャンクのオーバーラップを減らしてください。 |
次の表は、過去の経験に基づき、テキストの種類ごとに推奨されるチャンクサイズとオーバーラップサイズを示します:
|
テキストタイプ |
推奨チャンクサイズ (chunk_size) |
推奨オーバーラップサイズ (chunk_overlap) |
|
短いテキスト (FAQ、要約) |
100 ~ 300 |
20 ~ 50 |
|
一般的なテキスト (ニュース、ブログ) |
300 ~ 600 |
50 ~ 100 |
|
技術ドキュメント (API、論文) |
600 ~ 1024 |
100 ~ 200 |
|
長文ドキュメント (法務、書籍) |
1024 ~ 2048 |
200 ~ 400 |
検索モードの選択
各検索モードには、シナリオに応じた強みがあります:
-
密 (ベクトル) 検索:意味理解に優れています。 クエリとドキュメントをベクトルに変換し、ベクトルの類似度を計算して意味的な関連性を判定します。
-
疎 (キーワード) 検索: 完全一致に優れています。従来の単語頻度モデル (BM25 など) に基づき、キーワードの出現頻度とドキュメント内の位置から関連性を計算します。
-
ハイブリッド検索: 両方の長所を組み合わせます。ベクトル検索とキーワード検索の結果を統合し、Reciprocal Rank Fusion (RRF) や重み付き融合などのアルゴリズムでリランキングします。
|
検索モード |
長所と短所 |
シナリオ |
|
密 (ベクトル) 検索 |
|
|
|
疎 (キーワード) 検索 |
|
|
|
ハイブリッド検索 |
|
|
メタデータによる検索のフィルタリング
メタデータフィルタリングの価値
-
高精度な検索とノイズの低減: メタデータは検索時のフィルターとして使用できます。メタデータでフィルタリングすると、無関係なドキュメントを除外でき、生成モデルに無関係なコンテンツが渡ることを防げます。たとえば、ユーザーが "Find science fiction novels written by Liu Cixin," と質問した場合、システムはメタデータ条件
author=Liu Cixinとcategory=science fictionを使用して、最も関連性の高いドキュメントを直接特定できます。 -
ユーザー体験の向上
-
パーソナライズされたレコメンド: メタデータを使用して、ユーザーの過去の嗜好 (例:"sci-fi" ドキュメントを好む) に基づくパーソナライズされたレコメンドを提供します。
-
解釈性の向上: 結果にドキュメントのメタデータ (例:著者、ソース、日付) を含めることで、ユーザーは信頼性と関連性を判断しやすくなります。
-
多言語/マルチモーダル拡張のサポート: "language" や "media type" などのメタデータにより、複数言語や、テキストと画像が混在するメディアを含むナレッジベースの管理が容易になります。
-
使用方法
機能の制限:
-
ランタイムのイメージバージョン: 2.1.8 以降である必要があります。
-
ベクトルデータベース: Milvus と Elasticsearch のみサポートしています。
-
ナレッジベースタイプ: ドキュメントまたは構造化データをサポートします。画像はサポートしていません。
-
メタデータ変数の設定。 Milvus を使用するナレッジベースの場合、概要 タブの メタデータ セクションで [編集] をクリックして変数を設定します (たとえば、
authorという名前の変数)。 予約済みフィールドは使用しないでください。
-
ドキュメントのタグ付け。ドキュメントチャンク詳細ページに移動し、メタデータの編集 をクリックして、メタデータ変数とその値 (例:
author=Alex) を追加します。[概要] ページでは、メタデータの使用状況と値のカウントを表示できます。
-
フィルタリング効果のテスト。 リコールテスト タブで、メタデータフィルター条件を追加し、テストを実行します。
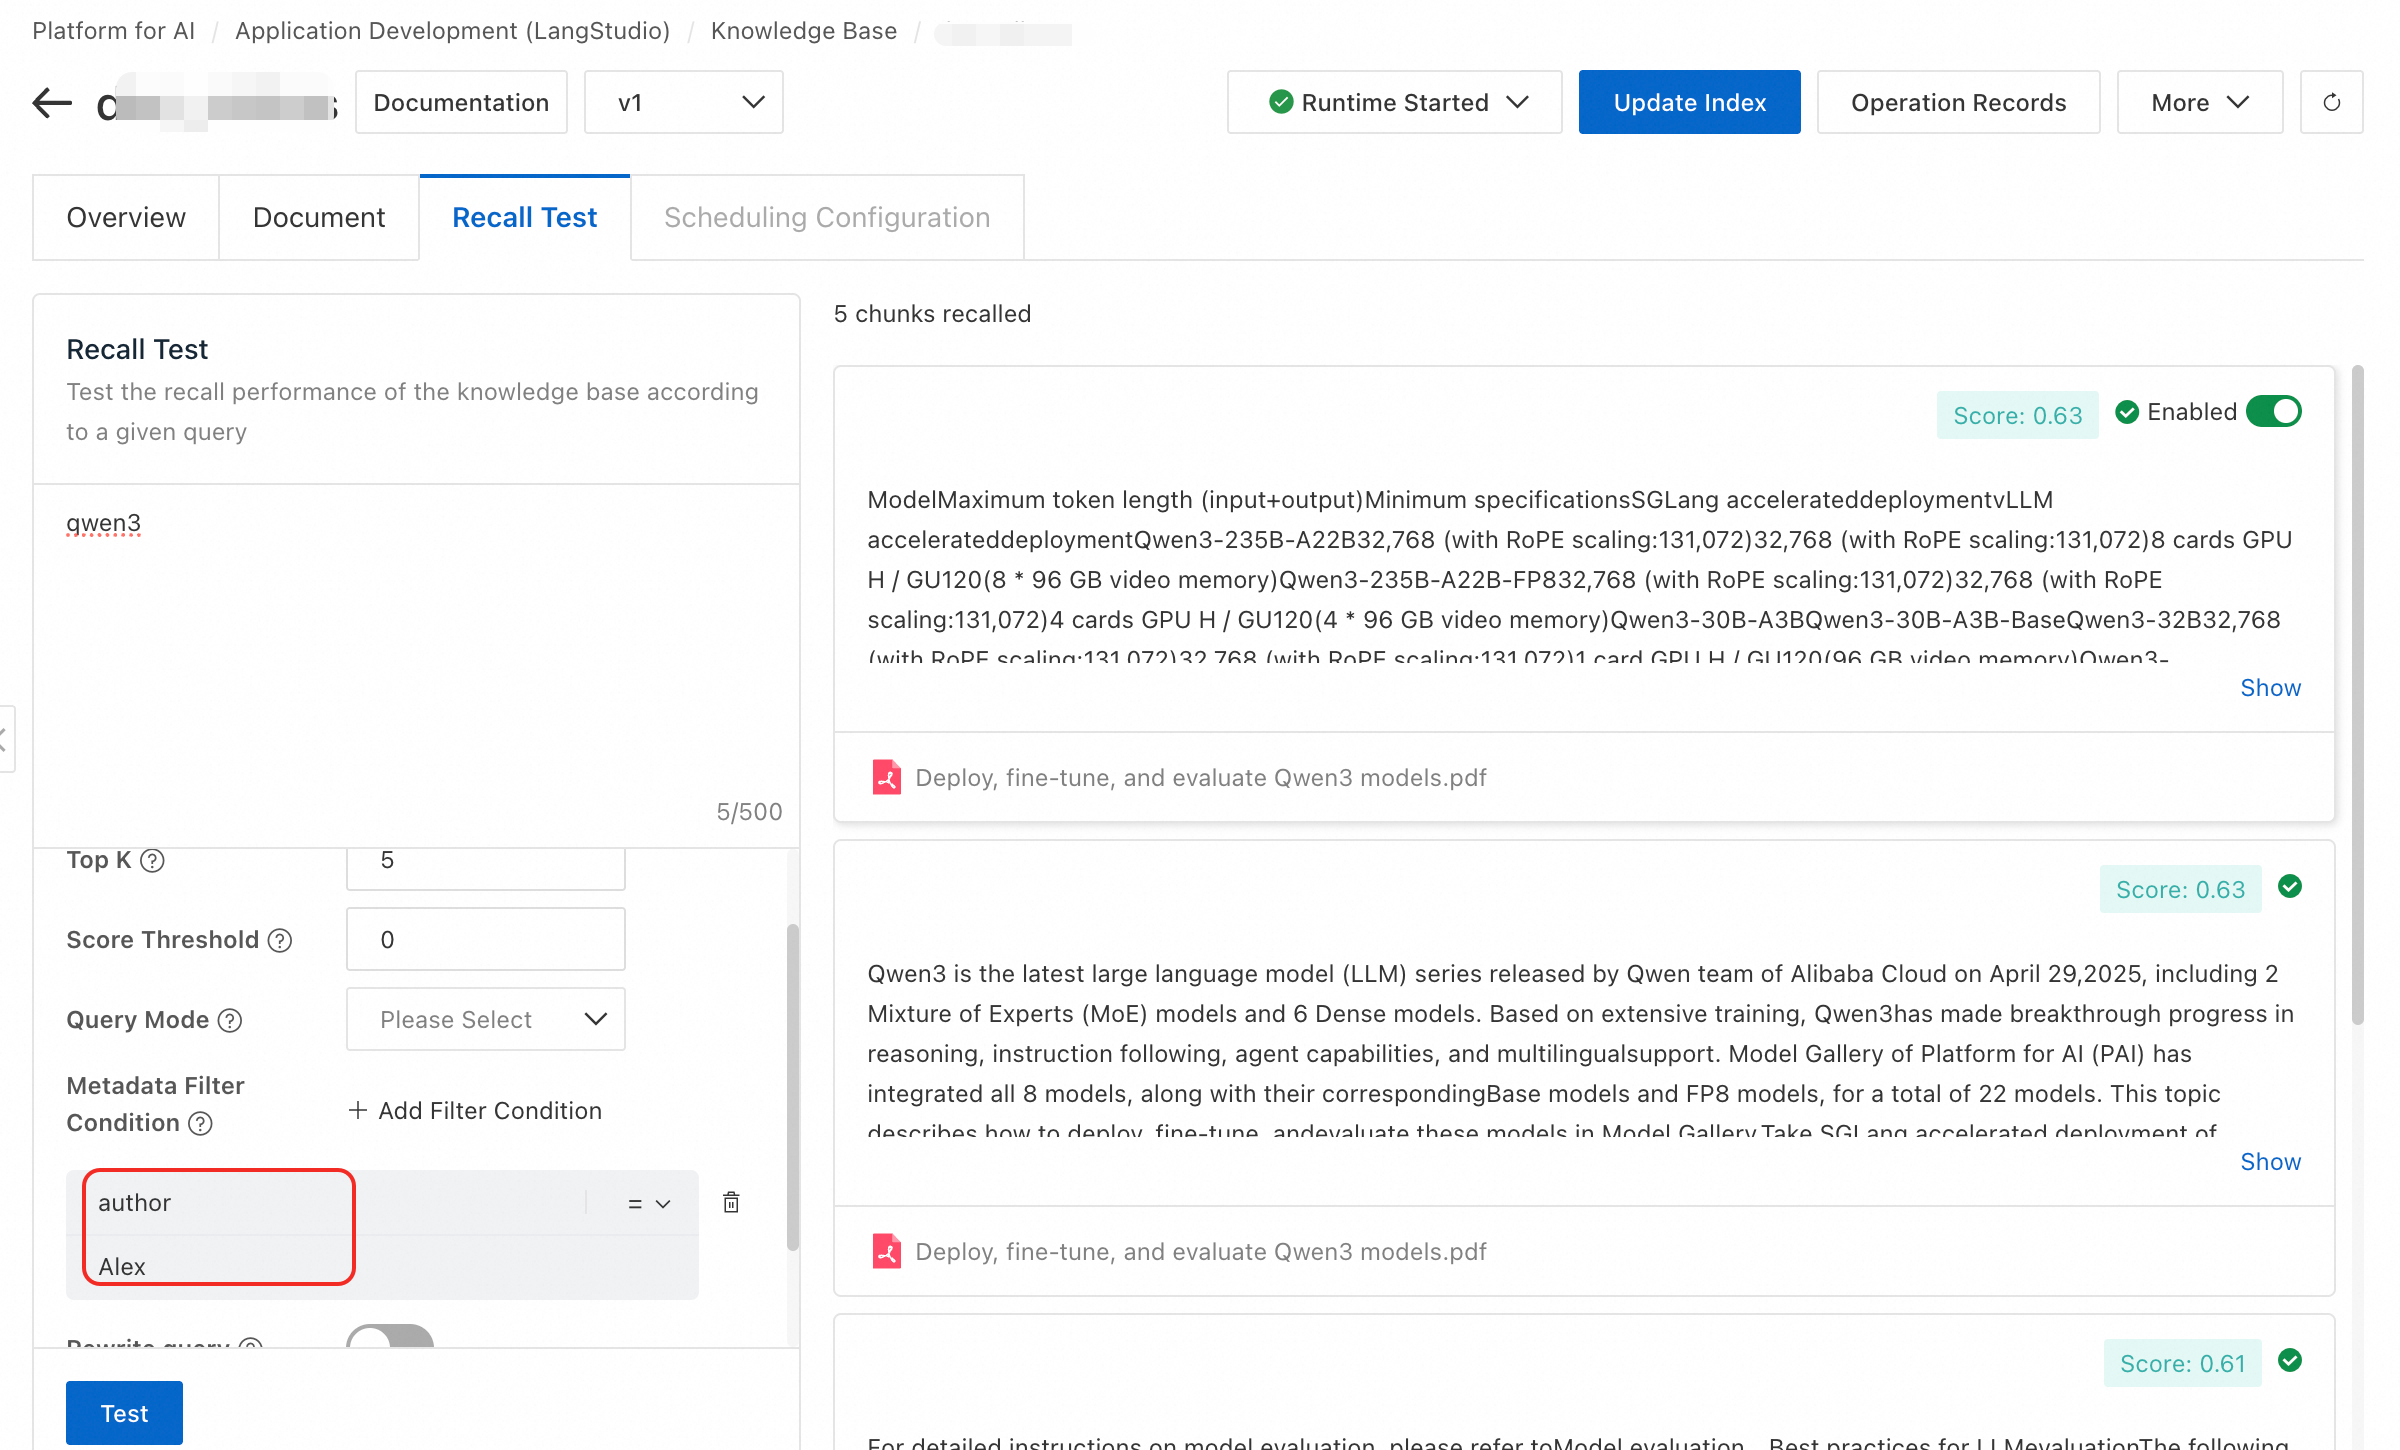
注: 画像に表示されているドキュメントは、手順 2 でタグ付けされています。
-
アプリケーションフローで使用します。ナレッジベースノードでメタデータフィルター条件を設定します。
クエリリライトと結果のリランキング
クエリリライト
曖昧、口語的、またはコンテキスト依存のクエリを、明確で単独で成立する質問に書き換え、検索精度を向上させます。
-
推奨されるシナリオ:
-
ユーザーのクエリが曖昧または不完全である場合 (例:コンテキストがない状態で "When was he born?" と質問する)。
-
マルチターン会話で、クエリがコンテキストに依存する場合 (例:"What did he do after that?")。
-
レトリバーまたは LLM (大規模言語モデル) の性能が低く、クエリを正確に理解できない場合。
-
意味検索ではなく、従来の転置インデックスによる検索方式 (BM25 など) を使用する場合。
-
-
推奨しないシナリオ:
-
ユーザーのクエリが既に非常に明確で具体的である場合。
-
LLM の性能が高く、クエリを十分に理解できる場合。
-
システムが低レイテンシを求め、書き換えによる追加の遅延を許容できない場合。
-
結果のリランキング
検索結果を並べ替え、最も関連性の高いドキュメントを優先します。
-
推奨されるシナリオ:
-
初期レトリバーの結果が不安定である場合 (例:BM25 や DPR)。
-
検索結果の順位が重要である場合 (例:検索または Q&A システムで高い Top-1 精度が求められる)。
-
-
推奨しないシナリオ:
-
システムリソースが限られており、追加の推論オーバーヘッドを許容できない場合。
-
初期レトリバーの性能が十分に高く、リランキングによる改善が限定的である場合。
-
応答時間が重要である場合 (例:リアルタイム検索)。
-
よくある質問
インデックス更新またはバージョンクローニングタスクが失敗した場合のトラブルシューティング
タスクが失敗した場合は、次の手順を実行してください。
-
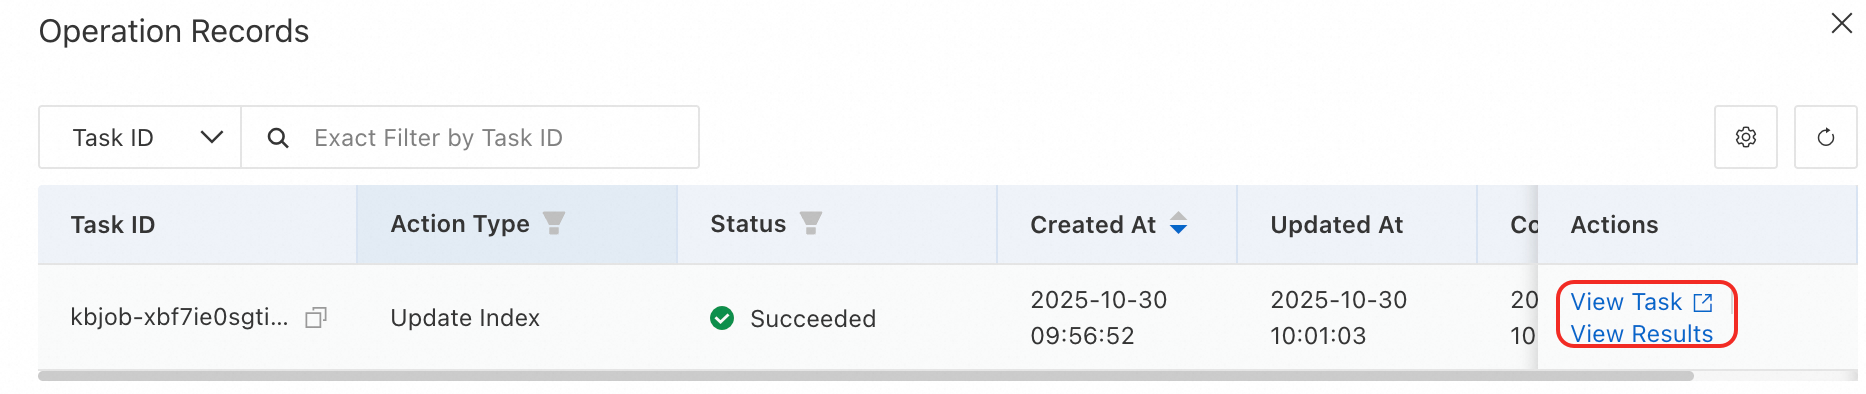
操作記録の表示: ナレッジベース詳細ページで、操作履歴 で失敗したタスクを見つけ、[タスクの表示] をクリックします。
-
タスクログの確認:システムによって PAI ワークフローページにリダイレクトされます。失敗したノードのログを確認してください。

例えば、ドキュメントタイプのナレッジベースのインデックス更新のワークフロータスクには、次の 3 つのノードが含まれます。[read-oss-file] ノードを除き、各ノードは PAI-DLC タスクを作成します。ログ内のジョブ URL から DLC タスクの詳細を確認することもできます。
-
read-oss-file:OSS ファイルを読み取ります。
-
rag-parse-chunk:ドキュメントの前処理とチャンキングを行います。
-
rag-sync-index:テキストチャンクのエンベディングと、ベクトルデータベースへの同期を行います。
-
ナレッジベースにシステムファイル (requirements.txt など) が表示されるのはなぜですか?
原因:ナレッジベースは、設定された [Input OSS Path] 内のすべてのファイルをインデックス化します。プロジェクトルートに設定すると、requirements.txt、.DS_Store、.git/、__pycache__/、*.pyc などのシステムファイルが意図せずインデックス化される可能性があります。
解決策:
-
インデックス化したいファイルのみを含む専用ディレクトリ (例:
knowledge-base-docs/) を OSS に作成します。 -
ナレッジベースの [Input OSS Path] をこのディレクトリを指すように更新します。
-
除外すべき一般的なファイル:
requirements.txt、.DS_Store、.git/、__pycache__/、*.pyc、*.log
誤ってインデックス化されたファイルをナレッジベースから削除するにはどうすればよいですか?
すでにインデックス化されたファイルを検索結果から削除するには、次の手順を実行してください。
-
OSS からの削除:次のいずれかの方法でファイルを削除してください。
-
コンソール: ファイルを選択し、[完全に削除] をクリックします。
-
API:バージョンパラメータを指定して、変更イベントをトリガーします。
-
-
自動再インデックス作成の待機: [自動更新] を設定している場合 (「自動更新」をご参照ください):
-
ルールが有効になるまで、少なくとも 3 分間待機します。
-
操作履歴 タブで、再インデックス作成タスクが完了したことを確認します。
-
-
手動更新 (自動更新が設定されていない場合): 右上隅にあるインデックスの更新をクリックして、完全な再インデックスを実行します。
-
削除の確認:[ドキュメント] タブで、ファイルのステータスがインデックス済みから削除済みに変更されたことを確認してください。
インデックスレコードがベクトルデータベースに完全に伝播するまでに数分かかる場合があります。再インデックス後もファイルが検索結果に影響を与える場合は、もう一度、完全な再インデックスをトリガーしてみてください。