Alibaba Cloud OpenSearch LLM-based Conversational Search は、データ解析、チャンキング、ベクトル化、テキスト検索とベクトル検索、およびマルチモーダル LLM 機能を標準搭載しています。本チュートリアルでは、オープンソース LLM アプリケーションプラットフォームである Dify と統合し、検索拡張生成 (RAG) システムを構築する方法について説明します。
人工知能生成コンテンツ (AIGC) 技術の進化により、大規模言語モデル (LLM)、エージェントフレームワーク、およびワークフローオーケストレーションが多様なアプリケーションサービスを実現しています。検索拡張生成 (RAG) は、企業ナレッジベース、インテリジェントカスタマーサービス、および e コマースアシスタントの中核コンポーネントとなっています。Alibaba Cloud Model Studio (Bailian) や Dify などの開発プラットフォームは、RAG を標準搭載し、開発者がビジネスアプリケーションを迅速に構築できるよう支援しています。
しかし、RAG の精度は検索パフォーマンスに大きく依存しており、アプリケーション開発プラットフォームは以下のような課題に直面しています:
-
使いやすさの不足: プラットフォームは、ナレッジベースドキュメントの形式、数量、およびサイズを制限することが多く、開発者は複雑なデータ前処理を実行するか、実際の需要を満たすことができなくなります。
-
制御性の制限: ほとんどのプラットフォームはブラックボックスであり、コアパイプラインのカスタマイズ、チューニング、または拡張が困難で、エンドツーエンドのパフォーマンスが低下することがよくあります。
-
エンタープライズグレード機能の不足: 多くのプラットフォームは、エンタープライズグレードの権限分離や迅速なデータインポートまたは更新機能を欠いており、本番環境での採用が困難です。
これらの課題に対処するために、Alibaba Cloud OpenSearch LLM-based Conversational Search を RAG システムとして使用し、ワークフローに統合してエンタープライズグレードのアプリケーションを構築できます。OpenSearch は Model Studio のモデルとの統合をサポートしており、カスタマイズされた RAG パフォーマンスのために LLM の選択肢を拡大します。詳細については、「LLM Management」をご参照ください。
OpenSearch は、Model Studio や Dify などのプラットフォームと柔軟に統合するために、さまざまな呼び出しおよび認証メカニズムをサポートしています。以下のセクションでは、Dify を例として、オープンソースアプリケーションプラットフォームとの統合におけるベストプラクティスを説明します。
アーキテクチャ
開発者はナレッジベースを OpenSearch にインポートします。ワークフローはユーザーのクエリを処理し、OpenSearch RAG システムに送信します。OpenSearch RAG システムは、参照リンクと画像を含む会話形式の回答を返します。その後、開発者はビジネス要件に応じてワークフロー内でこれらの結果を処理し、最終的な回答をエンドユーザーに提供します。
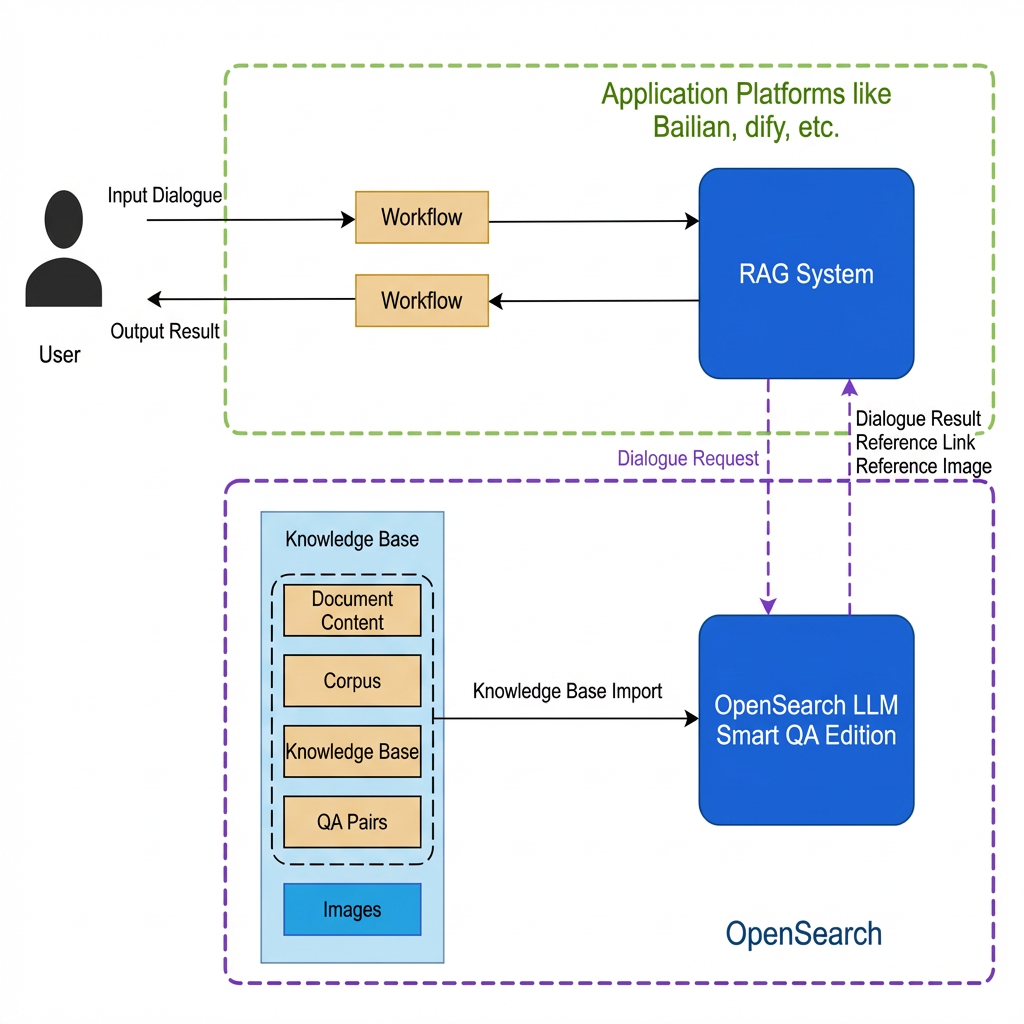
OpenSearch での RAG システムの構築
ステップ 1: RAG システムの構築
Alibaba Cloud OpenSearch LLM-based Conversational Search は、オールインワンの RAG 製品であり、数分で RAG システムを構築できます。コンソールでモデルの選択、プロンプトのカスタマイズ、およびパフォーマンスのチューニングが可能です。インスタンスの詳細で、[設定センター] -> [データ設定] に移動し、企業ナレッジベースを設定します。
[データ設定] ページで、[ファイルインポート] または [Web リンクインポート] をクリックして、企業ナレッジベースデータをインポートします。ファイルインポート機能は、doc、docx、pdf、html、txt、ppt、および pptx 形式の非構造化データファイル、および JSON または Excel 形式の構造化データ (UTF-8 エンコード、最大ファイルサイズ 128 MB) をサポートしています。ファイルを選択した後、[ファイルをアップロード] をクリックしてインポートを完了します。
詳細については、「コンソールを使用した企業ナレッジベース Q&A システムの構築」をご参照ください。
ステップ 2: API キーの作成と取得
パブリック API ドメイン名と API キーを作成して取得し、HTTP リクエストフローで使用するために安全に保管します。
Dify でのビジネスアプリケーションの構築
ステップ 1: ワークフローの作成
Dify の [Studio] ページで、[空のアプリを作成] をクリックします。[空のアプリを作成] ダイアログボックスで、アプリタイプとして [チャットアシスタント] を選択し、オーケストレーション方法として [ワークフローオーケストレーション] を選択します。アプリケーションに名前を付けて説明を入力し、[作成] をクリックします。
開始: ユーザーの入力を取得します。
Alibaba Cloud OpenSearch LLM-based Conversational Search (HTTP リクエスト): ユーザーの入力を OpenSearch に送信し、RAG システムからの出力を返します。
出力の解析 (コード実行): RAG システムからの出力を解析します。
回答を返す: 最終結果をユーザーに返します。
ステップ 2: ノードの設定
-
HTTP 経由での RAG システムへのアクセス
Method を POST に設定します。BODY の JSON コンテンツの例は {"question":{"text":"@ Start {x} sys.query "}} です。ここで、ユーザーの質問はワークフロー変数 sys.query を通じて渡されます。API キー認証の場合:
-
認証タイプ: API キー
-
API 認証タイプ: Bearer
-
API キー: Alibaba Cloud OpenSearch LLM-based Conversational Search から取得した API キー。
URL: Alibaba Cloud OpenSearch LLM-based Conversational Search から取得したパブリック API ドメイン名 + OpenSearch API パス (例: v3/openapi/apps/[app_name]/actions/knowledge-search)
BODY: JSON を選択します。完全なリクエスト内容とパラメータについては、「テキスト Q&A」をご参照ください。
-
出力の解析
OpenSearch API レスポンスは JSON 形式で、会話形式の回答、参照リンク、および参照画像が含まれます。コード実行を使用してレスポンスを解析し、必要な情報を抽出します。
回答のみを抽出するサンプルコード:
def main(body: str) -> str:
    import json
    dat = json.loads(body)
    return {
        'result': [ans['answer'] for ans in dat['result']['data']][0]
    }
プレビュー
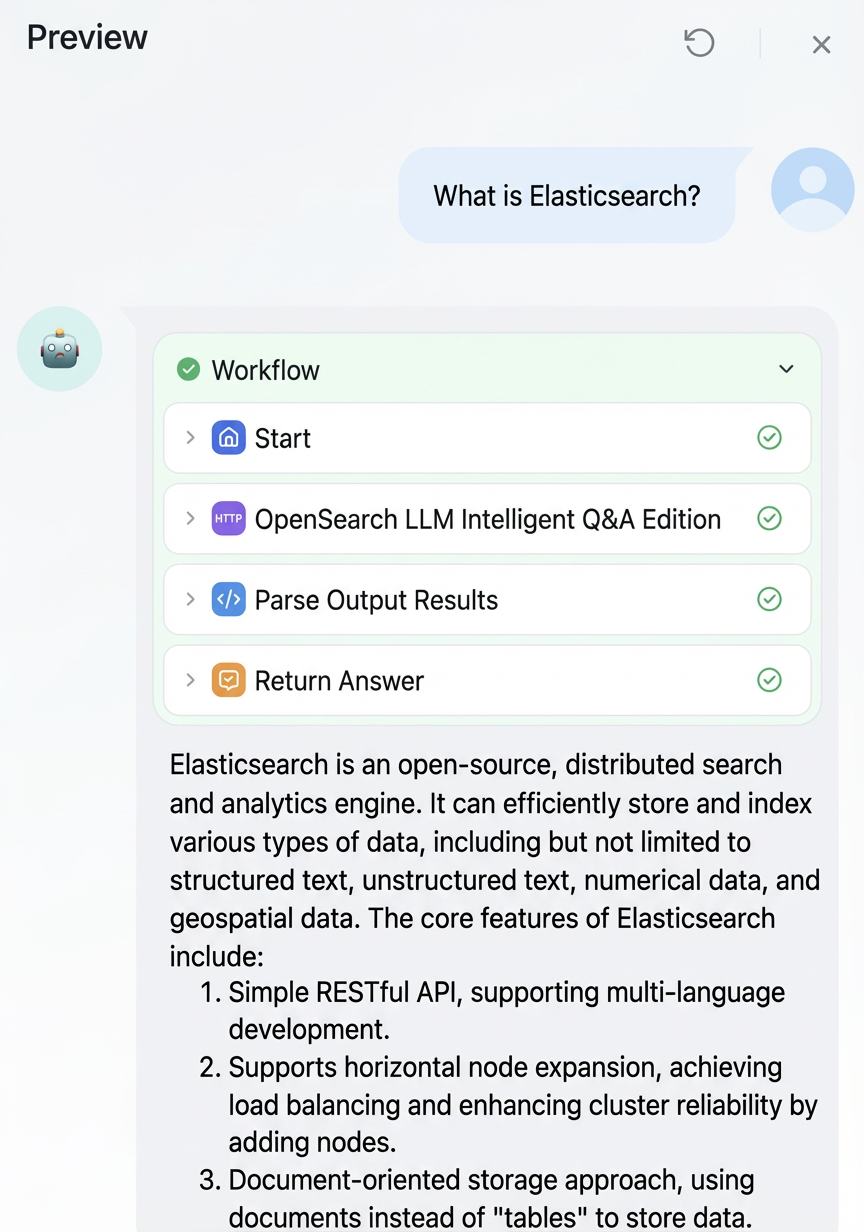
この基盤をもとに、追加のワークフローで拡張し、より豊富なビジネスアプリケーションを構築できます。たとえば、以下のインテリジェント会話アシスタントは、OpenSearch と Qwen モデルを使用して構築されています。
まず、システムはユーザーの意図をアフターサービスの問題、製品利用に関する質問、および雑談に分類します。アフターサービスの問題と製品利用に関する質問については、OpenSearch の対応するナレッジベースをクエリし、RAG システムを使用して回答を生成します。雑談については、Qwen モデルを呼び出してユーザーとチャットし、一般的な質問に回答します。
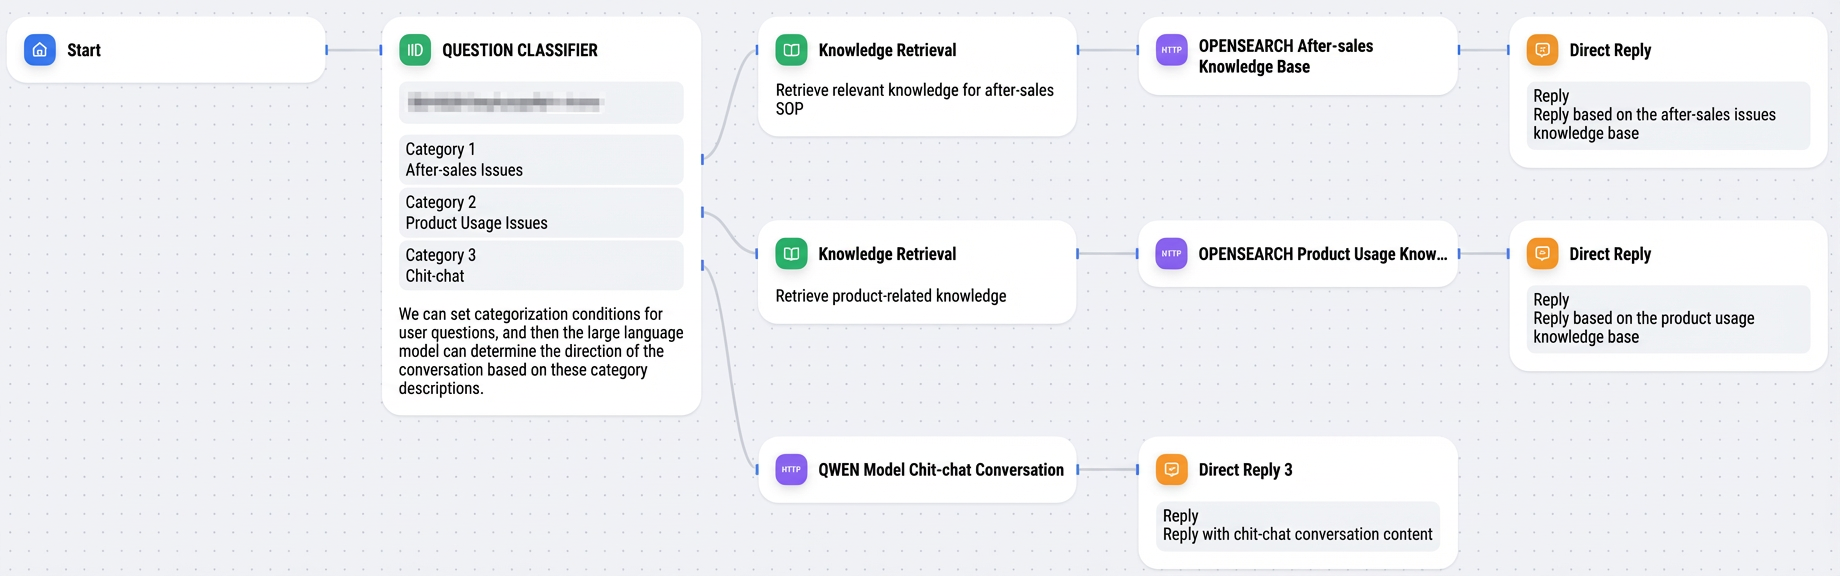
オールインワンの RAG 製品に加えて、Alibaba Cloud AI Search Development Workbench を使用できます。このワークベンチは、ドキュメント解析、ベクトル化、検索、およびリランキングなどのアトミック機能を提供します。これらの機能を使用して、カスタム Dify ツールを作成し、RAG システムの各ステップを微調整します。
Dify プラットフォームの上部メニューで、[ツール] > [カスタム] を選択します。作成された 2 つのカスタムツールが表示されます: [OpenSearch Text Embedding] (テキスト埋め込み) と [OpenSearch Reranker Model] (リランキングモデル)。
-
RAG システムに関するご質問がある場合は、Alibaba Cloud OpenSearch LLM-based Conversational Search DingTalk サポートグループに参加して、技術的な詳細と使用ガイダンスをご確認ください。