このトピックでは、カテゴリ予測機能の概要、基本原理、使用方法について説明します。この機能の迅速な理解と活用にお役立てください。
効果
基本概念
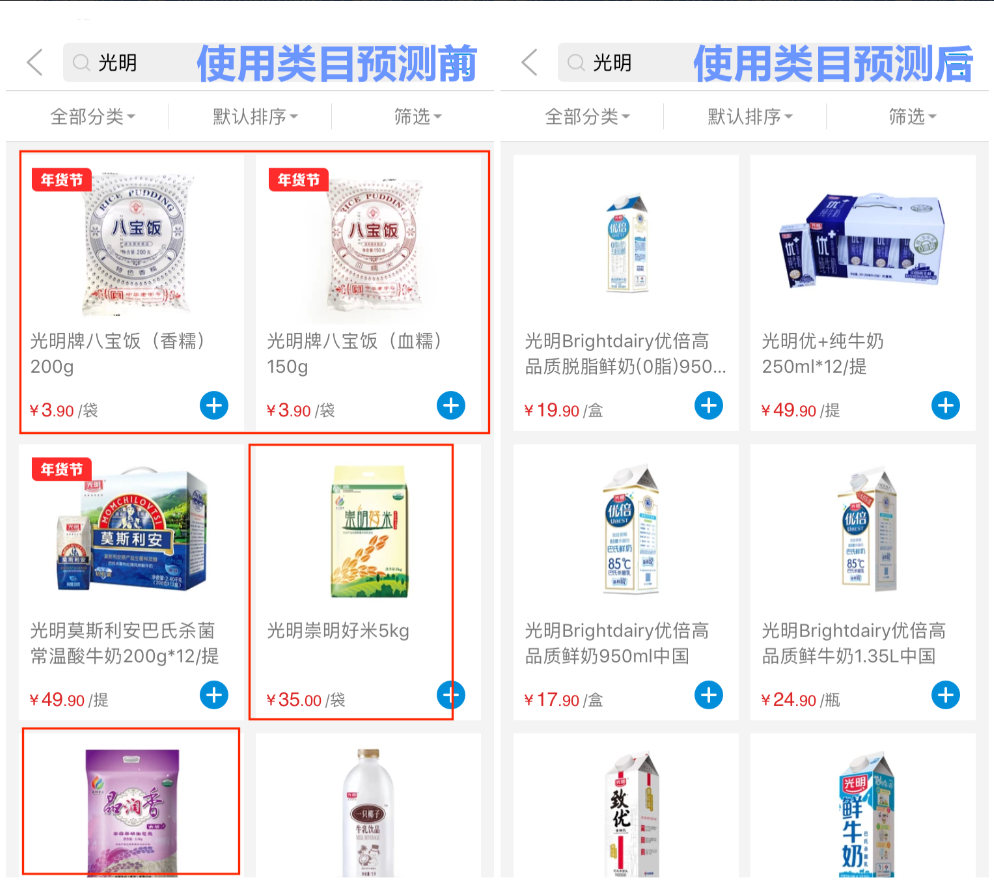
カテゴリ予測は、ユーザーの検索クエリと商品カテゴリとの間の関連性を計算して、検索結果をランク付けする機能です。関連性が高いと判断されたカテゴリに属する商品には、より高いランキングスコアが付き、検索結果の上位に表示されるようになります。
例:
例えば、あるユーザーが「Bright」と検索し、複数の商品が表示されたとします。その中には「Milk」カテゴリの商品と「Rice」カテゴリの商品が含まれています。過去の検索行動データに基づくと、「Bright」と検索したユーザーは、「Rice」カテゴリの商品よりも「Milk」カテゴリの商品を著しく多くクリックしていることが分かります。このため、カテゴリ予測モデルは、「Milk」カテゴリの方が「Rice」カテゴリよりも「Bright」との関連性が高いと予測します。その結果、各商品のランキングスコアを計算する際に、「Milk」カテゴリの商品が「Rice」カテゴリの商品よりも高いスコアを獲得し、上位に表示されるようになります。これにより、検索のビジネス価値が向上します。
カテゴリ予測の基本原理
カテゴリ予測の目的は、検索クエリとカテゴリとの間の関連性を予測することです。そのためには、過去のクエリデータ、クリック行動データ、および各カテゴリに属する商品情報データが必要となります。具体的には、過去に検索されたクエリを収集し、検索後のクリック行動データと組み合わせ、さらに各カテゴリの商品情報と関連付けることで、クエリとカテゴリ間のデータパターンを捉えます。
モデルのトレーニングにはデータソースが必要です。カテゴリ予測モデルを作成する際は、まずアプリケーションと関連付ける必要があります。アプリケーションを関連付けた後、モデルトレーニングに必要となる、以下の 3 種類のデータを特定する必要があります。
アプリケーションで過去に検索されたすべてのクエリ。検索リクエストに
raw_queryパラメータを追加する必要があります。カテゴリデータと商品データ。モデルトレーニングの準備時に、アプリケーションからこれらのフィールドを指定する必要があります。最低でも、アプリケーション内のカテゴリ ID フィールドと商品タイトルフィールドを指定する必要があります。
アプリケーションのクリック行動データ。報告される行動データが包括的で高品質であるほど、モデルの特徴量が豊富になり、結果も向上します。
OpenSearch のカテゴリ予測機能は、行動データを使用したモデルトレーニングと、行動データを使用しないモデルトレーニングの両方に対応しています。
行動データを使用したモデルトレーニングは、行動データがアップロードされている場合に適用されます。トレーニングを開始する前に、データ量、データ品質、およびデータ整合性が要件を満たしていることを確認するための事前チェックが自動的に実行されます。モデルトレーニングには、以下の手順が含まれます。
過去のクエリとカテゴリ情報を使用してサンプリングを行い、サンプルデータを生成し、行動データを使用してサンプルデータにラベルを付けます。
行動データに対してメトリクス統計や特徴量計算などの操作を実行し、クリック行動特徴量を生成します。
各カテゴリ配下の商品タイトルとクエリを組み合わせ、クエリとタイトルをトークン化し、クエリテキストと商品タイトルテキスト間のセマンティック特徴量を計算します。
トランザクション行動データがアップロードされている場合は、トランザクション行動データに対してメトリクス統計や特徴量計算を実行してトランザクション特徴量を生成し、取引実績の高い商品がより上位にランク付けされるようにします。
上記で生成されたサンプルデータを、行動特徴量、セマンティック特徴量、トランザクション特徴量、およびサンプルデータのラベルと組み合わせてトレーニングデータとし、アルゴリズムに入力して反復トレーニングを実行します。
トレーニングが完了すると、サンプル内のクエリとカテゴリ間の関連性を示すモデルが得られます。このモデルを使用して、クエリとカテゴリの間の関連性を予測できます。
「行動データ」を選択してカテゴリ予測モデルをトレーニングする場合、あるクエリに対して、過去 14 日以内にそのクエリ配下のカテゴリへのクリックが複数回あることが必要です。
行動データを使用しないモデルトレーニングは、行動データがアップロードされていない、または行動データの品質が低いシナリオ向けです。この場合、モデルのトレーニングを開始するには、アプリケーションでカテゴリ ID フィールドと商品タイトルフィールドを指定する必要があります。結果の評価を容易にするために、カテゴリ名フィールドも指定することを推奨します。行動データがない場合、サンプルにラベルを付けるための根拠がないため、別の種類のアルゴリズムを使用してモデルをトレーニングします。このアルゴリズムは、トークン化後のクエリとカテゴリ配下の商品タイトルのテキストデータのみに基づいて、クエリテキストと商品タイトルテキスト間のセマンティックな関連性を計算し、クエリとカテゴリ間の関連性を導き出します。
行動データを使用するモデルは、使用しないモデルよりも優れたパフォーマンスを発揮します。トレーニングの特徴量が豊富であるほど、モデルはクエリとカテゴリ間のデータパターンをより包括的に捉えることができ、予測の精度も高まります。
モデルが行動データを使用するかどうかにかかわらず、トレーニングプロセスでは、さまざまなシナリオのデータを用いた広範な実験と、慎重なパラメータチューニングが行われ、結果が期待値を満たすことを確認しています。
カテゴリ予測の使用方法
前提条件
モデルトレーニングにはデータソースが必要であり、モデルをトレーニングする前にアプリケーションを関連付ける必要があります。アプリケーションデータ、アプリケーションのクエリデータ、およびアプリケーションの行動データはすべて、カテゴリ予測モデルに必要なデータです。
クリック行動データをアップロードしていない場合、トレーニングにクリック行動データを使用したくない場合、またはクリック行動データがまだトレーニング条件を満たしていない場合は、まずクリック行動データなしでモデルをトレーニングできます。この場合、アプリケーションから 3 つのフィールド ([カテゴリ ID]、[商品タイトル]、[カテゴリ名]) のデータを選択する必要があります。カテゴリ ID と商品タイトルは必須で、カテゴリ名はオプションです。モデルトレーニングが完了すると、結果評価のためにモデルの一部の予測結果が出力されます。カテゴリ名は、結果評価ページでクエリとカテゴリ間の関連性が期待どおりかどうかを評価するために使用されるため、トレーニング時にカテゴリ名フィールドを提供することを推奨します。
クリック行動データがアップロードされている場合は、上記のフィールドを選択することに加えて、モデルトレーニング中に行動データを関連付けるオプションを選択することもできます。行動データがトレーニング条件を満たしている限り、そのデータがモデルのトレーニングに使用されます。
手順
アプリケーション配下にカテゴリ予測モデルを [作成] します。
カテゴリ予測モデルを [適用] します。まず、クエリ分析でモデルを適用し、次に基本ソートとビジネスソートでモデルを有効化します。
クエリ分析を作成し、カテゴリ予測を設定し、ステップ 1 で作成したモデルを選択します。
クエリでカテゴリ予測モデルを [有効化] します。SDK を介してクエリ API を呼び出し、
raw_queryパラメータを渡します。
詳細な手順については、「カテゴリ予測機能の使用」をご参照ください。