カテゴリ予測は、トレーニング済みのモデルを使用して検索クエリを商品カテゴリにマッチングし、そのカテゴリの結果をより上位にランク付けします。たとえば、「ランニングシューズ」のようなクエリは「スポーツ > フットウェア」にマッピングされ、関連性のない結果よりもアスレチックシューズが上位に表示されます。「デニム」のようなクエリは「衣料品 > パンツ」にマッピングされ、デニムをテーマにした家庭用品よりもジーンズが上位にランク付けされます。
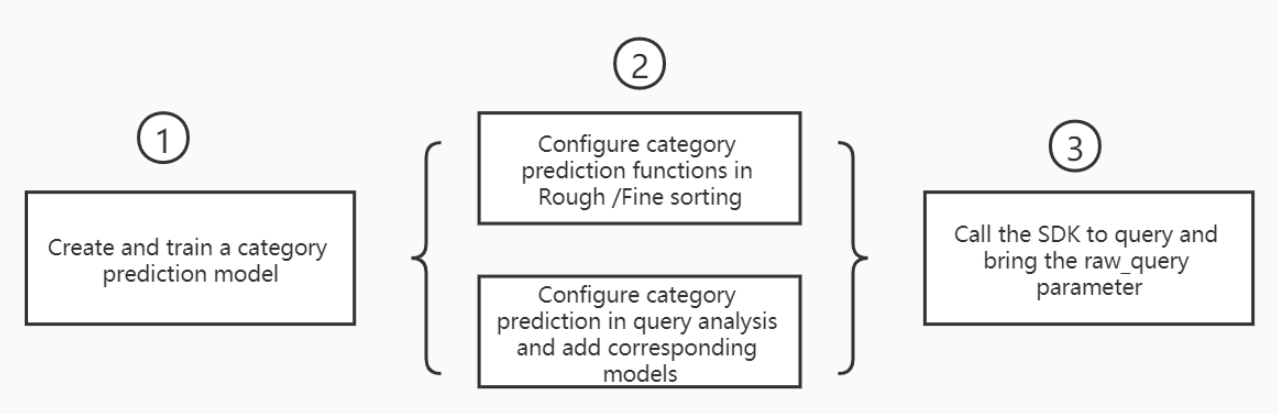
カテゴリ予測を有効にするには、モデルの作成とトレーニング、モデルを参照するクエリ分析ルールの設定、category_score を呼び出すソート式の追加という 3 つの設定を完了する必要があります。
前提条件
開始する前に、以下を確認してください。
-
アプリケーションスキーマで、カテゴリ ID、商品タイトル、カテゴリ名のフィールドが属性フィールドとして設定されていること
-
(商品データを使用する場合) カテゴリ ID、商品タイトル、カテゴリ名のフィールドを含むドキュメントデータがあること
-
(行動データを使用する場合) データ収集 によって収集されたクリック行動データがあること
カテゴリ予測モデルの作成とトレーニング
-
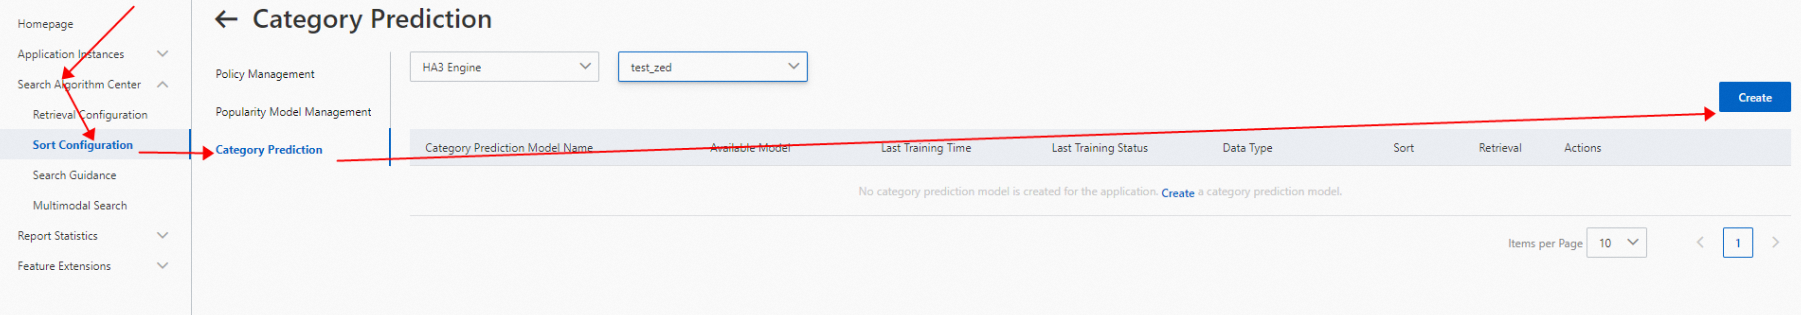
左側メニューで、[検索アルゴリズムセンター] > [ソート設定] を選択します。ナビゲーションツリーで [カテゴリ予測モデル] をクリックし、次に [作成] をクリックします。
-
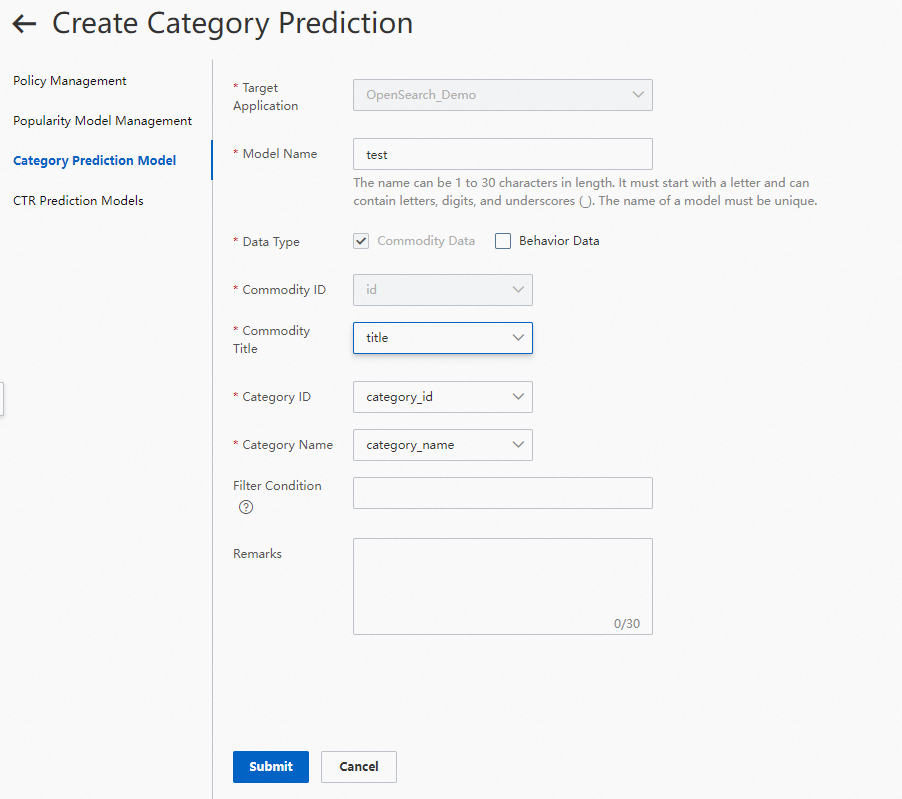
[カテゴリ予測の作成] ページで、モデルの詳細を入力します。
フィールド
説明
必須
モデル名
モデルの名前
はい
[データタイプ]
[商品データ] :アプリケーションのドキュメントデータ。カテゴリ ID、商品タイトル、カテゴリ名のフィールドが必要です。[行動データ] :収集されたクリック行動データ。
はい
[カテゴリ ID]
アプリケーションドキュメント内のカテゴリ ID を表すフィールド。INT データ型をサポートします。正の整数である必要があります。正でない値を指定すると、サーバーエラーが発生します。
はい
[商品タイトル]
商品タイトルを表すフィールド。TEXT および LITERAL データ型をサポートします。
はい
[カテゴリ名]
カテゴリ名を表すフィールド。TEXT および LITERAL データ型をサポートします。
はい
[フィルタリング条件]
トレーニングデータをフィルタリングするための条件。フィールド名は、アプリケーションスキーマ内のフィールド名と一致する必要があります。サポートされている演算子:
<、>、<=、>=、=、!=。複数の条件はカンマ (,) で区切ります。すべての条件は AND ロジックを使用します。OR ロジックはサポートされていません。例:is_onsale > 0いいえ
-
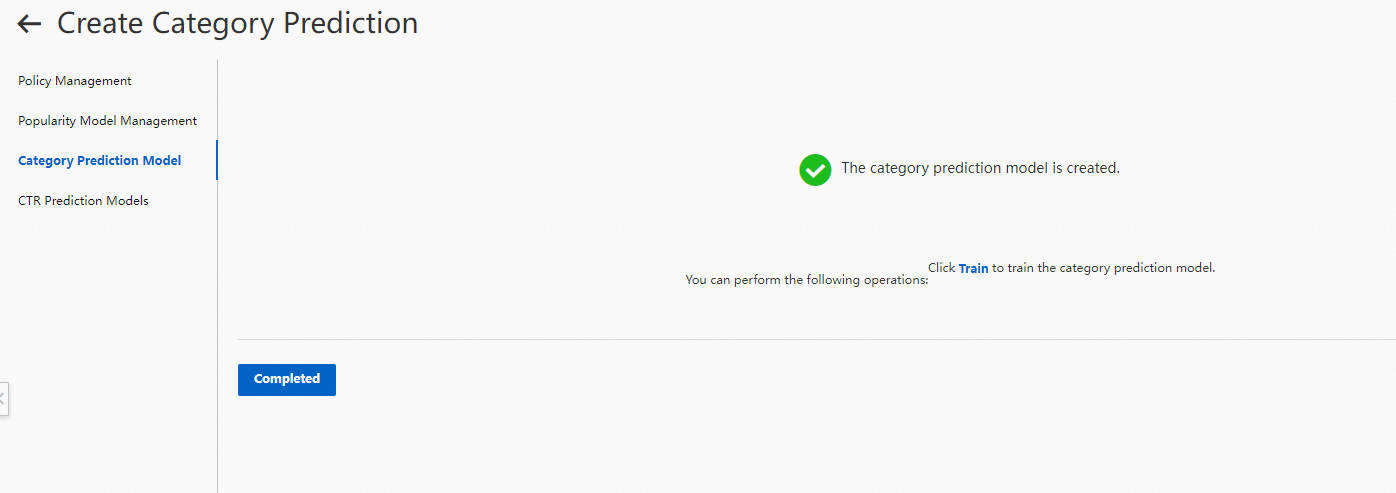
[完了] をクリックして、モデル詳細ページに移動します。
-
[カテゴリ予測モデル] ページで、モデルのステータスは [トレーニング待ち] です。[操作] 列の [トレーニング] をクリックして、トレーニングを開始します。
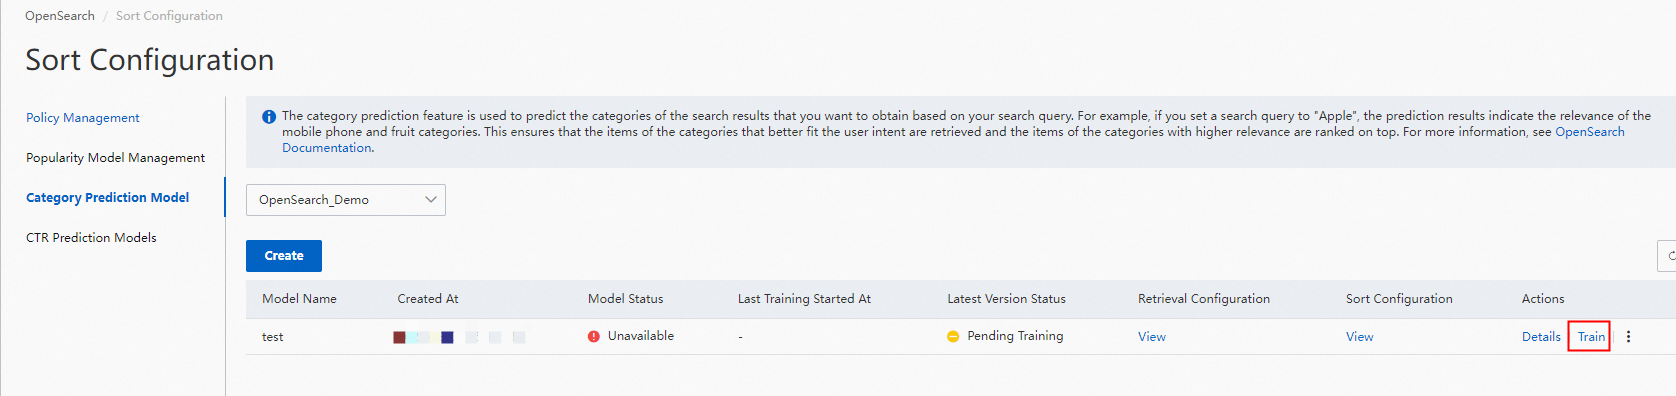
モデルは次の状態に遷移します。
状態
意味
トレーニング待ち
モデルは作成されましたが、トレーニングは開始されていません
トレーニング中
モデルはトレーニング中です
トレーニング失敗
データエラーによりトレーニングが失敗しました
未適用
トレーニングは完了しましたが、まだ検索やソートで参照されていません
トレーニング済みで未合格
トレーニングは完了しましたが、モデルはトレーニングの基準を満たしませんでした
ご不明な点がある場合は、チケットを送信してください。
クエリ分析とソート式の設定
クエリ分析ルールの作成
-
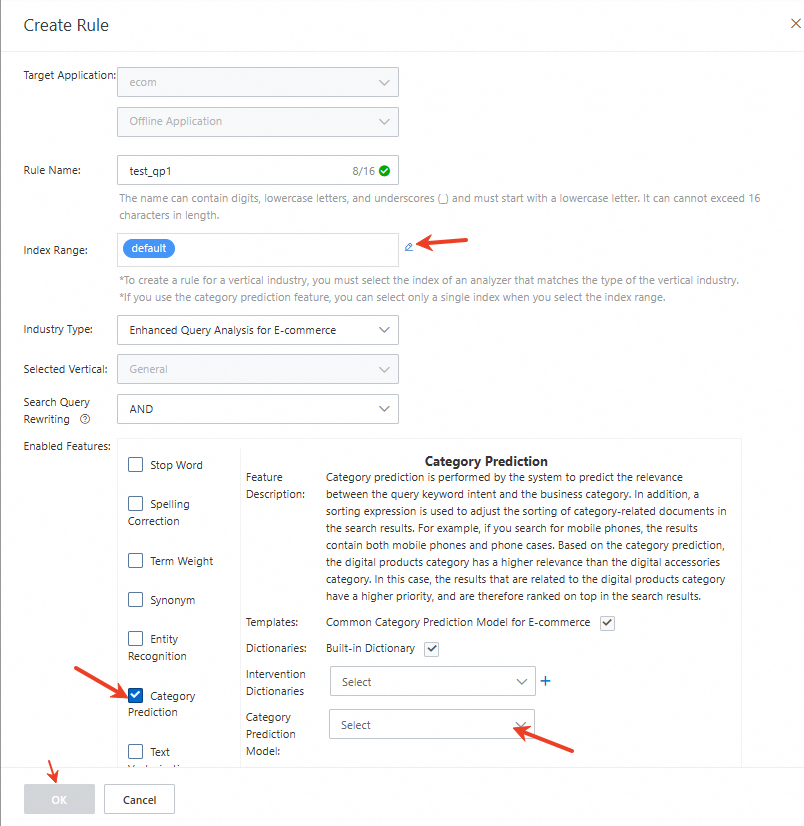
左側メニューで、[検索アルゴリズムセンター] > [取得設定] を選択します。ナビゲーションツリーで [クエリ分析ルール設定] をクリックし、次に [作成] をクリックします。

-
クエリ分析ルールを設定し、保存します。
モデルの基本ソートへの適用
基本ソートは、ランキングの最初の段階です。
-
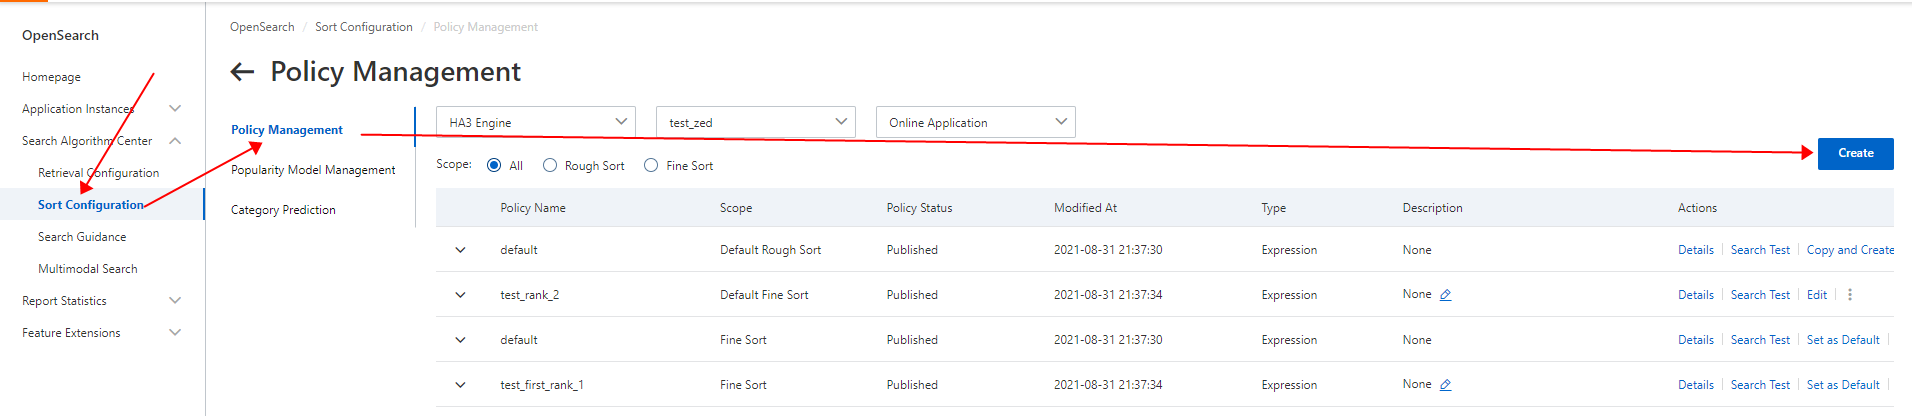
左側メニューで、[検索アルゴリズムセンター] > [ソート設定] を選択します。[ポリシー管理] ページで、[作成] をクリックします。
-
[ポリシーの作成] ページで、ポリシー名を入力します。[範囲] を [基本ソート] に、[タイプ] を [式] に設定します。コンソールでは式のみがサポートされています。カスタムプラグインは今後サポートされる予定です。

-
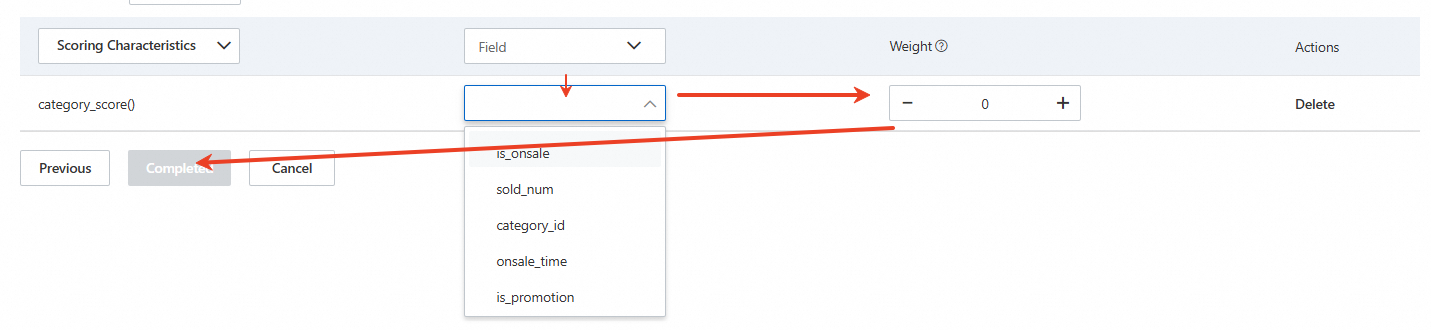
[ソート設定] ステップで、[スコアリング特性] ドロップダウンリストから
category_score()を選択します。
-
フィールドを選択し、重みを設定して、設定を保存します。
モデルの高度ソートへの適用
高度ソートは、ランキングの第 2 段階です。
-
[ポリシーの作成] ページで、ポリシー名を入力します。[範囲] を [高度ソート] に、[タイプ] を [式] に設定します。コンソールでは式のみがサポートされています。カスタムプラグインは今後サポートされる予定です。

-
[ソート設定] ステップで、[組み込み関数] ドロップダウンリストから
category_score(cate_id_field)を選択します。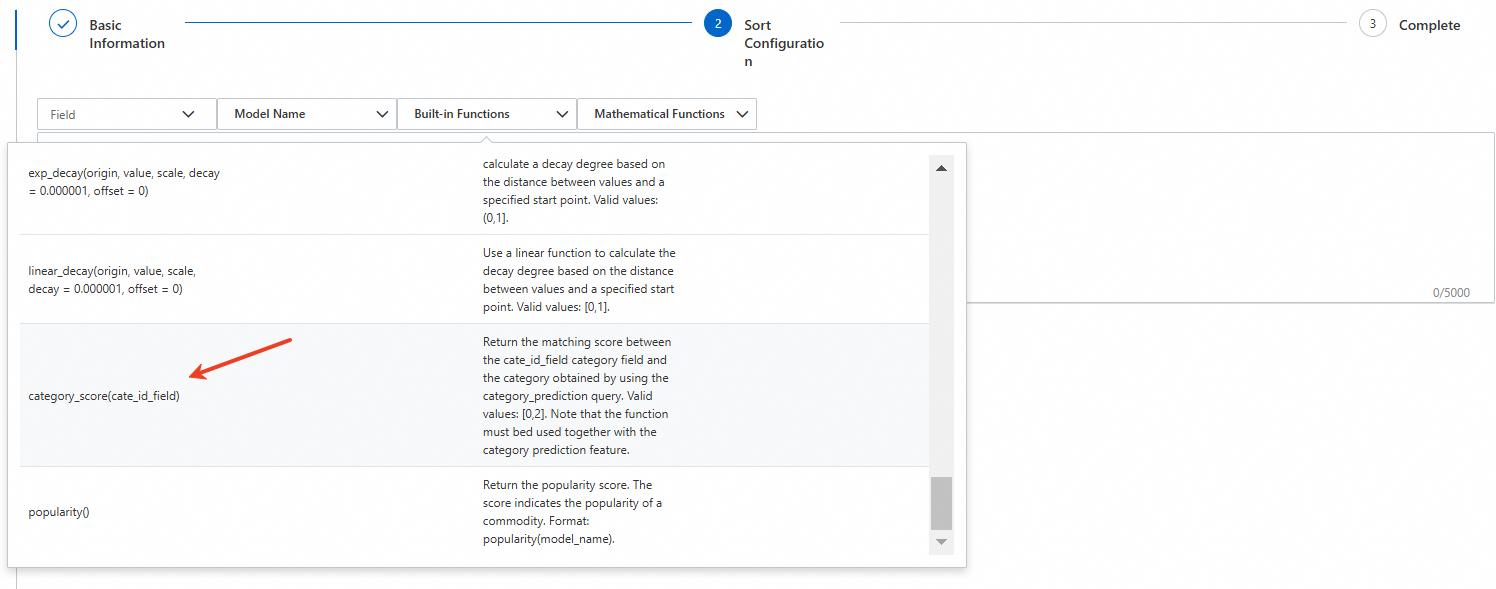
-
cate_id_fieldをモデルのカテゴリ ID フィールドに置き換え、設定を保存します。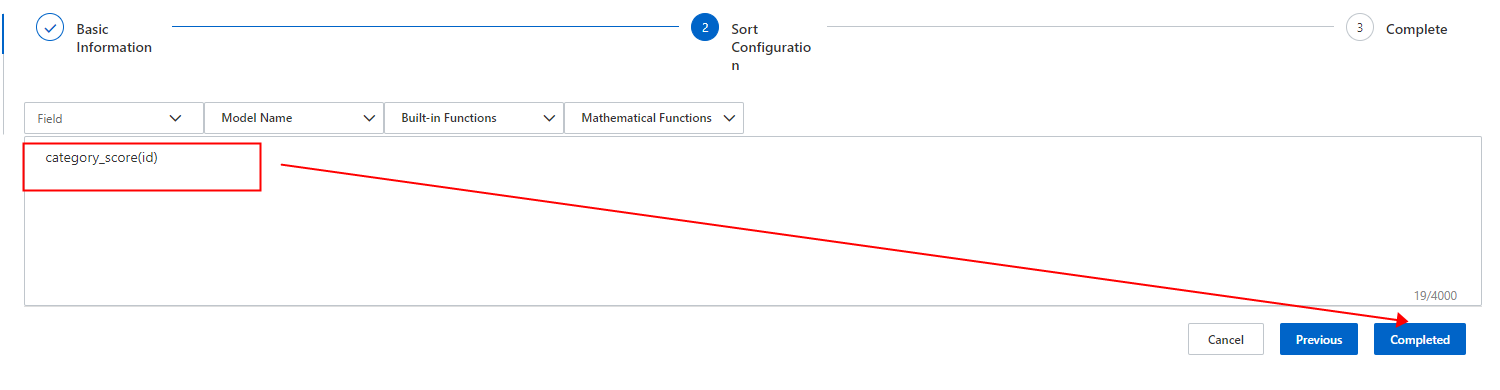
-
ソートポリシーによって参照された後、モデルのステータスを確認します。
-
アプリケーションで検索テストを実行します。
raw_queryパラメーターに検索クエリを設定して、カテゴリ予測の結果をテストします。
API および SDK 呼び出しにおけるカテゴリ予測の有効化
カテゴリ予測は、raw_query パラメーターが存在し、その値がインデックス内の検索クエリと一致する場合にのみ、検索結果をソートします。
raw_query に、ユーザーが入力した検索クエリを設定します。
raw_query=<search_query>-
API 経由で呼び出す場合:
URL_ENCODEを使用して値を URL エンコードします。 -
SDK 経由で呼び出す場合: エンコードは不要です。
カテゴリ予測が有効になるタイミング
以下の表は、インデックス設定と raw_query の値に基づいて、カテゴリ予測がいつ適用されるかを示しています。
|
インデックス設定 |
リクエスト内の |
|
カテゴリ予測は適用されるか? |
|
無効 |
はい |
— |
いいえ |
|
無効 |
いいえ |
— |
いいえ |
|
有効 |
いいえ |
— |
いいえ |
|
有効 |
はい |
いいえ |
いいえ |
|
有効 |
はい |
はい |
はい |
複数インデックスの動作: リクエストが複数のインデックスを対象とする場合、カテゴリ予測は上記のルールに基づいてインデックスごとに適用されます。
# raw_query が index3 に対するクエリと一致するため、index3 の予測が有効になります
query=index2:'index_query' AND index3:'search_query'&raw_query=search_query

# index2 の予測が優先的に有効になります。
# index2 の設定が適用されない場合、index3 が有効になります
query=index2:'search_query' AND index3:'search_query'&raw_query=search_query
制限
-
アプリケーションごとに最大 5 つのカテゴリ予測モデルを作成できます。
-
モデルのトレーニングに使用されるデータフィールドは、クエリ分析ルールが適用されるインデックスに含まれている必要があります。
-
モデルを作成する前に、カテゴリ ID と関連フィールドを属性フィールドとして設定してください。
-
クエリ分析ルールがカテゴリ予測モデルを参照し、リクエストに
category_predictionパラメーターが含まれている場合、エラーが発生します。 -
カテゴリ予測を有効にするには、モデルを参照するクエリ分析ルール、
category_score関数を含むソート式、リクエスト内のraw_queryパラメーターの 3 つすべてを設定する必要があります。 -
関連 API: Algorithms
モデルトレーニング失敗時のトラブルシューティング
カテゴリ予測モデルのトレーニングが失敗した場合は、次の手順に従ってトラブルシューティングを行ってください。
-
異常レポートの確認:モデル詳細ページで、[最新バージョンのステータス] を確認します。ステータスにデータエラーが表示されている場合は、[異常レポート] を開いて失敗の原因を特定します。
-
完全性レベルの確認:[完全性レベル] と対応する [アップグレード条件] を確認します。アップグレード条件に従ってデータを調整し、完全性レベルを向上させます。
-
T-1 データロジック:モデルトレーニングでは、前日 (T-1) の統計データが使用されます。新しく作成されたモデルを初めてトレーニングする場合、前日のデータが利用できないため、"Training field does not exist" というエラーが発生し、トレーニングが失敗することがあります。データが準備される翌日まで待ってから、モデルを再トレーニングしてください。
-
データ量要件:トレーニングには、直近 1 日のユニークなクエリ数が 100 を超える必要があります。ユニークなクエリ数とは、
raw_queryパラメーターを含む成功した検索リクエストの数を指します。 -
フィルタリング条件の形式:フィルタリング条件が設定されている場合、フィールド名はアプリケーションスキーマのフィールドと一致する必要があります。複数の条件は AND ロジックを使用し、カンマ (
,) で区切る必要があります。形式が正しくないと、トレーニングが失敗する可能性があります。例:is_onsale > 0。
高度な使用方法
固有表現抽出 (NER) との組み合わせ
クエリ分析ルールでカテゴリ予測と並行して NER を設定すると、より多くのドキュメントが取得されます。NER の結果も取得に使用されます。予測されたカテゴリに一致するドキュメントがない場合、検索クエリ内の単語が選択的に無視されて結果が拡張されます。この拡張された結果が、最終的なカテゴリ予測の出力となります。詳細については、「固有表現抽出 (NER)」をご参照ください。
予測結果への介入
介入により、クエリ分析の介入と同様に、トレーニング済みモデルの予測を上書きできます。詳細については、「カテゴリ予測の介入ディクショナリ」をご参照ください。