Wan を使用して 画像生成 を行う際、 Text-to-Video/Image-to-Video プロンプトガイド だけでは 特定のスタイル、IP キャラクター、または視覚効果 に関するカスタマイズのニーズを満たせない場合は、 モデルのファインチューニング を使用します。
適用範囲
-
サポートされるリージョン:このドキュメントは、シンガポールリージョンにのみ適用されます。このリージョンの API キーを使用する必要があります。
-
サポートされるファインチューニング手法:SFT-LoRA 効率的ファインチューニング。
-
サポートされるモデル:
- 画像生成 (Text-to-Image/Image-to-Image):wan2.7-image-pro、wan2.7-image。
モデルのファインチューニング方法
Text-to-Image
ファインチューニングの目的:キャラクター LoRA モデルのトレーニング。
期待される結果:テキストプロンプトが与えられると、モデルはプロンプトで説明されたシーンに特定のキャラクターの画像を生成します。
| 入力プロンプト 朝のラッシュアワーの混雑した地下鉄の車両内で、手すりにつかまっている人物。背景にはぼやけた乗客、窓からはトンネルの照明が見える。普通のサラリーマンが着るような白いシャツと黒いズボンを着用し、カメラに向かって立っている。半身ショットで、リアルなスナップ写真風。 | 出力画像 (ファインチューニング前 - Text-to-Image)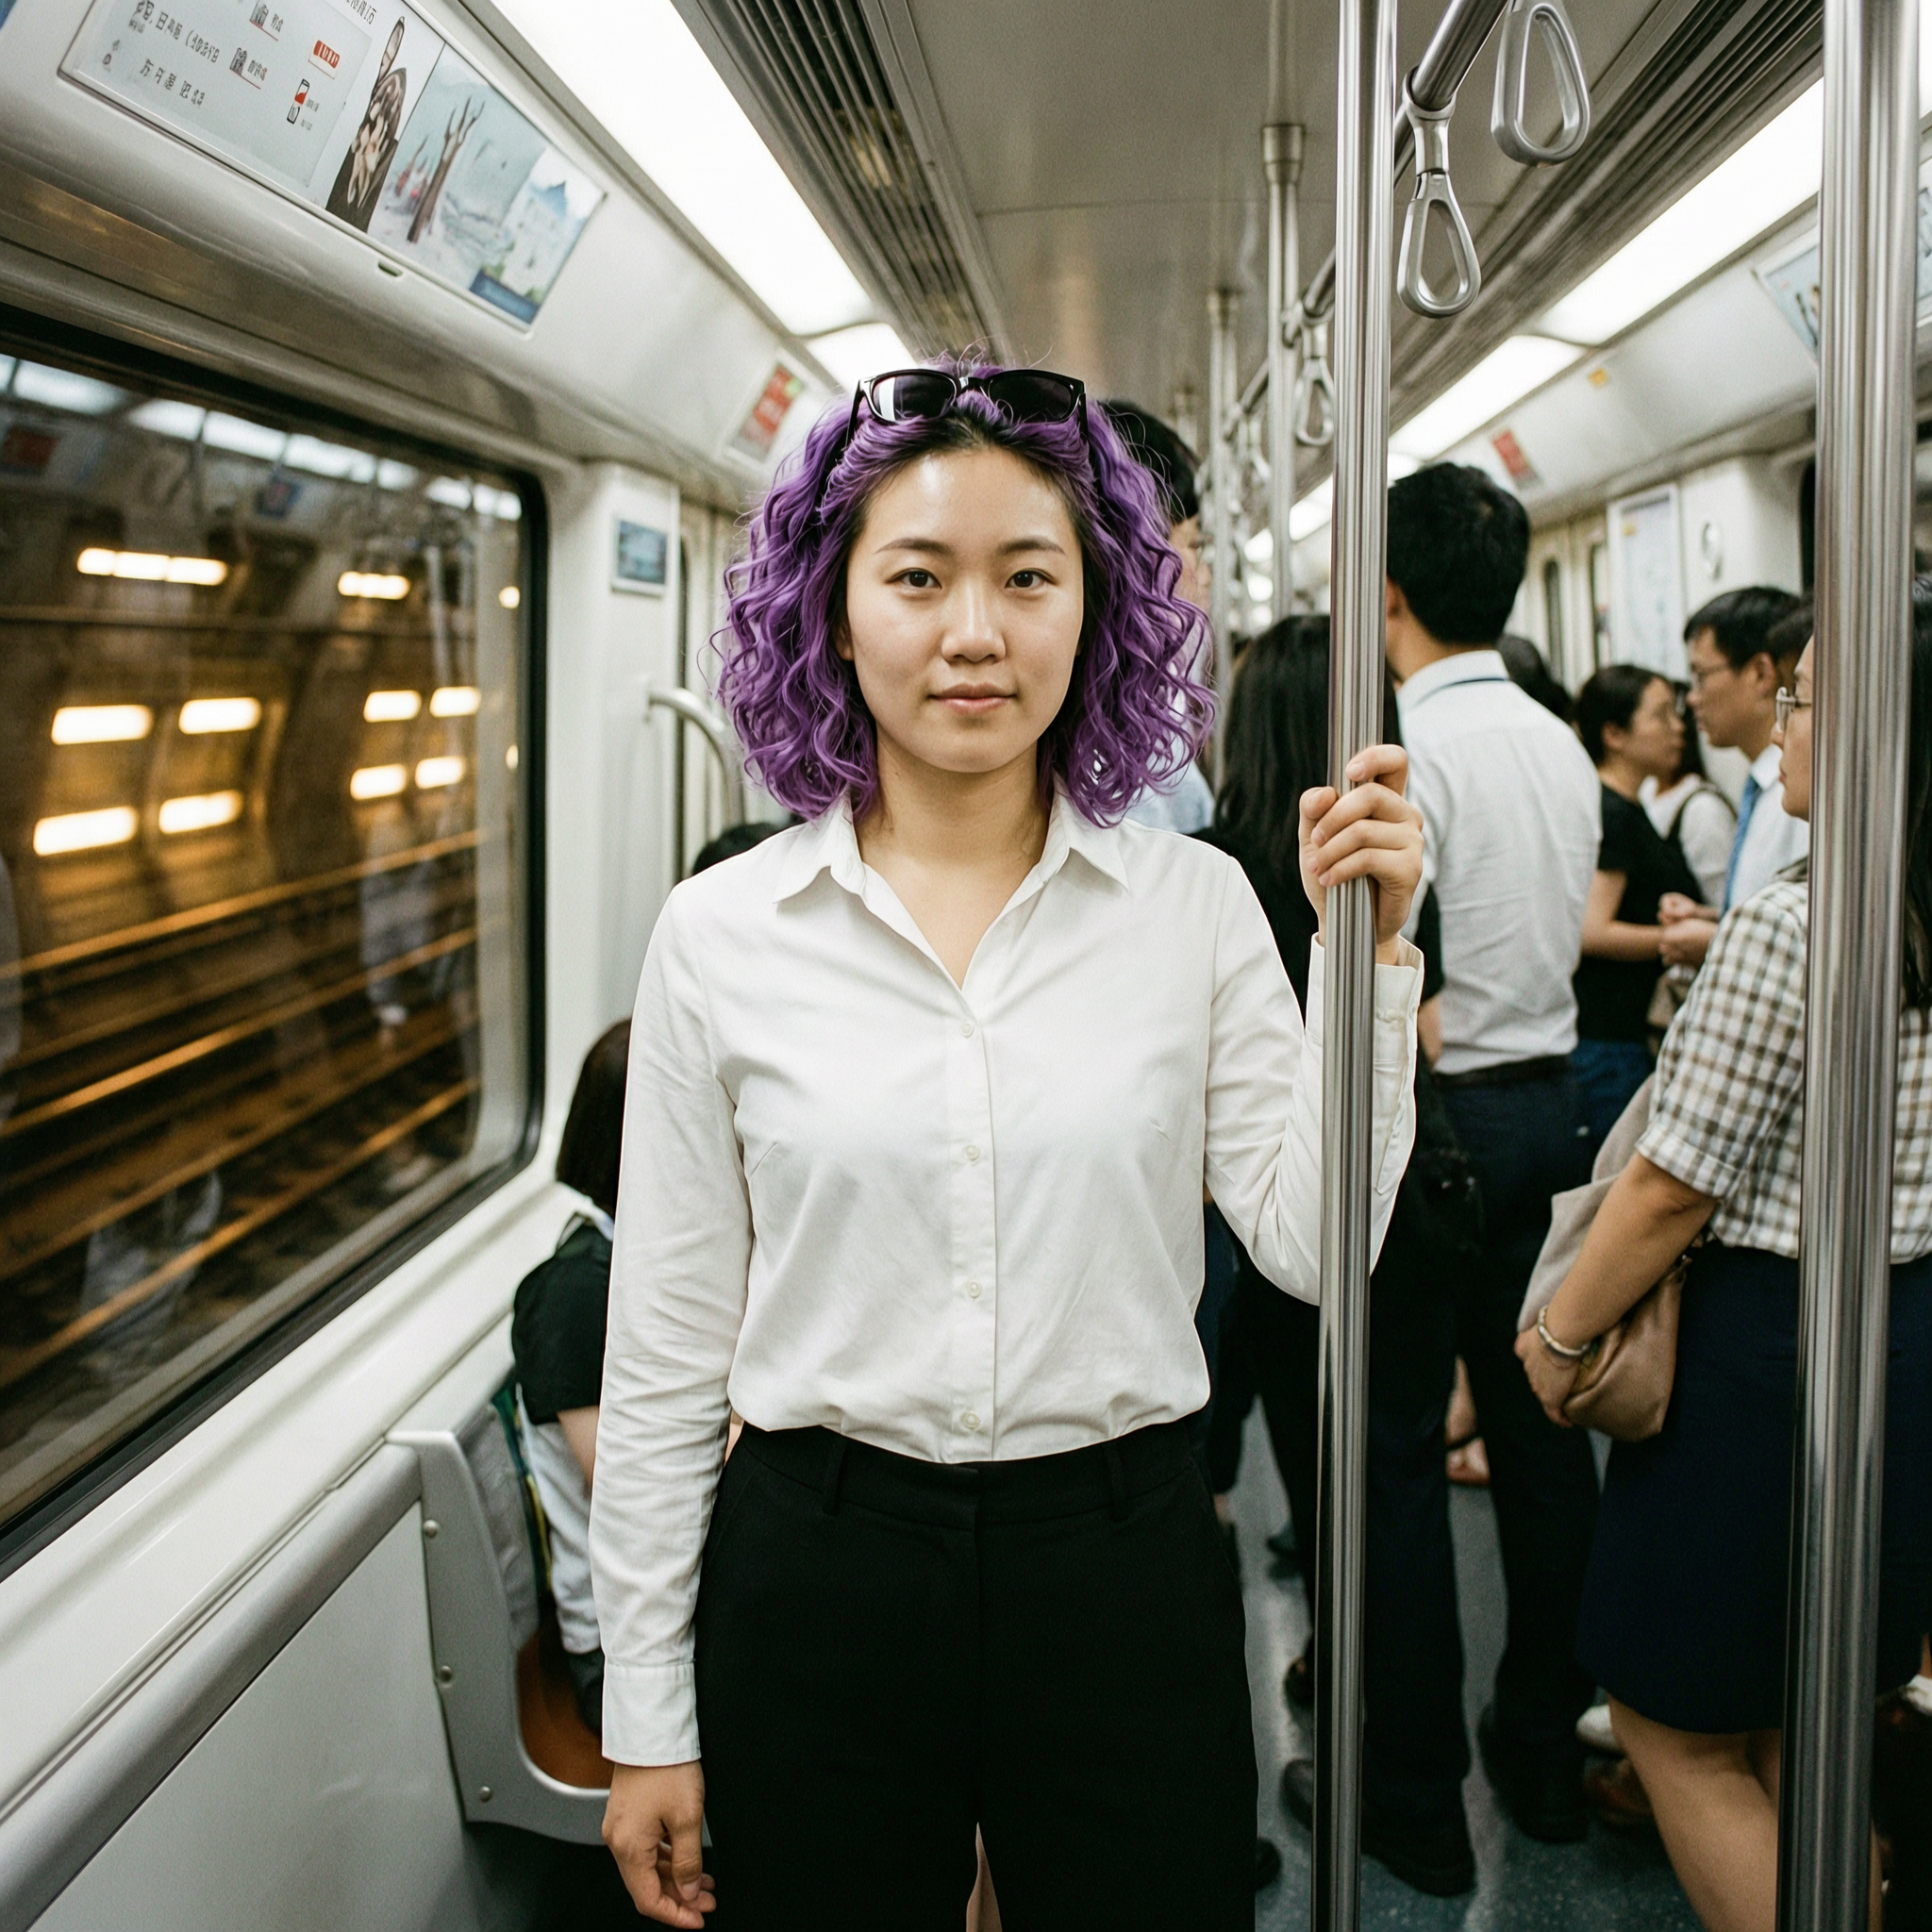
| 出力画像 (ファインチューニング後)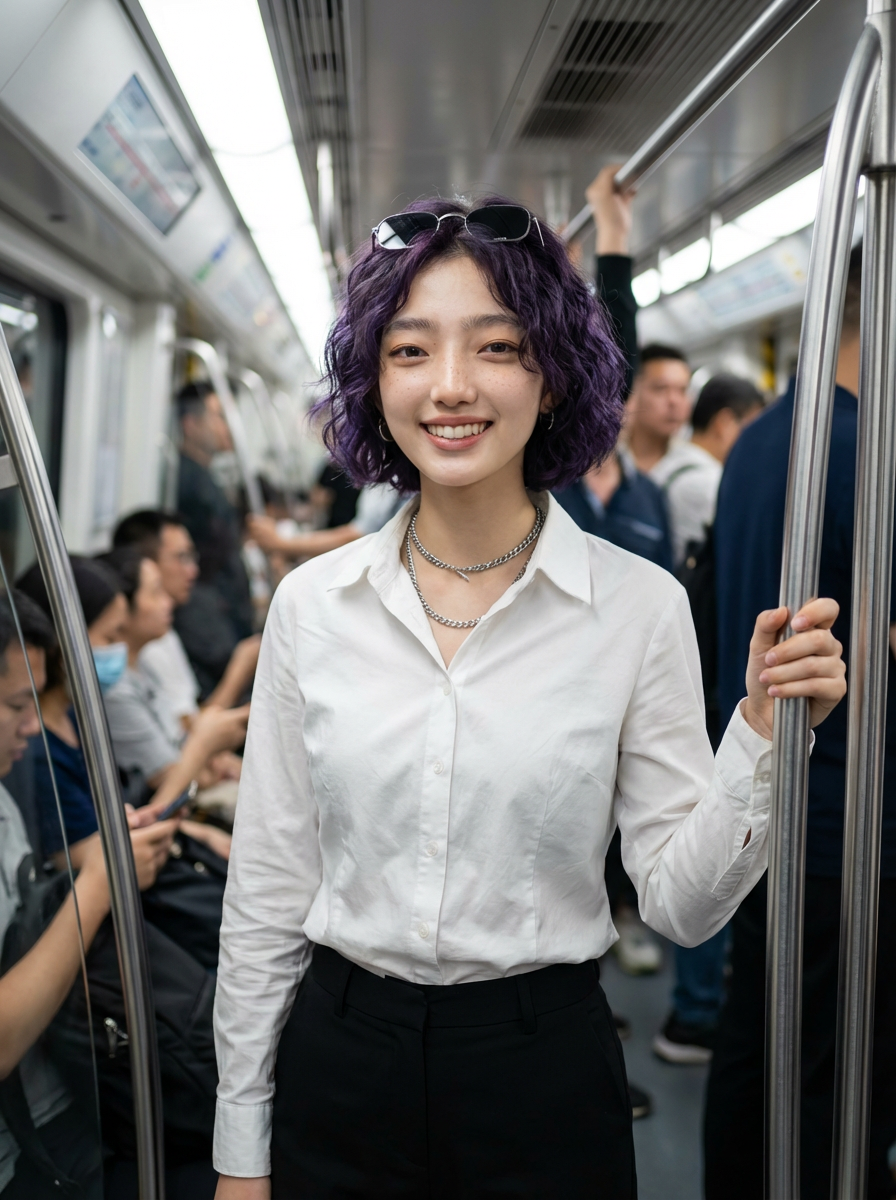
|
Image-to-Image
ファインチューニングの目的:「終末世界の赤黒メカアーマー」の LoRA モデルのトレーニング。
期待される結果:キャラクター画像が与えられると、モデルはテキストプロンプトを必要とせずに、キャラクターの「終末世界の赤黒メカアーマー」風のバージョンを生成します。
入力画像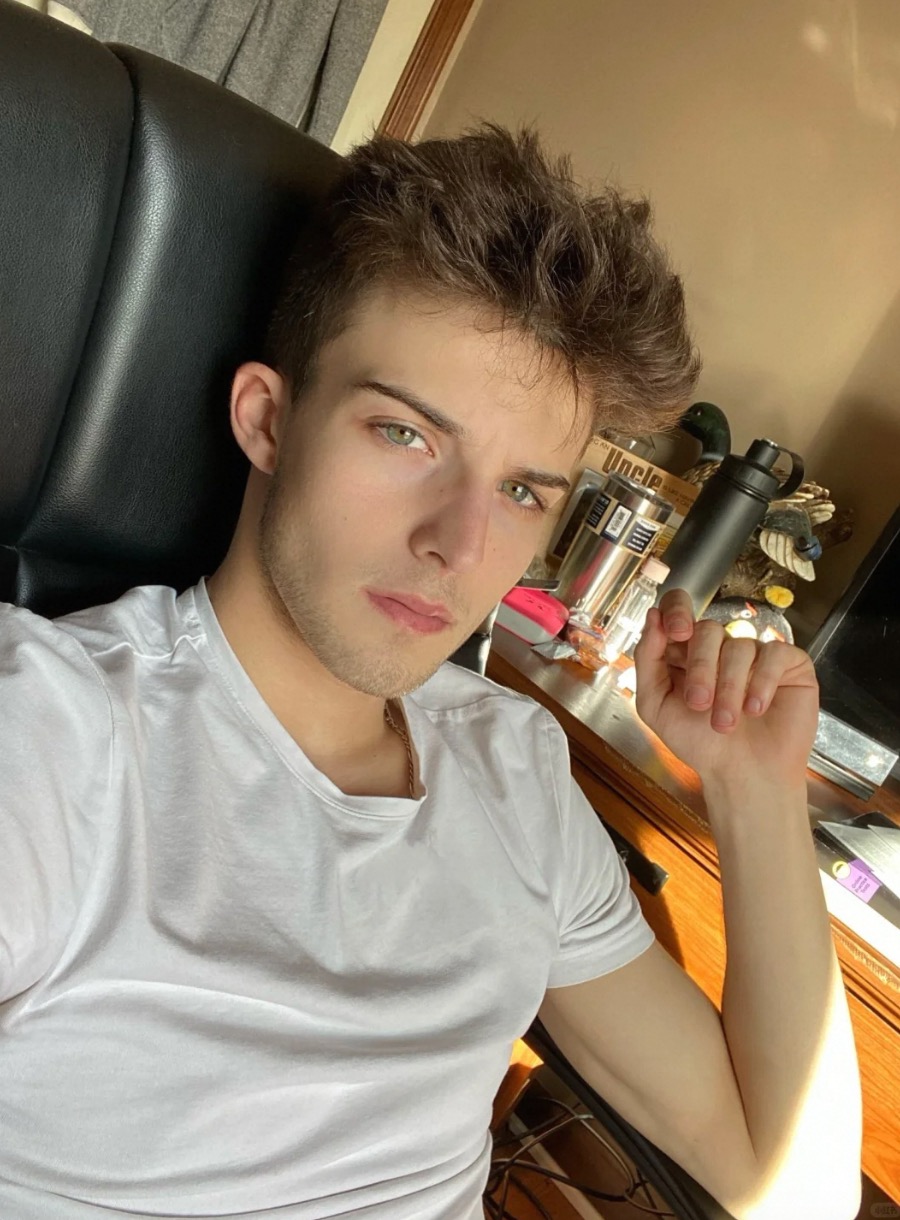 | 出力画像 (ファインチューニング前)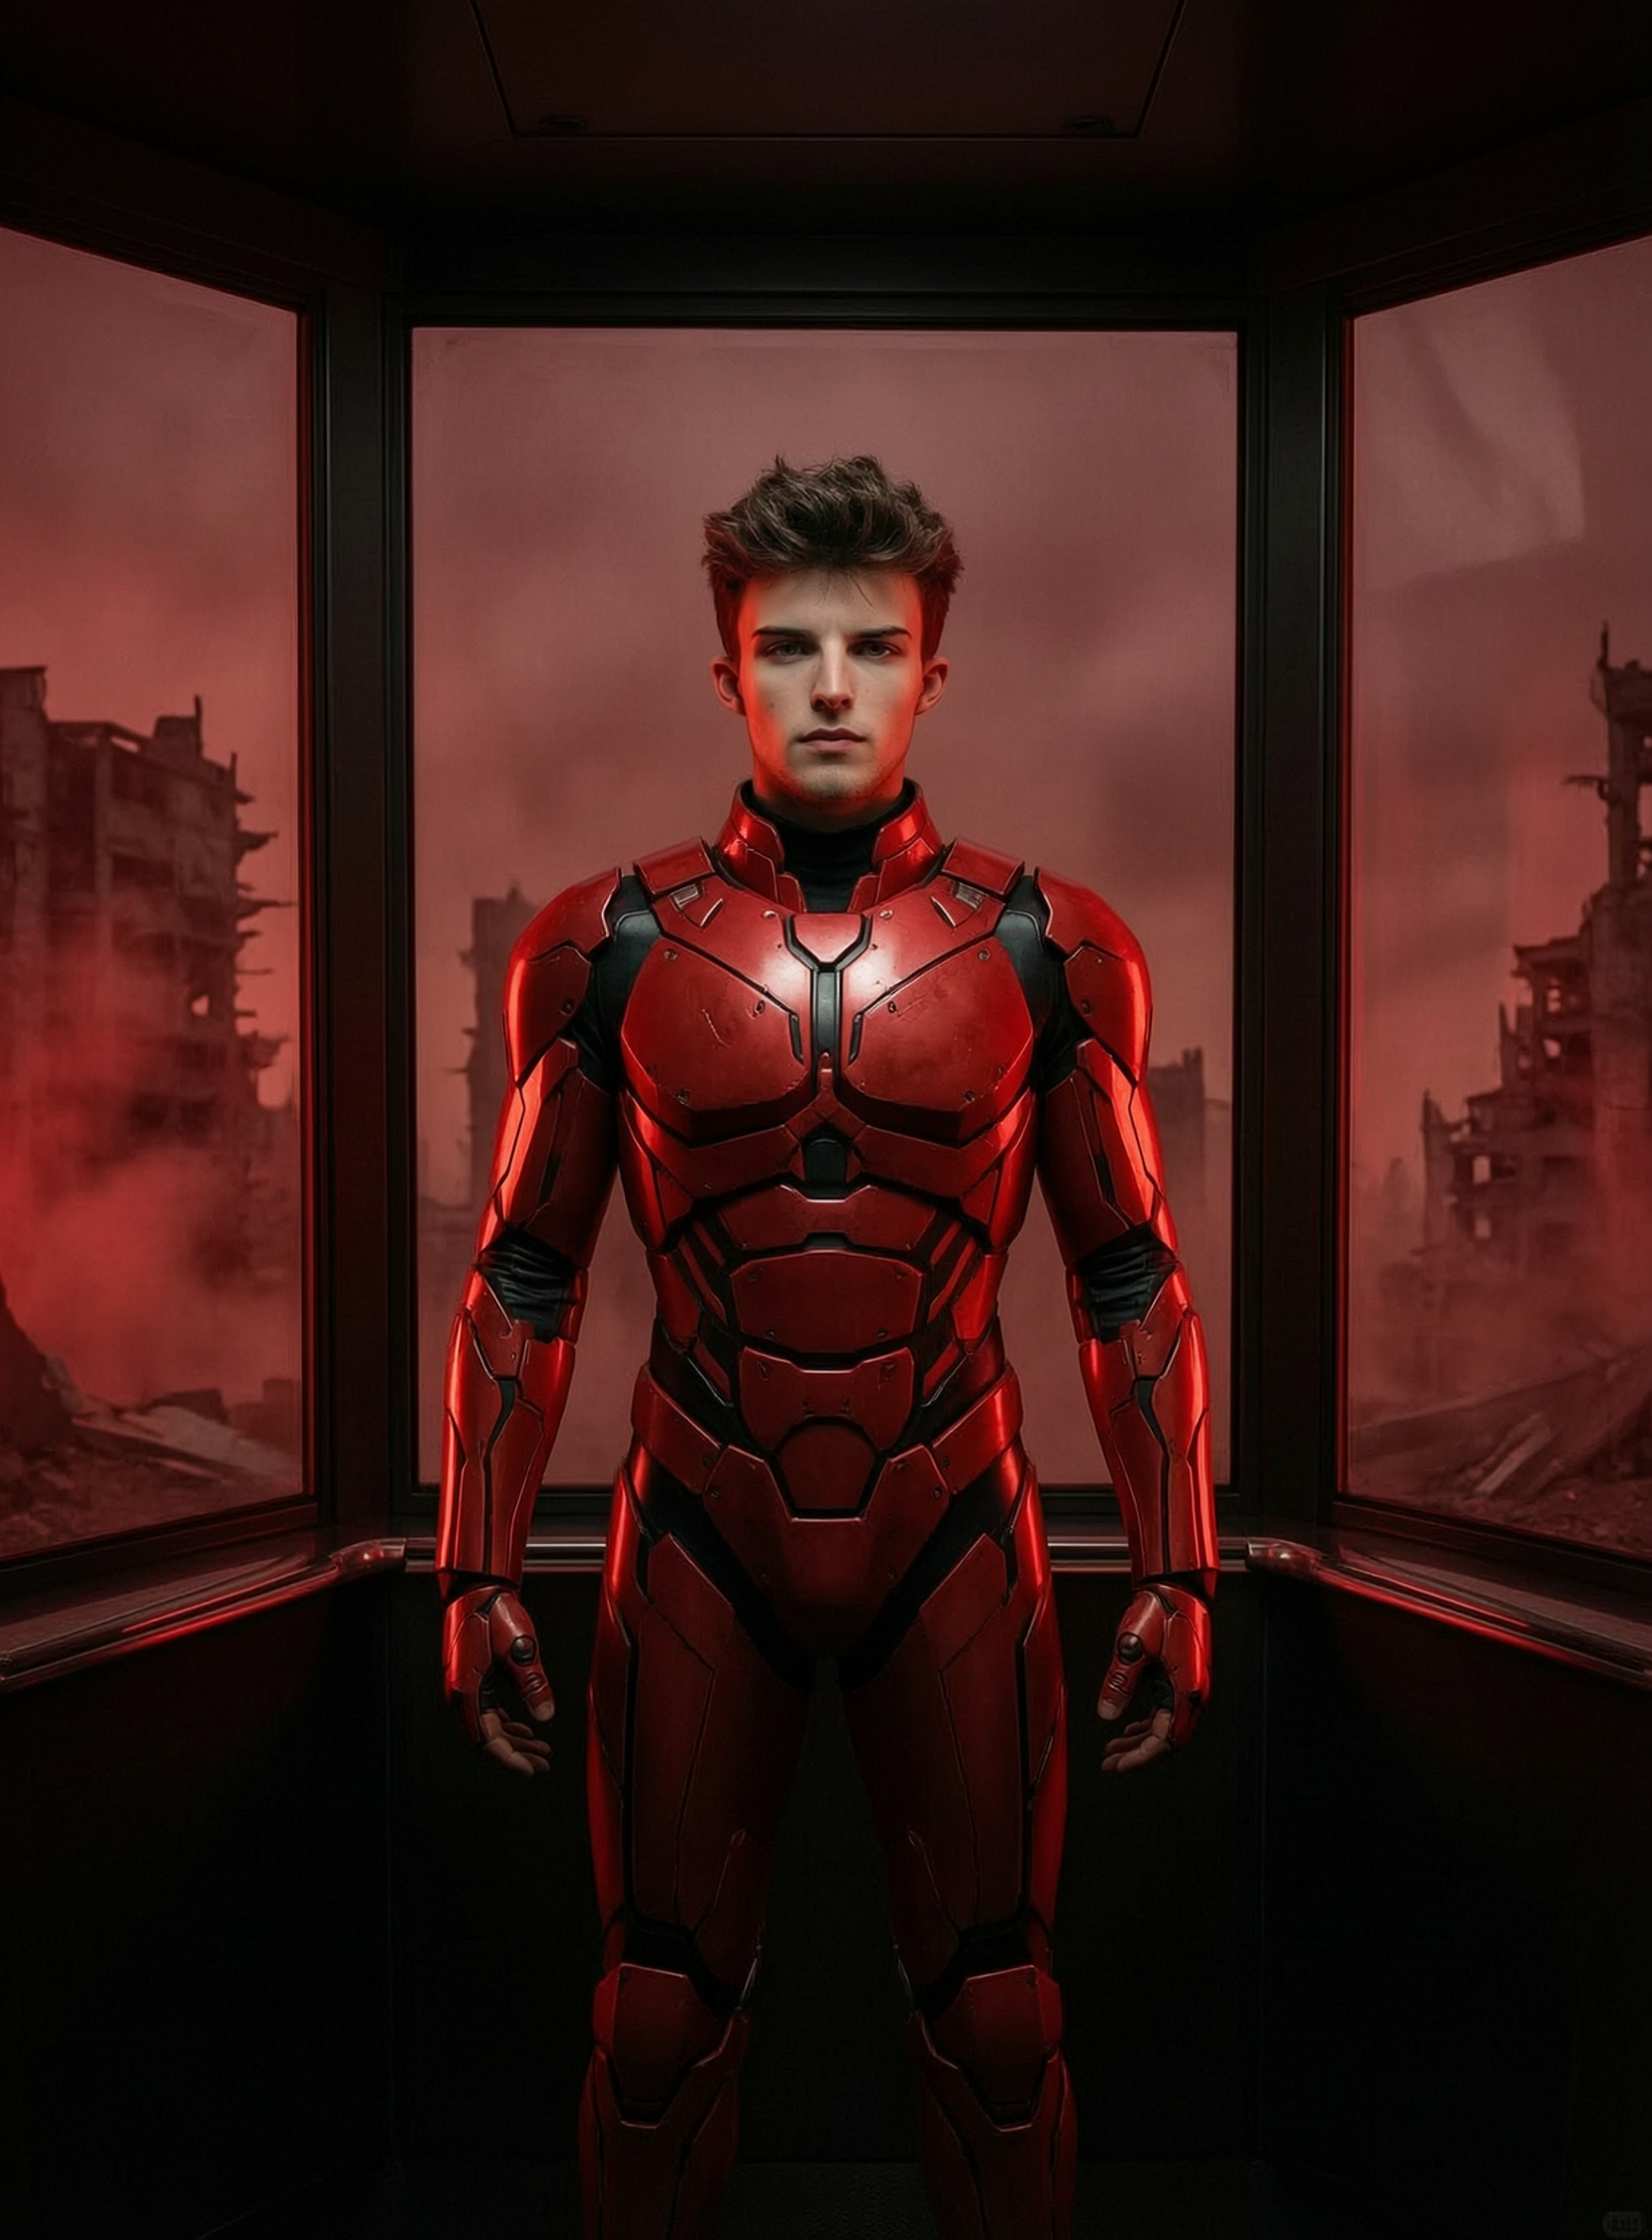
| 出力画像 (ファインチューニング後)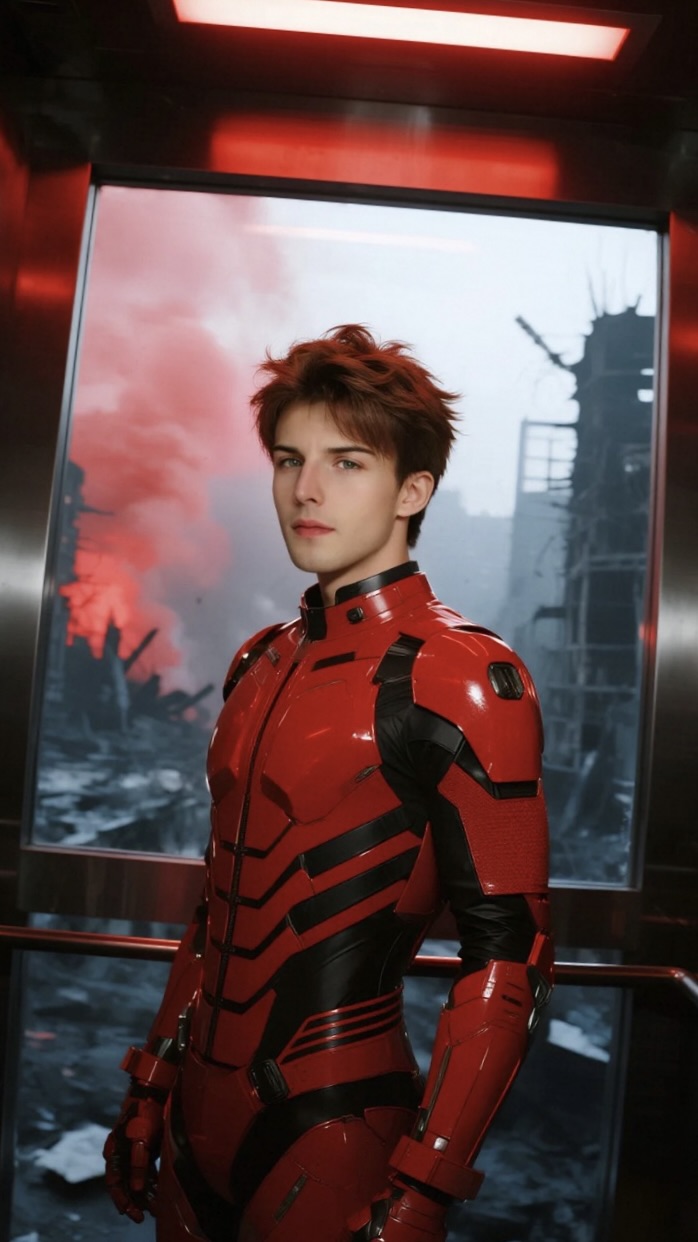
|
以下のコードを実行する前に、API キーの取得とAPI キーを環境変数として設定を行ってください。
ステップ 1:データセットのアップロード
ローカルのデータセット (.zip 形式) を Alibaba Cloud Model Studio プラットフォームにアップロードし、ファイル ID (id) を取得します。
サンプル トレーニングデータ:フォーマットについては、「トレーニングセット」をご参照ください。
- 画像生成 - Text-to-Image:wan-image-t2i-training-dataset.zip
- 画像生成 - Image-to-Image:wan-image-i2i-training-dataset.zip
この例では Text-to-Image を使用し、トレーニングセットのみをアップロードします。システムはトレーニングセットの一部を自動的に分割し、検証セットとして使用します。
curl --location --request POST 'https://dashscope-intl.aliyuncs.com/compatible-mode/v1/files' \
--header "Authorization: Bearer $DASHSCOPE_API_KEY" \
--form 'file=@"./wan-image-t2i-training-dataset.zip"' \
--form 'purpose="fine-tune"'
id を保存します。これはアップロードされたデータセットの一意の識別子です。
{
    "id": "file-ft-3c67043a747c-xxxxxx",
    "object": "file",
    "bytes": 73310369,
    "filename": "wan-image-t2i-training-dataset.zip",
    "purpose": "fine-tune",
    "status": "processed",
    "created_at": 1782271893
}
ステップ 2:モデルのファインチューニング
ステップ 2.1:ファインチューニングジョブの作成
ステップ 1 で取得したファイル ID を使用して、トレーニングジョブを開始します。
リクエスト例<replace_with_training_dataset_file_id> を、前のステップで取得した id に置き換えます。完全なパラメーターリファレンスとフォーマット制約については、「ハイパーパラメーター」をご参照ください。
ハイパーパラメーター
パラメーター | タイプ | 必須 | 説明 | 推奨値 |
|---|---|---|---|---|
max_steps | int | はい | 総トレーニングステップ数。トレーニングの総反復回数を決定するコアパラメーターです。モデルの収束を確保するために少なくとも 500 ステップを推奨し、データセットが大きい場合はより大きな値を推奨します。 | 800 |
eval_steps | int | はい | 検証間隔。値は 0 以上である必要があります。トレーニング中にモデルを評価する頻度 (ステップ単位) を指定します。各間隔でチェックポイントも保存されます。 | 200 |
learning_rate | float | はい | 学習率。モデルの重み更新の大きさを制御します。値が大きすぎるとモデルの性能が低下する可能性があり、小さすぎると変化が微々たるものになる可能性があります。デフォルト値の使用を推奨します。 | 3e-5 |
generation_type | string | はい | 生成モード。Text-to-Image には | t2i |
max_pixels | string | はい | トレーニング画像の最大解像度。例:「1k」または「2k」(1K = 1024×1024, 2K = 2048×2048)。トレーニングセット内の画像の総ピクセル数 (幅 × 高さ) の上限を設定します。システムはこの値を超える画像のみを縮小し、上限以下の画像は変更されません。3つの解像度関連パラメーター ( | Text-to-Image: "2k" |
val_img_size | string | はい | 検証画像の生成解像度。例:「1k」または「2k」(1K = 1024×1024, 2K = 2048×2048)。検証評価中に生成される画像の目標解像度。 | Text-to-Image: "2k" |
max_token_length | string | はい | ステップごとの最大トークン長。例:「1k」または「2k」。このパラメーターは | Text-to-Image: "2k" |
gradient_clip | float | はい | 勾配クリッピング。すべてのトレーニング可能なパラメーターにわたるグローバル勾配ノルムクリッピングのしきい値で、勾配爆発を防ぐために使用されます。クリッピングを無効にするには -1 に設定します。 | 0.5 |
weight_decay | float | はい | 重み減衰。AdamW オプティマイザーの分離された重み減衰係数です。すべてのトレーニング可能なパラメーターに適用され、過学習を防ぐための正則化に使用されます。 | 0.02 |
lora_rank | int | はい | LoRA ランク。LoRA の低ランク行列のランク (次元)。この値は、ファインチューニングのためのトレーニング可能なパラメーターの数を決定します。値が大きいほどモデルのフィット能力は向上しますが、トレーニングは遅くなります。値は 2 のべき乗 (例:16, 32, 64) である必要があります。 | 32 |
save_total_limit | int | いいえ | チェックポイント保存上限。保存するモデルチェックポイントの最大数。システムは、この値である N 個の最新のチェックポイントのみを保持します。 | 10 |
split | float | いいえ | トレーニングセットの分割比率。値の範囲は (0, 1) です。このパラメーターは | 0.9 |
curl --location 'https://dashscope-intl.aliyuncs.com/api/v1/fine-tunes' \
--header "Authorization: Bearer $DASHSCOPE_API_KEY" \
--header 'Content-Type: application/json' \
--data '{
    "model": "wan2.7-image-pro",
    "training_datasets": [
        {
            "data_source_type": "file_id",
            "file_id": "<replace_with_training_dataset_file_id>"
        }
    ],
    "training_type": "efficient_sft",
    "hyper_parameters": {
        "learning_rate": 3e-5,
        "max_steps": 800,
        "eval_steps": 200,
        "max_token_length": "1k",
        "gradient_clip": 0.5,
        "weight_decay": 0.02,
        "max_pixels": "1k",
        "val_img_size": "1k",
        "generation_type": "t2i",
        "lora_rank": 32,
        "save_total_limit": 10
    }
}'
注記トレーニング時間の目安:
- Text-to-Image (t2i):300 ステップで約 77 分。
- Image-to-Image (i2i):300 ステップで約 110 分。
output フィールドの 3 つの主要なパラメーターに注意してください:
job_id:ジョブ ID。進捗状況のクエリに使用されます。finetuned_output:ファインチューニング済みモデルの名前。後続のデプロイと呼び出しにはこの名前を使用する必要があります。status:トレーニングステータス。ファインチューニングジョブを作成した後、初期ステータスは PENDING であり、トレーニングがまだ開始されていないことを示します。
{
    ...
    "output": {
        "job_id": "ft-202511111122-xxxx",
        "status": "PENDING",
        "finetuned_output": "xxxx-ft-202511111122-xxxx",
        ...
    }
}
ステップ 2.2:ファインチューニングジョブのステータスをクエリ
ステップ 2.1 で取得した job_id を使用して、ジョブの進捗状況をクエリします。status が SUCCEEDED に変わるまで、以下の API をポーリングします。
URL の <replace_with_fine_tuning_job_id> を job_id の値に置き換えます。
curl --location 'https://dashscope-intl.aliyuncs.com/api/v1/fine-tunes/<replace_with_fine_tuning_job_id>' \
--header "Authorization: Bearer $DASHSCOPE_API_KEY" \
--header 'Content-Type: application/json'
output フィールドの 2 つのパラメーターに注意してください:
status:値が SUCCEEDED に変わると、モデルのトレーニングは完了し、モデルのデプロイに進むことができます。usage:モデルのトレーニング中に消費されたトークンの総数で、課金に使用されます。
{
    ...
    "output": {
        "job_id": "ft-202511111122-xxxx",
        "status": "SUCCEEDED",
        "usage": 432000,
        ...
    }
}
ステップ 3:ファインチューニング済みモデルのデプロイ
ステップ 3.1:モデルをオンラインサービスとしてデプロイ
ファインチューニングジョブのステータスが SUCCEEDED に変わったら、モデルをオンラインサービスとしてデプロイします。
リクエスト例<replace_with_model_name> を、ファインチューニングジョブの作成の出力にある finetuned_output の値に置き換えます。
curl --location 'https://dashscope-intl.aliyuncs.com/api/v1/deployments' \
--header "Authorization: Bearer $DASHSCOPE_API_KEY" \
--header 'Content-Type: application/json' \
--data '{
    "model_name": "<replace_with_model_name>",
    "capacity": 1,
    "plan": "lora"
}'
output フィールドの 2 つのパラメーターに注意してください:
deployed_model:デプロイ済みモデルの名前。デプロイステータスのクエリとモデルの呼び出しに使用されます。status:モデルのデプロイステータス。ファインチューニング済みモデルをデプロイした後、初期ステータスは PENDING であり、デプロイがまだ開始されていないことを示します。
{
    ...
    "output": {
        "deployed_model": "wan2.7-image-pro-xxxxxxxxxxxx",
        "status": "PENDING",
        ...
    }
}
ステップ 3.2:デプロイステータスのクエリ
デプロイステータスをクエリします。status が RUNNING に変わるまで、以下の API をポーリングします。
注記この例のファインチューニング済みモデルでは、デプロイプロセスに約 5~10 分かかります。
<replace_with_deployed_model> を、ステップ 3.1 の出力にある deployed_model の値に置き換えます。
curl --location 'https://dashscope-intl.aliyuncs.com/api/v1/deployments/<replace_with_deployed_model>' \
--header "Authorization: Bearer $DASHSCOPE_API_KEY" \
--header 'Content-Type: application/json'
output フィールドの 2 つのパラメーターに注意してください:
status:ステータスが RUNNING に変わると、モデルは正常にデプロイされ、呼び出しを開始できます。deployed_model:デプロイ済みモデルの名前。
{
    ...
    "output": {
        "status": "RUNNING",
        "deployed_model": "wan2.7-image-pro-xxxxxxxxxxxx",
        ...
    }
}
ステップ 4:モデルを呼び出して画像を生成
モデルが正常にデプロイされた後 (デプロイの status が RUNNING)、呼び出しを開始できます。
注記現在デプロイされているモデルは非同期呼び出しのみをサポートしており、message.content に type フィールドはありません。
ステップ 4.1:画像生成タスクを作成し、task_id を取得
<replace_with_deployed_model> を、前のステップで取得した deployed_model の値に置き換えます。
Text-to-Image
トリガーワードを含むテキスト記述を提供します。モデルはトレーニングされたスタイルに一致する画像を生成します。
curl --location 'https://dashscope-intl.aliyuncs.com/api/v1/services/aigc/image-generation/generation' \
--header 'Content-Type: application/json' \
--header "Authorization: Bearer $DASHSCOPE_API_KEY" \
--header "X-DashScope-Async: enable" \
--data '{
    "model": "<replace_with_deployed_model>",
    "input": {
        "messages": [
            {
                "role": "user",
                "content": [
                    {"text": "s86b5p, A person in a crowded morning rush hour subway car, holding onto the handrail, with blurred passengers in the background and tunnel lights visible through the windows, wearing an ordinary office worker white shirt and black trousers, standing facing the camera, half-body shot, realistic candid feel."}
                ]
            }
        ]
    },
    "parameters": {
        "size": "2K",
        "n": 1
    }
}'
Image-to-Image
参照画像と編集指示を提供します。モデルは参照画像に基づいて、トレーニングされたスタイルで画像を生成します。
curl --location 'https://dashscope-intl.aliyuncs.com/api/v1/services/aigc/image-generation/generation' \
--header 'Content-Type: application/json' \
--header "Authorization: Bearer $DASHSCOPE_API_KEY" \
--header "X-DashScope-Async: enable" \
--data '{
    "model": "<replace_with_deployed_model>",
    "input": {
        "messages": [
            {
                "role": "user",
                "content": [
                    {"image": "<replace_with_reference_image_URL>"},
                    {"text": "s86b5p, Change the background to an elevator with red lighting. Change the character clothing to red tight-fitting mech armor with black stripe decorations."}
                ]
            }
        ]
    },
    "parameters": {
        "size": "2K",
        "n": 1
    }
}'
次のステップで結果をクエリするために、task_id をコピーして保存します。
{
    "request_id": "4909100c-7b5a-9f92-bfe5-xxxxxx",
    "output": {
        "task_id": "0385dc79-5ff8-4d82-bcb6-xxxxxx",
        "task_status": "PENDING"
    }
}
注記ファインチューニングされた LoRA モデルを呼び出す際の入力パラメーターは、Wan2.7 - 画像生成と編集のものと同じです。
以下の表には、LoRA モデル呼び出しの主要なパラメーターのみを記載しています。
フィールド | タイプ | 必須 | 説明 | 例 |
|---|---|---|---|---|
model | string | はい | モデル名。ステータスが RUNNING で正常にデプロイされたファインチューニング済みモデルを使用する必要があります。 | wan2.7-image-pro-xxxxxxxxxxxx |
input.messages[].content[].text | string | はい | テキストプロンプト。LoRA スタイルを有効にするためにトリガーワードを含めることを推奨します。 | s86b5p, A person in a quiet private library on a peaceful afternoon... |
parameters.size | string | いいえ | 出力画像の解像度。
| 2K |
parameters.n | integer | いいえ | 生成する画像の数。有効な値:1~4。デフォルト:1。 | 1 |
ステップ 4.2:task_id で結果をクエリ
task_status が SUCCEEDED に変わるまで、task_id を使用してタスクステータスをポーリングします。output.choices[].message.content[].image から画像 URL を取得します。
86ecf553-d340-4e21-xxxxxxxxxを実際の task_id に置き換えてください。
curl -X GET https://dashscope-intl.aliyuncs.com/api/v1/tasks/86ecf553-d340-4e21-xxxxxxxxx \
--header "Authorization: Bearer $DASHSCOPE_API_KEY"
画像 URL は 24 時間有効です。速やかに画像をダウンロードしてください。
{
    "request_id": "3f2ebb4e-3d47-97b5-xxxx-xxxxxx",
    "output": {
        "task_id": "aeea547c-e24e-4acb-xxxx-xxxxxx",
        "task_status": "SUCCEEDED",
        "submit_time": "2026-05-29 17:35:23.826",
        "scheduled_time": "2026-05-29 17:35:23.865",
        "end_time": "2026-05-29 17:36:32.498",
        "finished": true,
        "choices": [
            {
                "finish_reason": "stop",
                "message": {
                    "role": "assistant",
                    "content": [
                        {
                            "image": "https://dashscope-7c2c.oss-accelerate.aliyuncs.com/xxx.png?Expires=xxxxxx"
                        }
                    ]
                }
            }
        ]
    },
    "usage": {
        "size": "2048*2048",
        "total_tokens": 770,
        "image_count": 1,
        "output_tokens": 691,
        "input_tokens": 79
    }
}
カスタムデータセットの構築
このドキュメントのサンプルデータを使用してファインチューニングのワークフローを体験するだけでなく、独自のデータセットを構築してファインチューニングすることもできます。
データセットには、トレーニングセット (必須) と検証セット (オプション、トレーニングセットからの自動分割をサポート) を含める必要があります。すべてのファイルを .zip 形式でパッケージ化します。ファイル名には英数字、アンダースコア、ハイフンのみを使用してください。
データセットのフォーマット
トレーニングセット:必須
Text-to-Image
トレーニングセットには、トレーニング対象の画像とアノテーションファイル (data.jsonl) が含まれます。
- トレーニングセットのサンプル:wan-image-t2i-training-dataset.zip
- Zip パッケージのディレクトリ構造:
wan-image-t2i-training-dataset.zip
├── data.jsonl      # data.jsonl という名前にする必要があり、最大 20MB
├── 1_0.png         # トレーニング対象画像、最大解像度 4096*4096、画像あたり最大 20MB、PNG/JPG/JPEG/WEBP/BMP をサポート
├── 1_1.png         # ファイル名は英数字のみをサポート、フラットな構造 (サブディレクトリなし)
└── 1_2.png
- アノテーションファイル (data.jsonl):各行は 1 つのトレーニングサンプルを表し、JSON オブジェクトである必要があります。
{
  "prompt": "s86b5p, A person in a quiet private library on a peaceful afternoon, with tall dark walnut bookshelves behind them, sunlight streaming through venetian blinds casting striped shadows, wearing a soft beige cable-knit sweater, standing facing the camera, half-body shot, the image has a delicate film grain texture.",
  "img_path": "./1_0.png"
}
Image-to-Image
トレーニングセットには、参照画像 (入力)、トレーニング対象画像 (出力)、およびアノテーションファイル (data.jsonl) が含まれます。
- トレーニングセットのサンプル:wan-image-i2i-training-dataset.zip
- Zip パッケージのディレクトリ構造:
wan-image-i2i-training-dataset.zip
├── data.jsonl      # data.jsonl という名前にする必要があり、最大 20MB
├── 1_0.jpg         # トレーニング対象画像 (出力)
├── 1_1.jpg         # 参照画像 (入力)
├── 6_0.jpg         # トレーニング対象画像 (出力)
└── 6_1.jpg         # 参照画像 (入力)
- アノテーションファイル (data.jsonl):各行は 1 つのトレーニングサンプルを表し、JSON オブジェクトである必要があります。
{
  "prompt": "s86b5p, Change the background to an elevator with red lighting, featuring large floor-to-ceiling windows. Change the character's clothing to red tight-fitting mech armor with black stripe decorations.",
  "input_img": "./1_1.jpg",
  "img_path": "./1_0.jpg"
}
Multi-Image-to-Image
トレーニングセットには、複数の参照画像 (入力)、トレーニング対象画像 (出力)、およびアノテーションファイル (data.jsonl) が含まれます。単一の Image-to-Image とは異なり、Multi-Image-to-Image は複数の参照画像を同時に入力できます (例:キャラクター写真 + ポーズ画像、最大 9 枚の参照画像)。モデルは、すべての参照画像からの情報を組み合わせて対象画像を生成します。
- トレーニングセットのサンプル:
- Zip パッケージのディレクトリ構造:
wan-image-multi-i2i-training-dataset.zip
├── data.jsonl      # data.jsonl という名前にする必要があり、最大 20MB
├── 1_0.jpg         # トレーニング対象画像 (出力)
├── 1_ref.jpg       # 参照画像 1 (例:キャラクター写真)
├── 1_pose.jpg      # 参照画像 2 (例:ポーズ画像)
├── 6_0.jpg         # トレーニング対象画像 (出力)
├── 6_ref.jpg       # 参照画像 1
└── 6_pose.jpg      # 参照画像 2
- アノテーションファイル (data.jsonl):各行は 1 つのトレーニングサンプルを表し、JSON オブジェクトである必要があります。
input_imgsフィールド (配列型) を使用して、複数の参照画像のパスを渡します。
{
  "prompt": "s86b5p, Change the background to an elevator with red lighting, featuring large floor-to-ceiling windows. Outside the windows, there is a post-apocalyptic scene with red mist. Change the character's clothing to red tight-fitting mech armor with black stripe decorations. Standing with both arms stretched horizontally to form a T-shape.",
  "input_imgs": ["./1_ref.jpg", "./1_pose.jpg"],
  "img_path": "./1_0.jpg"
}
注記
- Multi-Image-to-Image は
input_imgs(配列) を使用し、単一の Image-to-Image はinput_img(文字列) を使用します。この違いにご注意ください。 input_imgs配列内の画像の順序は、トレーニングの意図と一致させる必要があります (例:最初の画像をキャラクター参照、2 番目をポーズ参照として)。input_imgsは最大 9 枚の参照画像をサポートします。
注記
- data.jsonl は、行区切りの JSONL 形式 (1 行に 1 つの独立した JSON オブジェクト) である必要があります。ファイルの最初の文字が
[である JSON 配列形式の使用は許可されていません。 - zip パッケージ内のファイルは、フラットな構造で配置する必要があります。サブディレクトリは許可されていません。ファイル名は英数字のみをサポートします (漢字、スペース、特殊文字は許可されていません)。
検証セット:オプション
検証セットには、アノテーションファイル (data.jsonl) とオプションの参照画像 (Image-to-Image モードで必須) が含まれます。対象画像は不要です。各評価チェックポイントで、トレーニングジョブは自動的にモデルサービスを呼び出し、検証セットのプロンプト (および参照画像) を使用してプレビュー画像を生成します。
-
検証セット:
- Text-to-Image: wan-image-t2i-valid-dataset.zip
- Image-to-Image: wan-image-i2i-valid-dataset.zip
-
Zip パッケージのディレクトリ構造:
wan-image-i2i-valid-dataset.zip
├── data.jsonl       # data.jsonl という名前にする必要があり、最大 20MB
├── input_001.png    # オプション、Image-to-Image モード用の参照画像
└── input_002.png
-
アノテーションファイル (data.jsonl):各行は 1 つの検証サンプルを表し、JSON オブジェクトである必要があります。
Text-to-Image
{
    "prompt": "s86b5p, A person in a crowded morning rush hour subway car, holding onto the handrail, with blurred passengers in the background and tunnel lights visible through the windows, wearing an ordinary office worker white shirt and black trousers, standing facing the camera, half-body shot, realistic candid feel."
}
Image-to-Image
{
    "prompt": "s86b5p, Change the background to an elevator with red lighting, featuring large floor-to-ceiling windows. Change the character's clothing to red tight-fitting mech armor with black stripe decorations.",
    "input_img": "./input_001.png"
}
Multi-Image-to-Image
Multi-Image-to-Image の検証セットは
input_imgs(配列) を使用して複数の参照画像のパスを渡し、最大 9 枚の画像をサポートします。{ "prompt": "s86b5p, Change the background to an elevator with red lighting, featuring large floor-to-ceiling windows. Outside the windows, there is a post-apocalyptic scene with red mist. Change the character's clothing to red tight-fitting mech armor with black stripe decorations. Standing with both arms stretched horizontally to form a T-shape.", "input_imgs": ["./input_001.png", "./input_002.png"] }
データ規模と制限
-
データ量:少なくとも 25 枚の画像を提供することを推奨します (より良い結果を得るためには 50 枚以上を推奨)。複数のシーンや角度で同じキャラクターやスタイルを使用し、一貫したコンテンツ記述を行います。
-
Zip パッケージ:API 経由でアップロードする場合、総パッケージサイズは 1 GB 以下である必要があります。
-
トレーニング画像の要件:
- サポートされる画像フォーマット:BMP、JPEG、PNG、WEBP。
- 画像の解像度は 4096×4096 以下である必要があります。
- 個々の画像ファイルサイズは 20 MB 以下である必要があります。
データ収集とクリーニング
1. ファインチューニングシナリオの決定
Wan は、画像生成に関する以下のファインチューニングシナリオをサポートしています:
- IP キャラクタースタイル化:アニメキャラクターやマスコット画像など、特定の IP キャラクターの描画スタイルをモデルに学習させます。
- 固定ビジュアルスタイル:フラットイラスト、水墨画、ピクセルアートなど、特定の画風を再現するモデルの能力を向上させます。
- 特定シーン生成:商品展示画像やポスターレイアウトなど、特定の構図パターンやシーンテンプレートを再現します。
2. 元データの取得
- AI 生成と選択:Wan ベースモデルを使用して画像を大量に生成し、ターゲット効果に最も一致する高品質なサンプルを手動で選択します。これは最も一般的に使用される方法です。
- 実写撮影:リアルなシーン (実際の商品写真やポートレート写真など) を目指す場合、実写映像を使用するのが最良の選択です。
- 3D ソフトウェアレンダリング:細かいディテール制御や 3D レンダリングスタイルが必要なシーンでは、3D ソフトウェア (Blender や C4D など) を使用してソースマテリアルを作成することを推奨します。
3. データのクリーニング
ディメンション | ベストプラクティス | アンチパターン |
|---|---|---|
一貫性 | コアな特徴は高い一貫性を持つ必要があります。 例:「フラットイラストスタイル」をトレーニングする場合、すべての画像は同じ線の太さと配色を共有する必要があります。 | 混合スタイル。 データセットに厚塗りスタイルとフラットスタイルの両方の画像が含まれている。モデルはどちらのスタイルを学習すべきか判断できません。 |
多様性 | 主題やシーンが多様であるほど良い。 異なる主題 (男性、女性、高齢者、子供、猫、犬、建物) や異なる構図 (ロングショット、クローズアップ、エクストリームクローズアップ) をカバーします。解像度やアスペクト比もできるだけ多様であるべきです。 | 単一のシーンや主題。 すべての画像が「白い壁を背景に赤い服を着た人物」を示している。モデルは「赤い服」と「白い壁」がスタイルの一部であると誤って学習し、異なるシーンで正しく生成できなくなる可能性があります。 |
バランス | データタイプ間でバランスの取れた比率。 複数のスタイルが含まれる場合、その数量はほぼ等しくあるべきです。 | 著しく不均衡な比率。 90% がポートレート画像で 10% が風景画像。モデルは風景画像を生成する際に性能が低下する可能性があります。 |
クリーンさ | クリーンでクリアな画像。 ノイズのないオリジナル素材を使用します。 | 注意をそらす要素を含む。 画像にウォーターマーク、明らかな黒い枠、またはノイズが含まれている。モデルはウォーターマークをスタイルの一部として学習する可能性があります。 |
解像度 | 中程度の解像度。 トレーニング画像の解像度は 2048×2048 を超えないことを推奨します。過度に大きな画像はトレーニング時間を増加させます。 | 解像度のばらつきが大きすぎる。 トレーニングセットに 256×256 の小さな画像と 4096×4096 の大きな画像の両方が含まれていると、トレーニングの安定性に影響します。 |
画像アノテーション:画像用のプロンプト作成
データセットのアノテーションファイル (data.jsonl) では、各画像に対応するプロンプトがあります。プロンプトは対象画像の内容を記述します。プロンプトの品質は、モデルが何を学習するかを直接決定します。
プロンプト作成の公式
プロンプト = [主題の説明] + [背景の説明] + [トリガーワード] + [スタイルの説明]プロンプトのコンポーネント | 説明 | 推奨 | 例 |
|---|---|---|---|
主題の説明 | 画像内の人物やオブジェクトを説明します | 必須 | 赤い中国風のロングシャツを着た若い女性... |
背景の説明 | 主題が置かれている環境を説明します | 必須 | 背景は緑のツタで覆われたレンガの壁... |
トリガーワード | 実際の意味を持たない珍しい単語 | 推奨 | s86b5p または m01aa |
スタイルの説明 | 対象画像の画風と視覚的特徴を詳細に説明します | 推奨 | クリーンで流れるような線と鮮やかなフラットカラーで描かれたフラットイラストスタイルで、立体感と現代的なデザイン美学を強調しています。 |
検証セットによるモデル評価
検証セットの指定
ファインチューニングジョブにはトレーニングセットを含める必要がありますが、検証セットはオプションです。システムによる自動分割または手動アップロードのいずれかを選択できます。具体的な方法は以下の通りです:
方法 1:検証セットをアップロードしない (システムによる自動分割)
ビデオおよび画像生成モデルのファインチューニング API を呼び出す際、検証セットを別途アップロードしない場合 (つまり、validation_file_ids パラメーターが提供されない場合)、システムは split に基づいてトレーニングセットから検証セットを分割します。デフォルトは 0.9 で、これは 90% がトレーニングに、10% が検証に使用されることを意味します。
方法 2:検証セットを手動でアップロード (validation_file_ids で指定)
システムのランダム分割に頼らず、独自に準備したデータでチェックポイントを評価したい場合は、カスタム検証セットをアップロードできます。
注意:手動でアップロードを選択すると、システムは上記の自動分割ルールを完全に無視し、アップロードしたデータのみを検証に使用します。
デプロイに最適なチェックポイントの選択
トレーニング中、システムは定期的にモデルの「スナップショット」(つまりチェックポイント) を保存します。デフォルトでは、システムは最後のチェックポイントを最終的なファインチューニング済みモデルとして出力します。しかし、中間段階で生成されたチェックポイントが最終バージョンよりも優れた性能を示すことがあります。最も満足のいくものを選択してデプロイできます。
システムは、ハイパーパラメーター (hyper_parameters) の eval_steps で設定された間隔で、検証セット上でチェックポイントを実行し、プレビュー画像を生成します。
- 評価方法:生成されたプレビュー画像を直接観察して結果を判断します。
- 選択基準:最も良い結果で、スタイルが最も一致するチェックポイントを見つけます。
手順
ステップ 1:チェックポイントによって生成されたプレビュー結果の表示
ステップ 1.1:検証済みチェックポイントのリストをクエリ
この API は、検証に合格し、プレビュー画像の生成に成功したチェックポイントのみを返します。検証に失敗したチェックポイントはリストされません。
リクエスト例<replace_with_fine_tuning_job_id>:ビデオおよび画像生成モデルのファインチューニング API の出力パラメーターjob_idで完全に置き換えます。
curl --location 'https://dashscope.aliyuncs.com/api/v1/fine-tunes/<replace_with_fine_tuning_job_id>/validation-results' \
--header "Authorization: Bearer $DASHSCOPE_API_KEY" \
--header 'Content-Type: application/json'
この API は、検証に成功したチェックポイントの名前のみを含むリストを返します。
{
    "request_id": "da1310f5-5a21-4e29-99d4-xxxxxx",
    "output": [
        {
            "checkpoint": "checkpoint-160"
        },
        ...
    ]
}
ステップ 1.2:チェックポイントの検証データセット結果のクエリ
前のステップで返されたリストからチェックポイント (例:「checkpoint-160」) を選択し、生成されたイメージ結果を確認します。
リクエスト例<replace_with_fine_tuning_job_id>:ファインチューニングジョブの作成 の出力に含まれるjob_idの値に置き換えます。<replace_with_checkpoint_to_export>:チェックポイントの値 (例:「checkpoint-160」) に置き換えます。
curl --location 'https://dashscope-intl.aliyuncs.com/api/v1/fine-tunes/<replace_with_fine_tuning_job_id>/validation-details/<replace_with_checkpoint_to_export>?page_no=1&page_size=10' \
--header "Authorization: Bearer $DASHSCOPE_API_KEY"
プレビューイメージの URL は img_path フィールドにあり、24 時間有効です。結果を確認するために、速やかにイメージをダウンロードしてください。このステップを繰り返し、複数のチェックポイントの結果を比較して、最も満足のいくものを見つけてください。
{
    "request_id": "375b3ad0-d3fa-451f-b629-xxxxxxx",
    "output": {
        "page_no": 1,
        "page_size": 10,
        "total": 5,
        "list": [
            {
                "img_path": "https://finetune-result.oss-cn-wulanchabu.aliyuncs.com/xxx.png?Expires=xxxxxx",
                "prompt": "s86b5p, Change the background to an elevator equipped with a white ceiling lighting, featuring large floor-to-ceiling windows. Change the character's clothing to red tight-fitting mech armor with black stripe decorations.",
                "input_img": "https://finetune-result.oss-cn-wulanchabu.aliyuncs.com/val_dataset/input_001.png?Expires=xxxxxx"
            },
            ...
        ]
    }
}
ステップ 2:チェックポイントをエクスポートし、デプロイ用のモデル名を取得
ステップ 2.1:モデルのエクスポート
「checkpoint-160」が最も良い結果だったと仮定し、次のステップはそれをエクスポートすることです。
リクエスト例<replace_with_fine_tuning_job_id>:ファインチューニングジョブの作成の出力にあるjob_idの値で完全に置き換えます。<replace_with_checkpoint_to_export>:チェックポイントの値で完全に置き換えます。例:「checkpoint-160」。<replace_with_exported_model_display_name>:コンソール表示にのみ使用されるカスタムモデル名で完全に置き換えます。例:「wan2.5-checkpoint-160」。この名前はグローバルに一意である必要があります。重複した名前でのエクスポートはサポートされていません。パラメーターの詳細については、「3. チェックポイントのエクスポート」をご参照ください。
curl --location 'https://dashscope-intl.aliyuncs.com/api/v1/fine-tunes/<replace_with_fine_tuning_job_id>/export/<replace_with_checkpoint_to_export>?model_name=<replace_with_exported_model_display_name>' \
--header "Authorization: Bearer $DASHSCOPE_API_KEY"
レスポンスパラメーター output=true は、エクスポートリクエストが正常に作成されたことを示します。
{
    "request_id": "0817d1ed-b6b6-4383-9650-xxxxx",
    "output": true
}
ステップ 2.2:デプロイ用の新しいモデル名をクエリ
すべてのチェックポイントのステータスをクエリし、エクスポートが完了したことを確認し、デプロイ用の専用の新しいモデル名 (model_name) を取得します。
<replace_with_fine_tuning_job_id>:ファインチューニングジョブの作成の出力にあるjob_idの値で完全に置き換えます。
curl --location 'https://dashscope-intl.aliyuncs.com/api/v1/fine-tunes/<replace_with_fine_tuning_job_id>/checkpoints' \
--header "Authorization: Bearer $DASHSCOPE_API_KEY"
返されたリストでエクスポートされたチェックポイント (checkpoint-160 など) を見つけます。その status が SUCCEEDED に変わると、エクスポートは成功です。この時点で返される model_name フィールドが、エクスポート後の新しいモデル名です。
{
    "request_id": "b0e33c6e-404b-4524-87ac-xxxxxx",
    "output": [
         ...,
        {
            "create_time": "2025-11-11T13:27:29",
            "full_name": "ft-202511111122-496e:checkpoint-160",
            "job_id": "ft-202511111122-496e",
            "checkpoint": "checkpoint-160",
            "model_name": "xxxx-ft-202511111122-xxxx-c160", // 重要フィールド、モデルのデプロイと呼び出しに使用
            "model_display_name": "xxxx-ft-202511111122-xxxx",
            "status": "SUCCEEDED" // 正常にエクスポートされたチェックポイント
        },
        ...

    ]
}
ステップ 3:モデルのデプロイと呼び出し
課金
-
モデルトレーニング:有料。
- コスト = 総トレーニングトークン数 × 単価。「トレーニングとデプロイの価格」をご参照ください。
- トレーニング完了後、ファインチューニングジョブの取得 API の
usageフィールドで、トレーニング中に消費されたトークンの総数を確認できます。
以下の表は、wan2.7-image、wan2.7-image-pro のトレーニングステップ数と推定コストを示しています。このデータは参考用です。実際のトレーニング結果は最終的な納品物に準じ、コストは公式の請求書に準じます。詳細な課金計算式については、「トレーニングとデプロイの価格」をご参照ください。
generation_type
画像解像度
一般的なステップ数
推定トークン消費量
推定コスト
t2i (Text-to-Image)
1K
500
6,400,000
$96
1,000
12,800,000
$192
2,000
25,600,000
$384
2K
500
11,610,000
$174.15
1,000
23,220,000
$348.3
2,000
46,440,000
$696.6
i2i (Image-to-Image)
1K
500
11,610,000
$174.15
1,000
23,220,000
$348.3
2,000
46,440,000
$696.6
2K
500
16,000,000
$240
1,000
32,000,000
$480
2,000
64,000,000
$960
-
モデルのデプロイと呼び出し:デプロイは無料です。呼び出しは、ファインチューニングされたベースモデルの標準レートで課金されます。
モデル ID
LoRA デプロイ & 呼び出し価格
wan2.7-image-pro
$0.075/画像
wan2.7-image
$0.03/画像
API リファレンス
よくある質問
Q:良いトリガーワードを設計するにはどうすればよいですか?
A:ルールは以下の通りです:
- s86b5p、m01aa、EVEAven638123 のように、実際の意味を持たない珍しい文字の組み合わせを使用することを推奨します。ベースモデルの語彙に意味がないことを確認してください。
- 一般的な英単語 (beautiful、fire、dance など) の使用は避けてください。これは、モデルがこれらの単語に対して元々持っている理解を汚染する可能性があります。