本ドキュメントでは、プロビジョンドスループット (PTU) デプロイにおける長文入力とプレフィックスキャッシング機能について、クォータ消費ルール、容量計算ツールの使用方法、関連する API レスポンスフィールドの説明を含めて解説します。
概要
PTU (Provisioned Throughput Unit) は、プラットフォームのリソースを予約して特定の TPM スループット容量を保証するモデルデプロイ方式であり、保証されたクォータの範囲内ではレート制限が適用されません。高スループット、高性能、高負荷の本番環境に適しており、安定したスループット容量、低レイテンシ、より強固なリソース確実性を提供します。トークンベースの課金と比較して、TPS (1 秒あたりの生成トークン数) は通常約 1.5 ~ 2.0 倍向上します。
ユースケース:
- 銀行アプリ向けのインテリジェントカスタマーサポート (トラフィックが安定しており、保証された同時実行体験が必要)。
- ソーシャルプラットフォームのリアルタイムコンテンツモデレーション (予測可能なパイプライントスクの安定した処理が必要)。
- パブリッククラウドの翻訳 API (標準パッケージユーザーにベースラインのサービス保証を提供)。
長文ドキュメント分析 (契約書、調査レポートの要約) や、入力が 32K トークンを超えるマルチターン会話 (カスタマーサポート、コーディングアシスタント) などでも一般的に使用されます。PTU 作成時にはオーバーフロー戦略を選択できます。自動オーバーフロー (デフォルト、クォータ超過時に自動的に従量課金へ切り替わる) または PTU 容量のみ使用 (超過時に 429 を返す) です。詳細については、「課金ルール」をご参照ください。
PTU は長文入力の階層型容量係数とキャッシュ割引もサポートしています。詳細については、「長文入力とプレフィックスキャッシング」をご参照ください。プレフィックスキャッシングの仕組みについては、「コンテキストキャッシング」をご参照ください。
課金ルール
费用 = 使用时长 × (输入 TPM 单价 × 输入 TPM + 输出 TPM 单价 × 输出 TPM)
後払いは 1 時間単位で計算されます。使用期間の単位は「時間」で、単価は下表の「継続 1 時間」列の値を使用します。前払いは 1 日単位で計算されます。使用期間の単位は「日」で、単価は下表の「継続 1 日」列の値を使用します。
- 前払い注文は支払い後にリアルタイムで有効になり、有効期間は N 日間で、N 日目の 23:59 に終了します。22:00 以降に注文した場合、有効期限は自動的に 1 日延長されます。
- 前払い注文の有効期限が切れると、サービスは 2 時間の遅延の後に停止され、リソースは停止後 14 時間保持されてから解放されます。
- 前払い注文は早期終了をサポートしています。使用済み部分は 1.2 倍の係数で精算されて返金されます。詳細については、「設定ダウングレードの返金ルール」をご参照ください。
- 後払い課金では、アカウントが延滞状態になった場合、デプロイされたリソースは 24 時間保持されて課金が継続され、この間もサービスを通常どおり使用できます。24 時間後、システムは課金を停止し、モデルデプロイは延滞状態になり、基盤となるリソースは削除されますが、モデルデプロイタスクは保持されます。延滞金を支払うと、システムはリソースを再割り当てして使用を復元します (復元後も料金は継続的に発生します)。これ以上料金を発生させたくない場合は、モデルデプロイタスクを削除できます。削除に成功すると課金は停止します。
モデル入力が最大入力トークン数を超えると、該当する呼び出しは自動的に現在のモデルの従量課金モードに切り替わります。購入した TPM を超過した場合は、作成時に選択したオーバーフロー戦略に従って処理されます (「自動オーバーフロー」は従量課金に切り替わり、「PTU 容量のみ使用」は 429 を返します)。この場合、推論パフォーマンスが低下する可能性があり、ビジネススペース内の現在のスナップショットモデルの公開トラフィック制御の対象となり、料金はモデル呼び出し (従量課金) の標準に従って課金されます。
- この場合 (「自動オーバーフロー」戦略の場合のみ)、API レスポンスの Header には
x-dashscope-ptu-overflow:trueが含まれます。 - TPM 統計の確認は、モデルモニタリング から行えます。
縮小 (ダウングレード) シナリオにおける具体的な費用削減と返金ルールについては、「設定ダウングレードの返金ルール」をご参照ください。
注記PTU デプロイは長文入力の階層型容量係数とキャッシュ割引をサポートしています。詳細については、「長文入力とプレフィックスキャッシング」をご参照ください。
サポートされているモデルと価格
シンガポール
Qwen
モデル名 | モデルコード | 最大入力トークン | 後払い入力 10K TPM/時間 | 後払い出力 1K TPM/時間 | 前払い入力 10K TPM/日 | 前払い出力 1K TPM/日 |
|---|---|---|---|---|---|---|
Qwen3.8-Max | qwen3.8-max | 1M | $4.8 | $1.44 | $57.6 | $17.28 |
Qwen3.7-Flash-2026-07-15 有効化するにはビジネスマネージャーにお問い合わせください | qwen3.7-flash-2026-07-15 | 128K | $0.072 | $0.031 | $0.864 | $0.374 |
Qwen3.7-Max-2026-05-20 | qwen3.7-max-2026-05-20 | 256K | $1.92 | $1.8 | $72 | $21.6 |
Qwen3.7-Plus-2026-05-26 | qwen3.7-plus-2026-05-26 | 256K | $0.96 | $0.384 | $11.52 | $4.608 |
Qwen3.6-Plus-2026-04-02 | qwen3.6-plus-2026-04-02 | 128K | $1.2 | $0.72 | $14.4 | $8.64 |
Qwen3.5-Plus-2026-04-20 | qwen3.5-plus-2026-04-20 | 128K | $0.96 | $0.576 | $11.52 | $6.912 |
DeepSeek
モデル名 | モデルコード | 最大入力トークン | 後払い入力 10K TPM/時間 | 後払い出力 1K TPM/時間 | 前払い入力 10K TPM/日 | 前払い出力 1K TPM/日 |
|---|---|---|---|---|---|---|
DeepSeek-v4-Flash | deepseek-v4-flash | 256K | $0.72 | $0.144 | $8.64 | $1.728 |
DeepSeek-v4-Flash-0731 | deepseek-v4-flash-0731 | 64K | $1.44 | $0.288 | $17.28 | $3.456 |
DeepSeek-v4-Pro | deepseek-v4-pro | 256K | $0.96 | $1.728 | $103.68 | $20.736 |
Qwen-VL
モデル名 | モデルコード | 最大入力トークン | 後払い入力 10K TPM/時間 | 後払い出力 1K TPM/時間 | 前払い入力 10K TPM/日 | 前払い出力 1K TPM/日 |
|---|---|---|---|---|---|---|
Qwen3-VL-Plus-2025-09-23 | qwen3-vl-plus-2025-09-23 | 128K | $0.48 | $0.384 | $5.76 | $4.608 |
GLM
モデル名 | モデルコード | 最大入力トークン | 後払い入力 10K TPM/時間 | 後払い出力 1K TPM/時間 | 前払い入力 10K TPM/日 | 前払い出力 1K TPM/日 |
|---|---|---|---|---|---|---|
GLM-5.2 | glm-5.2 | 1M | $5.04 | $1.584 | $60.48 | $19.008 |
中国 (北京)
Qwen
モデル名 | モデルコード | 最大入力トークン | 後払い入力 10K TPM/時間 | 後払い出力 1K TPM/時間 | 前払い入力 10K TPM/日 | 前払い出力 1K TPM/日 |
|---|---|---|---|---|---|---|
Qwen3.8-Max | qwen3.8-max | 1M | $3.96 | $1.188 | $47.53 | $14.258 |
Qwen3.7-Flash-2026-07-15 有効化するにはビジネスマネージャーにお問い合わせください | qwen3.7-flash-2026-07-15 | 128K | $0.066 | $0.026 | $0.792 | $0.317 |
Qwen3.7-Max-2026-05-20 | qwen3.7-max-2026-05-20 | 256K | $3.96 | $1.188 | $47.53 | $14.258 |
Qwen3.7-Plus-2026-05-26 | qwen3.7-plus-2026-05-26 | 256K | $0.66 | $0.264 | $7.92 | $3.168 |
Qwen3.6-Plus-2026-04-02 | qwen3.6-plus-2026-04-02 | 128K | $0.67 | $0.066 | $7.93 | $4.753 |
Qwen3.5-Plus-2026-04-20 | qwen3.5-plus-2026-04-20 | 128K | $0.26 | $0.16 | $3.17 | $1.9 |
Qwen3-Max-2025-09-23 | qwen3-max-2025-09-23 | 128K | $1.11 | $0.45 | $13.32 | $5.4 |
Qwen-Flash-2025-07-28 | qwen-flash-2025-07-28 | 128K | $0.06 | $0.06 | $0.72 | $0.72 |
Qwen-Plus-2025-12-01 | qwen-plus-2025-12-01 | 128K | $0.28 | 非思考:$0.07 思考:$0.28 | $3.36 | 非思考:$0.84 思考:$3.36 |
DeepSeek
モデル名 | モデルコード | 最大入力トークン | 後払い入力 10K TPM/時間 | 後払い出力 1K TPM/時間 | 前払い入力 10K TPM/日 | 前払い出力 1K TPM/日 |
|---|---|---|---|---|---|---|
DeepSeek-v4-Flash | deepseek-v4-flash | 256K | $0.5 | $0.099 | $5.94 | $1.188 |
DeepSeek-v4-Flash-0731 | deepseek-v4-flash-0731 | 64K | $0.99 | $0.198 | $11.88 | $2.376 |
DeepSeek-v4-Pro | deepseek-v4-pro | 256K | $5.94 | $1.188 | $71.3 | $14.26 |
DeepSeek-v3 | deepseek-v3 | 64K | $0.99 | $0.396 | $11.9 | $4.75 |
Qwen-VL
モデル名 | モデルコード | 最大入力トークン | 後払い入力 10K TPM/時間 | 後払い出力 1K TPM/時間 | 前払い入力 10K TPM/日 | 前払い出力 1K TPM/日 |
|---|---|---|---|---|---|---|
Qwen3-VL-Plus-2025-09-23 | qwen3-vl-plus-2025-09-23 | 128K | $0.35 | $0.35 | $4.2 | $4.2 |
GLM
モデル名 | モデルコード | 最大入力トークン | 後払い入力 10K TPM/時間 | 後払い出力 1K TPM/時間 | 前払い入力 10K TPM/日 | 前払い出力 1K TPM/日 |
|---|---|---|---|---|---|---|
GLM-5.2 | glm-5.2 | 1M | $3.96 | $1.386 | $47.53 | $16.635 |
長文入力とプレフィックスキャッシング
長文入力の階層型係数とキャッシュ割引はモデルによって異なります。次の表は、現在サポートされているモデルのパラメーターを示しています。
モデル | タイプ | 最大入力長 | キャッシュ割引 | 長文入力階層型係数 |
|---|---|---|---|---|
glm-5.2 | PTU | (0, 1M) | 0.25 | 1 |
qwen3.8-flash | PTU | (0, 1M) | 0.125 | 1 |
qwen3.8-max | PTU | (0, 1M) | 0.125 | 1 |
qwen3.7-flash-2026-07-15 | PTU | (0, 1M) | 0.2 | 入力と出力で同一 |
deepseek-v4-flash-0731 | PTU | (0, 1M) | 0.1 | 1 |
qwen3.7-plus-2026-05-26 | PTU | PTU | 100万 | 0.2 (キャッシュヒット部分は容量の 20% として計算) |
glm-5.1 | PTU | PTU | 200K | 0.2 (キャッシュヒット部分は容量の 20% として計算) |
deepseek-v4-pro | PTU | PTU | 256K | 0.08 (キャッシュヒット部分は容量の 8% として計算) |
その他のモデル | PTU | PTU | コンソールをご参照ください | コンソールをご参照ください |
計算例 (glm-5.1 を使用)
场景 1:短输入(10K token,无缓存)
  输入消耗:10K × 1.0 = 10KTPM

场景 2:长输入(50K token,无缓存)
  输入消耗:32K × 1.0 + 18K × 1.33 = 55.94 KTPM
  输出消耗(假设 1K token):1K × 1.17 = 1.17 KTPM

场景 3:长输入 + 缓存命中(50K token,前 30K 命中缓存)
  缓存部分输入(前 30K,均在 [0,32K) 阶梯内):
    30K × 1.0 × 0.2 = 6  KTPM
  非缓存部分输入(后 20K):
    2K × 1.0 + 18K × 1.33 = 25.94 KTPM
  输入合计 = 31.940 KTPM(比无缓存节省 43%)
プロビジョンドスループットクォータ計算ツール
注記デプロイの作成またはスケールの前に計算ツールを使用して、長文入力シナリオでのクォータ要件を評価してください。これにより、クォータ不足によってリクエストが従量課金の課金にフォールバックするのを防げます。実際の購入上限については、コンソールをご参照ください。
前提条件: Model Studio を有効化し、PTU デプロイの権限を持っていること。Model Studio コンソール にログインし、専用デプロイ > 新規モデルのデプロイ ページ (または既存のデプロイの詳細ページで スケールアップ をクリック) に移動し、デプロイ可能な PTU (プロビジョンドスループット) モデルを選択して、プロビジョンドスループットクォータ計算ツール を展開します。
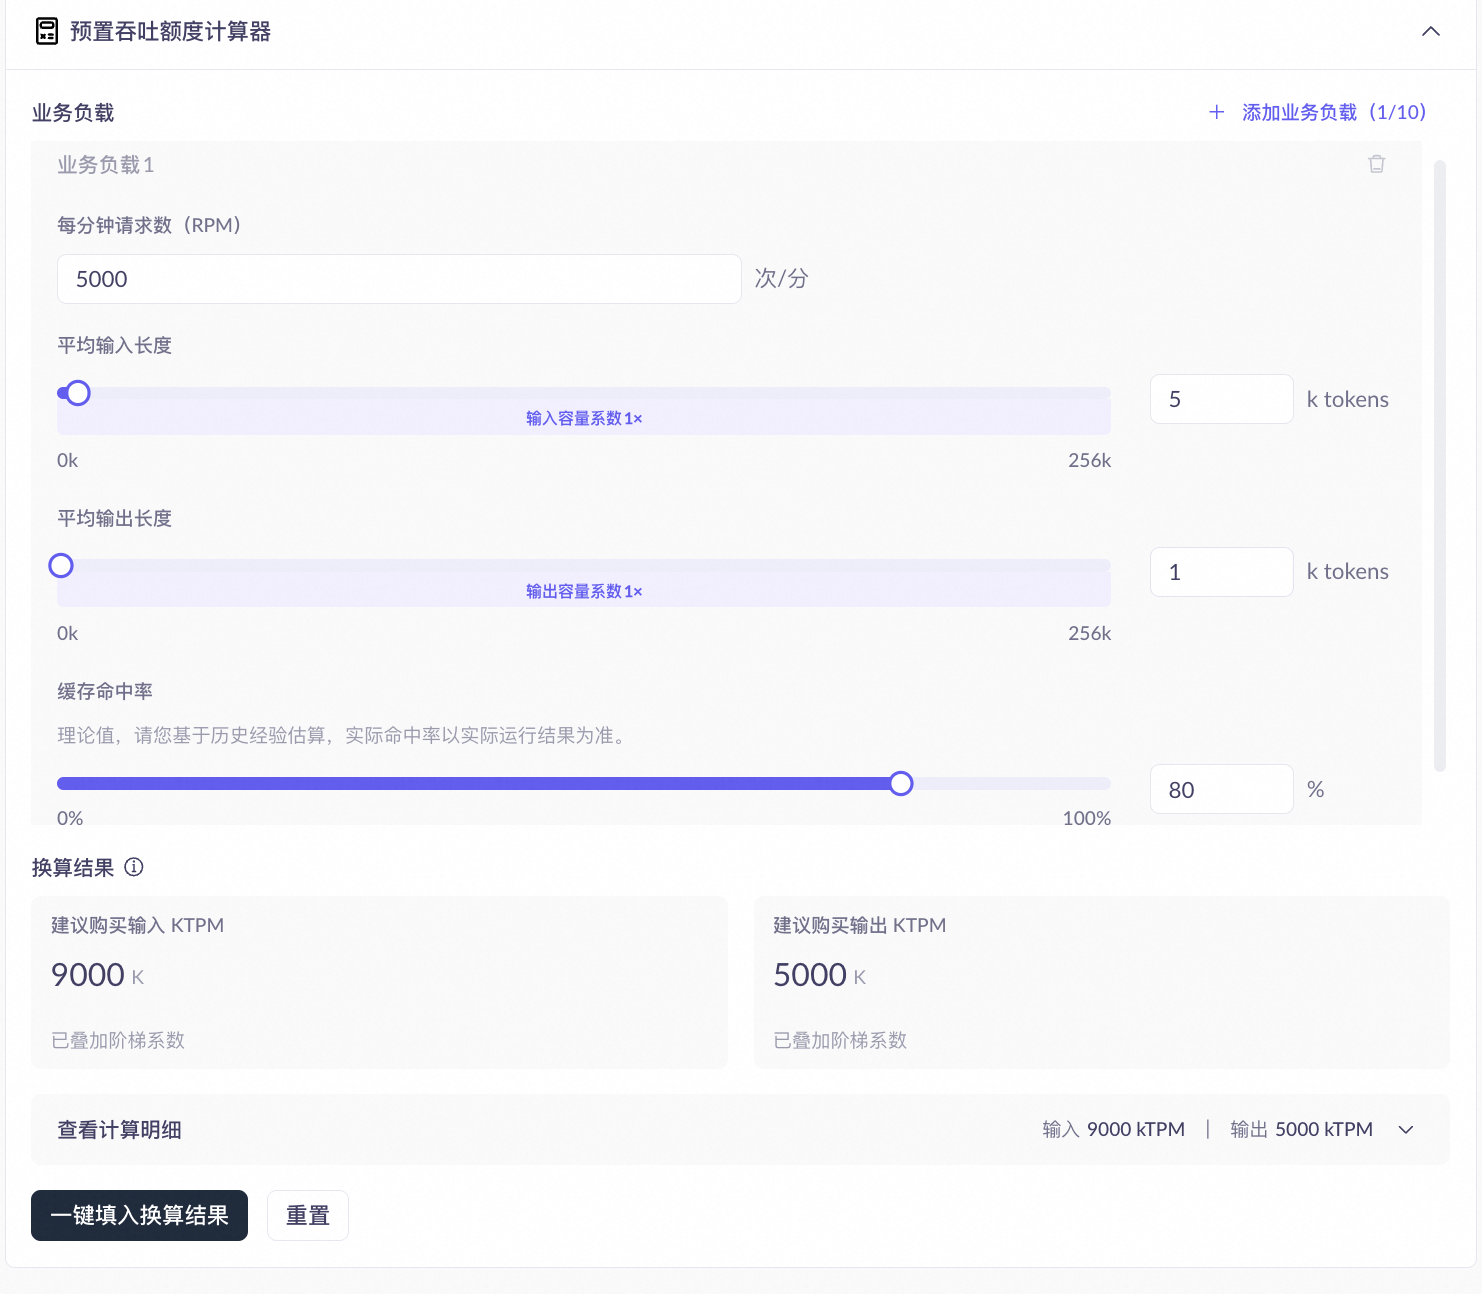
プロビジョンドスループットクォータ計算ツール は、ワークロードに基づいて KTPM クォータを自動的に推奨します。以下のパラメーターを入力すると、計算ツールは推奨される入力 KTPM と出力 KTPM を出力します。
パラメーター | 説明 | 結果への影響 |
|---|---|---|
毎分リクエスト数 (RPM) | ビジネスのピーク時間帯における 1 分あたりのリクエスト数。 | RPM が大きいほど、推奨される入力および出力 KTPM が比例して増加します。 |
平均入力長 (トークン) | リクエストあたりの平均入力トークン数。 | 入力が長いほど、階層と係数が高くなり、推奨される入力 KTPM が増加します。階層の境界はモデルによって異なります。実際の値についてはコンソールをご参照ください。 |
平均出力長 (トークン) | リクエストあたりの平均出力トークン数。 | 出力が長いほど、適用される係数が高くなる可能性があり、推奨される出力 KTPM が増加します。 |
キャッシュヒット率 (%) | リクエストのプレフィックストークンのうちキャッシュにヒットする割合。実際のヒット率はリクエスト内容の反復性に依存します。実際の実行結果をご参照ください。 | ヒット率が高いほど入力クォータの消費が遅くなり、推奨される入力 KTPM が減少します。出力 KTPM ではなく、入力 KTPM にのみ影響します。 |
API レスポンスフィールド
PTU デプロイの API レスポンスには、課金方法とクォータ消費を特定する以下のクォータ関連フィールドが含まれます。
フィールド | タイプ | 説明 |
|---|---|---|
| String | トップレベルのレスポンスフィールド (すべての API フォーマットで共通)。値が |
| Integer | 変換後 (階層型係数とキャッシュ割引を含む) に実際に消費された PTU クォータトークン数。 |
| Integer | プレフィックスキャッシュにヒットしたトークン数。詳細については、コンテキストキャッシングをご参照ください。 |
これらのフィールドの JSON パスは、API フォーマットによって異なります。
OpenAI Chat 互換
フィールド | JSON パス | 説明 |
|---|---|---|
|
| 入力側のキャッシュトークン数 |
|
| 入力側の PTU クォータ消費量 |
|
| 出力側の PTU クォータ消費量 |
OpenAI Responses
フィールド | JSON パス | 説明 |
|---|---|---|
|
| 入力側のキャッシュトークン数 |
|
| 入力側の PTU クォータ消費量 |
|
| 出力側の PTU クォータ消費量 |
Anthropic 互換
フィールド | JSON パス | 説明 |
|---|---|---|
|
| 入力側の PTU クォータ消費量 |
|
| 出力側の PTU クォータ消費量 |
注記Anthropic 互換フォーマットは、現在 cached_tokens フィールドを返しません。provisioned_tokens を使用して、キャッシングの効果を間接的に評価できます。
DashScope
フィールド | JSON パス | 説明 |
|---|---|---|
|
| 入力側のキャッシュトークン数 |
|
| 入力側の PTU クォータ消費量 |
|
| 出力側の PTU クォータ消費量 |
完全なフィールド定義と値の範囲については、API リファレンスをご参照ください。
モニタリングと検証
Model Studio プラットフォームのモデルモニタリング機能を使用して、PTU デプロイをモニタリングできます。長文入力とキャッシングに関連するメトリクスは以下のとおりです。
- PTU 使用率: 入力、出力、思考モード出力の 3 つの独立した曲線で構成されます。長文入力シナリオでは、階層型係数により使用率が 100% を超えることがありますが、これは想定された動作です。
- トークン使用量とキャッシュヒット:
cached_tokensデータ系列が含まれ、総入力に対するキャッシュヒットの割合を示します。 - クォータ内/クォータ外の呼び出し回数: PTU クォータを超えたリクエストの割合を示します (自動オーバーフロー戦略ではリクエストは従量課金の課金にフォールバックし、PTU 容量のみ使用戦略では 429 エラーが返されます)。
モニタリングメトリクスと手順の詳細については、「モデルモニタリング」をご参照ください。
スケーリング
スケーリング ボタンをクリックすると、セルフサービスでスループット (インスタンス数) を手動調整できます。費用削減と返金ルールの詳細については、「設定ダウングレードの返金ルール」をご参照ください。
さらに、操作列のスケーリング設定ボタンから、(スケーリングしきい値、最小/最大レプリカ数、スケジュールスケーリングなどを含む) 自動スケーリングポリシーを設定できます。
よくある質問
Q: PTU クォータを超えるとどうなりますか?
作成時に選択したオーバーフロー戦略によって扱いが異なります。「自動オーバーフロー」戦略では、リクエストは自動的に従量課金の課金にフォールバックし、API レスポンスの service_tier フィールドは返却されないか default となり、レスポンスヘッダーに x-dashscope-ptu-overflow:true が含まれるため、サービスは中断されません。「PTU 容量のみ使用」戦略では、クォータを超えたリクエストには 429 エラーが返され、追加の料金は発生しません。
Q: 1 回の入力がモデルの上限を超えるとどうなりますか?
Qwen シリーズモデルの入力上限は 128K トークン、DeepSeek シリーズモデルは 64K トークンです。上限を超えたリクエストも自動的に従量課金の課金にフォールバックします。
Q: キャッシングが機能していることを確認するにはどうすればよいですか?
API レスポンスの cached_tokens フィールドを確認してください。0 より大きい値は、プレフィックスキャッシュにヒットしたことを示します。キャッシュヒットしたトークンは、モデルの割引係数でクォータを消費します (具体的な割引率については、「長文入力とプレフィックスキャッシング」をご参照ください)。コンソールのモニタリングページのトークン使用量チャートで傾向を確認することもできます。
Q: cached_tokens が常に 0 で、キャッシングが機能しない場合はどうすればよいですか?
一般的な原因: リクエスト間で入力プレフィックスに一貫性がない (例: System Message が変化する)、2 つのリクエストの間隔がキャッシュの有効期間を超えている、入力トークン数が少なすぎてキャッシングがトリガーされない、などです。トラブルシューティング方法とキャッシュの制限事項については、「コンテキストキャッシング」をご参照ください。
Q: 使用率が 100% を超えるのはなぜですか?
一部のモデル (glm-5.1 など) では、長文入力の階層型容量係数により、実際のクォータ消費量が生のトークン数を超えることがあります。使用率は、変換後の消費量 ÷ 購入クォータで計算されます。100% を超える場合は、消費レートが購入クォータを超えていることを意味し、超過分はオーバーフロー戦略に従って処理されます (自動オーバーフローではサービスの可用性に影響を与えることなく従量課金の課金にフォールバックし、PTU 容量のみ使用では 429 を返します)。