LindormTable は、Log-Structured Merge-Tree (LSM-Tree) ストレージ構造を使用しています。正確な行数を取得するには全表スキャンが必要であり、テーブルが大きくなるほど操作にかかる時間が長くなります。COUNT 操作を頻繁に実行することは避けてください。
Lindorm
Lindorm ワイドテーブルの正確な行数と推定行数の違いは次のとおりです。
正確な行数 | 推定行数 | |
統計メソッド | テーブル全体をスキャンして、正確な行数を取得します。 | ファイルレベルでメタデータを直接取得するため、結果が実際のテーブルサイズと異なる場合があります。 |
統計パフォーマンス | 完了までに時間がかかり、同時に実行されると追加の負荷が高くなります。 | 完了までの時間が短く、同時に実行される際の追加の負荷は低いです。 |
適用シナリオ | データ移行前後のデータ検証などのシナリオ。 | アプリケーションページでテーブルサイズの変更傾向を表示するシナリオ。 |
ワイドテーブルの正確な行数を取得する方法
次の方法を使用して、ワイドテーブルの正確な行数を取得できます。ビジネスシナリオに基づいて方法を選択することを推奨します。
Lindorm SQL を使用した行数のカウントは、一般的に HBase RowCounter を使用するよりも高速です。これは、Lindorm が COUNT 操作を自動的に分散して並列 (マルチスレッド実行) で処理するのに対し、HBase シェルはシングルスレッドでカウントするためです。ただし、COUNT は依然として全表スキャンが必要であり、デフォルトのタイムアウトは 120 秒です。タイムアウトすると、操作はエラーを報告します。大規模なテーブルの場合は、SQL の HINT を使用してタイムアウトを延長できます。Lindorm SQL の処理速度は、ノードあたり毎秒数十万行に達することがあります。COUNT は CPU 負荷の高い操作であるため、ビジネスのピーク時間帯には実行しないでください。
SQL を使用したワイドテーブルの正確な行数の取得
Lindorm-cli、MySQL クライアントを使用した LindormTable への接続と使用、または JDBC を使用して Lindorm に接続し、SQL ステートメントを実行できます。
たとえば、次の SQL ステートメントを実行して、table_name の行数をカウントし、実行タイムアウトを 5 分に設定できます。
SELECT /*+ _l_operation_timeout_(300000) */ COUNT(*) FROM table_name;結果は次のようになります。
+--------+
| EXPR$0 |
+--------+
| 160000 |
+--------+テーブルの正確な行数をカウントするには、全表スキャンが必要です。この操作は注意して実行してください。データ量が 100 万行を超える場合は、次の方法を推奨します。
検索インデックスを使用して高速化する: 詳細については、「検索インデックスを使用したワイドテーブルのデータクエリ」をご参照ください。
1843_v1_4_0.xdita">.
_l_operation_timeoutHINT を追加してステートメントのタイムアウトを延長する: 詳細については、「HINT」をご参照ください。HBase Shell を使用したワイドテーブルの
HBase Shell を使用して LindormTable に接続します。詳細については、「Lindorm Shell を使用して LindormTable にアクセスする」をご参照ください。
COUNT コマンドの使用 (推奨)
HBase シェルで COUNT コマンドを使用すると、HBase テーブルの正確な行数を取得できます。このコマンドの仕組みは、テーブルのすべてのデータをバッチでスキャンしてカウントすることです。そのため、同じ VPC 内の ECS クライアントから COUNT コマンドを実行することを推奨します。インターネット経由で COUNT コマンドを実行すると、ネットワーク使用率が高くなり、統計効率が低下します。テーブルの構造によって、スキャン速度は異なります。COUNT コマンドのフルテーブルスキャンの速度は、100,000 行/秒 未満になる場合があります。次の文を実行して、テーブルの総行数をカウントします:
count 'table_name'結果は次のようになります:

HBase RowCounter プラグインを使用した高速化
HBase シェルの count コマンドを使用すると、ワイドテーブルの正確な行数を取得できますが、大規模なテーブルでは速度が遅くなります。RowCounter プラグインは、ローカルの擬似分散 MR タスクを起動して COUNT 操作を実行します。デフォルトでは、プラグインはシングルスレッドで実行され、統計速度は HBase シェルの COUNT コマンドとほぼ同じです。統計速度を向上させるには、
mapreduce.local.map.tasks.maximumを指定してスレッド数を増やすことができます。複数のスレッドで並行実行することで、統計が大幅に高速化されます。スレッド数は、テーブルのリージョン数以下である必要があります。
テーブル内のリージョンの数以下となります。テーブル内のリージョンの数以下となります。
スレッド数を増やすと、クラスターのロードが高くなり、オンラインサービスに影響を与える可能性があります。ビジネス要件に基づいて数を設定してください。
スレッド数を増やすと、クラスターの負荷が高くなり、オンラインサービスに影響を与える可能性があります。ビジネス要件に基づいて数値を設定してください。
たとえば、HBase Shell で RowCounter プラグインを使用して Lindorm ワイドテーブルの行数をカウントするには、次のコマンドを実行します。
Lindorm ワイドテーブルの行をカウントするには、HBase Shell で次のコマンドを実行します。
RowCounter プラグインを使用して、対象テーブルの総行数をカウントします。
対象テーブル (table) の合計行数
./alihbase-2.0.18/bin/hbase org.apache.hadoop.hbase.mapreduce.RowCounter "table_name"RowCounter プラグインを使用して、16 の並行スレッドでテーブル (table) の総行数をカウントします。
RowCounter プラグインを使用して、16 の並行スレッドでテーブル (table) の総行数をカウントします。
./alihbase-2.0.18/bin/hbase org.apache.hadoop.hbase.mapreduce.RowCounter -Dmapreduce.local.map.tasks.maximum=16 "table_name"RowCounter プラグインを使用して、名前空間 ns 内の対象テーブル (table) の合計行数をカウントします。
RowCounter プラグインを使用して、名前空間 ns 内の対象テーブル (table) の総行数をカウントします。
./alihbase-2.0.18/bin/hbase org.apache.hadoop.hbase.mapreduce.RowCounter "ns:table_name"RowCounter プラグインの統計結果は、次の図に示すように、Log ディレクトリの
hbase.logファイルに保存されます。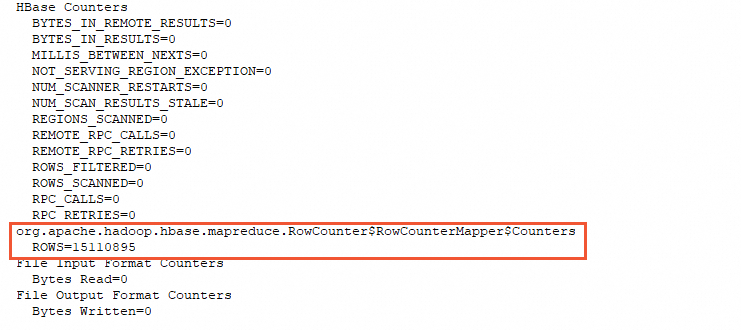
ワイドテーブルの推定行数を取得する方法
次の方法を使用して、ワイドテーブルの推定行数を取得できます。
SQL を使用したワイドテーブルの推定行数の取得
SELECT ステートメントを使用して正確な行数を取得するのとは異なり、推定行数の取得には次の SHOW ステートメントを使用します。
この機能には、LindormTable バージョン 2.8.2.6 以降および Lindorm SQL バージョン 2.8.2.6 以降が必要です。
SHOW ESTIMATED ROWS FROM table_name;次の結果が返されます。
+---------------------+
| ESTIMATED_ROW_COUNT |
+---------------------+
| 15000               |
+---------------------+
クラスター管理システムでのテーブルの推定行数の表示
Lindorm クラスター管理システムでは、概要ページでテーブルのおおよその行数を表示できます。この推定値は、データファイルの行数メタデータを合計して計算されます。ユーザーが更新または削除操作を実行すると、同じ行のデータが複数のファイルに分散される可能性があります。さらに、ファイルの行数メタデータはファイルが生成されるときに収集されます。ユーザーが TTL 機能を使用している場合、ファイル内の一部のデータが期限切れになっている可能性があり、これにより推定行数が実際の行数と異なる場合があります。
Lindorm クラスター管理システムで、左側のナビゲーションウィンドウで [概要] をクリックします。[現在の IDC] エリアで、ターゲットテーブルを見つけます。行数は [行] 列に表示されます。
テーブルにデータがあるにもかかわらず推定行数が 0 の場合、Lindorm ワイドテーブルエンジンのマイナーバージョンが低すぎます。マイナーバージョンをアップグレードしてください。アップグレード方法の詳細については、「Lindorm インスタンスのマイナーエンジンバージョンのアップグレード」をご参照ください。