このトピックでは、独自の API キーを申請することなく、Flink SQL ジョブで組み込みの大規模言語モデルサービスを使用して、ストリーミング感情分析とベクトル化を行う方法について説明します。
背景情報
Flink AI サービスは、マネージド型の組み込み大規模言語モデル (LLM) を提供します。API キーを申請する必要はありません。Flink SQL ジョブで組み込みモデルを直接参照することで、ストリーミング AI 推論とベクトル化が可能になります。以下のセクションでは、2 つの主要なモデルのユースケースについて説明します。
-
チャット/completions モデル:チャット/completions モデルは、対話生成とテキスト理解に基づく LLM です。感情分析、意図認識、質疑応答システムなどのシナリオで広く使用されています。
-
感情分析:ビジネスのソーシャルメディアコメントに対してリアルタイムの感情分類を実行し、ユーザーの感情を肯定的、否定的、または中立的として識別します。
-
インテリジェントカスタマーサービス:対話生成機能を利用して、インテリジェントカスタマーサービスシステムに自然言語対話を提供します。
-
コンテンツモデレーション:テキスト内の機密コンテンツやポリシー違反を自動的に検出し、コンテンツのセキュリティ監査をより効率的にします。
-
-
embedding モデル:embedding モデルは、テキストを高次元のベクトル表現に変換します。一般的な応用例には、セマンティック検索、レコメンデーションシステム、ナレッジグラフの構築などがあります。
-
セマンティック検索:製品説明やユーザーのクエリをベクトル化することで、関連性に基づいたセマンティック検索を可能にします。
-
レコメンデーションシステム:テキストのベクトル化を使用して、ユーザーの興味と製品の特徴との関連性を発見し、推奨精度を向上させます。
-
ナレッジグラフ:非構造化テキストをベクトル形式に変換し、その後の知識抽出と関係モデリングを簡素化します。
-
前提条件
-
Flink ワークスペースがアクティブ化済みであること。詳細については、「Realtime Compute for Apache Flink のアクティブ化」をご参照ください。
-
Flink AI サービスがアクティブ化済みであること。詳細については、「Flink AI サービス (組み込みモデル)」をご参照ください。
制限事項
-
Ververica Runtime (VVR) 8.0.7 以降が必要です。
-
ML_PREDICT 演算子のスループットは、モデルサービスプラットフォームのレート制限ポリシーによって制限されます。トラフィック制限に達すると、Flink ジョブでバックプレッシャーが発生したり、タイムアウトにより再起動したりする可能性があります。
ステップ 1:組み込みモデルの登録
詳細については、「モデル設定」をご参照ください。
チャット/completions モデル
次のサンプル SQL コードは、Flink 組み込みテキストモデルを登録する方法を示しています。
CREATE MODEL ai_analyze_sentiment
INPUT (`input` STRING)
OUTPUT (`content` STRING)
WITH (
    'provider' = 'dashscope',
    'task' = 'chat/completions',
    'model' = 'qwen3.5-flash',
    'system-prompt' = 'Classify the text below into one of the following labels: [positive, negative, neutral, mixed]. Output only the label.'
);
embedding モデル
次のサンプル SQL コードは、Flink 組み込み embedding モデルを登録する方法を示しています。
CREATE MODEL embedding_model
INPUT (`input` STRING)
OUTPUT (`embeddings` ARRAY<FLOAT>)
WITH (
    'provider' = 'dashscope',
    'task' = 'embeddings',
    'model' = 'text-embedding-v4'
);
ステップ 2:ジョブの作成
SQL ストリーミングジョブのドラフトを作成します。詳細については、「Flink SQL ジョブ」をご参照ください。
ステップ 3:LLM 分析用の SQL ジョブの作成
チャット/completions モデル
ML_PREDICT AI 関数を使用して、登録された ai_analyze_sentiment モデルを呼び出し、映画レビューの感情分析を行います。
次のサンプル SQL を SQL エディターにコピーします。
-- 一時的なシンクテーブルを作成します。
CREATE TEMPORARY TABLE print_sink(
  id BIGINT,
  movie_name VARCHAR,
  predict_label VARCHAR,
  actual_label VARCHAR
) WITH (
  'connector' = 'print',   -- print コネクターを使用します。
  'logger' = 'true'        -- 結果をコンソールに表示します。
);

-- テストデータを構築するための一時的なデータビューを作成します。
-- | id | movie_name | comment   | actual_label |
-- | 1  | Her Story     | My favorite part was when the kid guessed the sounds. It is one of the most romantic narratives I have seen in movies. Very gentle and loving. | POSITIVE |
-- | 2  | The Dumpling Queen   | Unremarkable.  | NEGATIVE |
CREATE TEMPORARY VIEW movie_comment(id, movie_name, user_comment, actual_label)
AS VALUES (1, 'Her Story', 'My favorite part was when the kid guessed the sounds. It is one of the most romantic narratives I have seen in movies. Very gentle and loving.', 'positive'), (2, 'The Dumpling Queen', 'Unremarkable.', 'negative');

INSERT INTO print_sink
SELECT id, movie_name, content as predict_label, actual_label
FROM ML_PREDICT(
  TABLE movie_comment,
  MODEL ai_analyze_sentiment,  -- 登録済みの Flink 組み込みテキストモデル。
  DESCRIPTOR(user_comment));
embedding モデル
ML_PREDICT AI 関数を使用して、登録済みの embedding_model を呼び出し、映画レビューの埋め込みを生成してから、その結果を Milvus (パブリックプレビュー) に書き込みます。
次のサンプル SQL を SQL エディターにコピーします。
-- milvus_sink という名前の一時的なシンクテーブルを作成します。
CREATE TEMPORARY TABLE milvus_sink
(
    id STRING,
    movie_name STRING,
    user_comment STRING,
    embeddings ARRAY<FLOAT>,
    PRIMARY KEY (id) NOT ENFORCED
)
WITH (
    'connector' = 'milvus',
    'endpoint' = '<YOUR-ENDPOINT>',
    'port' = '<YOUR-PORT>',
    'userName' = '<YOUR-USERNAME>',
    'password' = '<YOUR-PASSWORD>',
    'databaseName' = 'default',
    'collectionName' = 'movie-comment-embeddings'
);

-- テストデータを構築するための一時的なデータビューを作成します。
-- | id | movie_name | comment |
-- | 1 | Her Story |My favorite part was when the kid guessed the sounds. It is one of the most romantic narratives I have seen in movies. Very gentle and loving.|
-- | 2 | The Dumpling Queen | Unremarkable. |
CREATE TEMPORARY VIEW movie_comment(id, movie_name,  user_comment)
AS VALUES ('1', 'Her Story', 'My favorite part was when the kid guessed the sounds. It is one of the most romantic narratives I have seen in movies. Very gentle and loving.'), ('2', 'The Dumpling Queen', 'Unremarkable.');


INSERT INTO
    milvus_sink
SELECT
    id,
    movie_name,
    user_comment,
    embeddings
FROM
    ML_PREDICT (
        TABLE movie_comment,
        MODEL embedding_model,  -- 登録済みの Flink 組み込み embedding モデル。
        DESCRIPTOR (user_comment)
    );
ステップ 4:ジョブのデプロイと開始
ジョブをデプロイして開始します。詳細については、「Flink SQL ジョブ」をご参照ください。
ステップ 5:分析結果の表示
チャット/completions モデル
-
ジョブのステータスが [FINISHED] であることを確認します。
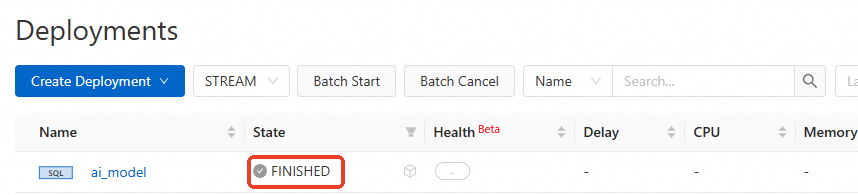
-
コンソールで、[デプロイ] ページに移動し、対象のジョブ名をクリックします。
-
[ログ] タブで、[Task Managers] サブタブをクリックし、[現在の TaskManager] を選択します。
-
[ログ] をクリックし、PrintSinkOutputWriter に関連するログを検索します。
モデルの予測ラベル
predict_labelは、実際のラベルactual_labelと一致します。[タスクマネージャー] タブで、左側の [実行ログ] を選択します。ログには、
+I[1, Her Story, positive, positive]や+I[2, The Dumpling Queen, negative, negative]などの PrintSinkOutputWriter の出力が表示されます。これは、predict_label が actual_label と一致することを示しています。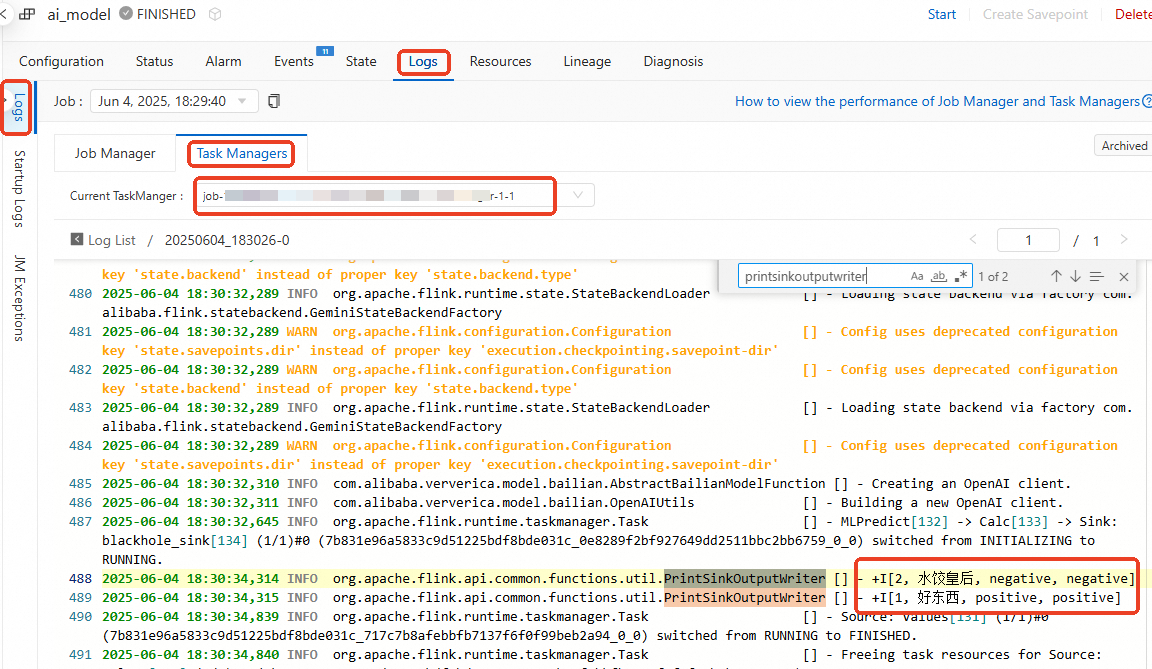
関連ドキュメント
-
AI モデルのデータ定義言語 (DDL) ステートメント:モデルの設定
-
AI 関数:ML_PREDICT
-
ベクトル検索サービス:Milvus (パブリックプレビュー)