Mem0 フレームワークを使用してメモリのライフサイクルを管理し、Elasticsearch をベクトル検索に利用することで、永続ストレージ、セマンティック取得、インテリジェントな更新をサポートする本番環境レベルの AI メモリシステムを構築できます。
ユースケース
-
長時間の対話への対応:長時間の会話におけるコンテキストの損失を防ぎます。
-
クロスセッションコンテキストの維持:エージェントがユーザーの対話履歴や個人の好みを記憶できるようになります。
-
永続メモリの管理:会話から得た重要な情報を構造化して保存します。
-
マルチエージェントコラボレーションの実現:複数のエージェントが単一のメモリストアを共有できるようになります。
これら 2 つのシナリオは、メモリシステムの価値を示しています。
E コマースのインテリジェントショッピングアシスタント
ユーザーが新しいセッションを開始し、「軟水塩の追加を自動でリマインドしてくれる食洗機」について質問します。クロスセッションメモリがなければ、システムは以前のセッションでの制約「家に乳児がいるので水質を優先したい」を思い出すことができません。標準的なコンテキストの切り捨てでは、これを独立したクエリとして扱います。しかし、メモリシステムはベクトルインデックスを使用して「乳児のいる家庭」というタグをユーザー ID に永続的にリンクさせることができます。そして、この情報を構造化されたメモリフラグメントとして新しいセッションのコンテキストに注入することで、クロスセッションの意図が維持されます。
インテリジェント AI カスタマーサービス
顧客が「先月購入したロボット掃除機のアプリが接続できない」と不満を述べます。メモリシステムがなければ、エージェントは「どのモデルを購入しましたか? シリアル番号は何ですか?」といった繰り返しの質問をしなければなりません。この繰り返しは顧客体験を低下させ、貴重なコンテキストウィンドウのスペースを消費します。メモリシステムは、ユーザーのデバイス ID、過去のサポートチケット、以前に試した解決策をバージョン管理されたメモリユニットとして保存できます。新しいセッションが始まると、システムは低トークンのセマンティッククエリを使用して、この構造化された状態を正確に取得します。これにより、カスタマーサービスの対応が「再診断」から「解決の再開」へとシフトします。
仕組み
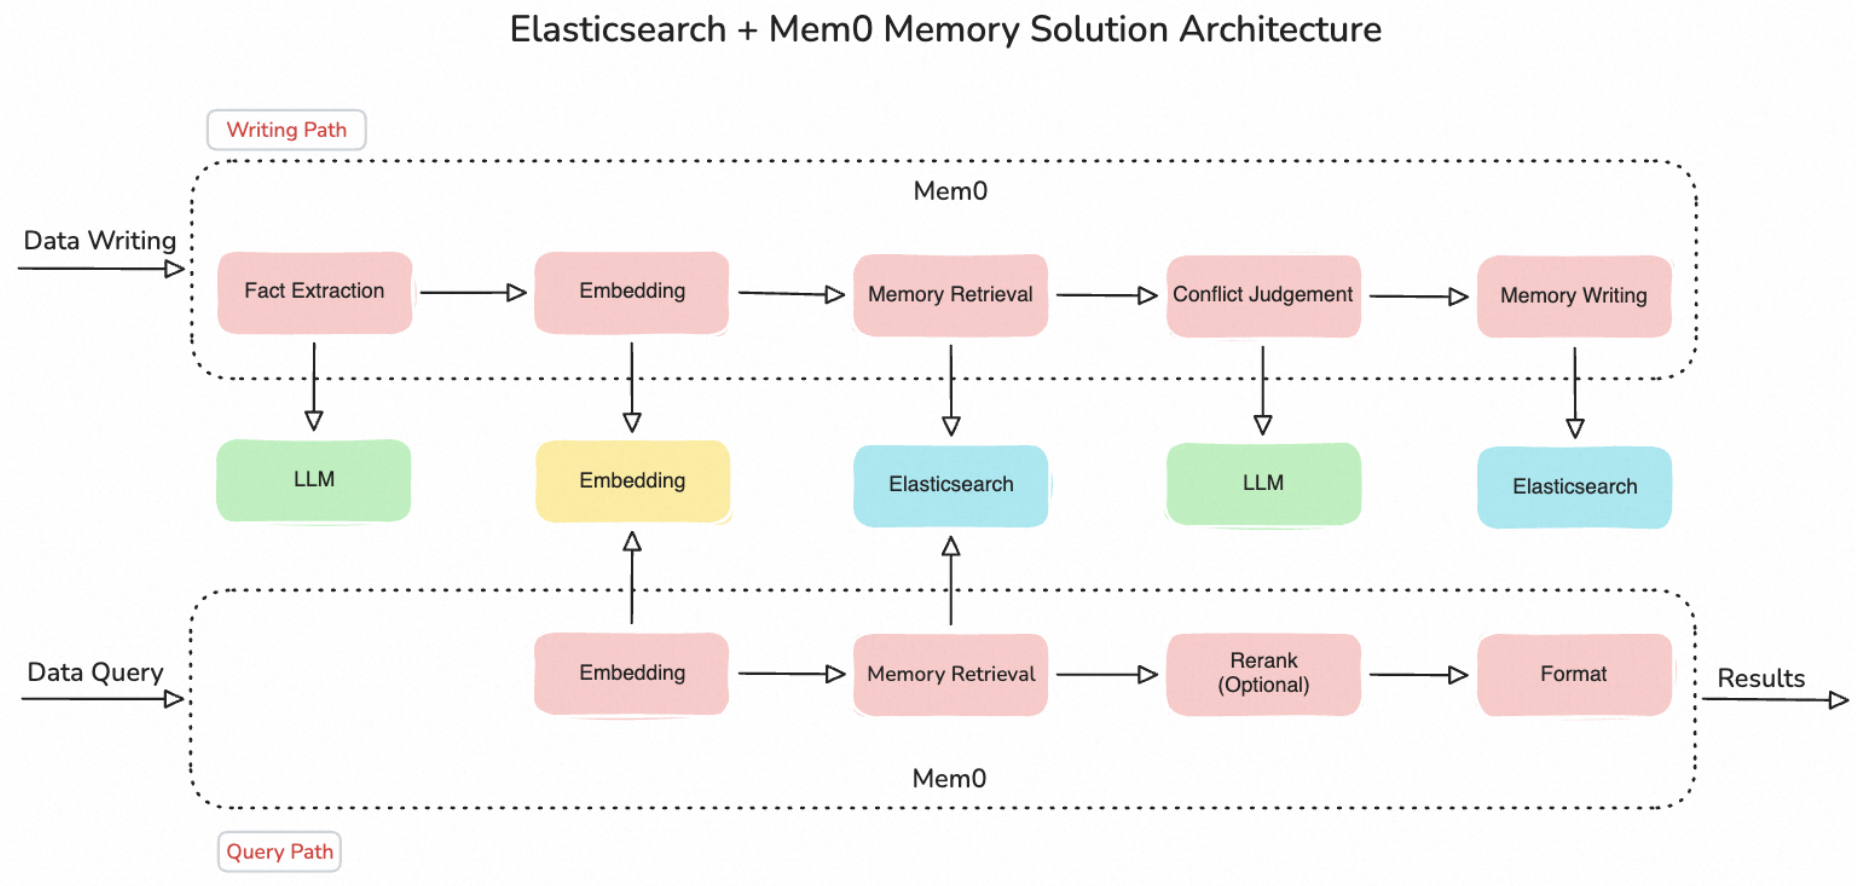
システムのコアワークフローは以下の通りです。
-
事実抽出:大規模言語モデル (LLM) を使用して、入力から事実を抽出します。
-
ベクトル化:埋め込みモデルを使用してテキストをベクトルに変換し、セマンティック的に類似したメモリがベクトル空間で近くなるようにします。
-
メモリ取得:Elasticsearch でトップ K 類似ベクトル検索を実行し、最も関連性の高いメモリフラグメントを返します。
-
競合解決:LLM を使用して、メモリを更新、マージ、無視、または作成するかを決定します。
-
書き込みの実行:最新のメモリを Elasticsearch に永続化します。
取得パスでは、リランカーモデルを設定して検索結果を並べ替え、取得精度を向上させることもできます。
例:OpenClaw へのメモリシステムの追加
OpenClaw は、大規模言語モデル (LLM) と、オペレーティングシステムの制御、Web アクセス、ファイル操作などの機能を組み合わせたオープンソースのパーソナル AI エージェントフレームワークで、AI が複雑なタスクを順次実行できるようにします。OpenClaw のネイティブメモリシステムには、コンテキスト長の制限、取得効率の低さ、クロスセッションの継続性の欠如といった制限があります。Mem0 と Elasticsearch を統合することで、これらの問題に対処します。
ステップ 1:Elasticsearch の準備
-
クイックスタート ガイドに従ってインスタンスを作成し、ログインパスワードを設定します。
-
Kibana のパブリックアクセスホワイトリストを設定します。
-
対象インスタンスの 基本情報 ページに移動します。左側メニューで、 をクリックします。Kibana セクションで、設定の編集 をクリックします。
-
Kibana ホワイトリスト を設定します。デフォルトでは、ホワイトリストは 127.0.0.1 に設定されており、すべての IPv4 アドレスからのアクセスを拒否します。Kibana にアクセスするには、お使いのデバイスのパブリック IP アドレスをホワイトリストに追加します。詳細については、「Kibana を介したクラスターへの接続」をご参照ください。
-
-
Kibana セクションに戻り、インターネットからのアクセス をクリックします。Kibana のログインページで、ユーザー名とパスワードを入力します。ログインに成功したら、Kibana の Dev Tools を使用して
mem0という名前のインデックスを作成します。PUT /mem0 { "settings": { "number_of_shards": 1, "number_of_replicas": 1 } }
ステップ 2:Mem0 サーバーのデプロイ
-
Mem0 と Flask をインストールします。
pip install mem0ai flaskその他のインストール方法については、Mem0 の README をご参照ください。
-
Mem0 サーバーのディレクトリを作成します。
mkdir -p /opt/mem0-server cd /opt/mem0-server -
プレースホルダーを実際の値に置き換えて、以下の内容で
server.pyファイルを作成します。-
$API_KEY: Model Studio の API キー
-
$ELASTICSEARCH_HOST, $ELASTICSEARCH_PORT: Elasticsearch インスタンスのエンドポイントとポート
-
$ELASTICSEARCH_USER, $ELASTICSEARCH_PASSWORD: Elasticsearch インスタンスのユーザー名とパスワード
# server.py - これをスタンドアロンサービスとして実行します
from mem0 import Memory
from flask import Flask, request, jsonify

app = Flask(__name__)

# ここで Mem0 を設定します
config = {
    "llm": {
        "provider": "openai",
        "config": {
            "model": "qwen-plus",
            "api_key": "$API_KEY",
            "openai_base_url": "https://dashscope.aliyuncs.com/compatible-mode/v1",
        }
    },
    "embedder": {
        "provider": "openai",
        "config": {
            "model": "text-embedding-v2",
            "api_key": "$API_KEY",
            "openai_base_url": "https://dashscope.aliyuncs.com/compatible-mode/v1",
        }
    },
    "vector_store": {
        "provider": "elasticsearch",
        "config": {
            "host": "$ELASTICSEARCH_HOST",     # Elasticsearch インスタンスのホスト
            "port": "$ELASTICSEARCH_PORT",     # Elasticsearch インスタンスのポート
            "user": "$ELASTICSEARCH_USER",     # Elasticsearch インスタンスのユーザー名
            "password": "$ELASTICSEARCH_PASSWORD",  # Elasticsearch インスタンスのパスワード
            "collection_name": "mem0",         # ステップ 1 で作成したインデックスの名前
        }
    },
}

memory = Memory.from_config(config)

@app.route('/v1/memories', methods=['POST'])
def add_memory():
    data = request.json
    result = memory.add(
        messages=data['messages'],
        user_id=data['user_id']
    )
    return jsonify(result)

@app.route('/v1/memories/search', methods=['POST'])
def search_memories():
    data = request.json
    result = memory.search(
        query=data['query'],
        user_id=data['user_id']
    )
    return jsonify(result)

@app.route('/v1/memories', methods=['DELETE'])
def delete_memories():
    user_id = request.args.get('user_id')
    memory.delete_all(user_id=user_id)
    return jsonify({"status": "success"})

if __name__ == '__main__':
    app.run(host='0.0.0.0', port=8420)
-
-
Mem0 サーバーを起動します。
python server.py
ステップ 3:OpenClaw の設定
-
Elastic Compute Service (ECS) インスタンスに OpenClaw をデプロイします。次のいずれかの方法を選択できます。
-
方法 1 (Compute Nest によるワンクリックデプロイ):ECS インスタンスに OpenClaw をデプロイする
-
方法 2 (ワークベンチを使用したワンクリックインストール):
-
ECS コンソールにログインし、対象のインスタンスを選択します。
-
[リモート接続] > [今すぐログオン] をクリックします。
-
ワークベンチのターミナルツールバーで、[OpenClaw のワンクリック管理] をクリックします。
-
[OpenClaw をインストール] を選択し、操作を確定します。
-
-
-
ECS インスタンスにログインし、スキルディレクトリを作成します。
mkdir -p ~/.openclaw/workspace/skills/agentic-memory-es cd ~/.openclaw/workspace/skills/agentic-memory-es -
このディレクトリに以下の3つのファイルを作成します。
agentic-memory-es/
├── manifest.json    # メタデータと API 定義
├── handler.py       # コア処理ロジック
└── SKILL.md         # 指示書
manifest.json:
{
  "name": "agentic memory",
  "id": "agentic-memory-es",
  "version": "1.0.0",
  "description_for_model": "Mem0 + Elasticsearch ベースのメモリプラットフォームで、追加 (add)、検索 (search)、ユーザー ID による削除 (delete_by_user_id) をサポートします。",
  "description_for_human": "Alibaba Cloud Elasticsearch を利用したエージェントメモリプラットフォーム。",
  "auth": {
    "type": "token",
    "token_header": "Authorization",
    "token_prefix": "Token"
  },
  "api": {
    "type": "python",
    "main_file": "handler.py",
    "functions": [
      {
        "name": "add",
        "description": "セッションから事実、ユーザーの好み、または習慣を抽出し、それらを永続化します。",
        "parameters": {
          "type": "object",
          "properties": {
            "user_id": { "type": "string", "description": "ユーザー ID" },
            "context": { "type": "string", "description": "セッションコンテンツ" }
          },
          "required": ["user_id", "context"]
        }
      },
      {
        "name": "search",
        "description": "ユーザーレベルの履歴メモリ (クロスセッション) を取得します。",
        "parameters": {
          "type": "object",
          "properties": {
            "user_id": { "type": "string", "description": "ユーザー ID" },
            "query": { "type": "string", "description": "検索クエリ" }
          },
          "required": ["user_id", "query"]
        }
      },
      {
        "name": "delete_by_user_id",
        "description": "ユーザー ID に関連付けられた履歴メモリを削除します。",
        "parameters": {
          "type": "object",
          "properties": {
            "user_id": { "type": "string", "description": "ユーザー ID" }
          },
          "required": ["user_id"]
        }
      }
    ]
  }
}
handler.py:
$Mem0_HOSTを、ステップ 2 でデプロイした Mem0 サーバーのエンドポイントに置き換えてください。-
Mem0 サーバーと OpenClaw が同じ ECS インスタンス上にある場合は、
http://127.0.0.1:8420を使用します。 -
異なるマシン上にある場合は、Mem0 サーバーの内部またはパブリック IP アドレスを使用します。
import json
import subprocess

HOST = "$Mem0_HOST"

def _run_safe_curl(url, payload, method='POST'):
    if payload is not None:
        input_data = json.dumps(payload, ensure_ascii=False)
    else:
        input_data = ""

    cmd = [
        "curl", "-s", "-X", method, url,
        "-H", "Content-Type: application/json",
        "--data-binary", "@-",
        "--max-time", "15",
        "--no-buffer"
    ]

    try:
        input_data = json.dumps(payload)

        result = subprocess.run(
            cmd, input=input_data, capture_output=True,
            text=True, check=True, encoding='utf-8'
        )

        output = result.stdout.strip()
        if not output:
            return {"status": "success"}
        return json.loads(output)

    except subprocess.CalledProcessError as e:
        return {"error": f"Curl command failed: {e.stderr}"}
    except Exception as e:
        return {"error": str(e)}

def add(user_id, context):
    url = f"{HOST}/v1/memories"
    payload = {
        "messages": [
            {"role": "user", "content": context}
        ],
        "user_id": str(user_id)
    }
    return _run_safe_curl(url, payload, method='POST')

def search(user_id, query):
    url = f"{HOST}/v1/memories/search"
    payload = {
        "query": query,
        "user_id": str(user_id)
    }
    return _run_safe_curl(url, payload, method='POST')

def delete_by_user_id(user_id):
    url = f"{HOST}/v1/memories?user_id={user_id}"
    return _run_safe_curl(url, payload=None, method='DELETE')
SKILL.md:
--- name: agentic memory description: Mem0 + Elasticsearch ベースのメモリプラットフォーム。 allowed-tools: - add - search - delete_by_user_id metadata: category: memory provider: elasticsearch --- # 指示 Elasticsearch を利用したメモリストアにアクセスできるようになりました。このスキルは Mem0 + Elasticsearch サービスを統合し、OpenClaw に長期記憶を提供します。これにより、ネイティブの .md ファイルストレージが置き換えられます。これは、ユーザーの好み、事実、イベント関係の正確な抽出とミリ秒レベルの取得を可能にし、クロスセッションの知識の永続化をサポートします。以下の原則に従ってください。 1. 積極的な記憶:コアとなる事実 (アイデンティティ、スキル) や明示的な好み (習慣、制約) をキャプチャします。 - ユーザーが「エージェントアシスタントを開発しています」と述べた場合、add を呼び出します。 - ユーザーが「始める前に計画を立てるのが好きです」や「仕事中に邪魔されるのが嫌いです」といった好みを示した場合、add を呼び出します。 2. 文脈に沿った取得:新しいタスクを開始したり、履歴を確認したりする際に、search を呼び出してメモリを取得し、一貫性のある会話を確保します。 3. メモリのクリア:ユーザーがすべてのメモリをクリアすることにした場合、delete_by_user_id を呼び出して、そのユーザー ID のすべてのメモリを削除します。 # ツール ## メモリ管理 (Mem0 + Elasticsearch) このツールセットは、Mem0 + Elasticsearch に基づくメモリ機能を提供し、エージェントが異なるセッション間でメモリを永続化および取得できるようにします。 ### 1. add - 説明:セッションから事実、ユーザーの好み、または習慣を抽出し、それらを永続化します。 - 必須パラメーター: - user_id (string):ユーザーの一意の識別子。 - context (string):セッションのコンテンツ。 - 戻り値:操作ステータスまたは新しく保存されたレコードの ID を含むオブジェクト。 ### 2. search - 説明:ユーザーレベルの履歴メモリ (クロスセッション) を取得します。 - 必須パラメーター: - user_id (string):ユーザーの一意の識別子。 - query (string):検索クエリ。 - 戻り値:関連性でソートされた結果を含むオブジェクト。 ### 3. delete_by_user_id - 説明:ユーザー ID に関連付けられた履歴メモリを削除します。 - 必須パラメーター: - user_id (string):ユーザーの一意の識別子。 - 戻り値:操作の確認メッセージ。 # 出力形式 1. 自然な統合:「メモリを検索しています」などの用語には言及しないでください。事実を既知のコンテキストとして返信に直接埋め込みます (例:「あなたが Rust を学習しているということを踏まえ、私は...を提案します」)。 2. コンテキスト認識:取得した事実を優先的に使用して、パーソナライズされた意思決定を行い、カスタマイズされた技術的ガイダンスを提供します。 3. 丁寧な処理:関連するメモリが見つからない場合は、直接高品質な応答を生成します。「メモリが見つかりませんでした」や「検索に失敗しました」とは言及しないでください。 4. アクションフィードバック:add の呼び出しが成功した後、返信の最後に「あなたの好みを記録しました」のように、自然な形で確認メッセージを加えます。 # 例 ### シナリオ 1:メモリの追加 ユーザー入力:「来月、Elasticsearch サービスをスケールアウトする予定です。」 アクション:add(user_id="user_01", context="来月 Elasticsearch をスケールアウトする予定") ### シナリオ 2:メモリの検索 ユーザー入力:「以前のスケールアウト計画を確認してください。」 アクション:search(user_id="user_01", query="スケールアウト計画") ### シナリオ 3:ユーザーメモリのクリア (ユーザー ID による削除) ユーザー入力:「私のメモリをすべてクリアしてください。」 アクション:delete_by_user_id(user_id="user_01") # タグ Memory-as-a-Service Elasticsearch Mem0 # 制限事項 - 複雑さの制限:極端に長い段落を単一の事実として保存することは避けてください。取得精度を向上させるために、より短く、セマンティックに定義されたステートメントに分割してください。 -
-
スキルを更新するか、OpenClaw ゲートウェイを再起動してください。
ステップ 4:結果の検証
Mem0 サーバーをデプロイした後、次のようにその機能を検証します。
-
メモリの書き込み:
ゲートウェイのチャットインターフェースで
/newを送信して新しいセッションを開始し、「家に赤ちゃんがいることを覚えておいてください」と送信します。アシスタントの返信でこの情報が記憶されたことが確認されれば、Mem0 + Elasticsearch に基づくエージェントのメモリへの書き込みは成功です。 -
メモリの取得:
ゲートウェイのチャットインターフェースで
/newを送信して新しいセッションを開始します。ユーザーは家族構成の情報に言及せず、「自動で塩の補充をリマインドしてくれる食洗機を推奨してください」とだけ入力します。アシスタントの返信が自動的に記録されたメモリを参照している場合、それはシステムの Mem0 + Elasticsearch によるエージェントメモリが、過去のセッションからユーザーの家に赤ちゃんがいるコンテキストを思い出したことを示しています。これにより、クロスセッションでのメモリ取得が機能していることが確認できます。
この例では、Alibaba Cloud がホストする OpenClaw セットアップを使用しており、迅速なワンクリックデプロイをサポートしています。ローカルでのデプロイについては、OpenClaw の GitHub リポジトリをご参照ください。